結論(2026年9月22日時点):マルチモーダルとは、テキストだけでなく画像・音声・動画・PDFといった複数の入力様式(モダリティ)を、1つのAIモデルがそのまま受け取って理解できることです。ChatGPT・Gemini・Claude・Microsoft Copilotの4ツールとも画像とPDFは標準で読めますが、録音ファイルと動画の対応はツールごとに違い、Geminiだけが動画そのものを直接読みます。
- 要点1:業務で効くのは「帳票の写真・現場の写真・会議の録音・図面やスライド・動画マニュアル・手書きメモ」の6つの入力。どれも今のツールで試せます。
- 要点2:4ツールの入力対応表(本文)は、執筆当日に各社の公式ページで確認した現在値だけを載せています。上限や形式は公式の記載どおりに引用しました。
- 要点3:写真や録音を渡す前に決めるべきは、学習利用の設定・保持期間・機密区分の3点。ここが決まっていないと稟議は通りません。
対象読者:生成AIの導入を検討・推進している経営者、DX・情報システム・総務の担当者。
読了後にできること:自社の帳票の写真1枚を、学習利用をオフにした状態で表に変換し、原本と突き合わせる。
「写真や画面キャプチャをAIに読ませていいんですか?」
企業向けの生成AI研修で、この質問が出ない回はほとんどありません。次に多いのが「会議の録音をそのまま要約させていいのか」、その次が「PDFの表やグラフはどこまで正確に読むのか」。つまり現場の関心は、もう「AIに文章を書かせる」段階を越えて、手元にある写真・録音・図面をAIに渡してよいか、渡したらどこまで読めるかに移っています。この問いに答えるための言葉が「マルチモーダル」です。
正直に言うと、この言葉は社内会議でかなり雑に使われています。「うちもマルチモーダルAIを入れよう」と言われて、実際に必要だったのはAI-OCRの入れ替えだった、という例を導入支援の現場で何度も見ました。逆に、CopilotとChatGPTで画像や動画の入力対応が違うことを知らずに稟議を書き、情報システム部門から差し戻された例もあります。
この記事では、マルチモーダルの意味を1段落で定義したうえで、業務で効く入力の型6つ、主要4ツールの入力対応表(2026年9月22日に公式ページで確認)、渡す前に決める社内規程のチェック項目、そして研修でそのまま使っている「まず試す3手」の手順をまとめます。読み終わるころには、自社のどの業務で今のAIに何を読ませられるか、どこに社内規程が要るかを1本で判断できるはずです。
マルチモーダルとは|テキスト・画像・音声・動画を1つのAIが扱うこと
マルチモーダル(multimodal)は「複数の(multi)様式(modal)」という意味の言葉で、AIの文脈ではテキスト・画像・音声・動画・PDFなど、種類の違う情報を1つのモデルが受け取り、まとめて理解して出力できることを指します。総務省の令和6年版 情報通信白書(第1章第2節)も、生成AIを「ユーザーからの指示に対して、テキスト、画像、音声など多様に生成できるAI技術の総称」と説明し、その特徴として「複数の異なる入力様式(マルチモーダル)」という言い方をしています(参照日 2026-09-22)。
なお、ラッコキーワードで「マルチモーダル」を引くと「マルチモーダル鎮痛」という医療用語も出てきます。こちらは複数の鎮痛法を組み合わせる治療の話で、この記事で扱うAIのマルチモーダルとは別の言葉です。
単一モーダルとの違い
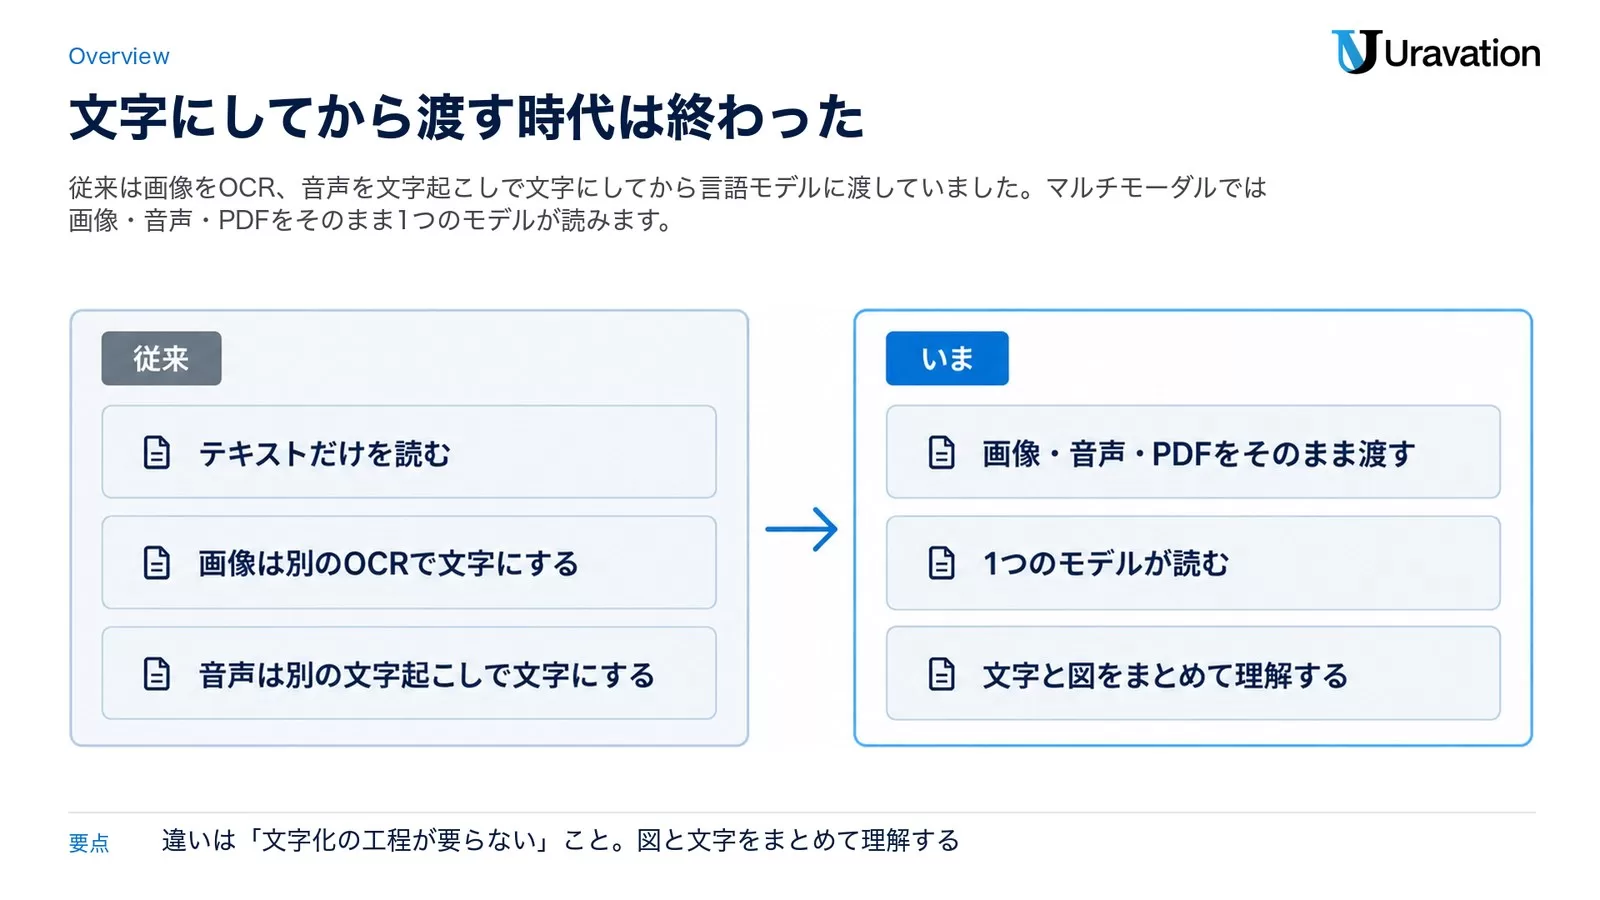
これまでの業務システムは、入力の種類ごとに道具が分かれていました。テキストだけを読む言語モデル、画像は別のOCRで文字にする、音声は別の文字起こしで文字にする、という具合です。文字にしてから言語モデルに渡すので、途中で図・写真の位置関係・声の調子といった情報が落ちます。
マルチモーダルなモデルでは、画像・音声・PDFをそのまま渡すことができ、1つのモデルが読むので、文字と図をまとめて理解する処理ができます。たとえば見積書の写真なら「どの数字がどの行の金額か」を表の構造ごと読み、会議の録音なら「誰が何を決めたか」を話者の切り替わりごと読みます。Googleの公式ドキュメントは「All Gemini model versions are multimodal(Geminiの全モデルはマルチモーダル)」と書いており(Gemini API Image understanding・2026-09-17更新)、2026年9月時点では主要モデルの側はもう「文字だけ」ではありません。
LLM・生成AI・OCRとの関係
よく混同されるので、関係を整理しておきます。
| 言葉 | 指しているもの | マルチモーダルとの関係 |
|---|---|---|
| 生成AI | 指示に応じて文章・画像・音声などを生成するAIの総称 | マルチモーダルは生成AIの「入出力の幅」を表す性質 |
| LLM(大規模言語モデル) | テキストを学習した言語モデル | 画像や音声も扱えるようにしたものが「マルチモーダルLLM」と呼ばれる |
| OCR/AI-OCR | 画像の中の文字を文字データに変換する技術 | OCRは「文字化」まで。マルチモーダルAIは文字化と同時に意味の理解・要約・表への整形までする |
| 文字起こし | 音声を文字に変換する技術 | マルチモーダルAIは文字起こしと同時に要約・決定事項の抽出までする |
導入支援で一番多い詰まりが、この「OCRとVLM(画像を理解するモデル)の混同」です。既存のAI-OCRで十分な定型帳票にマルチモーダルAIを当てる必要はありませんし、逆にレイアウトが毎回違う帳票・手書き・写真混じりの資料はマルチモーダルAIのほうが向きます。AI-OCRとの使い分けはAI-OCR比較7選|精度・料金・手書き対応の選び方で詳しく書いています。
業務で効く入力の型6つ|帳票の写真から動画マニュアルまで
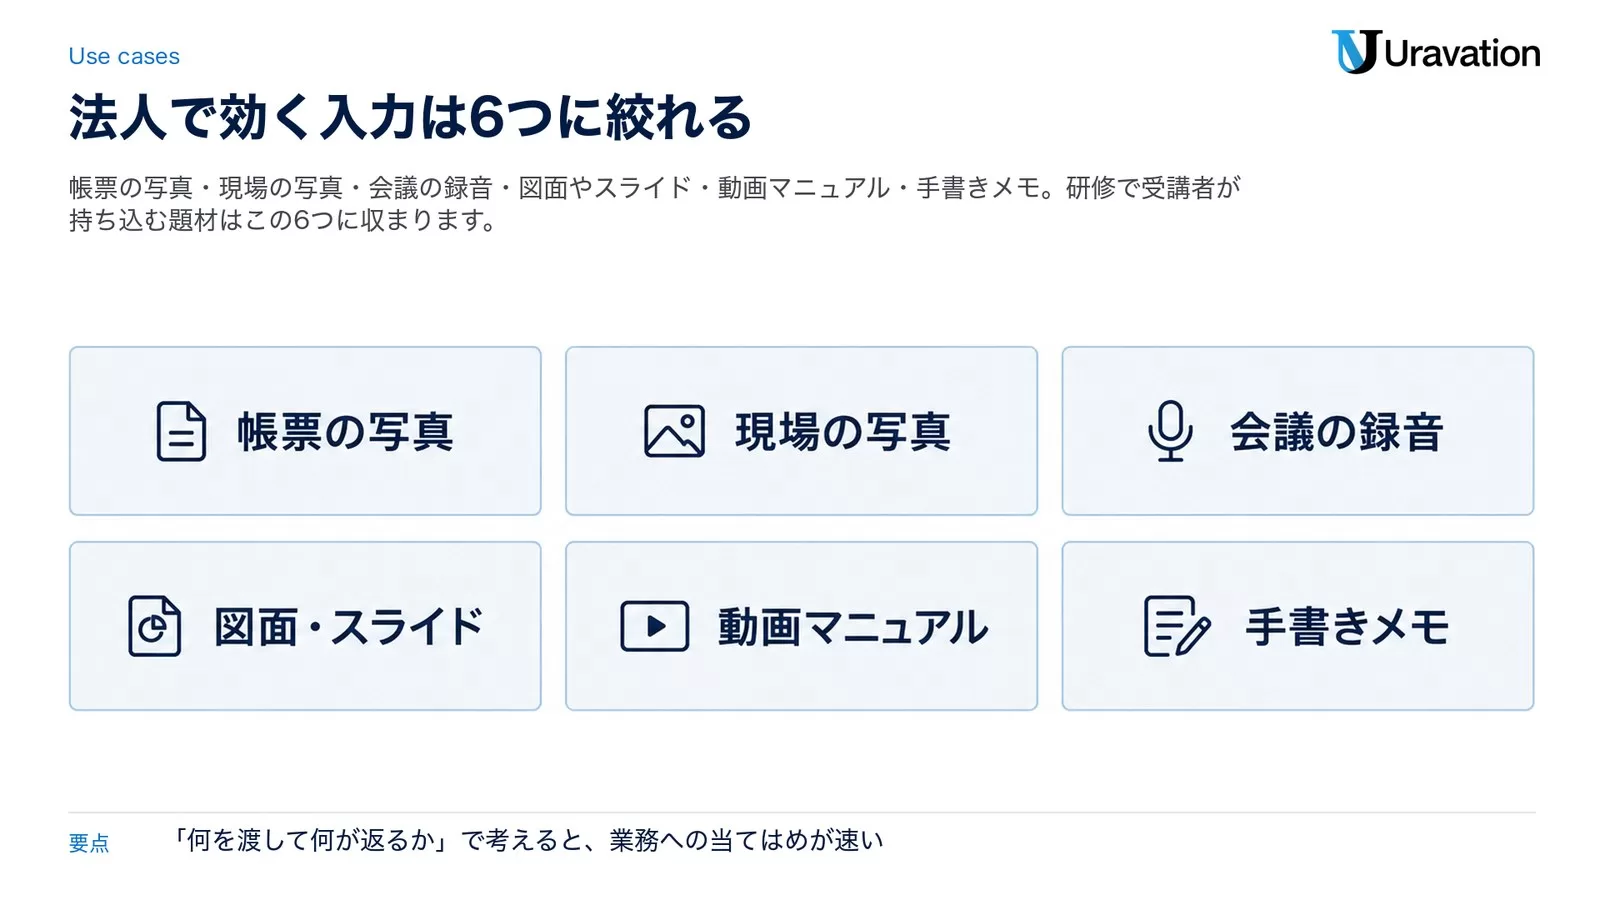
研修で受講者が実際に持ち込む題材を見ていると、法人で効く入力は次の6つに集約されます。ここでは「何を渡して、何が返ってくるか」だけを整理します。数字の効果は自社の実物で測るものなので、この記事では書きません。
1. 帳票の写真(請求書・領収書・納品書)
スマホで撮った請求書や領収書の写真を渡し、「日付・取引先・品目・金額・税区分」を表にしてもらう使い方です。レイアウトが取引先ごとに違う帳票ほど、固定テンプレートのOCRより向いています。ただし、金額と日付は必ず原本と突き合わせる前提で使います(理由は後述の「公式が明記する苦手」で説明します)。
2. 現場の写真(点検・報告)
設備・店舗・工事現場の写真を渡し、「写っている異常の候補」「報告書の下書き」を作らせる使い方です。写真には人の顔・車のナンバー・他社の看板が写り込みやすいので、渡す前に機密区分を決める必要があります(後述)。
3. 会議の録音(議事録)
録音ファイルや会議ツールの文字起こしを渡し、決定事項・宿題・期限を抽出させる使い方です。ツールによって「録音ファイルを直接渡せるか」「会議ツールの文字起こし経由か」が違うため、対応表を確認してから運用を決めます。社内規程に入れる項目はAI議事録のセキュリティ対策|社内規定に入れるべき10項目にまとめています。
4. 図面・スライド(読解)
設計図・配置図・提案スライドを画像やPDFで渡し、「記載漏れ」「前版との差分」「用語の不統一」を指摘させる使い方です。図面は機密度が高いので、渡す先が社外のクラウドである点を必ず確認します。
5. 動画マニュアル(検索)
作業手順の動画を渡し、「◯◯の手順は何分何秒か」「安全に関する注意は何回出てくるか」を答えさせる使い方です。動画そのものを読めるツールは限られるため、対応表で確認します。
6. 手書きメモ(整理)
ホワイトボードや手帳の写真を渡し、ToDoと担当者に整理させる使い方です。手書きは誤読が起きやすいので、整理結果を本人が見て直す前提です。
主要4ツールの入力対応表|ChatGPT・Gemini・Claude・Copilot(2026年9月22日時点)
ここが競合記事にはない部分です。以下は2026年9月22日に各社の公式ページを開いて確認した記載だけで作っています。上限や形式は日々変わるので、稟議に載せる前に出典リンク先を再確認してください。表の「対応」「一部対応」「未対応」は公式の記載に基づく3値で、公式に記載が見つからないものは「要確認」としています。
| 入力 | ChatGPT/OpenAI API | Gemini | Claude | Microsoft Copilot(法人) |
|---|---|---|---|---|
| 画像 | 対応。API公式の対応形式はPNG・JPEG・WEBP・非アニメGIF。1リクエスト最大1,500枚・合計512MB | 対応。API公式の対応形式はPNG・JPEG・WEBP・HEIC・HEIF。1リクエスト最大3,600枚・インライン送信は合計20MB。Geminiアプリは1プロンプト最大10ファイル | 対応。JPEG・PNG・GIF・WebP。claude.aiは1メッセージ20枚・1枚10MB・最大8000×8000px | 対応。Copilot Chatに「写真を撮る・アップロード・貼り付け」で画像を渡せる。個人向けCopilotはPNG・JPEG・PJP・JFIF、1ファイル50MB、1会話20ファイル |
| 対応。APIは「抽出した文字と各ページの画像の両方」をモデルに渡す。1ファイル50MB・リクエスト合計50MB | 対応。APIは1ファイル50MB・最大1,000ページ、1ページ258トークン。アプリは1ファイル100MB | 対応。APIは1リクエスト32MB・最大600ページ(コンテキストが100万トークン未満のモデルは100ページ)。claude.aiは100ページまで図表込みで読み、101〜1,000ページは文字のみ。1ファイル500MB・1チャット20ファイル | 対応。Word・Excel・PDFをアップロードして質問できる。アップロードしたファイルは利用者のOneDrive for Businessに保存 | |
| 音声 | 対応。会話はGPT-Live/Realtime API(入力はtext・audio・image)。録音ファイルは文字起こしAPI(gpt-transcribe等)でmp3・mp4・mpeg・mpga・m4a・wav・webm、1ファイル25MB | 対応。アプリは音声ファイル合計10分(Google AI Pro/Ultraは3時間)。APIは1プロンプト最長9.5時間、1秒32トークン | 一部対応。音声モード(ベータ・全プラン・モバイル/デスクトップ/Web)で会話は可。録音ファイルの読み込みは公式の対応形式一覧に記載なし=未対応 | 一部対応。ディクテーション・読み上げ・リアルタイム音声(有償ライセンス利用者のみ)。会議の録音はTeamsのトランスクリプト経由でCopilotが要約。録音ファイルの直接アップロードは対応形式に記載なし |
| 動画 | 未対応(API)。公式モデルページでgpt-6-astraの入力は「text, image」。ChatGPTアプリ側の動画ファイル対応は、2026年9月22日時点で公式ヘルプを取得できず要確認 | 対応。アプリは1ファイル2GB・合計5分(Google AI Pro/Ultraは1時間)。APIは低解像度で最長3時間・1FPSで抽出・1リクエスト10本・公開YouTube URLも可 | 未対応。公式の対応形式一覧に動画の記載なし | 一部対応。Teams会議の録画は文字起こし経由でCopilotが要約。Stream(Clipchampプレーヤー)の動画はトランスクリプトが100語以上あれば質問可。Video recapは録画されたTeams会議のみ・現時点で英語のみ |
出典(参照日 2026-09-22):OpenAI Images and vision/OpenAI PDF file inputs/OpenAI Speech to text/OpenAI gpt-6-astra/OpenAI gpt-realtime/Gemini API Audio/Gemini API Video understanding/Gemini API Document understanding/Geminiアプリ ファイルのアップロード/Claude Vision/Claude PDF support/Upload files to Claude/Claude Use voice mode/Microsoft Copilot Chat FAQ/File upload in Microsoft Copilot/Copilot in Teams meetings/Copilot in Stream/Video recap in Microsoft Copilot
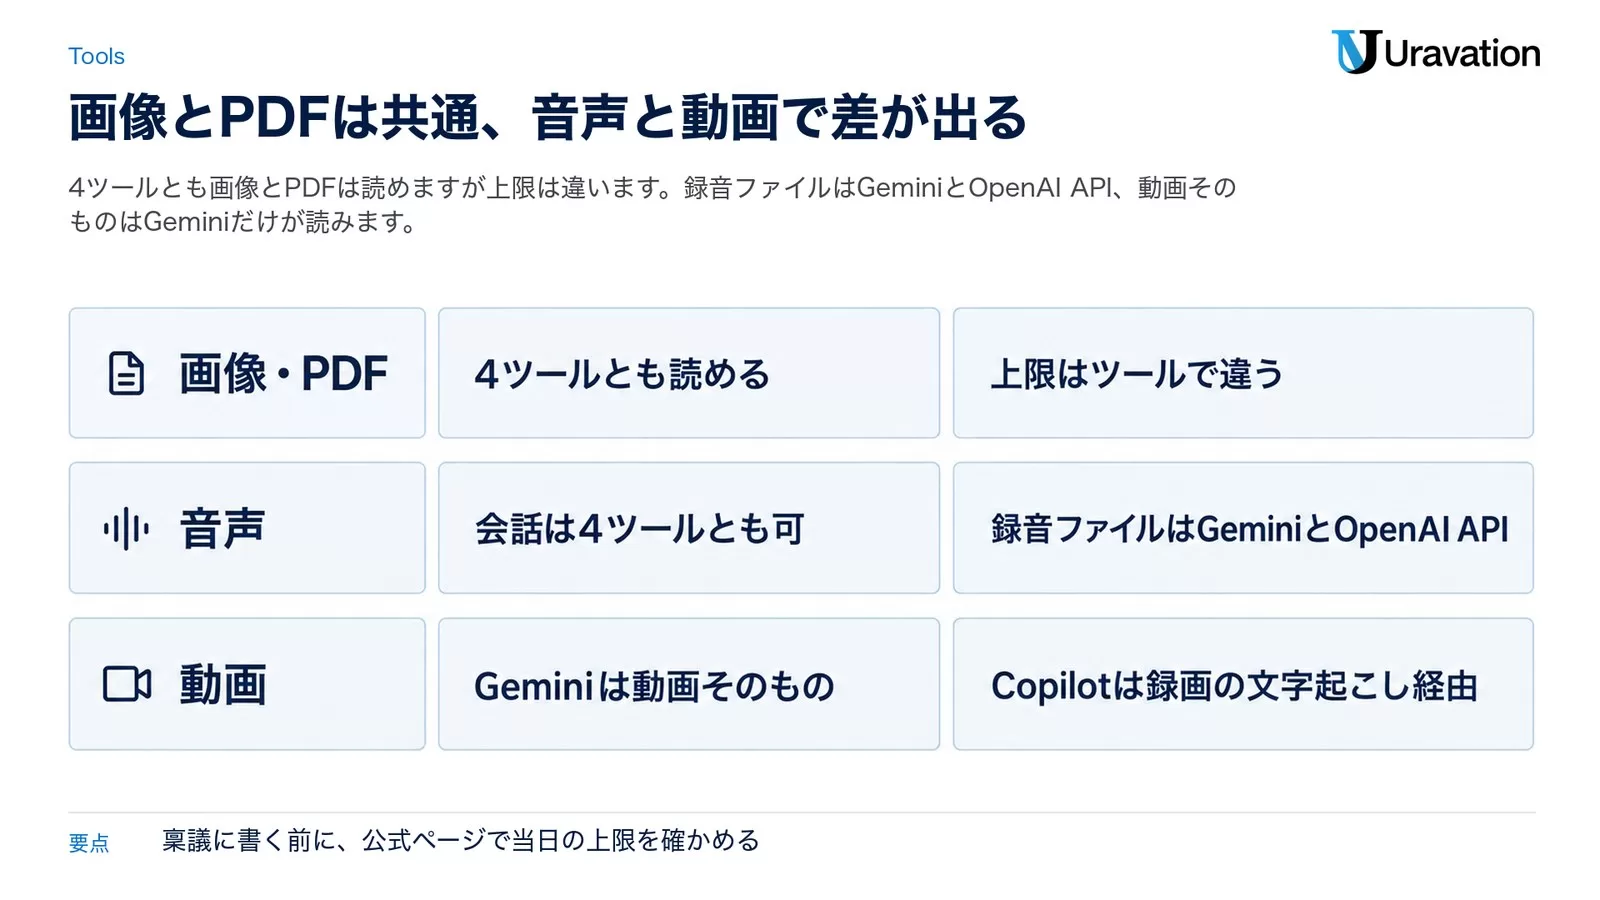
表を一言でまとめると、画像・PDFは「4ツールとも読める」が「上限はツールで違う」、音声は「会話は4ツールとも可」で「録音ファイルはGeminiとOpenAI API」が直接受け付ける、動画は「Geminiは動画そのもの」を読み「Copilotは録画の文字起こし経由」、という位置づけです。
表を読むときの注意3つ
- 「モデルが読める」と「アプリで渡せる」は別。OpenAIはAPIの公式docsで画像・PDF・音声の入力を細かく定義していますが、ChatGPTアプリ側のファイル上限を載せた公式ヘルプは、2026年9月22日時点で当方の環境から取得できませんでした。この記事ではアプリ側の数字を書いていません。
- Microsoftは名称が変わっています。Microsoft Learnの公式ページには「Microsoft 365 Copilot is now named Microsoft Copilot, and Microsoft 365 Copilot Chat is now named Microsoft Copilot Chat」と明記されています(Enterprise data protection・2026-05-29付)。稟議書の製品名は現行表記に合わせてください。なお有償ライセンスなしのCopilot Chatでも、Microsoft Learnの機能一覧にファイルアップロードと画像アップロードが載っています。
- Geminiの公式docsは2026-09-17更新で、例に使われているモデルはgemini-3.8-flashです。モデル名は世代が変わりやすいので、記事ではモデル名より「対応している入力の種類と上限」を見てください。
開発者向けに実装の手順まで踏み込んだものは、姉妹サイトのマルチモーダルAIエージェント実装ガイド 2026にあります。この記事は「定義と業務判断」、あちらは「実装」という役割分担です。
公式が明記する「苦手」|精度の限界を先に知る
マルチモーダルAIは万能ではなく、各社が公式ドキュメントで「苦手」を明記しています。ここを知らずに帳票の金額をそのまま経理システムに流すと事故になります。
OpenAIが公式に書いている制約
OpenAIのImages and visionには、次の制約が列挙されています(参照日 2026-09-22)。
- CTスキャンのような専門的な医用画像の解釈には向かない
- 日本語・韓国語など非ラテン文字のテキストでは最適に動作しない場合がある
- 小さい文字は拡大が必要になることがある
- 回転した文字・上下逆の文字を誤読することがある
- CAPTCHAの送信は安全上ブロックされる
- 正確な空間位置の特定を要する作業は苦手
「日本語で最適に動作しない場合がある」は、日本の帳票を読ませる法人にとって一番重要な一文です。だからこそ、自社の実物で試してから運用に入れる必要があります。
Anthropic(Claude)が公式に書いている制約
ClaudeのVisionドキュメントには、低画質・回転・200ピクセル未満の極小画像では誤りうること、物体の数え上げは概算であること、座標や位置の出力は近似であること、画像内の人物の特定は行わないこと、CTやMRIのような診断画像の解釈には設計されていないこと、AI生成画像かどうかの判定はできないことが書かれています。さらに「高リスクの用途では必ず人が確認すること」と明記されています。
Google(Gemini)が公式に書いている処理の仕組み
Geminiの公式docsは制約というより「どう処理されるか」を具体的に書いています。画像は縦横とも384ピクセル以下なら258トークン、それより大きい画像は768×768のタイルごとに258トークン。PDFは1ページ258トークンで、PDF以外の形式(TXT・Markdown・HTML等)は「純粋な文字として抽出されるので図表は失われる」と明記されています(Document understanding)。つまり「図表を読ませたいならPDFのまま渡す」が公式の答えです。
管理者が先に決めること|学習利用・保持期間・機密区分
写真や録音をAIに渡すというのは、社内のデータを社外のクラウドに送ることです。研修で「写真を読ませていいですか」と聞かれたとき、私が返す答えは「ツールの設定と社内規程の2つが決まっていれば可、どちらかが未定なら不可」です。決めるべき項目は3つあります。
1. 学習利用の設定(ツールごとの公式の記載)
| ツール | 個人向けプランの既定 | 法人向け(Team/Enterprise/Workspace/API) |
|---|---|---|
| OpenAI | ChatGPT個人プランの既定は公式ヘルプを取得できず要確認(2026-09-22時点) | APIは「明示的にオプトインしない限り学習に使わない」と公式docsに明記。不正利用監視のログは最長30日保持、対象顧客はゼロデータ保持を申請可 |
| Geminiアプリは「アクティビティを保存」がオンだと学習に使われ、人による確認もある(アカウントとは切り離される)。既定の保持は18か月、オフにすると72時間 | Google Workspaceは「顧客の許可なく学習に使わない」「組織の外に出さない」と明記。APIは無料枠だと改善に使われる(人が読むこともある)、有料枠は使われない | |
| Anthropic | Claude個人プランは「Help improve Claude」がオプトイン。シークレットチャットは対象外。削除は30日以内、オンにすると匿名化して最長5年保持 | Team/Enterprise/APIは既定で学習に使わない(フィードバック送信は例外)。APIに渡した画像は処理後に自動削除 |
| Microsoft | 個人向けCopilotはアップロードしたファイルを最長18か月保存後に削除、学習には使わない | Entraアカウントでサインインした法人向けCopilot Chatはエンタープライズデータ保護(EDP)の対象。プロンプト・応答・アップロードしたファイルは基盤モデルの学習に使わない。監査・eDiscovery・Purviewの保持ポリシーが適用される |
出典(参照日 2026-09-22):OpenAI Your data/Gemini Apps Privacy Hub/Generative AI in Google Workspace Privacy Hub/Gemini API Additional Terms/Anthropic 個人向け 学習利用/Anthropic 法人向け 学習利用/Anthropic 保持期間/Microsoft Enterprise data protection
ポイントは、「法人契約なら安心」ではなく「個人アカウントで使わせない」です。同じGeminiでも、個人アカウントはアクティビティ設定次第で学習に使われ、Workspaceアカウントは使われません。社員が私物スマホの個人アカウントで請求書の写真を読ませていたら、規程が何を書いていても意味がありません。
2. 保持期間と会議録音の扱い
会議の録音は特に注意が要ります。Teamsの場合、会議後にCopilotへ質問するにはトランスクリプトが必要で、主催者が「会議中のみ」を選ぶと文字起こしや録画を残さずに会議中だけCopilotを使えます。ただし公式ページは「録画とトランスクリプトがオフでも、Copilotのプロンプトと応答はコンプライアンス目的で保持されることがある」とも書いています(Use Copilot without recording a Teams meeting)。「録音していないから残らない」は正しくありません。
3. 機密区分(写真・録音も対象にする)
多くの会社の情報区分は文書を前提に作られていて、写真・録音・図面の画像が区分の対象になっていません。最低限、次の3行を規程に足してください。
- 人の顔・氏名・車両番号・取引先名が写る写真は「個人情報を含む」として扱う
- 図面・設計書・原価が分かる資料は、文書と同じ機密区分を画像にも適用する
- 会議の録音は、参加者に事前告知したうえで、学習利用オフの法人アカウントでのみ処理する
規程全体の作り方はAI利用ガイドライン策定7ステップ|社内ルール雛形付きを参照してください。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
導入判断の4点|精度・費用・データ・現場運用
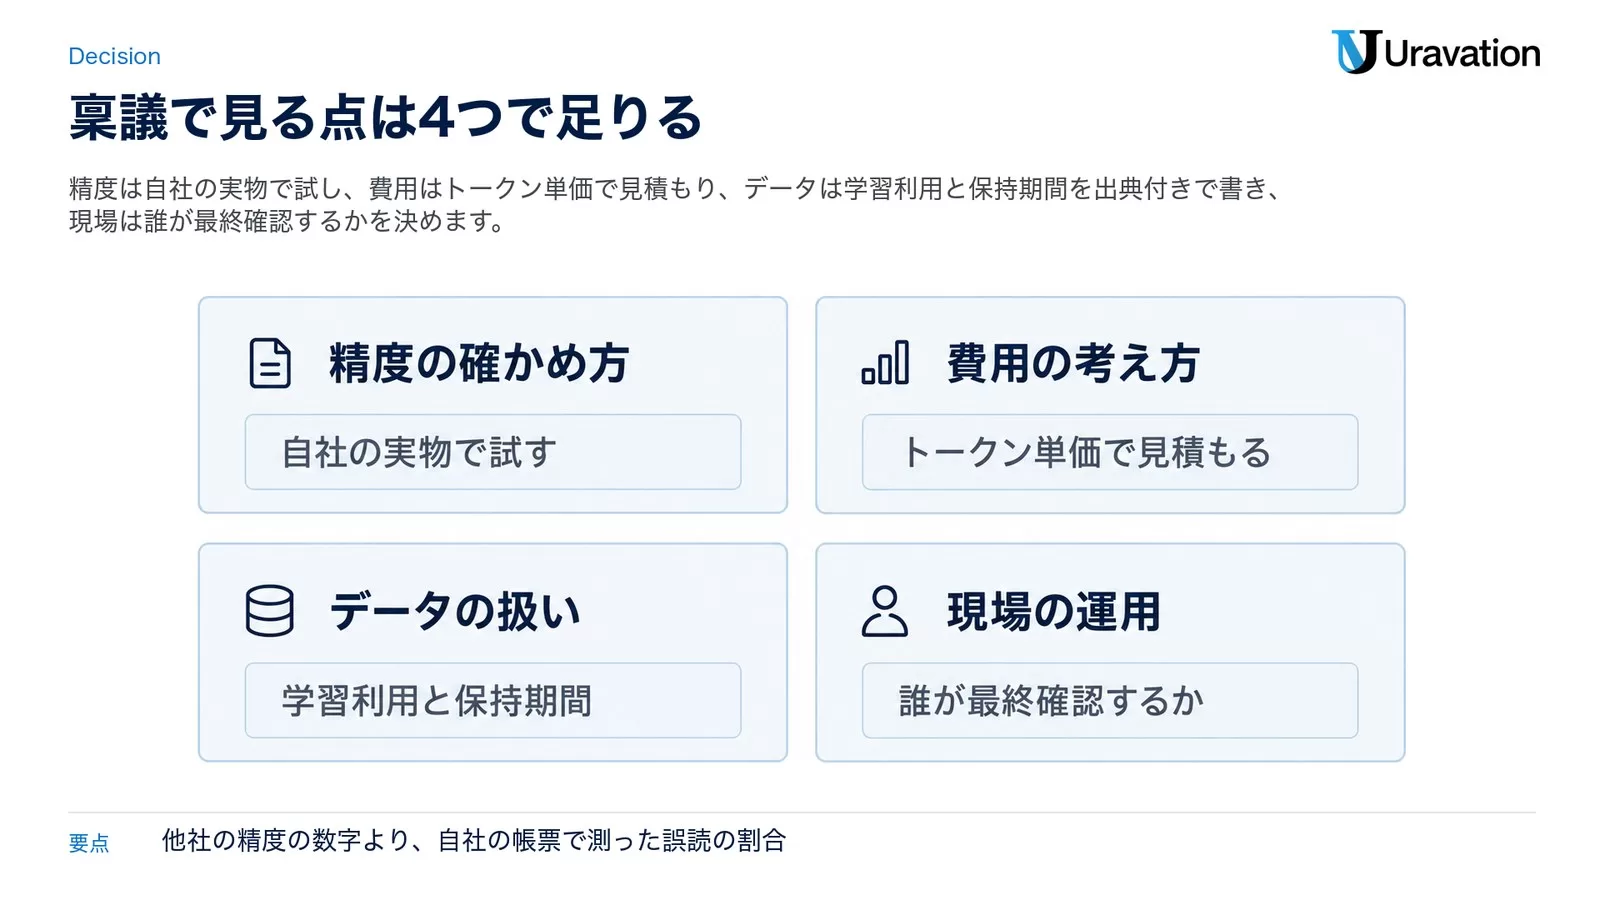
稟議を通すために、経営側が見るべき点は4つに絞れます。
1. 精度の確かめ方=自社の実物で試す
ベンダーの精度の数字より、自社の帳票・写真・録音で試した結果が全てです。手順は、①実物を10〜20件用意する ②学習利用をオフにした法人アカウントで読ませる ③人が原本と突き合わせて「合っていた項目/誤読した項目」を記録する、の3段階です。誤読の割合を記録することが、あとで「どこまで任せるか」を決める根拠になります。
2. 費用の考え方=トークン単価で見積もる
画像・音声・動画の入力は、文字と同じ「トークン」に換算して課金されます。公式に書かれている換算だけ挙げると、Claudeは画像を28×28ピクセルのパッチで数え「⌈幅÷28⌉×⌈高さ÷28⌉」トークン、Geminiは384ピクセル以下の画像で258トークン・音声1秒32トークン・動画は低解像度で1秒あたり約100トークン、PDFは1ページ258トークンです。OpenAIのgpt-6-astraは入力100万トークンあたり10ドル、出力50ドル(公式モデルページ・2026-09-22時点)。円換算は為替で変わるため、この記事では書きません。チャットアプリの法人プランは定額なので、まずはアプリで試し、量が増えてからAPIの見積もりに移る順番が現実的です。
3. データの扱い=学習利用と保持期間
前節の表のとおり、契約形態で扱いが変わります。稟議書には「どのアカウント種別で」「学習利用の設定は何で」「保持期間は何日か」を出典付きで書きます。
4. 現場の運用=誰が最終確認するか
読み取り結果をそのまま基幹システムに流す運用は、公式が「人の確認を」と明記している以上、初期段階では避けます。最終判断は人がする、と決めておくのが出発点です。金額・日付・固有名詞は担当者が原本と突き合わせる、というルールを最初に決めておくと、精度が上がった後に「確認を省く項目」を段階的に増やせます。
まず試す3手|帳票写真→表化・会議録音→議事録・図面写真→不備チェック
研修で実際に使っている手順を、指示文ごとそのまま載せます。どれも「学習利用をオフにした法人アカウント」「機密区分が『社外可』の資料」で試してください。
1手目:帳票の写真を表にする
スマホで撮った請求書の写真を1枚アップロードし、次の指示文を貼ります。
この画像は請求書です。次の項目を表にしてください。
列:発行日/取引先名/品目/数量/単価/金額(税抜)/消費税/合計

ルール:
- 読み取れない文字は推測せず「判読不能」と書く
- 合計が各行の金額の和と一致しない場合は、その旨を表の下に書く
- 数字と固有名詞は、画像のどの位置から読んだかを一言添える
不足している情報があれば、最初に質問してから作業を開始してください。
返ってきた表を原本と突き合わせ、誤読した項目を記録します。この記録が「精度の確かめ方」の材料になります。
2手目:会議の録音を議事録にする
Geminiアプリは音声ファイルを直接、TeamsのCopilotはトランスクリプト経由で渡せます。渡したら次の指示文です。
この会議の音声(または文字起こし)から議事録を作ってください。
構成:
1. 決定事項(箇条書き・決めた人)
2. 宿題(担当者・期限・期限が発言されていなければ「未定」)
3. 未決の論点
4. 次の会議までに確認すること

ルール:
- 発言されていないことを補わない
- 誰の発言か特定できない箇所は「発言者不明」と書く
- 数字・固有名詞は聞き取れた通りに書き、自信がない箇所に「要確認」を付ける
仮定した点は必ず「仮定」と明記してください。
3手目:図面の写真で不備をチェックする
この画像は設計図(または配置図)です。次の観点で不備の候補を挙げてください。
1. 寸法や数値が記載されていない箇所
2. 凡例にない記号
3. 図中の表記ゆれ(同じものを別の名前で呼んでいる)
4. 前版との差分(前版の画像も添付した場合のみ)

ルール:
- 不備と断定せず「候補」として挙げ、根拠を図中の位置で示す
- 判断できない箇所は「判断不能」と書く
数字と固有名詞は、根拠(図中の位置)を添えてください。
追加の2手:PDFの表・グラフと手書きメモ
研修でよく出る質問「PDFの表・グラフはどこまで正確に読むか」には、この指示文で自分の資料を使って確かめてもらっています。
このPDFの3ページ目の表を、そのまま同じ列構成で書き出してください。
そのうえで、
- 表の数値と本文中の数値が食い違っている箇所
- グラフの読み取り値と表の値が食い違っている箇所
を挙げてください。読み取れない箇所は推測せず「判読不能」と書いてください。
手書きメモの整理はこちらです。
この画像はホワイトボードの写真です。
書かれている内容を「ToDo/担当/期限/メモ」の4列の表に整理してください。
判読できない文字は「?」で残し、勝手に補わないでください。
不足している情報があれば、最初に質問してから作業を開始してください。
指示文に毎回「推測しない」「判読不能と書く」と入れているのは、公式が明記する「小さい文字・回転・非ラテン文字の誤読」を、運用側で受け止めるためです。
【要注意】よくある失敗パターンと回避策
失敗1:写真の個人情報を機密区分の対象にしていない
❌ 現場の写真を「ただの写真」として個人アカウントのAIに渡す
⭕ 顔・車両番号・取引先名が写る写真は「個人情報を含む」と区分し、学習利用オフの法人アカウントだけで処理する
なぜ重要か:文書向けに作られた情報区分は、写真と録音を漏らしがちです。区分の対象を「写真・録音も対象にする」と一行足すだけで防げます。
失敗2:図面の機密を「法人契約だから」で済ませる
❌ 法人契約なら何を渡しても大丈夫だと思う
⭕ 契約形態ごとの公式の記載(学習利用・保持期間)を出典付きで稟議に書き、設定画面で確かめる
なぜ重要か:同じサービス名でも個人アカウントと法人アカウントで扱いが違います。「設定画面で確かめる」まで運用に含めます。
失敗3:誤読の検証なしで基幹システムに流す
❌ 読み取った金額をそのまま会計ソフトに転記する
⭕ 実物で精度を測り、誤読の割合を記録してから、確認を省く項目を段階的に決める
なぜ重要か:OpenAIもAnthropicも「日本語・小さい文字・回転」での誤読を公式に認めています。人の確認を残す設計が前提です。
失敗4:OCRで足りる仕事にマルチモーダルAIを当てる
❌ 定型の同じレイアウトの帳票を毎回マルチモーダルAIに読ませる
⭕ レイアウトが固定ならAI-OCR、毎回違う・手書き・写真混じりならマルチモーダルAI、と分ける
なぜ重要か:費用はトークン単価で積み上がります。定型帳票はOCRのほうが安く速いことが多く、マルチモーダルAIは「レイアウトが読めない帳票」に使うのが効きます。
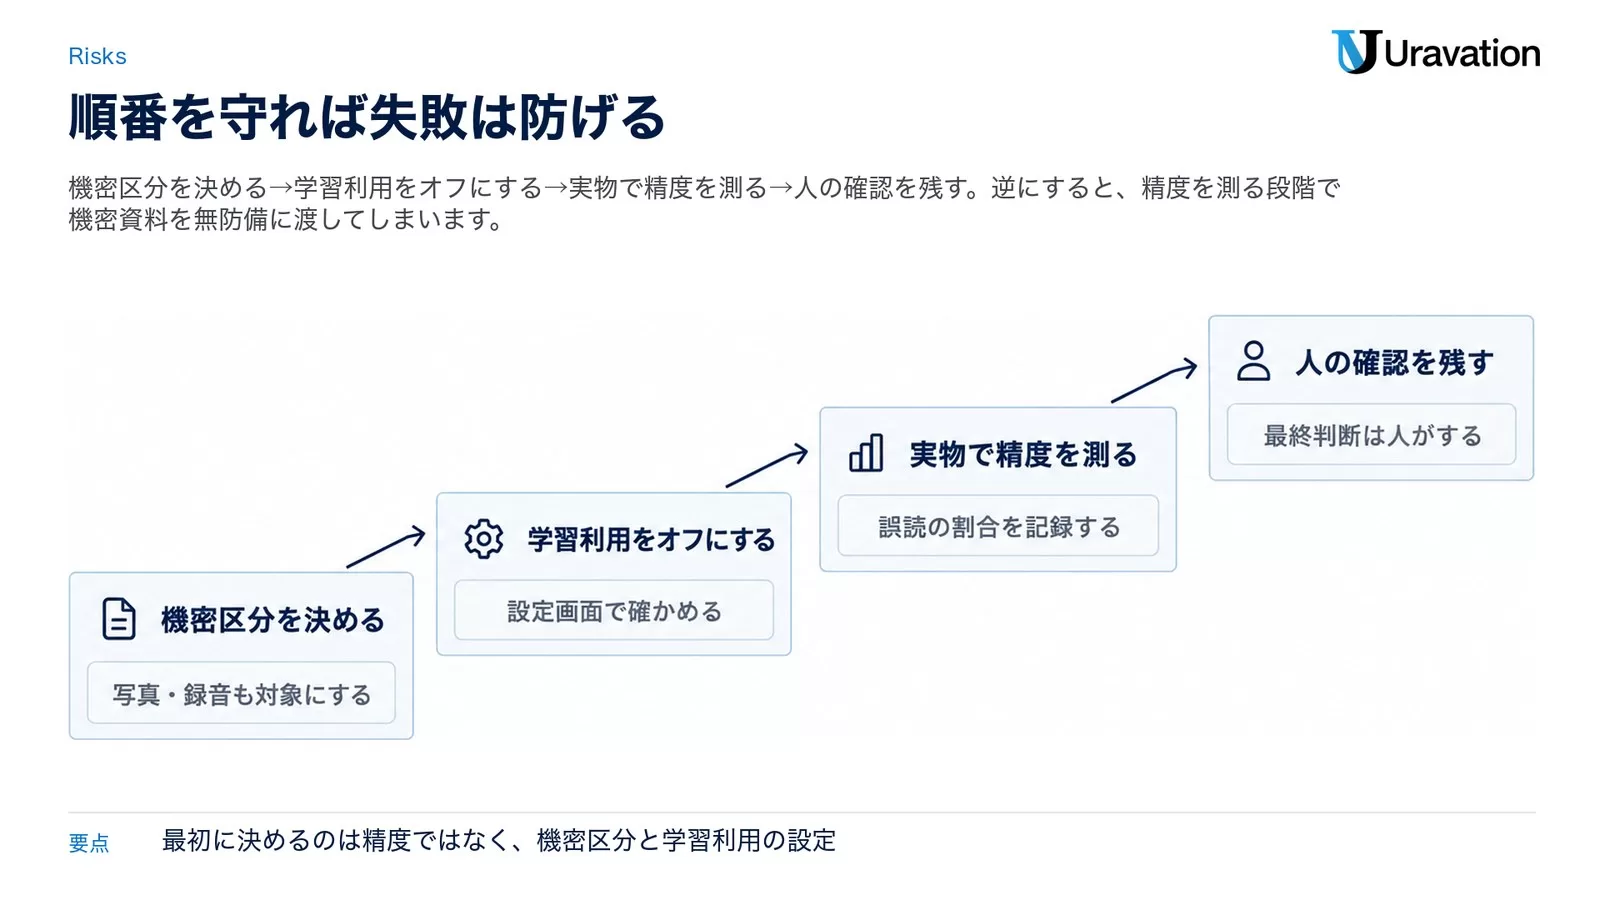
失敗を防ぐ順番は、機密区分を決める→学習利用をオフにする→実物で精度を測る→人の確認を残す、の4段です。この順番を逆にすると、精度を測る段階で機密資料を無防備に渡してしまいます。
Uravationならこう判断する
導入支援と研修で毎回出る3つの質問に、私たちはこう答えています。
「写真や画面キャプチャを読ませてよいか」→ 法人アカウントで学習利用がオフになっていて、その写真の機密区分が「社外クラウド可」なら可。どちらかが未確認なら、確認できるまで不可。
「会議の録音をそのまま要約させてよいか」→ 参加者への事前告知と、録音の保存先・保持期間の確認が済んでいれば可。Teamsなら「会議中のみ」設定でも、プロンプトと応答はPurviewの保持対象になりうることを説明したうえで判断する。
「PDFの表・グラフはどこまで正確に読むか」→ 自社の資料で試して、誤読の割合を記録してから決める。公式が「日本語で最適でない場合がある」と書いている以上、他社の精度の数字は当てにしない。
順番としては、定義(この記事)→ 業務判断(4点)→ 実装です。検索基盤に画像や音声の意味を持たせる実装はGemini Embedding 2入門|5種類の検索統合法、CLIから複数モダリティを扱う実装はMiniMax MMX-CLI完全ガイド|7モダリティに分けて書いています。社内展開の段取りはChatGPT法人導入の手順|プラン選定から社内展開・定着まで5ステップと同じ型で進められます。
よくある質問
マルチモーダルとLLMの違いは何ですか?
LLM(大規模言語モデル)はテキストを学習した言語モデルの呼び名で、マルチモーダルは「画像・音声・動画など複数の入力様式を扱える」という性質の呼び名です。テキストに加えて画像や音声も扱えるLLMを「マルチモーダルLLM」と呼びます。生成AIとの違いも同じで、生成AIは「生成するAI」の総称、マルチモーダルはその入出力の幅を表す言葉です。
マルチモーダルAIとOCRの違いは何ですか?
OCR(AI-OCR)は画像の文字を文字データに変換するところまでが仕事です。マルチモーダルAIは文字化と同時に、表の構造・図の意味・文脈を理解して要約や整形までします。レイアウトが固定の定型帳票はOCRで十分なことが多く、毎回レイアウトが違う帳票や手書き・写真混じりの資料はマルチモーダルAIが向きます。
精度はどこまで信用できますか?
OpenAIは公式に「日本語など非ラテン文字で最適に動作しない場合がある」「小さい文字・回転した文字を誤読することがある」と書き、Anthropicは「低画質・200ピクセル未満の画像で誤りうる」「数え上げは概算」と書いています(参照日 2026-09-22)。金額・日付・固有名詞は人が原本と突き合わせる前提で使い、自社の実物で誤読の割合を測ってから任せる範囲を決めてください。
画像や音声を渡すと追加費用がかかりますか?
チャットアプリの法人プランは定額の範囲で使えるのが一般的です。APIでは画像・音声・動画をトークンに換算して課金され、公式の換算はGeminiで音声1秒32トークン・PDF1ページ258トークン、Claudeで画像1枚「⌈幅÷28⌉×⌈高さ÷28⌉」トークンです。量が増えたらこの換算で見積もり、円換算は当日の為替で確認してください。
研修にはどう組み込めばよいですか?
座学で定義を説明するより、受講者が自分の帳票・会議の文字起こし・図面を持ち込んで「まず試す3手」を実際にやるほうが定着します。前提として、研修用の法人アカウントで学習利用をオフにし、持ち込む資料は機密区分「社外可」に限ることを事前に案内します。研修の設計は法人向けAI研修で相談を受けています。
まとめ:今日から始める3つのアクション
- 今日やること:自社の請求書の写真1枚を、学習利用をオフにした法人アカウントで「1手目」の指示文に通し、原本と突き合わせる。
- 今週中:情報区分の規程に「写真・録音も対象にする」の3行を足し、使っているツールの学習利用設定を設定画面で確かめる。
- 今月中:帳票・会議・図面のうち1業務を選び、10〜20件の実物で誤読の割合を記録して、確認を省ける項目と残す項目を決める。
マルチモーダルは「画像も読める便利な機能」ではなく、社内の写真・録音・図面が社外のクラウドに流れる入り口です。だからこそ、定義を正しく共有し、設定と規程を先に決めたうえで、実物で精度を測る順番が要ります。この記事の対応表と指示文は、そのまま社内会議の資料に使ってください。
社内規程の雛形や研修用のチェックリストは資料ダウンロードから入手できます。ご質問・ご相談はお問い合わせフォームからお気軽にどうぞ。
執筆者
佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・シリーズ累計約6万部)。
SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。
参考・出典
- 令和6年版 情報通信白書 第1章第2節 生成AIのインパクト — 総務省(参照日: 2026-09-22)
- Images and vision/PDF file inputs/Speech to text/gpt-6-astra/gpt-realtime/Your data — OpenAI 公式docs(参照日: 2026-09-22)
- Image understanding/Audio understanding/Video understanding/Document understanding/Gemini API Additional Terms of Service — Google(いずれも2026-09-17更新・参照日: 2026-09-22)
- Geminiアプリ ファイルのアップロード/Gemini Apps Privacy Hub/Generative AI in Google Workspace Privacy Hub — Google(参照日: 2026-09-22)
- Vision/PDF support/Upload files to Claude/Use voice mode/Is my data used for model training?(個人向け)/同(法人向け)/How long do you store my data? — Anthropic(参照日: 2026-09-22)
- Enterprise data protection in Microsoft Copilot and Microsoft Copilot Chat/Frequently asked questions about Microsoft Copilot Chat/File upload in Microsoft Copilot/Get started with Copilot in Microsoft Teams meetings/Use Copilot without transcribing or recording a Teams meeting/Copilot in Stream/How video recap in Microsoft Copilot works — Microsoft(参照日: 2026-09-22)
この記事の内容を社内展開する方へ: 経営者のためのAIエージェント活用ガイド(講演完全版Web資料)(無料・Web資料) をダウンロードできます。