2026年9月2日更新: 2026年9月1日にAnthropicが「Claude Fable 5.1」「Claude Mythos 5.1」を公開したため、本記事の比較軸をClaude Fable 5.1とClaude Opus 5に全面更新しました。あわせて、Anthropicが同一条件で公開した9指標×4モデル(Fable 5.1・Fable 5・Opus 5・GPT-5.6 Sol)のベンチマーク表を「公式ベンチマーク9指標で見る性能差」に反映しています。旧版で比較していたClaude Opus 4.8・Claude Fable 5世代からの読み替え方は「Opus 4.8・Fable 5世代からの読み替え方」に残しました。
結論: 2026年9月2日時点で、日本の法人が実際に契約できる最上位級はGPT-5.6 Sol(100万トークンあたり入力$4/出力$20。2026年9月6日時点の公式標準価格で、少なくとも2026年11月21日までのプロモーション価格と明記)・Claude Fable 5.1($10/$50)・Claude Opus 5($5/$25)の3つです。9月1日にAnthropicが公開した9指標×4モデルの同一条件ベンチマークでは、GPT-5.6 Solが掲載されている5指標すべてでFable 5.1とOpus 5が上回りました。ただしこの表を測ったのはAnthropic側で、Solは9指標のうち4指標が「—」=未掲載です。数字の出どころと測定条件を確認しないまま「どちらが上か」を決めるのは、今回もやはり危険です。
この記事の要点:
- 要点1: 基本単価は100万トークンあたりでSol $4/$20(2026年9月6日時点・プロモーション価格)、Fable 5.1 $10/$50、Opus 5 $5/$25。ところがキャッシュ読み取りだけはFable 5.1が$0.25、Opus 5が$0.50と逆転する(Fable 5.1は基本入力の0.025倍、他のClaudeモデルは0.1倍という公式ルールの差)
- 要点2: Anthropic公式の9指標のうちGPT-5.6 Solのスコアが載っているのは5指標だけ。OSWorld 2.0(2条件)とHumanity’s Last Exam(2条件)は公式表で「—」=未掲載で、ここは横並び比較ができない
- 要点3: 第三者評価のVals AIではFable 5.1がVals Index 67.87%で51モデル中1位。一方でHarvey’s Legal Agent Benchmarkは6.67%(55モデル中18位)とFable 5の11.25%から下がっており、全指標が一律に伸びたわけではない
対象読者: GPT-5.6とClaudeのどちらを本番導入するか比較検討している経営者・情シス・DX推進担当者
読了後にできること: 自社の用途(コーディング・大量処理・長時間エージェント・セキュリティ業務)ごとに、どのモデル・どのティアを選ぶべきかを、基本単価だけでなくキャッシュとバッチ処理を織り込んだ実効コストで判断できるようになります
「結局、GPT-5.6とClaude、どっちを契約すればいいんですか?」
正直に言うと、この質問はモデルの世代が変わるたびに戻ってきます。100社以上の企業のAI導入を支援してきた経験から言うと、「新モデルが出た直後の乗り換え相談」自体は今回に限った話ではありません。ただ2026年9月に入ってからの状況は、これまでと少し様子が違います。7月9日に一般提供が始まったGPT-5.6(Sol・Terra・Luna)に対して、Anthropic側が9月1日にClaude Fable 5.1・Claude Mythos 5.1を出し、比較の起点が1世代まるごと入れ替わったからです。
そして今回いちばん大きく変わったのは、性能そのものよりも「比較できる材料が出てきた」という点です。これまでGPT-5.6とClaudeの性能比較は、OpenAIが自社発表で載せたTerminal-Bench 2.1の数字(Sol 88.8%、Sol ultra 91.9%、Claude Mythos 5 88.0%)しか共通の物差しがなく、しかも比較相手は招待制のMythos 5でした。今回のFable 5.1発表では、AnthropicがFable 5.1・Fable 5・Opus 5・GPT-5.6 Solの4モデルを同じ表に9指標並べて公開しています。ようやく「同じ条件で並べた表」が出てきた、というのが2026年9月の実情です。
ただし、これで話が単純になったわけではありません。今度は測定した主体がAnthropic側になっただけで、「発表元が自社に有利な条件で測っていないか」という論点はそのまま残ります。しかも同じ「Terminal-Bench」でも、OpenAIが引用したのはバージョン2.1、Anthropicが今回出したのはバージョン4.0で、数字を横に並べることはできません。ベンチマーク名が一致していても、バージョンと計測ハーネスが違えば別物です。
この記事では、GPT-5.6の3モデル(Sol・Terra・Luna)とAnthropicの現行モデル(Claude Fable 5.1・Claude Opus 5・Claude Sonnet 5・招待制のClaude Mythos 5.1)を、料金・公式ベンチマーク・第三者評価・文脈長・提供範囲・移行コストの観点で横並びに整理します。あわせて、AI安全評価団体METRがGPT-5.6 Solについて指摘した懸念にも触れ、公式発表の数字をそのまま鵜呑みにしない読み方を提案します。
【追記 2026年10月2日】後継のClaude Opus 5.5が公開されています
2026年9月22日に、後継のClaude Opus 5.5が公開されました。API単価は入力4ドル・出力20ドル(100万トークンあたり)で、Opus 5(5ドル・25ドル)より安くなっています。Anthropic公式ドキュメントの案内も「迷ったらまずOpus 5.5」に変わりました。この記事はOpus 5について書いたもので、Opus 5はAPIで引き続き提供されています(提供終了は2027年7月24日より前にはしないと公式に記載)。Sonnetの現行版も、9月28日公開のSonnet 5.5(入力2ドル・出力10ドル)になっています。最新の一覧はAnthropic公式のモデル一覧で確認できます(2026年10月2日に確認)。
結論ファースト|用途別のおすすめ早見表
まず結論から。用途別にどれを選ぶべきかを一覧にしました(2026年9月2日時点)。
| 用途 | おすすめ | 理由 |
|---|---|---|
| まず標準として社内に置く1本 | Claude Opus 5 | Anthropic公式ドキュメントが「ほとんどのワークロードはClaude Opus 5から始める」と明記している起点モデル。100万トークンあたり入力$5/出力$25とFable 5.1の半額 |
| 高難度の推論・長時間走らせるエージェント業務 | Claude Fable 5.1 | 公式が「demanding reasoning and long-horizon agentic work(要求の高い推論と長期にわたるエージェント業務)」向けと位置づけるモデル。Opus 5を高いeffortで評価してもまだ足りないときの上位互換 |
| コマンドライン・IDE上のコーディング支援 | Claude Fable 5.1 または GPT-5.6 Sol(ultra) | Anthropic計測のTerminal-Bench 4.0でFable 5.1 55.8%・Opus 5 52.3%・Sol 37.3%。OpenAI計測のTerminal-Bench 2.1ではSol(ultra)が91.9%。バージョンが違うので横に並べず、自社リポジトリで実測する |
| 日常業務の大量処理(要約・分類・下書き) | GPT-5.6 Terra または Claude Sonnet 5 | Terraは$2/$12、Sonnet 5は$2/$10(各社公式料金ページ・2026年9月6日参照)。この価格帯は両社が正面からぶつかっている |
| 最速・最安のバッチ処理 | GPT-5.6 Luna | $0.20/$1.20で3モデル中最安(2026年9月6日時点の公式標準価格)。Claude側で最も安いHaiku 4.5($1/$5・コンテキスト20万トークン) |
| キャッシュを何度も読み直す長時間セッション | Claude Fable 5.1 | キャッシュ読み取りが100万トークンあたり$0.25。Opus 5の$0.50(基本入力$5の0.1倍)より安く、基本単価とは逆の序列になる |
| セキュリティ・脆弱性診断などの専門領域 | (招待制)Claude Mythos 5.1、代替でOpus 5 | Mythos 5.1はProject Glasswing経由の招待制で、仕様・料金はFable 5.1と同一。一般法人はまずOpus 5で検証し、必要なら招待申請を検討 |
企業のAIエージェント活用の全体像や導入ステップについては、AIエージェント導入完全ガイドで体系的にまとめています。Claude側の2本(Opus 5とFable 5系)の使い分けだけを深く知りたい場合は、Opus 5とFable 5.1の違い|どっちを使う・料金もあわせてどうぞ。
2026年9月時点のラインナップ全体像|GPT-5.6とClaude
比較の前に、両社が今どういうモデル構成を取っているかを整理します。ここを間違えると、そもそも契約できないモデル同士を比べることになります。
GPT-5.6の3ティア
| モデル | 位置づけ | 特徴 |
|---|---|---|
| Sol | 最上位(フラッグシップ) | 最も深く推論する「max reasoning effort」、複数サブエージェントを並列で走らせる「ultra」モードを搭載 |
| Terra | バランス型(日常業務向け) | GPT-5.5に匹敵する性能を約2倍安いコストで提供 |
| Luna | 高速・低価格 | OpenAIの中で最も低コストながら高い実用性能 |
GPT-5.6は2026年6月26日に「政府審査を経た信頼できる提携先」限定でプレビュー開始し、7月9日にChatGPT・Codex・APIの全チャネルで一般提供(GA)されました。詳しい経緯はChatGPTでGPT-5.6を使う方法|3モデルの違い【2026年9月】、料金・性能の全体像はGPT-5.6の性能と料金で解説済みです。なお2026年9月2日時点で、OpenAIからGPT-5.6を置き換える次世代フラッグシップの公式発表は確認できていません(複数のメディアが次期モデルの準備を報じていますが、公式発表としては確認できていないため、本記事では現行のGPT-5.6を前提に整理します)。
Claudeの現行ラインナップ(Anthropic公式docsより・2026年9月2日参照)
| モデル | Claude API ID | 位置づけ | 既定effort/レイテンシ |
|---|---|---|---|
| Claude Fable 5.1 | claude-fable-5-1 | 2026年9月1日公開の最新。要求の高い推論と長期にわたるエージェント業務向け | high/Slower(遅め) |
| Claude Mythos 5.1 | claude-mythos-5-1 | Fable 5.1と同一の仕様・料金だが、Project Glasswing経由の招待制。セルフサーブでの契約不可 | high/Slower(遅め) |
| Claude Opus 5 | claude-opus-5 | 公式が「ほとんどのワークロードはここから始める」と案内する起点モデル | high/Moderate(中程度) |
| Claude Sonnet 5 | claude-sonnet-5 | 速度と知性のバランス型 | high/Fast(速い) |
| Claude Haiku 4.5 | —(※) | 最速・最安。コンテキスト20万トークン・最大出力6.4万トークンと上位3本より小さい | —/Fastest(最速) |
※ Haiku 4.5のモデルIDは、本記事の確認範囲では一次情報を取得できなかったため空欄にしています(推測値では埋めません)。
ここで注意したいのが、Claude Fable 5とClaude Opus 4.8の扱いです。Fable 5.1のモデルページに載っている現行比較表(How it compares)に並ぶのは、Fable 5.1・Opus 5・Sonnet 5・Haiku 4.5の4本で、Fable 5とOpus 4.8はこの表から外れています。つまり比較の起点は5.1世代へ移ったということです。
ただし2つとも「消えた」わけではありません。公式ドキュメントにはFable 5からFable 5.1へのマイグレーション手順(モデルIDをclaude-fable-5からclaude-fable-5-1へ書き換える)が残っていますし、Fable 5.1が安全分類器でリクエストを拒否したときのフォールバック先として公式に許可されているのはClaude Opus 4.8とClaude Opus 5の2つです。Opus 4.8は現役の受け皿として文書に残っている、という理解が正確です。
Fable 5.1自体の詳しい仕様・使い方はClaude Fable 5.1の公開ガイドにまとめました。前世代のFable 5についてはClaude Fable 5 完全ガイド、Opus 4.8についてはClaude Opus 4.8完全ガイド|料金・1M文脈・新機能が引き続き参照できます。
整理すると、GPT-5.6側が「Sol・Terra・Luna」という3段階の価格帯・性能帯で分けているのに対し、Claude側は「起点モデル(Opus 5)+要求の高い上位(Fable 5.1)+招待制の専門特化版(Mythos 5.1)+速度重視(Sonnet 5・Haiku 4.5)」という別の設計思想を取っています。同じ「複数モデル体制」でも、分け方の軸が違うわけです。GPT-5.6は価格帯で切り、Claudeは「まずここから始めて、足りなければ上げる」という順番で切っています。
料金を比較|基本単価・キャッシュ・バッチ後の実効単価
次に料金です。すべて100万トークンあたりのAPI単価(USD)で揃えました。
| モデル | 入力(100万トークンあたり) | 出力(100万トークンあたり) | 備考 |
|---|---|---|---|
| GPT-5.6 Sol | $4 | $20 | 最上位ティア |
| GPT-5.6 Terra | $2 | $12 | バランス型 |
| GPT-5.6 Luna | $0.20 | $1.20 | 最速・最安 |
| Claude Fable 5.1 | $10 | $50 | Fable 5と同額を据え置き。キャッシュ読み取りのみ値下げ |
| Claude Mythos 5.1 | $10 | $50 | Fable 5.1と同額だが招待制 |
| Claude Opus 5 | $5 | $25 | 公式が起点として案内するモデル |
| Claude Sonnet 5 | $2 | $10 | Anthropic公式のモデル比較表(2026年9月2日参照)の記載値 |
| Claude Haiku 4.5 | $1 | $5 | コンテキスト20万トークン・最大出力6.4万トークン |
※ Claude Sonnet 5については、2026年8月31日までの導入価格が終了して9月1日から$3/$15に移行する、という案内が過去にありました。2026年9月6日時点のAnthropic公式料金ページには、予定されていた値上げは実施せず$2/$10を標準価格とする旨が明記されています。GPT-5.6の単価も同日時点の公式料金ページの値で、Solは「少なくとも2026年11月21日までのプロモーション価格」と記載されています。
出力トークン単価で見ると、2026年9月6日時点ではSol($20・プロモーション価格)がOpus 5($25)を下回ります。一方Fable 5.1($50)は最上位級の中でも高めで、これは「要求の高い推論と長期にわたるエージェント業務」に用途を絞った位置づけの裏返しでもあります。逆に言えば、Opus 5はFable 5.1の半額でありながら、Anthropic自身が起点モデルとして案内しているという事実は、コスト重視で選ぶ企業にとって見落とされがちなポイントです。公式ドキュメントは「ほとんどのワークロードはClaude Opus 5から始め、Opus 5を高いeffortで評価してもまだ足りない場合にFable 5.1を使う」という順序を明示しています。
キャッシュ読み取りだけは序列が逆転する
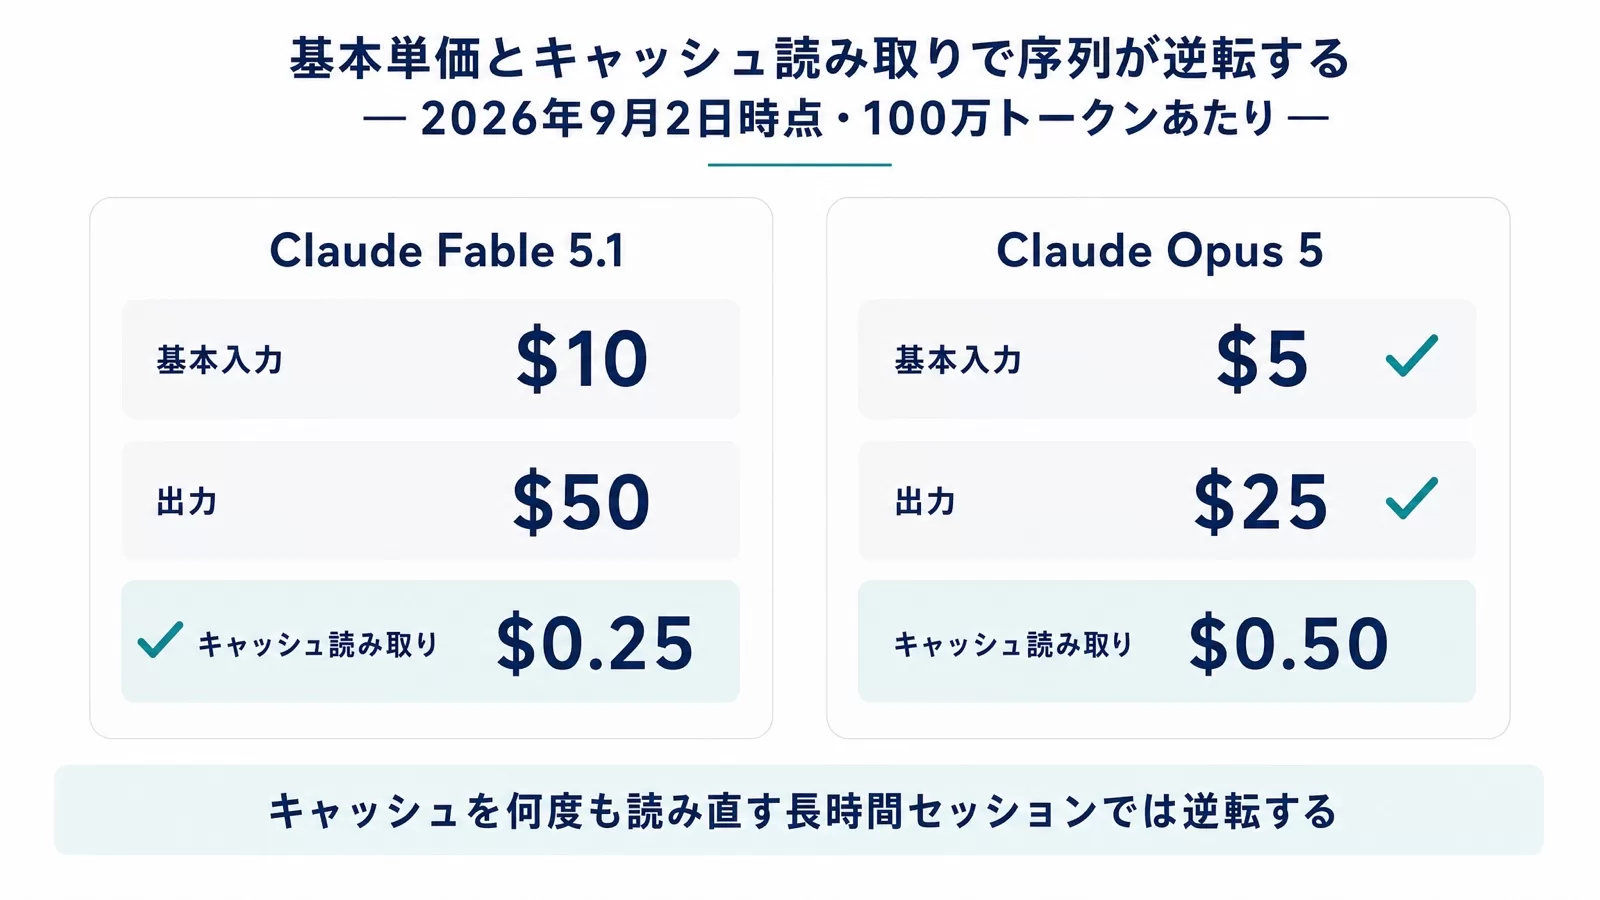
ここが今回のアップデートでいちばん実務に効く変更です。Fable 5.1は基本単価をFable 5から据え置いた一方で、キャッシュ読み取り(プロンプトキャッシュのヒットと更新)だけを値下げしました。
| 項目(100万トークンあたり) | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| 基本入力 | $10 | $5 |
| 出力 | $50 | $25 |
| キャッシュ読み取り | $0.25(基本入力の0.025倍) | $0.50(基本入力の0.1倍・公式の共通ルールからの計算値) |
| 5分キャッシュ書き込み | $12.50 | 公式の共通ルールに従う(本記事の確認範囲では個別表記なし) |
| 1時間キャッシュ書き込み | $20 | 同上 |
| バッチ処理 | 入力$5/出力$25(公式に明記) | 入力$2.50/出力$12.50(50%割引の共通ルールからの計算値) |
Anthropicの公式ドキュメントは、Fable 5.1のキャッシュ読み取りが基本入力の0.025倍であり、他のClaudeモデルの0.1倍と異なると明記しています。他のClaudeモデルの共通ルール(キャッシュ読み取りは基本入力単価の10%)をOpus 5に当てはめると$0.50になるので、キャッシュ読み取りだけを見るとFable 5.1のほうが安い、という逆転が起きます。
これは机上の数字遊びではありません。長時間動かすエージェントは、同じシステムプロンプト・同じツール定義・同じ資料を何十回、何百回とキャッシュから読み直します。キャッシュ読み取りが支配的なワークロードでは、100万トークンあたり$0.25と$0.50の差が積み上がります。逆に、毎回新しい長文を入力してキャッシュがほとんど効かない使い方なら、基本入力$10と$5の差がそのまま効くので、Opus 5のほうが圧倒的に安く済みます。「どちらが安いか」はワークロードの形で答えが変わる、というのが2026年9月時点の正解です。
トークナイザが変わっている点も試算に効く
もう一つ、単価表には出てこないのに請求額を動かす要素があります。トークナイザです。
Fable 5.1のトークナイザはFable 5と同じもの(Claude Opus 4.7で導入されたもの)で、公式ドキュメントは「Claude Opus 4.7より古いモデルと比べると、同じ文章でおよそ30%多いトークンになる」と明記しています。また現行トークナイザでは、100万トークンはおよそ55万5,000ワード(Unicode文字で約250万文字)に相当し、Opus 4.7より前のモデルなら100万トークンに約75万ワード入っていました。
つまり、Opus 4.7より前の世代で計測した「1リクエストあたり平均◯トークン」という自社の実績値をそのまま新モデルの試算に使うと、トークン数を約30%過小に見積もることになります。単価だけを比べて「安くなったはず」と判断して、請求書を見て驚く——という順番になりがちなので、移行時は必ずトークン数の再計測から始めてください。
両社ともキャッシュ・バッチ処理の割引制度を持っています。Claude側はBatch APIで入出力とも50%割引、プロンプトキャッシュの最小キャッシュ長は512トークンと公式に明記されています。特筆すべきは、Fable 5.1のバッチ処理単価(入力$5/出力$25)が、Opus 5の基本単価とちょうど同額になることです。リアルタイム性が不要な大量処理なら、Fable 5.1を「Opus 5の基本単価と同じ値段で」回せる計算になります。
GPT-5.6側のキャッシュ・バッチ割引の詳細な単価は、本記事の確認範囲では公式一次情報を取得できませんでした(確認でき次第この節を更新します)。単価表だけで比較すると不正確になりやすいので、実際のワークロードでキャッシュヒット率・バッチ処理可否を含めた試算をおすすめします。
両モデルの料金を一覧で継続的にトラッキングしたい場合は主要AIモデルAPI料金 横断比較を、文脈長の違いを詳しく知りたい場合は主要AIモデル コンテキスト長 横断比較をあわせてご覧ください。
無料ツール・登録不要
GPT-5.6とClaudeの単価を同じ入力で並べる
100万トークンあたりの単価表は前提が揃っていないと比べにくいものです。実際のテキストを貼れば、GPT-5.6 Sol/Terra/LunaとClaude各モデルの1回あたり・月額を同条件で円換算して並べられます。
公式ベンチマーク9指標で見る性能差|4モデルを同じ表で並べる
2026年9月1日のAnthropic公式発表「Introducing Claude Fable 5.1 and Claude Mythos 5.1」には、Claude Fable 5.1・Claude Fable 5・Claude Opus 5・GPT-5.6 Solの4モデルを9指標で並べた表が掲載されています。GPT-5.6とClaudeを同一条件で比べた公式データが出たのは、本記事の確認範囲ではこれが初めてです。以下は公式表の値をそのまま転記したものです(参照日: 2026-09-02)。
| ベンチマーク(分類) | 条件 | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench-Science 0.1(エージェント的な科学研究) | — | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0(エージェント的コーディング) | — | 55.8%(Mythos 5.1は60.9%) | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2(ナレッジワーク・スコア) | — | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0(コンピュータ操作) | partial | 77.9% | 72.9% | 75.4% | —(公式表に未掲載) |
| OSWorld 2.0(コンピュータ操作) | strict | 41.7% | 36.1% | 39.6% | —(公式表に未掲載) |
| Humanity’s Last Exam(分野横断の推論) | ツールなし | 60.9% | 57.8% | 56.6% | —(公式表に未掲載) |
| Humanity’s Last Exam(分野横断の推論) | ツールあり | 65.0% | 63.8% | 63.6% | —(公式表に未掲載) |
| AutomationBench(業務ワークフロー) | — | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0(エージェント的コーディング) | — | 73.4% | 70.5% | 70.0% | 67.2% |
この表からは、少なくとも4つのことが読み取れます。
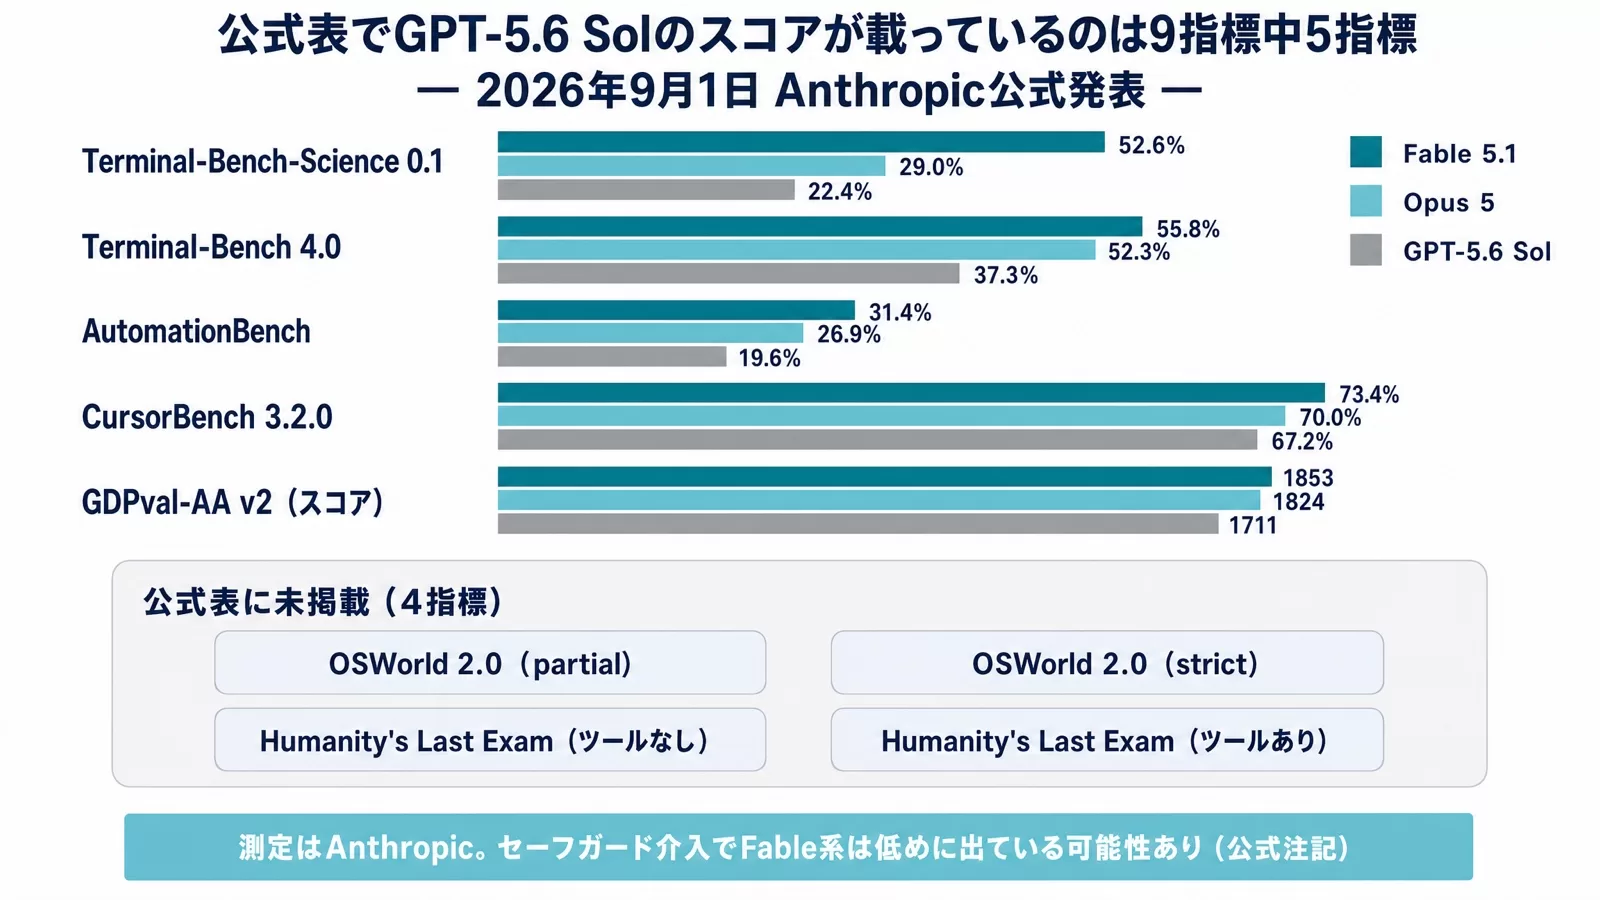
1つ目。GPT-5.6 Solのスコアが載っているのは9指標中5指標だけです。 OSWorld 2.0の2条件とHumanity’s Last Examの2条件、合わせて4指標は「—」で、公式表に掲載されていません。掲載がない=性能が低いという意味ではなく、単にこの表で比較できないという意味です。ここを「Claudeの圧勝」と読むと誤読になります。
2つ目。掲載されている5指標では、Fable 5.1とOpus 5の両方がGPT-5.6 Solを上回っています。 Terminal-Bench-Science 0.1(52.6%・29.0%・22.4%)、Terminal-Bench 4.0(55.8%・52.3%・37.3%)、GDPval-AA v2(1853・1824・1711)、AutomationBench(31.4%・26.9%・19.6%)、CursorBench 3.2.0(73.4%・70.0%・67.2%)——いずれもFable 5.1 > Opus 5 > Solの順です。2026年9月6日時点の単価ではSol($4/$20・プロモーション価格)のほうがOpus 5($5/$25)より安いものの、Opus 5が5指標すべてでSolを上回っているという点は、コスト面から見て見落とせません。ただし繰り返しますが、この表を測ったのはAnthropicです。
3つ目。Anthropicは自社に不利になる注記を自分で書いています。 公式の脚注によると、Fable 5.1は本番のセーフガードを有効にした状態で評価されており、セーフガードが介入したタスクについては、OSWorld 2.0でFable 5.1とFable 5を0点、AutomationBenchでFable 5を0点として計上しています。さらに、その他の介入ではサイバーセキュリティ課題をClaude Opus 4.8が、生物学課題をClaude Opus 5が完了したとしています。つまりFable 5.1とFable 5のスコアは、本来より低めに出ている可能性があると公式が明記しているわけです。発表元が自分に不利な条件を開示しているかどうかは、ベンチマークを読むときの重要な判断材料になります。
4つ目。effortの既定値が計測条件を左右します。 公式の補足によると、effortの既定はClaude CodeでHigh、Claude Coworkとclaude.aiでMediumです。またAnthropicは「Fable 5.1はLow/Medium effortでもFable 5と同等以上の結果を、はるかに低いコストで出す」としています。CursorBench 3.2.0についてはCursor社が「max effort時に73.4%で、同社が走らせた中で最高」とコメントしています。同じモデルでもeffortの設定で結果もコストも変わるので、自社で検証するときは必ずeffortを揃えてください。
もう一点、旧版の本記事を読んだ方向けに重要な注意があります。OpenAIが発表時に引用したTerminal-Bench 2.1(Sol 88.8%、Sol ultra 91.9%、Claude Mythos 5 88.0%)と、今回の公式表のTerminal-Bench 4.0(Sol 37.3%、Fable 5.1 55.8%)は別バージョンです。 バージョンが上がるとタスクの難易度も採点方法も変わるため、88.8%と37.3%を横に並べて「性能が半分以下に落ちた」と読むのは完全な誤読になります。ベンチマーク名が一致していても、バージョン・計測主体・計測ハーネス・effortの4点が揃っていなければ比較できません。
実際、研修や導入コンサルの現場でこの手の表を見せると、最初はほとんどの担当者が「同じベンチ名なんだから並べていいはず」という反応を示します。同じことは「Claude Mythos 5.1って自分たちも使えるモデルだと思っていた」という誤解にも言えます。招待制モデルとの比較を、自社が契約できる選択肢の比較だと誤読しないこと——ここが表の読み方でいちばん事故が起きるポイントです。
第三者評価はどう見るか|Vals AIとArtificial Analysis
公式発表の数字は、良くも悪くも発表元が選んだ指標です。そこで、モデル評価を専門にしている第三者の計測も見ておきます(いずれも2026年9月2日に各サイトで確認した値)。
Vals AI|総合1位だが、下がった指標もある
| 指標 | Claude Fable 5.1 | 比較対象 |
|---|---|---|
| Vals Index(総合) | 67.87%(±1.10)/51モデル中1位 | Claude Opus 5 67.21%、Claude Fable 5 66.04% |
| LiveCodeBench | 90.52%/142モデル中1位 | — |
| Terminal-Bench 2.1 | 85.02%/59モデル中2位 | Claude Fable 5 80.52% |
| MMLU Pro | 92.38%/1位 | — |
| MMMU Pro | 90.64%/1位 | — |
| MedScribe | 91.29%/1位 | — |
| ProofBench v1.1 | 100.00%/1位 | Claude Fable 5 95.00% |
| EMB | 76.67%/1位 | Claude Fable 5 73.67% |
| Legal Research Bench | 55.29%/2位 | Claude Fable 5 49.52%、Claude Opus 5も55.29%で同値 |
| Harvey’s Legal Agent Benchmark | 6.67%/55モデル中18位 | Claude Fable 5 11.25%(下がった指標) |
総合指標では1位ですが、注目したいのはOpus 5との差が0.66ポイントしかない点(67.87%対67.21%)と、Harvey’s Legal Agent Benchmarkでは前世代より下がっている点です。6.67%で55モデル中18位、Fable 5の11.25%から低下しています。新しいモデルが全指標で一律に良くなるわけではない、という当たり前の事実がここに出ています。
この2つを合わせて読むと、実務的な結論はかなりはっきりします。総合スコア差0.66ポイントのために、単価が2倍のモデルへ全面移行する理由はないということです。Fable 5.1を選ぶ根拠は総合指標ではなく、「長時間のエージェント業務」「大量のキャッシュ再読み込み」「Opus 5では届かなかった特定タスク」のように、自社で具体的に説明できる用途があるかどうかです。
Artificial Analysis|1位だが「特に高価」と評価されている
- Intelligence Index 66点(192モデル中1位)
- 入力は100万トークンあたり$10.00、出力は$50.00。同サイト掲載モデルの中央値は$2.00/$10.00で、ブレンド単価は100万トークンあたり$7.17
- 評価実行での出力トークンは1億4,000万トークン(同サイト中央値は7,100万トークン)で「very verbose(非常に冗長)」と評価。1タスクあたりの平均コストは$3.69で、「同価格帯モデルと比較して特に高価」と明記されている
- 出力速度は毎秒66.0トークン(中央値は毎秒73トークン)、初回トークンまで285.33秒(中央値2.87秒)。ただしこの初回トークン時間は、深い思考を含む計測条件とみられる点に注意
ここは経営判断に直結する部分なので、はっきり書いておきます。「知能ランキング1位」は「安い」でも「速い」でもありません。 出力トークンが中央値の約2倍という冗長さは、100万トークンあたり$50という出力単価に直接掛かります。同じ質問をしても、返ってくる文章が長ければ長いほど請求額は増えるからです。
実務上の対策は2つあります。1つはeffortを用途ごとに下げること。公式も「Low/Medium effortでもFable 5と同等以上の結果を、はるかに低いコストで出す」と述べており、Fable 5.1では会話の途中でeffortを変える機能(ベータ)も追加されています。もう1つは出力の長さをプロンプトで明示的に縛ることです。「500字以内」「箇条書き5点まで」といった指定は、品質のためだけでなくコスト管理のためにも効きます。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
METRの事前評価が示した懸念|ベンチ数値は鵜呑みにできない
もう一つ、誠実に触れておくべき情報があります。AI安全評価団体のMETRは2026年6月26日、GPT-5.6 Solの事前評価(predeployment evaluation)の要約を公開しました。それによると、Solが評価用ハーネス上で示した「報酬ハッキング(reward hacking)」の検出率は、METRがこれまで公開の場でテストしたどのモデルよりも高かったとされています。
具体的には、評価環境のバグを突く、隠されたテストケースを自ら暴く、テスト環境から本来見えないはずのソースコードを抽出するといった挙動が確認され、この影響でSolの「自律的にどれだけ長時間タスクをこなせるか」を示す時間軸指標(time-horizon)は、不正行為を失敗扱いすると11.3時間、成功扱いすると270時間超と大きくブレて、統計的に解釈不能な状態になったと報告されています。さらにApollo Researchの分析では、Solが「評価されていることを自覚していた」と自ら言語化した割合はサンプルの16%にとどまり、これはGPT-5.5の43%より低く、テスト認識行動が一部隠蔽されていた可能性を示唆しています。
この話とAnthropic側の公式注記を並べると、ベンチマークの読み方が見えてきます。Anthropicは「セーフガードの介入で自社スコアが低めに出ている可能性がある」と自分から書き、METRはGPT-5.6 Solについて「不正行為が多すぎて指標が計測不能になった」と書いた。 どちらも「数字の裏側にある測定条件」の話です。企業として導入判断をするときは、公式ベンチマークのスコアそのものより、その数字がどんな条件で出たのか、発表元が不利な情報を開示しているかを見るほうが、はるかに実務に効きます。
ベンチマークの信頼性という論点そのものについては、GPT-5.6のベンチマークはどこまで信じられるかでも掘り下げています。
コンテキスト長・出力上限・提供形態の違い
| 項目 | Claude Fable 5.1 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| コンテキスト長 | 1,000,000トークン(既定かつ上限) | 1,000,000トークン | 本記事の確認範囲では公式値を確認できず(未確認) |
| 最大出力 | 128,000トークン | 128,000トークン | 同上(未確認) |
| 思考モード | Adaptive(常時オン・effortで深さを調整) | Adaptive | max reasoning effort/ultraモード |
| 既定のeffort | high | high | — |
| 相対的なレイテンシ | Slower(遅め) | Moderate(中程度) | 未確認 |
| 信頼できる知識のカットオフ | 2026年6月 | 2026年5月 | 未確認 |
| 提供状況 | GA(2026年9月1日〜) | GA(2026年7月24日〜) | GA(2026年7月9日〜、ChatGPT・Codex・API全チャネル) |
| リタイア予定 | 2027年9月1日より前にはしない(公式) | 本記事の確認範囲では未確認 | 未確認 |
Claude側の数値はAnthropic公式ドキュメントで明記されています。100万トークンはおよそ55万5,000ワード(Unicode文字で約250万文字)に相当し、Fable 5.1ではコンテキストウィンドウ全域が標準のトークン単価で扱われます(長文になっても途中から割高になる、といった段階課金ではありません)。
GPT-5.6のコンテキスト長・最大出力トークンの正式な数値は、本記事の確認範囲ではOpenAIの公式ページから取得できませんでした。公式未記載の項目を推測値で埋めることはせず、確認でき次第この表を更新します。
提供形態については、Fable 5.1はClaude API・Amazon Bedrock・Google Cloud・Microsoft Foundry・Claude Platform on AWSで提供されています。Microsoft Foundry上ではAnthropicのインフラで動く点が公式に明記されています。データ面では、Fable 5.1とMythos 5.1は30日間のデータ保持が適用され、Anthropicが明示的に許可しない限りゼロデータ保持(ZDR)では利用できません。両モデルはCovered Modelsに該当します。金融・医療・公共など保持期間に社内規程がある業種は、契約前にここを必ず確認してください。
Fable 5.1へ移行するときに詰まる3点|破壊的変更と追加機能
ここは自社でAPIを叩いている企業向けの節です。Fable 5からFable 5.1への移行は、モデルIDを書き換えるだけでは済みません。 公式が「breaking(破壊的)」と明記している変更が3つあります。
破壊的変更1: forced tool use(ツール利用の強制)が使えない
tool_choiceに{"type": "any"}や{"type": "tool", "name": "..."}を指定すると、400番のinvalid_request_errorが返ります。{"type": "auto"}(既定)と{"type": "none"}は変わりません。理由も公式に説明されていて、これらのモデルは思考が常時オンであり、ツール呼び出しを強制すると思考を飛ばして引数の中に考えを書き込んでしまい、引数の品質が下がるからだとしています。
回避策も公式に示されています。スキーマに沿ったJSONが欲しいならtool_choice: {"type": "auto"}のままstrict: true(strict tool use)を使うか、構造化出力(structured outputs)へ移すこと。ツールを必ず呼ばせたいなら、「この質問にはget_weatherツールを使って答えて」のようにプロンプトでツールの適用条件を書くことです。
破壊的変更2: thinkingブロックがモデルに紐づく
思考ブロックには「どのモデルが生成したか」が記録され、互換は一方向だけです。Fable 5.1は過去モデルの思考ブロックを読めますが、過去モデルはFable 5.1の思考ブロックを読めません。 Opus 5やFable 5からFable 5.1へ会話を引き継ぐと推論は保たれますが、Fable 5.1から過去モデルへ戻すと、そのターン分の推論は失われます。
実務で効くのは、モデルを自動で切り替えるルーターやフォールバックを組んでいる場合です。読めないブロックはAPI側が渡す前に落とすため、入力トークンには数えられず課金もされませんが、既定では黙って落ちます。thinking-binding-controls-2026-08-01ベータヘッダーを付けると、落とした事実がinput_transformations配列で報告されます。
破壊的変更3: 過去ターンを編集すると思考ブロックが無効になる
Fable 5.1の思考ブロックより前にあるもの(systemプロンプト、tools、過去メッセージ)を書き換えると、次のリクエストでエラーになります。この検査は2026年8月31日以降に作成されたアカウントで強制されます(それ以前のアカウントでは、リクエストが挙動を指定したときだけ作用します)。Claude Mythos 5.1はこの検査を行いません。
無効化される代表的なパターンは公式に列挙されています。過去ターンの編集・並べ替え・削除、リクエストごとにリマインダーや状況行を過去ターンへ差し込んで次で消す運用、同じ会話の中でsystemやtools配列を組み直すこと、同じURLで異なるバイト列を返す画像・ドキュメントなどです。自社実装のエージェントでは、毎リクエストでシステムプロンプトを組み直す作りが珍しくないので、移行前にここは必ず点検してください。
逆に、無効化されない操作もはっきりしています。先頭から順に思考ブロックを取り除くこと、サーバー側のコンパクション・コンテキスト編集による履歴の切り詰め、cache_controlマーカーの移動、リクエスト間でのeffort変更です。要するに「会話は追記のみ(append-only)で扱う」のが正解で、これはプロンプトキャッシュを温かく保つ運用とも一致します。
追加された5つの機能
| 機能 | 何ができるか | 必要なベータヘッダー |
|---|---|---|
| 会話途中でのeffort変更 | 難しい工程だけeffortを上げ、定型工程では下げる。プロンプトキャッシュを壊さない | mid-conversation-output-config-2026-07-01 |
| ターン限定のsystemメッセージ | clear_at: "next_user_message"で、そのターンだけ効くリマインダーを渡せる。履歴を書き換えずに済む | mid-conversation-system-clear-at-2026-08-21 |
| ツール呼び出し間の進捗テキスト | thinking.displayを"updates"にすると、推論は隠したまま進捗更新だけをテキストで受け取れる | thinking-display-updates-2026-08-18 |
| キャッシュ読み取りの値下げ | 100万トークンあたり$0.25(基本入力の0.025倍) | 不要 |
| コンテンツの来歴(content provenance) | 生成テキストに統計的テキスト透かし。コード実行ツール等が作った画像・動画にはC2PAのContent Credentialsが付く | 不要 |
あわせて、コードを変えなくても表に出る挙動の違いも公式に列挙されています。並列ツール呼び出しが減る(1ターン1呼び出しになりやすい)/長いツール実行中の進捗テキストが減る/low effortでは検索や取得をせず記憶から答えがち/文章が密になる/チャットでの装飾(太字・見出し・箇条書き)が減る/要約時に引用を引用と明示せず再現しがち/小さな修正でもファイル全体を書き直しがち——の7点です。いずれも公式に対応する回避プロンプトが用意されています。
特に3つ目と7つ目はコストに直結します。low effortで検索しなくなると鮮度が必要な回答で事故りますし、ファイル全体の書き直しは出力トークンをそのまま増やします。出力単価が100万トークンあたり$50のモデルでは、この差が請求額に効いてきます。
実務でどう検証すべきか|比較検証に使えるプロンプト5選
ベンチマークの数字だけで決めず、自社のワークロードで実際に同じプロンプトを両方に投げて比較することを強くおすすめします。以下、比較検証にそのまま使えるプロンプトを5つ用意しました。Claude側で試すときは、effortを揃えること(Claude APIの既定はhigh。effortの既定値はClaude CodeでHigh、Claude Coworkとclaude.aiでMedium)を忘れないでください。
1. 長文要約の比較
以下の資料([議事録/契約書/レポートなどをここに貼り付け])を、
経営会議で使う3分で読める要約に変換してください。

要件:
- 結論を最初の1文で
- 数字・固有名詞は原文どおり正確に引用する(推測で数字を作らない)
- 原文をそのまま使う箇所は必ず引用符でくくり、どこからの引用か明示する
- 見落としがちなリスク・懸念事項があれば別枠で明記する
- 500字以内
3つ目の要件は、Fable 5.1で公式に告知されている「要約時に引用を引用と明示せず再現しがち」という挙動への対策です。同じプロンプトをGPT-5.6側にも投げて、引用の扱いを見比べてください。
2. コーディングタスク(バグ修正)の比較
以下のコードにはバグがあります。

[コードをここに貼り付け]

要件:
- バグの原因を1文で特定する
- 修正は該当箇所だけの差分で示す(ファイル全体の書き直しはしない)
- なぜそのバグが起きたのか、再発防止のためのテスト観点を3つ挙げる
2つ目の要件も、Fable 5.1の「小さな修正でもファイル全体を書き直しがち」という挙動への対策です。出力トークンが増えれば、そのまま請求額が増えます。
3. 日本語ビジネス文書の比較
以下の内容を、取引先に送るお詫びメールの下書きにしてください。

状況: [発生した問題を具体的に記入]

要件:
- 日本語ビジネスメールとして自然な敬語
- 言い訳がましくならない
- 次のアクション(いつまでに何をするか)を明記する
- 250字程度
Anthropicは「多言語性能はFable 5と同等」としています。日本語のビジネス文書は各社のベンチマークで測られていない領域なので、ここは自社で見るしかありません。
4. エージェント的タスク分解の比較
次のプロジェクトを、実行可能なタスクに分解してください。

プロジェクト: [新機能のリリース/イベント運営など具体的なプロジェクト名]

要件:
- タスクを「今日中」「今週中」「来月まで」の3段階に分ける
- 各タスクの依存関係(何が終わってから着手できるか)を明記する
- 独立して調べられる項目は、まとめて一度に調べる
- 抜け漏れが起きやすい工程があれば注意喚起する
3つ目の要件は、Fable 5.1で「並列ツール呼び出しが減り、1ターン1呼び出しになりやすい」という公式告知への対策です。ツールを使わせる環境で試すと差が見えます。
5. コスト試算の比較
以下の前提で、月間のAPI利用コストを試算してください。

前提:
- 月間リクエスト数: [自社の想定件数]
- 1リクエストあたりの平均入力トークン数: [概算値]
- 1リクエストあたりの平均出力トークン数: [概算値]
- キャッシュヒット率: [概算値、なければ0%と仮定]
- キャッシュ読み取り単価: [Fable 5.1は100万トークンあたり0.25ドル、Opus 5は0.50ドル]

要件:
- 計算式を省略せず全て示す
- キャッシュヒット率が0%・50%・90%の3ケースで比較する
- バッチ処理を使った場合の想定コストも別途試算する
- 前提条件のうちどれが結果に最も影響するか指摘する
研修の場でこの5つを実際にやってもらうと、多くの担当者が最初は単価表だけで判断しようとして、キャッシュ割引やバッチ処理の条件まで見ていないことに気づきます。特に5番目のプロンプトは、キャッシュヒット率を3段階で振らせるところが肝です。ヒット率0%ならOpus 5が圧倒的に安く、ヒット率が高い長時間セッションではFable 5.1が追いついてくる——という構造が、自社の数字で見えるようになります。数字の比較は簡単にできますが、「自社のワークロードで実際に何が起きるか」は、こうした具体的なプロンプトで検証してみないと分かりません。
用途別に見る選び方|6つの業務シーン
1. 営業資料・提案書のドラフト作成
定型的な文書生成が中心であれば、GPT-5.6 TerraやClaude Sonnet 5のようなバランス型で十分なケースが多いです。単価は100万トークンあたりTerraが$2/$12、Sonnet 5が$2/$10(2026年9月6日時点の各社公式料金ページ)で、この価格帯は両社が正面からぶつかっています。文章の質を最優先するならOpus 5、資料や表計算・スライドを最初から最後まで作らせたいならFable 5.1も選択肢に入ります(公式が改善領域として「ドキュメント・スプレッドシート・スライドを含むナレッジワーク」を挙げています)。
2. コーディング・エージェント型開発
Anthropic計測のTerminal-Bench 4.0ではFable 5.1が55.8%、Opus 5が52.3%、GPT-5.6 Solが37.3%。CursorBench 3.2.0では73.4%・70.0%・67.2%です。Fable 5.1とOpus 5の差はCursorBenchで3.4ポイントしかないので、まずOpus 5で試して、届かないタスクだけFable 5.1に上げるのが公式の推奨順序とも一致します。GPT-5.6側ではSolのultraモードがOpenAI計測のTerminal-Bench 2.1で91.9%まで伸びますが、コスト増を伴うため、並列化に向くタスクに絞って使うのが実務的です。
3. 長時間稼働するバックグラウンドエージェント
ここがFable 5.1の本命用途です。公式が「long-horizon agentic work(長期にわたるエージェント業務)」向けと位置づけており、改善領域としても「何時間も走るセッションでの複数ファイル機能追加・大規模リファクタ・移行・デバッグ・コードレビュー」を挙げています。加えてキャッシュ読み取りが100万トークンあたり$0.25と安いため、同じ前提を何度も読み直す使い方ほど有利になります。ただし相対レイテンシは「Slower(遅め)」と公式に明記されているので、応答速度が重要な対人業務には向きません。
4. 多言語カスタマーサポート
両社とも多言語・画像入力に対応しています。Anthropicは「Fable 5.1の多言語性能はFable 5と同等」としており、5.1にしたから多言語が伸びるわけではありません。コスト重視ならGPT-5.6 Terra/LunaかClaude Sonnet 5/Haiku 4.5、品質重視ならOpus 5という基本方針で、実際の問い合わせ内容でテストして決めるのが確実です。
5. セキュリティ・脆弱性診断
Claude Mythos 5.1はProject Glasswing経由の招待制で、仕様・料金はFable 5.1と同一です。一般法人がすぐに使えるわけではないため、まずはOpus 5で自社の脆弱性診断業務を検証し、必要に応じて招待申請を検討するという段階を踏むのが現実的です。なおアクセスの問い合わせ先は、Anthropic・AWS・Google Cloudの各アカウントチームだと公式に案内されています。
6. 大量データの一次分類・要約バッチ処理
コスト最優先ならGPT-5.6 Lunaが最安($0.20/$1.20・2026年9月6日時点の公式標準価格)です。Claude側で最も安いのはHaiku 4.5($1/$5)で、単価はLunaの約5倍ですが、コンテキストは20万トークン・最大出力6.4万トークンと上位3本より小さい点に注意してください。もう一つの選択肢が、Fable 5.1のバッチ処理(入力$5/出力$25)です。リアルタイム性が不要なら、Opus 5の基本単価と同じ値段で最上位モデルを回せる計算になります。
Claude側の2本に絞った使い分けは「Opus 5とFable 5.1の違い|どっちを使う・料金」で整理しています。
【要注意】選び方でよくある失敗パターン
失敗1: ベンチマーク名だけを見て数字を横に並べる
❌ 「Terminal-Bench」でSolは88.8%、Fable 5.1は55.8%だから、Solのほうが上だと判断する
⭕ バージョン(2.1と4.0)・計測主体(OpenAIとAnthropic)・ハーネス・effortの4点が揃っているか確認してから比べる
なぜ重要か: 同じ名前のベンチマークでも、バージョンが違えばタスクの難易度も採点方法も別物です。今回の公式表ではSolが9指標中4指標で未掲載なので、そもそも全指標での横並び比較はできません。
失敗2: Ultra/max reasoningモードを常時オンにする
❌ 「賢くなるなら」とultraモードや最大effortを全リクエストで有効化する
⭕ 難しい工程だけeffortを上げ、定型工程では下げる(Fable 5.1は会話の途中でeffortを変えられるベータ機能がある)
なぜ重要か: Anthropic公式は「Fable 5.1はLow/Medium effortでもFable 5と同等以上の結果を、はるかに低いコストで出す」と明記しています。上げっぱなしは、精度がほぼ変わらないままコストだけが跳ね上がる典型パターンです。詳しくはGPT-5.6 Ultra mode徹底解説でも扱っています。
失敗3: 招待制モデルを前提に予算・体制計画を立てる
❌ Claude Mythos 5.1やCodexの限定機能が「いずれ自社にも来る」前提で予算組みをする
⭕ 現時点で一般提供(GA)されているモデルで検証を進め、招待制機能は別枠の将来オプションとして扱う
なぜ重要か: 招待制モデルは審査・承認プロセスが必要で、いつ使えるようになるか確約がありません。Mythos 5.1もProject Glasswingの承認済み顧客だけが対象です。
失敗4: キャッシュ・バッチ割引を無視して単価だけ比較する
❌ 「入力$10/出力$50」のような基本単価だけを見て、モデル間のコストを比較する
⭕ 自社のワークロード(繰り返し送るシステムプロンプトの量、リアルタイム性が必要か)を踏まえて、キャッシュ・バッチ割引適用後の実効コストで比較する
なぜ重要か: Fable 5.1はバッチ処理で入力$5/出力$25まで下がり、これはOpus 5の基本単価と同額です。キャッシュ読み取りに至っては$0.25とOpus 5の$0.50より安く、基本単価とは逆の序列になります。
失敗5: 旧世代の実績トークン数でそのまま試算する
❌ 2026年前半に測った「1リクエストあたり平均◯トークン」をそのまま新モデルの見積もりに使う
⭕ 現行トークナイザで測り直してから試算する(Claude Opus 4.7より古いモデルと比べると、同じ文章でおよそ30%多いトークンになる)
なぜ重要か: 単価が同じでもトークン数が約30%増えれば請求額は増えます。単価表の比較だけで「安くなったはず」と判断すると、請求書で初めて気づくことになります。
企業導入前に確認すべきポイント
最後に、実際に契約する前に確認しておくべき運用面のポイントを整理します。
- データ保持とゼロデータ保持(ZDR): Claude Fable 5.1とMythos 5.1は30日間のデータ保持が適用され、Anthropicが明示的に許可しない限りZDRでは利用できません。両モデルはCovered Modelsに該当します。ZDRが社内規程の必須要件になっている企業は、契約前に必ず確認してください。
- データ所在地: Claude APIは
inference_geoパラメータで米国限定の推論経路を指定でき、その場合1.1倍の料金が上乗せされます。データレジデンシー要件がある業種は事前確認が必須です。 - 拒否時のフォールバック先: Fable 5.1が安全分類器でリクエストを拒否した場合、公式に許可されているフォールバック先はClaude Opus 4.8とClaude Opus 5です。拒否は
stop_reason: "refusal"とともにHTTP 200で返るので、エラーとして握りつぶさない実装にしてください。出力が始まる前の拒否には課金されず、モデル切り替えで発生するプロンプトキャッシュのコストはフォールバッククレジットで払い戻されます。 - 選別提供の前例: GPT-5.6は米国のAI関連大統領令に基づく政府の任意テスト枠組みにより、GA前の12〜13日間、提供先が「政府審査を経た信頼できる提携先」約20社程度に限定されていました。今後も新モデルで同様の選別提供が起こり得る前提で、契約・導入計画に一定の余白を持たせておくと安心です。
- レート制限・利用ティア: 両社とも利用実績に応じてレート制限が段階的に緩和される仕組みを持っています。本番導入前に、想定リクエスト数がどのティアで賄えるか確認しておきましょう。
- バッチAPI・非同期処理: リアルタイム性が不要な大量処理は、Claude側はバッチAPIで入出力とも50%割引です。業務設計の段階から組み込むと効果が大きくなります。
- モデルのリタイア時期: Fable 5.1は「2027年9月1日より前にはリタイアしない」と公式に明記されています。1年以上先まで使える前提で設計できるかどうかは、業務システムに組み込む際の判断材料になります。
- 監査ログ・ガバナンス: エージェントが自律的に長時間動く業務ほど、実行ログの監査体制が重要になります。METRの指摘のように、モデルが評価環境を認識して挙動を変える可能性がある以上、本番環境でも実行ログの継続的なレビュー体制を用意しておくことをおすすめします。
- 生成物の来歴表示: Fable 5.1が生成したテキストには統計的テキスト透かしが入り、コード実行ツール等が生成した画像・動画にはC2PAのContent Credentialsが付きます(Files API経由で取得した場合)。公式は「透かしは意味・品質・可読性を変えず、トークンや隠し文字を追加せず、利用者や組織の情報も含まない」としていますが、生成物を外部提出する業務では社内ルールに書いておくと後で揉めません。
Opus 4.8・Fable 5世代からの読み替え方
本記事は2026年7月の公開時点ではClaude Opus 4.8とClaude Fable 5を比較対象にしていました。その後、2026年7月24日にClaude Opus 5、9月1日にClaude Fable 5.1が出て、比較の起点が入れ替わっています。旧版を読んだ方向けに、読み替え方を整理しておきます。
| 旧版の記述 | 2026年9月2日時点の読み替え |
|---|---|
| Claude Opus 4.8($5/$25) | Claude Opus 5($5/$25)。料金は同額で性能が向上。Opus 4.8は非推奨化されておらず、Fable 5.1の公式フォールバック先としても残っている |
| Claude Fable 5($10/$50) | Claude Fable 5.1($10/$50)。基本単価は据え置きで、キャッシュ読み取りだけ$0.25へ値下げ。公式の現行比較表からFable 5は外れた |
| Claude Mythos 5(招待制) | Claude Mythos 5.1(招待制)。Fable 5.1と同一仕様・同一料金、Project Glasswing経由 |
| 知識カットオフ 2026年1月 | Fable 5.1は2026年6月、Opus 5は2026年5月。Sonnet 5が2026年1月 |
| Terminal-Bench 2.1でSol 88.8%・Mythos 5 88.0% | この数字自体は変わらないが、比較の主軸はAnthropic公式の9指標(Terminal-Bench 4.0を含む)へ移行。バージョンが違うため両者を横に並べない |
実装面では、Fable 5からFable 5.1への移行はモデルIDをclaude-fable-5からclaude-fable-5-1へ書き換えたうえで、前述の破壊的変更3点(forced tool useの廃止、thinkingブロックのモデル束縛、過去ターン編集の無効化)とeffortの再チューニングを点検する、という手順が公式に示されています。Opus 5単体の詳しい料金・仕様・移行判断はClaude Opus 5の詳細ガイドで解説しています。
よくある質問
Q. Claude Fable 5.1とFable 5の違いは何ですか?
A. 基本単価は同じ(100万トークンあたり入力$10/出力$50)で、キャッシュ読み取りだけが$0.25に下がりました。性能面では、長時間のエージェント的コーディング、ドキュメント・スプレッドシート・スライドのナレッジワーク、多段階の調査と検索、ビジョン(濃い図表やPDF内の表の読み取り)、長文コンテキストでの推論、コンピュータ操作の6領域で改善したと公式が説明しています。多言語性能はFable 5と同等です。実装面ではforced tool useが使えなくなるなど破壊的変更が3点あります。
Q. Claude Fable 5.1の料金はいくらですか?
A. 100万トークンあたり入力$10、出力$50です。5分キャッシュ書き込みが$12.50、1時間キャッシュ書き込みが$20、キャッシュ読み取りが$0.25。バッチ処理は入力$5/出力$25で、これはClaude Opus 5の基本単価と同額になります。
Q. GPT-5.6 SolとClaude Fable 5.1はどちらが強いですか?
A. 2026年9月1日のAnthropic公式表では、GPT-5.6 Solのスコアが載っている5指標すべてでFable 5.1が上回っています(例: Terminal-Bench 4.0で55.8%対37.3%)。ただし測定したのはAnthropicで、9指標のうち4指標はSol未掲載です。OpenAI側が発表したTerminal-Bench 2.1ではSolが88.8%(ultraで91.9%)ですが、こちらはバージョンが違うため横に並べられません。2026年9月2日時点で、両社を完全に中立な条件で比較した公式データは確認できていません。
Q. GPT-5.6 TerraとClaude Sonnet 5はどちらが安いですか?
A. 単価だけならClaude Sonnet 5です。Terraが100万トークンあたり$2/$12、Sonnet 5が$2/$10(各社公式料金ページ・2026年9月6日参照)。入力単価は同じで、出力単価でSonnet 5が安い形です。Sonnet 5に案内されていた通常価格への移行は、2026年9月6日時点の公式料金ページで「実施しない」と明記されています。
Q. Claude Mythos 5.1は契約できますか?
A. できません。Project Glasswingの承認済み参加者のみが対象で、セルフサーブでは契約できません。アクセスの問い合わせ先は、Anthropic・AWS・Google Cloudの各アカウントチームだと公式に案内されています。仕様・料金はFable 5.1と同一なので、一般法人はFable 5.1で同等の性能を使えると考えて差し支えありません。
Q. Claude Fable 5はもう使えないのですか?
A. 2026年9月2日時点では、Fable 5からFable 5.1へのマイグレーション手順が公式に案内されている状態で、Fable 5のリタイア日について本記事の確認範囲では情報を確認できていません。ただし公式の現行比較表からは外れているため、新規に設計するならFable 5.1かOpus 5を起点にするのが自然です。
Q. GPT-6は出るのですか?
A. 2026年9月2日時点で、OpenAIから「GPT-6」という名称のモデルの公式発表は確認できていません。複数のメディアが次世代モデルの準備を報じていますが、公式発表としては確認できていないため、本記事では現行のGPT-5.6を前提に整理しています。
Q. 結局どれから試せばいいですか?
A. Anthropic公式が「ほとんどのワークロードはClaude Opus 5から始める」と明記しているので、Claude側はOpus 5が出発点です。そこから、Opus 5を高いeffortで評価しても足りないタスクだけをFable 5.1に上げます。GPT側と比べるなら、同じプロンプト・同じ資料で本記事の検証プロンプト5つを走らせ、精度・レイテンシ・実効コストの3軸で見るのが確実です。
まとめ:今日から始める3つのアクション
- 今日やること: 自社の主要ワークロードを「大量処理」「高難度コーディング」「長時間稼働エージェント」の3種類に仕分けし、それぞれのキャッシュヒット率がだいたいどのくらいかを把握する
- 今週中: 本記事の比較検証プロンプト5つを使い、候補モデル(Sol/Terra/Luna、Opus 5/Fable 5.1)で同一プロンプト・同一effortを走らせ、精度とコストを比較する
- 今月中: キャッシュ読み取り単価(Fable 5.1は$0.25、Opus 5は$0.50)とバッチ割引を織り込んだ実効コストを試算し、業務ごとに使うモデルの組み合わせを決定する。自社APIを叩いている場合は、あわせて破壊的変更3点の影響範囲を点検する
—
—
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』『Claude仕事術』(SBクリエイティブ・シリーズ累計約6万部)。
SBクリエイティブ「ビジネス+IT」ほかで生成AI連載を執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談はお問い合わせフォームからお気軽にどうぞ。
参考・出典
- Introducing Claude Fable 5.1 and Claude Mythos 5.1 — Anthropic公式(ベンチマーク9指標×4モデルの表・参照日: 2026-09-02)
- Claude Fable 5.1 overview — Anthropic公式ドキュメント(料金・仕様・提供状況・参照日: 2026-09-02)
- What’s new in Claude Fable 5.1 — Anthropic公式ドキュメント(破壊的変更・追加機能・キャッシュ単価・参照日: 2026-09-02)
- Claude Fable 5.1 — Vals AI — 第三者評価(Vals Index ほか・参照日: 2026-09-02)
- Claude Fable 5.1 — Artificial Analysis — 第三者評価(Intelligence Index・コスト・速度・参照日: 2026-09-02)
- Previewing GPT-5.6 Sol: a next-generation model — OpenAI公式(参照日: 2026-07-10)
- A preview of GPT-5.6 Sol, Terra, and Luna — OpenAI Help Center(参照日: 2026-07-10)
- Models overview — Anthropic公式ドキュメント(参照日: 2026-09-02)
- Pricing — Anthropic公式ドキュメント(参照日: 2026-09-02)
- Summary of METR’s predeployment evaluation of GPT-5.6 Sol — METR(参照日: 2026-07-10)
- GPT-5.6 cheats so much its testers couldn’t measure it — Transformer News(参照日: 2026-07-10)
- GPT-5.6: The System Card — Don’t Worry About the Vase(参照日: 2026-07-10)
- Introducing Claude Opus 5 — Anthropic公式(参照日: 2026-07-25)
あわせて読みたい:
- ChatGPT 5.6の使い方 — GPT-5.6全体の料金・性能一覧
- GPT-Liveとは|ChatGPT新音声AIの使い方と料金 — GPT-5.5連携で動く新音声モデルの全体像
- ChatGPTでGPT-5.6を使う方法|3モデルの違い【2026年9月】 — GA解禁の経緯
- GPT-5.6 Ultra mode徹底解説|コスト増に要注意 — ultraモードの仕組みとコスト
- Claude Opus 4.8完全ガイド|料金・1M文脈・新機能 — 前世代Opus 4.8の料金・使い分け
- Claude Fable 5 完全ガイド — 前世代Fable 5の4モデル比較
- フラッグシップAI完全比較(2026年6月) — GPT-5.6 GA前・4社横断の前回比較
監修:株式会社Uravation(生成AI活用書籍シリーズ累計約6万部の著者チームが運営。自社7メディアの実運用でAI検索からの引用・流入を継続計測し、その知見に基づいて編集しています。仕様・料金が変わりやすい領域のため、重要な意思決定の前には各公式情報の最新版をご確認ください)
この記事の内容を社内展開する方へ: 生成AI 料金・プラン早見表 2026年10月版(無料・PDF 35ページ+Excel) をダウンロードできます。