🆕 Fable 5.1(2026年9月1日公開)の変更点・料金・移行手順の総合ガイドは Claude Fable 5.1とは?変更点・料金・使い方、プラン別の可否と上限は 利用クレジット・上限・リセット を参照。本記事はOpus 5.5とFable 5.1の使い分けです。
結論(2026年10月2日時点)
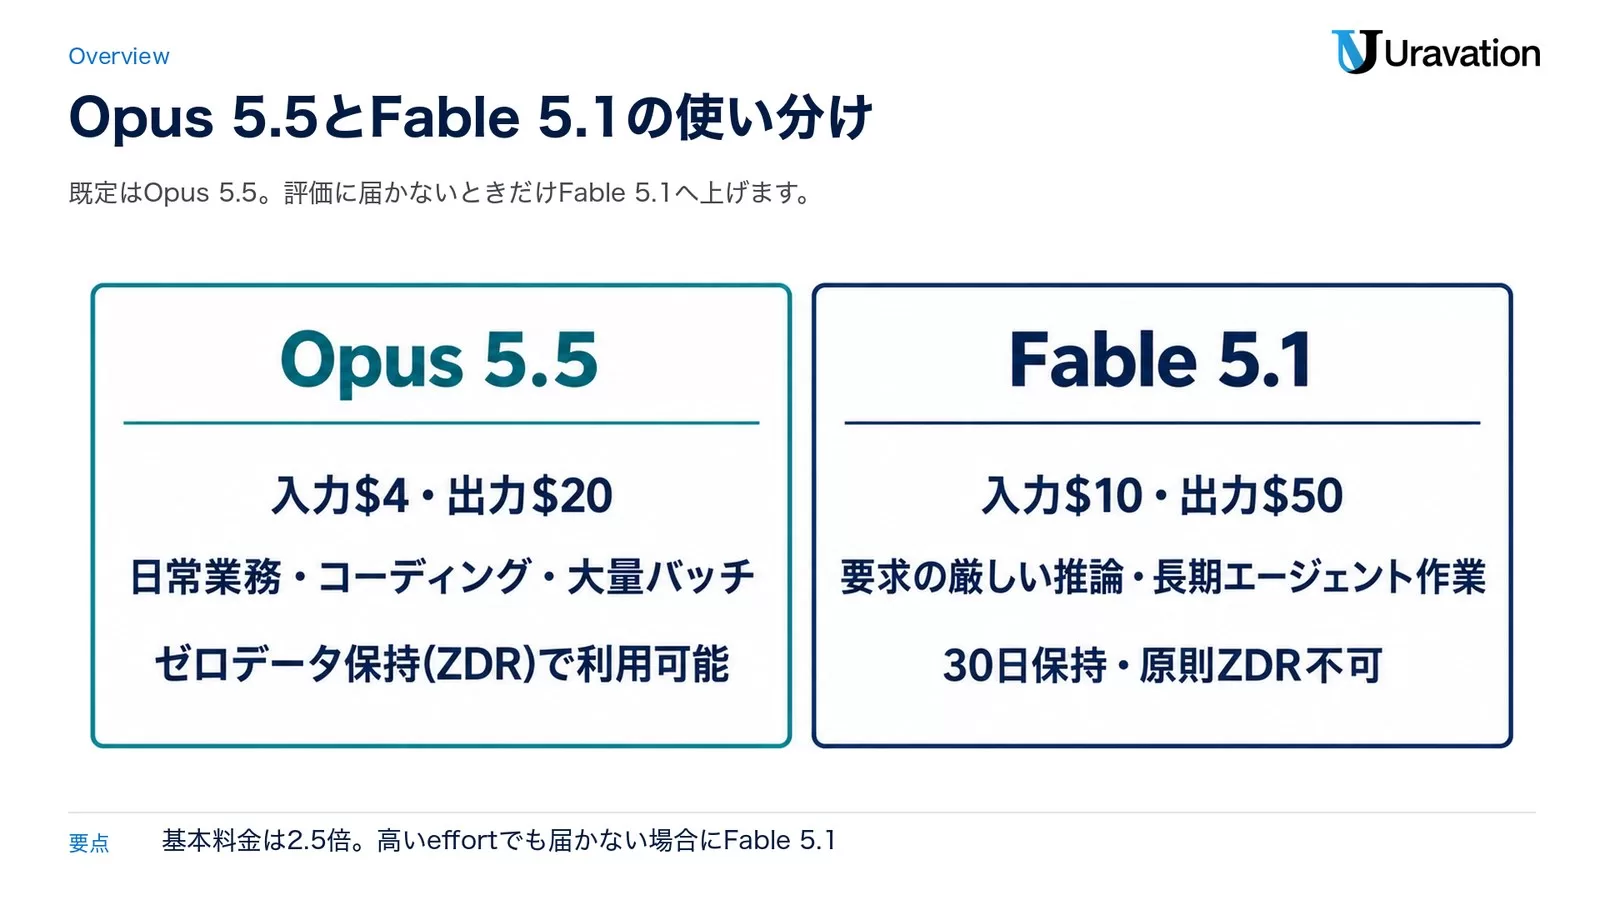
- どっちを使う:既定はOpus 5.5。Anthropic公式のモデル選定ページに「Most workloads start with Claude Opus 5.5」と明記され、effortをxhighやmaxまで上げても評価に届かない「要求の厳しい推論・長時間のエージェント作業」に限ってFable 5.1へ上げる、という順序になっている。
- 基本料金:100万トークンあたりOpus 5.5が入力4ドル・出力20ドル、Fable 5.1が入力10ドル・出力50ドル。単純比較では2.5倍。
- キャッシュ読み取りは差が縮むが逆転しない:Fable 5.1は基準入力の2.5%=0.25ドル、Opus 5.5は5%=0.20ドルで、差は1.25倍。長時間エージェントほど総額の差は2.5倍より小さくなるが、前世代のOpus 5(0.50ドル)のときのような逆転は起きない。
- Fable 5(無印)との関係:Fable 5.1は入出力単価をFable 5と同じに据え置きつつキャッシュ読み取りだけ4分の1にしたモデル(公式は「at the same input and output prices, with cache reads at a quarter of the cost」と説明)。Fable 5のキャッシュ読み取りは1ドルのまま。
- 安くする順番:Batch APIは入出力とも50%引き(Opus 5.5は2ドル/10ドル、Fable 5.1は5ドル/25ドル)。速度が要るときのOpus 5.5のFast mode(research preview)は8ドル/40ドル。
- 要点1: 公式の推奨順は「まずOpus 5.5」。公式のモデル一覧(2026年10月2日確認)は「迷ったら、ほとんどのワークロードはClaude Opus 5.5から始める。要求の厳しい推論と長期エージェント作業、またはOpus 5.5を高いeffortで回しても評価に届かない場合にFable 5.1を使う」と書いています。9月1日のFable 5.1公開時は起点がOpus 5でしたが、9月22日のOpus 5.5公開で起点がOpus 5.5に替わりました。
- 要点2: キャッシュ読み取りの逆転はなくなった。キャッシュ読み取りはFable 5.1が基準入力の2.5%(=$0.25/MTok)、Opus 5.5が5%(=$0.20/MTok)です。Fable 5.1のほうが安かったのは前世代のOpus 5($0.50/MTok)と比べたときだけで、Opus 5.5とは1.25倍の差。基本料金の2.5倍よりは小さいので、同じプレフィックスを何百ターンも読み直す長時間エージェントほど総額の倍率は縮みます。
- 要点3: Fable 5(無印)とOpus 5は旧世代になった。どちらも公式の廃止スケジュール(2026年10月2日確認)では Active のままで、退役はFable 5が「2027年6月9日より前にはない」、Opus 5が「2027年7月24日より前にはない」とされています。各モデルページの表示は Legacy に変わりました。Fable 5を本番で使っている組織は「5.1へ上げる/Opus 5.5へ降りる/当面据え置く」の3択を、Opus 5を使っている組織はOpus 5.5へ上げる前の破壊的変更4点を、コードで確認してから決める段階です。
対象読者: Claudeのモデルピッカーやapi設定で「結局Opus 5.5とFable 5.1、どっちを標準にすべきか」を判断したい情報システム担当者・経営者・開発チームリーダー
読了後にできること: 自社の業務をタスク別にOpus 5.5とFable 5.1へ振り分ける基準を持ち、キャッシュ込みの月額試算と、Fable 5からの3択判断フローを手に入れられます。
最終更新:2026年10月2日(Claude Opus 5.5の公開を反映)
「新しいOpusが出たので、もうFableは要らないですよね?」
2026年7月24日にClaude Opus 5が発表された翌日、企業向けのAI活用相談でこの質問を立て続けに受けました。無理もありません。Anthropic自身が公式ドキュメントで「Opus 5はFable 5の半額でフロンティア知能を実現する」とまで言い切っていたからです。ところが同じ時期のモデル選定ガイドは「最高の性能が必要な作業にはFable 5を」と案内し続けていて、半額でフロンティア級と言う一方で序列の頂点はFable 5のまま——この一見矛盾した状態が、モデル選定の現場を長く混乱させていました。
その混乱が、2026年9月1日(米国時間)のClaude Fable 5.1リリースで一段落しました。Fable 5.1の公式ドキュメントは冒頭で「ほとんどのワークロードは Claude Opus 5 から始めてください」と明記し、Fable 5.1の用途を「要求の厳しい推論と長期エージェント作業」に限定しました。つまりAnthropic自身が「既定はOpus、必要な時だけ上位」という順序を認めたわけです。そして9月22日に後継のClaude Opus 5.5が公開され、公式のモデル一覧が起点に挙げるモデルはOpus 5.5に替わりました(2026年10月2日確認)。
100社以上のAI研修・導入支援をしていて痛感するのは、こういう世代交代のタイミングでこそ「料金表の1行」を読み落とすと後から効いてくる、ということです。今回でいえばそれがキャッシュ読み取り単価です。Fable 5.1は入力$10・出力$50という基本料金をFable 5から据え置いた一方で、キャッシュ読み取りだけを$1.00から$0.25へ4分の1に下げました。Opus 5.5は入力$4・出力$20で、キャッシュ読み取りは基準入力の5%にあたる$0.20です。基本料金はFable 5.1が2.5倍、キャッシュ読み取りは1.25倍。前世代のOpus 5($0.50)のときにあった「この項目だけFable 5.1が安い」という逆転は、Opus 5.5では起きません。「キャッシュが効くならFable 5.1が安い」という9月前半の前提で予算を組むと、見積もりを誤ります。
この記事では、Anthropicの公式ドキュメント(モデル一覧・料金表・Opus 5.5とFable 5.1の各ページ)を一次ソースとして確認したうえで、Opus 5.5とFable 5.1を「料金」「性能」「運用要件」の3軸で比較し、どの業務をどちらに任せるべきかを判断基準とコピペ可能なプロンプトつきで整理します。あわせて、Fable 5(無印)を使い続けている組織のための3択判断フローと、Opus 5からOpus 5.5へ上げる前の確認点もまとめました。Claudeのモデル選定を含めたAI導入の全体設計についてはAI導入戦略 完全ガイドでも体系的に解説していますので、あわせてご覧ください。
【2026年9月2日 続報】
Claude Fable 5.1が2026年9月1日(米国時間)にリリースされました。料金据え置きでキャッシュ読み取りが4分の1になった変更点・APIの破壊的変更3点・移行手順は Claude Fable 5.1リリース|変更点・料金・移行【2026年9月】 で解説しています。
【2026年10月2日更新】比較対象をOpus 5.5に改めました
2026年9月22日に後継のClaude Opus 5.5が公開されたため、この記事の比較対象をOpus 5からOpus 5.5に改めました。単価(Opus 5.5は入力4ドル・出力20ドル、キャッシュ読み取り0.20ドル)、Fable 5.1との倍率(2.5倍)、公式の推奨文を、同日の公式値へ更新しています。Opus 5はAPIで引き続き提供されています(提供終了は2027年7月24日より前にはしないと公式に記載)。最新の一覧はAnthropic公式のモデル一覧で確認できます。
結論ファースト:用途別のおすすめ早見表
まず結論から。以下の早見表で自社の主要業務がどちらに該当するか確認してください。2026年9月22日のOpus 5.5公開を反映した版です(2026年10月2日更新)。
| 用途・タスク | おすすめ | 理由 |
|---|---|---|
| 日常業務の文書作成・要約・チャット | Opus 5.5 | 公式が「ほとんどのワークロードはOpus 5.5から」と明記。料金は入出力ともFable 5.1の4割 |
| 短〜中時間のコーディング・エージェント実行 | Opus 5.5 | Anthropic公表のTerminal-Bench 4.0はOpus 5.5が66.4%、Fable 5.1が55.8%。単価もFable 5.1の4割 |
| 大量バッチ処理(件数が多く単価が効くタスク) | Opus 5.5 | バッチAPI適用後も単価はFable 5.1の4割($2/$10 対 $5/$25) |
| 数時間走らせる長期エージェント(大規模リファクタ・複数ファイル改修・多段リサーチ) | まずOpus 5.5、評価に届かなければFable 5.1 | 公式が上げる条件にしているのは「Opus 5.5を高いeffortで回しても届かない場合」 |
| Opus 5.5を高いeffortで回しても評価基準に届かないタスク | Fable 5.1 | 公式ドキュメントが挙げている”上げる”条件 |
| 密なグラフ・PDF内の表を読ませる作業(ビジョン) | まずOpus 5.5(実測で決める) | Fable 5.1はFable 5比の強化領域として公式が明記(グラフのクロップ&ズームを含む)。Opus 5.5も読み取り精度の向上を公式が明記 |
| 多段の調査・ディープリサーチ | まずOpus 5.5、評価に届かなければFable 5.1 | 公式のモデル選定表はFable 5.1の例に挙げるが、Opus 5.5の発表には調査レポートの社内テストでOpus 5.5が上回った結果も載っている |
| ゼロデータ保持(ZDR)が契約条件の業務 | Opus 5.5(Fable 5.1は原則不可) | Opus 5.5は発表でゼロデータ保持での利用が可能と明記。Fable 5.1・Mythos 5.1はCovered Model指定で30日保持・原則ZDR不可と公式に明記 |
| tool_choiceで特定ツールを強制している既存実装 | どちらも改修が必要 | Opus 5.5もFable 5.1も強制ツール使用は400エラー。strict tool useへ改修してから移るか、前世代のOpus 5(APIで提供継続)に当面とどめる |
この判断基準の根拠を、公式スペックと第三者ベンチマークの両面から見ていきます。
Opus 5.5とFable 5.1、基本スペック比較表(Fable 5も併記)
Anthropic公式ドキュメント(Claude Platform Docs)に掲載されている料金・仕様を、そのまま突き合わせます。Fable 5(無印)は5.1の前世代ですが(廃止スケジュールは Active・2026年10月2日確認)、移行判断のために列を残しています。サブスクリプション(Pro・Max・Team)の月額は、別記事のClaudeの料金プラン早見表にまとめています。
| 項目 | Claude Opus 5.5 | Claude Fable 5.1 | Claude Fable 5(前世代) |
|---|---|---|---|
| モデルID(Claude API) | claude-opus-5-5 | claude-fable-5-1 | claude-fable-5 |
| 公式の位置づけ | ほとんどのワークロードの起点として推奨 | 要求の厳しい推論と長期エージェント作業向け | Fable 5.1の前世代(モデルページは Legacy 表示) |
| リリース日 | 2026年9月22日 | 2026年9月1日 | 2026年6月9日 |
| 提供終了(retirement)の目安 | 2027年9月22日以降 | 2027年9月1日以降 | 2027年6月9日以降 |
| 入力料金 | $4.00 / MTok | $10.00 / MTok | $10.00 / MTok |
| 出力料金 | $20.00 / MTok | $50.00 / MTok | $50.00 / MTok |
| キャッシュ読み取り | $0.20 / MTok(基準入力の5%) | $0.25 / MTok(基準入力の2.5%) | $1.00 / MTok(基準入力の10%) |
| 5分キャッシュ書き込み | $5.00 / MTok(公式表に明記) | $12.50 / MTok(公式表に明記) | $12.50 / MTok |
| 1時間キャッシュ書き込み | $8.00 / MTok(公式表に明記) | $20.00 / MTok(公式表に明記) | $20.00 / MTok |
| キャッシュ可能な最小プロンプト長 | 512トークン | 512トークン(Fable 5から変更なしと公式明記) | 512トークン |
| コンテキストウィンドウ | 1Mトークン | 1Mトークン | 1Mトークン |
| 最大出力 | 128kトークン | 128kトークン | 128kトークン |
| 信頼できる知識のカットオフ | 2026年6月 | 2026年6月 | 公開当時の公式記載は2026年1月 |
| 思考(Thinking) | Adaptive・常時ON(無効化は400エラー) | Adaptive・常時ON(無効化は400エラー) | Adaptive・常時ON |
| effortの既定値 | medium | high | high |
| 会話途中のeffort変更(beta) | 対応 | 対応(プロンプトキャッシュを壊さずに変更可) | 非対応 |
| 強制ツール使用(tool_choice: any / tool) | 非対応・400エラー | 非対応・400エラー | 利用可 |
| 比較レイテンシ(公式表記) | Moderate | Slower | Slower |
| 安全分類器による拒否応答 | 搭載(stop_reason: “refusal” を返す) | 搭載(stop_reason: “refusal” を返す) | 搭載 |
| 拒否時のフォールバック先 | 区分ごとに公式が推奨モデルを設定(発表ではサイバーセキュリティ関連の大半がOpus 4.8へ回る) | Claude Opus 4.8 と Claude Opus 5(公式に明記) | 同様の運用 |
| コンテンツ来歴(透かし) | 発表に「Fable 5.1と同じく透かしの対策を備える」と記載 | テキスト統計的透かし+画像/動画のC2PA署名に対応 | — |
| データ保持 | ゼロデータ保持(ZDR)で利用可能と発表に明記 | Covered Model指定・30日保持・原則ZDR不可と公式に明記 | Covered Model指定・30日保持・ZDR不可 |
| バッチAPI割引 | 50%引き($2.00/$10.00 MTok) | 50%引き($5.00/$25.00 MTok) | 50%引き($5.00/$25.00 MTok) |
コンテキスト長(1Mトークン)・最大出力(128kトークン)・キャッシュ最小長(512トークン)は3モデルとも同一です。Opus 5.5とFable 5.1の間で差がつくのは「基本料金」「キャッシュ単価」「effortの既定値」「データ保持ポリシー」です。強制ツール使用の非対応・思考の常時ON・安全分類器の拒否応答は、Opus 5.5でもFable 5.1と同じ扱いです。前世代のOpus 5(入力$5・出力$25)の料金シミュレーションはClaude Opus 5料金完全ガイド、effort設定やコンテキスト活用など具体的な使い方はClaude Opus 5の使い方で解説しています。
なお、Opus 5.5のキャッシュ単価は公式の料金表に個別に載っています(5分書き込み$5・1時間書き込み$8・読み取り$0.20)。読み取りが基準入力の5%というのはOpus 5.5だけの扱いで、Fable 5.1とMythos 5.1は2.5%、それ以外のモデルは10%です(2026年10月2日確認)。
キャッシュ読み取り単価の差——「Fable 5.1は常に2.5倍」が縮む条件
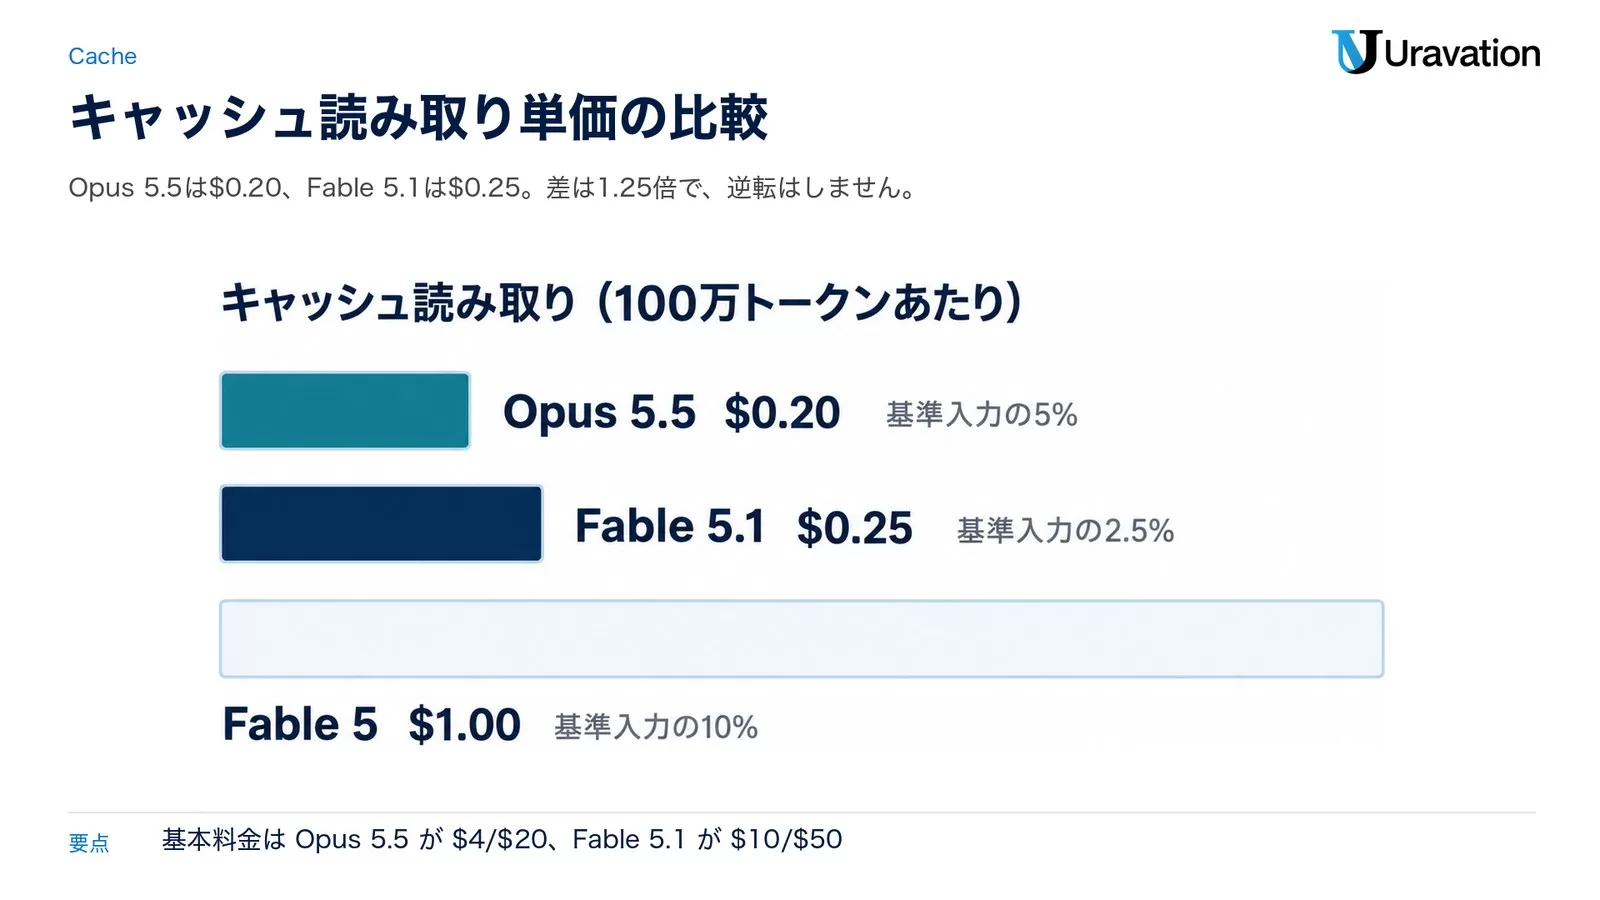
ここは9月に2回書き換わった項目です。まず9月1日、Fable 5.1は入力$10・出力$50という基本料金をFable 5から据え置きつつ、キャッシュ読み取りだけをFable 5の$1.00/MTokから$0.25/MTokへ4分の1に下げました。
Anthropicの公式ドキュメントは、この値付けの根拠をこう説明しています。通常、Claudeのプロンプトキャッシュ読み取りは基準入力価格の10%です。ところがFable 5.1とMythos 5.1は0.025倍(2.5%)、Opus 5.5は0.05倍(5%)が適用されます。Fable 5.1は基準入力$10の2.5%で$0.25、Opus 5.5は基準入力$4の5%で$0.20。キャッシュ読み取りはOpus 5.5のほうが$0.05安く、Fable 5.1はその1.25倍という関係です。前世代のOpus 5($0.50)に対してFable 5.1が半額だった逆転は、Opus 5.5では成り立ちません。
これは細かい話に見えて、長時間エージェントの経済性を変えます。エージェントは同じシステムプロンプト・同じツール定義・同じ作業ファイル群を、ターンのたびに読み直します。セッションが長くなるほど、請求のうち「キャッシュ読み取り」が占める割合が支配的になっていく。その項目の差が1.25倍なら、総額の倍率は基本料金の2.5倍より小さくなります。ただし逆転はしません。
前提を置いた試算:長時間エージェント1セッションの内訳
実際にどれくらい縮むのか、前提を明記して計算します。以下は「同じ形の仕事をさせた場合」の仮定計算であり、実際のコストはタスク内容や出力の冗長さで変動します。
前提: 20万トークンのプレフィックス(システムプロンプト+ツール定義+作業ファイル)を最初に1回キャッシュへ書き込み、その後100ターンにわたって毎ターン読み直す。1ターンあたり新規入力(ユーザー指示+ツール実行結果)1,000トークン、出力2,000トークンとする。合計はキャッシュ読み取り20MTok、キャッシュ書き込み0.2MTok、新規入力0.1MTok、出力0.2MTok。キャッシュ書き込みは5分TTLの単価(Opus 5.5は$5/MTok、Fable 5.1とFable 5は$12.50/MTok)を使用。
| 内訳 | Claude Opus 5.5 | Claude Fable 5.1 | Claude Fable 5(参考) |
|---|---|---|---|
| キャッシュ読み取り(20MTok) | 20 × $0.20 = $4.00 | 20 × $0.25 = $5.00 | 20 × $1.00 = $20.00 |
| キャッシュ書き込み(0.2MTok・5分) | 0.2 × $5 = $1.00 | 0.2 × $12.50 = $2.50 | 0.2 × $12.50 = $2.50 |
| 新規入力(0.1MTok) | 0.1 × $4 = $0.40 | 0.1 × $10 = $1.00 | 0.1 × $10 = $1.00 |
| 出力(0.2MTok) | 0.2 × $20 = $4.00 | 0.2 × $50 = $10.00 | 0.2 × $50 = $10.00 |
| 1セッション合計 | $9.40 | $18.50 | $33.50 |
読み取れることが3つあります。
- Fable 5.1はOpus 5.5の約1.97倍。$18.50 ÷ $9.40 ≒ 1.97。カタログ上の「2.5倍」よりは縮みますが、キャッシュが効く形の仕事でも2倍近い差が残ります。1ドル150円で換算すると、Opus 5.5が1,410円、Fable 5.1が2,775円です。
- Fable 5から5.1へ上げるだけで約45%安くなる。同じセッションが$33.50から$18.50へ。($33.50 − $18.50) ÷ $33.50 ≒ 0.448。コードを1行(モデルID)変えるだけで効く節約としては、かなり大きい部類です。
- 損益分岐点はなくなった。キャッシュ読み取りの単価はOpus 5.5($0.20)のほうが安いので、読み取り量をどれだけ増やしても、Fable 5.1の総額がOpus 5.5を下回ることはありません。倍率は1.25倍に近づきますが、差額は読み取り1MTokあたり$0.05ずつ広がります。前世代のOpus 5(読み取り$0.50)とは27MTokで総額が並ぶ計算でしたが、Opus 5.5には当てはまりません。
逆に言うと、キャッシュが効かない仕事ではきっちり2.5倍です。単発の文書生成・チャット・大量バッチのように、毎回まっさらな入力を投げて出力を受け取る使い方なら、Fable 5.1の請求額はOpus 5.5のちょうど2.5倍になります(後述の「コスト差の実務インパクト」参照)。
この試算をそのまま信じてはいけない3つの理由
正直に書いておくと、上の計算には見落としやすい落とし穴があります。Anthropicが公式に「Fable 5から変わった挙動」として挙げている内容が、そのままコストに跳ね返るからです。
- 出力トークンが増えやすい: 公式ドキュメントは「テキストファイルを編集するとき、ピンポイントな修正ではなくファイル全体を書き直しがち」「文章が密になり、1文が長く段落区切りが減る場合がある」と明記しています。出力$50/MTokは据え置きなので、出力量が増えれば試算の$10.00の項が膨らみ、約1.97倍という倍率はさらに開きます。
- ターン数が増えやすい: 「並列ツール呼び出しのばらつきが大きくなり、Fable 5が複数まとめて呼んでいた場面で1ターン1呼び出しになることがある」とも書かれています。ターンが増えればキャッシュ読み取り(安い側)も増えますが、往復時間と実時間は延びます。公式は回避策として、エージェントループに「独立したツール呼び出しはまとめて出す」という一文を足すことを推奨しています。
- 低effortでは検索しなくなる: 「最も低いeffortでは、検索・取得ツールの呼び出し回数が減り、記憶から答えることが増える」との記載があります。コスト削減目的でeffortを下げると、鮮度が必要なタスクで裏取りをしなくなる可能性がある。安さと正確さのトレードオフがここにあります。
研修先の情シス部門でよく聞かれるのが「結局、料金表のどこを見て予算を組めばいいのか」という質問です。私の答えは「基本料金の行ではなく、自社のワークロードで実際に発生するトークン種別の内訳から見てください」です。今回のFable 5.1やOpus 5.5のように、キャッシュ読み取りだけ別の倍率が適用されるケースは、総額試算を作って初めて意味がわかります。
プロンプト1: キャッシュ込みの総額試算(Opus 5.5 対 Fable 5.1)
Claude Opus 5.5とClaude Fable 5.1の月額コストを、プロンプトキャッシュを含めて試算してください。

【単価(2026年10月2日時点の公式値)】
- Opus 5.5: 入力$4 / 出力$20 / キャッシュ読み取り$0.20(すべて1Mトークンあたり)
- Fable 5.1: 入力$10 / 出力$50 / キャッシュ読み取り$0.25(すべて1Mトークンあたり)
- 5分キャッシュ書き込み: Opus 5.5は$5、Fable 5.1は$12.50(1Mトークンあたり)

【自社の想定ワークロード】
- 月間のキャッシュ読み取りトークン数: [ここに記入。不明なら「1セッションのプレフィックス長 × 平均ターン数 × 月間セッション数」で計算させる]
- 月間のキャッシュ書き込みトークン数: [ここに記入]
- 月間の新規入力トークン数: [ここに記入]
- 月間の出力トークン数: [ここに記入]

【出してほしい内容】
1. 両モデルの月額費用を、トークン種別ごとの内訳表と計算式つきで提示
2. Fable 5.1がOpus 5.5の何倍になるかを小数第2位まで
3. 他の条件を固定したまま、キャッシュ読み取り量だけを増やした場合に倍率がどこまで縮むか(両者が並ぶ点があるかどうかも)
4. バッチAPI(入出力ともに50%割引)を使った場合の再計算

前提が足りない場合は、勝手に埋めずに最初に質問してください。
仮定した数値は必ず"仮定"と明記し、計算式を省略しないでください。
公式の位置づけと第三者ベンチマークの”ズレ”——9月1日と22日で何が変わったか
7月時点のこの記事では、Anthropicの公式ドキュメント内で「Opus 5はFable 5の半額でフロンティア級の知能」という表現と「最高水準の性能が必要な作業にはFable 5を」という序列表現が併存していることを問題として指摘していました。同じ会社の文書で言っていることが二重になっていたわけです。
9月1日のFable 5.1リリースで、この二重表現は整理されました。さらに9月22日のOpus 5.5公開で、起点のモデルがOpus 5からOpus 5.5に替わっています。公式のモデル一覧は、比較表の前に次の一文を置いています(2026年10月2日確認)。
「どのモデルを使うか迷ったら、ほとんどのワークロードではClaude Opus 5.5から始めてください。要求の厳しい推論と長期エージェント作業、あるいはOpus 5.5をより高いeffortで回しても評価基準に届かない場合に、Claude Fable 5.1を使ってください」
これは実務的には大きな変化です。7月時点では「公式は上位と言っているが、実測ではOpus 5が上」という状態を自分で読み解く必要がありました。今は公式が既定をOpus 5.5だと明言し、Fable 5.1を”条件付きの上位”に位置づけている。社内でモデル選定を説明するとき、根拠として公式文をそのまま引用できるようになった、と考えてください。なお、Fable 5.1のモデルページにある同じ趣旨の文は、2026年10月2日時点で「Opus 5から」のままです。
第三者ベンチマークの数字(7月時点・Opus 5 対 Fable 5)
前世代どうし(Opus 5とFable 5)の比較として、独立系ベンチマーク機関Artificial Analysisが2026年7月24日に公開した数値を再掲します。Opus 5.5とFable 5.1について、同機関の計測値をこの記事では確認していません(2026年10月2日時点)。
- Intelligence Index: 190モデル中、Opus 5が61点で1位、Fable 5が60点。事実上の互角
- AA-Briefcase(企業のオフィスワークを模したエージェントタスク・最大努力設定): Opus 5が1,720Elo、Fable 5が1,574Eloで、Opus 5が146ポイント上回る
- GDPval-AA v2(実務のエージェント的知識労働タスク): Opus 5が1,861Elo、Fable 5が約1,747Eloで、100ポイント以上の差
- コスト効率: Opus 5は同等の知的水準を26%低いコストで達成(タスクあたり平均$2.03 対 Fable 5の$2.75)
- AA-Omniscience(事実知識の網羅性): Fable 5がOpus 5を上回る
- Humanity’s Last Exam(科学的推論): 両者53%でタイ
Anthropic公式のベンチマーク(Opus 5.5・Fable 5.1と前世代)
Anthropicは9月22日のOpus 5.5発表で、Opus 5.5・Fable 5.1・Opus 5の結果を同じ表に並べました。Fable 5の列だけは9月1日のFable 5.1発表の値です(「—」は記載なし)。Opus 5.5の値は原則max effort、Terminal-Bench 4.0はxhigh effortでの結果です。
| ベンチマーク | Claude Opus 5.5 | Claude Fable 5.1 | Claude Opus 5(前世代) | Claude Fable 5(前世代) |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 24.7% |
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 42.0% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — |
| GDPval-AA v2.1(Elo) | 1846 | 1735 | 1708 | — |
この表では、どの項目もOpus 5.5がFable 5.1を上回っています。ただしAnthropic自身が同じ発表で、この水準ではベンチマークの差は実務の差を測る目安として当てになりにくく、社内で使った実感では両者の差はスコアが示すより小さい、と注記しています。Fable 5.1がFable 5から大きく伸びた点は変わらず、Terminal-Bench-Science 0.1は24.7%から52.6%へ2倍以上です。
公式が挙げているFable 5.1の強化領域は6つです。(1)数時間走る長時間エージェントコーディング(複数ファイル機能追加・大規模リファクタ・移行・デバッグ・コードレビュー)、(2)文書/スプレッドシート/スライドの知識労働、(3)多段Web調査とディープリサーチの精度、(4)密なグラフ・提出書類・PDF内の入れ子表を読むビジョン、(5)1Mトークン全域をまたぐ長文脈の推論、(6)ブラウザやデスクトップアプリを操作するコンピュータ操作と失敗ステップからの復帰。多言語性能はFable 5と同等とされています。
ここで注意したいのは、この表はAnthropic自身の公表値だということです。Opus 5.5とFable 5.1を比べた第三者の独立計測を、この記事では2026年10月2日時点で確認していません。公表値の範囲では、Fable 5.1がOpus 5.5を上回る項目は表にありません。それでも公式は「Opus 5.5を高いeffortで回しても評価に届かない場合」の上げ先としてFable 5.1を案内しています。
研修先の情シス部門からよく聞かれるのが、「ベンダーの推奨モデル表示をそのまま信じていいのか」という質問です。私の答えはいつも同じで、「公式の位置づけは”参考”、実務の判断材料は”自社のタスクで実測すること”」です。今回のように公式の案内が整理されたケースでも、この原則は変わりません。むしろ公式のモデル一覧自身が「Opus 5.5を高いeffortで回しても評価に届かない場合」という条件を置いている以上、自社の評価セット(eval)を持っていることが前提の書き方になっている、と読むべきです。
プロンプト2: 社内選定議論用「モデル比較検討シート」生成
以下の条件で、Claude Opus 5.5とClaude Fable 5.1のどちらを標準モデルにすべきかの社内検討シートを作成してください。

【比較対象(2026年10月2日時点の公式値)】
1. Claude Opus 5.5(claude-opus-5-5・入力$4 / 出力$20 / キャッシュ読み取り$0.20 per MTok)
2. Claude Fable 5.1(claude-fable-5-1・入力$10 / 出力$50 / キャッシュ読み取り$0.25 per MTok)

【前提として押さえる公式の位置づけ】
- ほとんどのワークロードはOpus 5.5から始める
- 要求の厳しい推論・長期エージェント作業、またはOpus 5.5を高effortで回しても評価に届かない場合にFable 5.1

【出してほしい形式】
- 評価軸(コスト・レイテンシ・精度・データ保持・API改修コスト・可用性)を6つ以上の表にする
- 自社の主要業務[ここに自社の業務内容を記入]を評価軸に当てはめて優劣を判定
- 「Opus 5.5を標準にしてFable 5.1へエスカレーションする条件」を3つ、判定可能な形で定義
- 最終推奨と、その理由を3行で要約

不足している情報があれば、最初に質問してから作業を開始してください。
仮定した点は必ず"仮定"と明記してください。
数字と固有名詞は、根拠(出典/計算式)を添えてください。タスク別の選択基準——理由つきで判断する
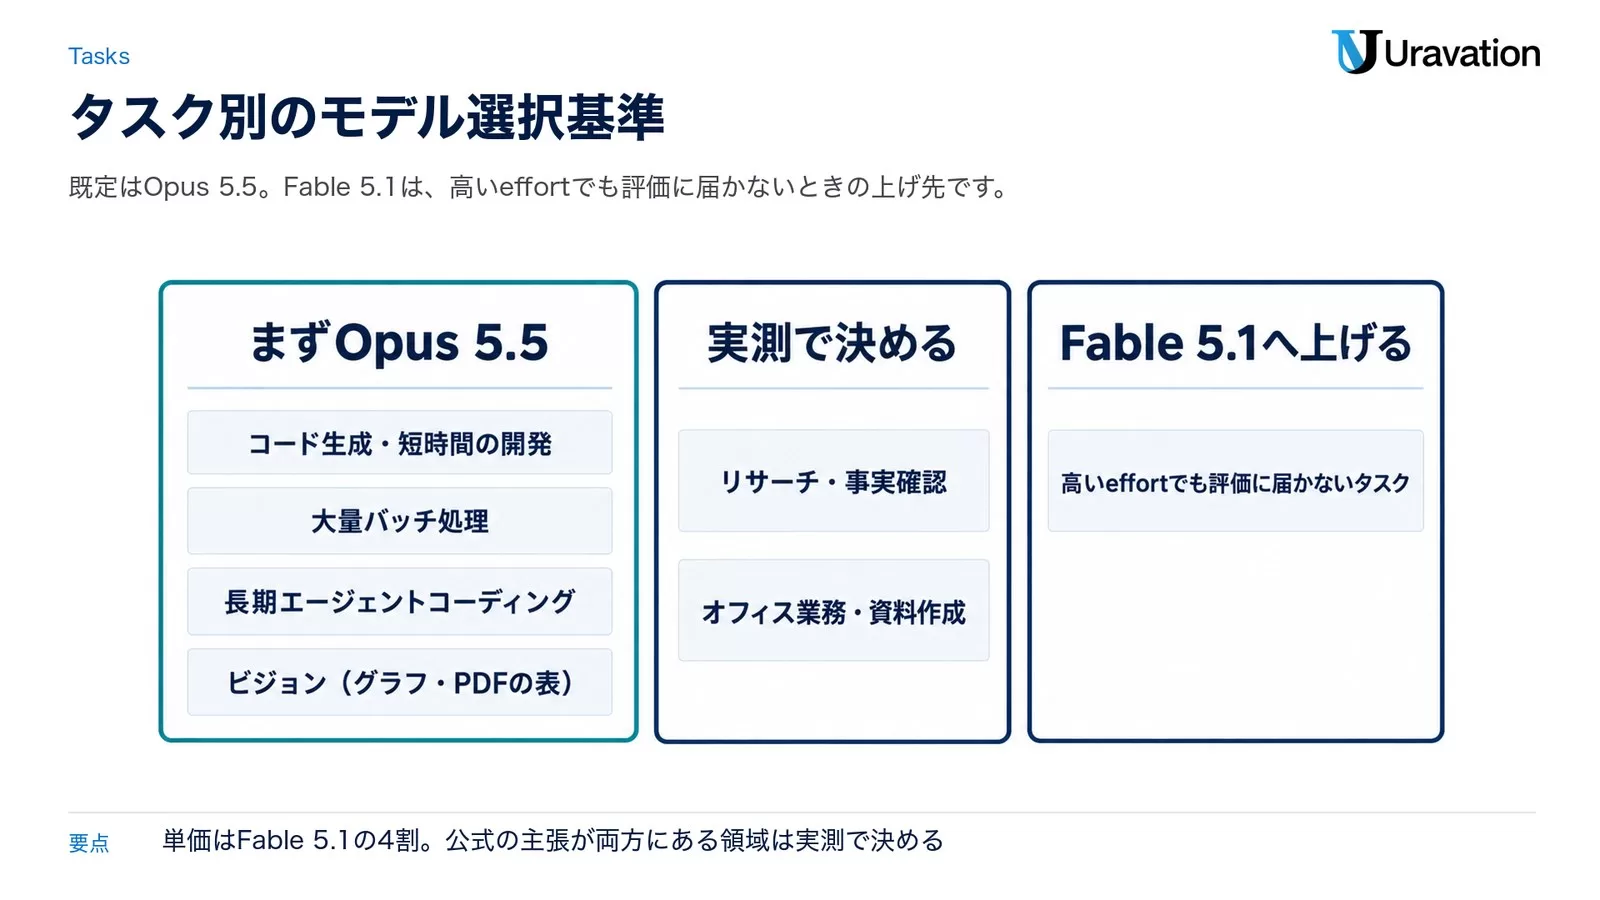
用途ごとの選択基準を、理由とあわせて整理します。2026年9月22日のOpus 5.5公開を反映した版です。
コード生成・短時間のソフトウェア開発
Opus 5.5が妥当。Anthropicの公表値では、CursorBench 4.0でOpus 5.5が57.8%、Fable 5.1が51.8%、Terminal-Bench 4.0で66.4%対55.8%です。既定のeffort(medium)でのCursorBench 4.0は52.5%で、max effortのFable 5.1は51.8%です。単価はFable 5.1の4割なので、日常のコーディング支援やレビューでFable 5.1を選ぶ積極的な理由は薄いままです。
数時間走らせる長期エージェントコーディング
まずOpus 5.5、評価に届かなければFable 5.1。Fable 5.1の公式ドキュメントは「複数ファイルにまたがる機能追加、大規模リファクタと移行、デバッグ、数時間走るセッションをまたぐコードレビュー」を強化領域の筆頭に挙げています。一方、公式のモデル選定表はOpus 5.5の例にも「数時間の自律コーディングエージェント、大規模リファクタ」を挙げ、Opus 5.5の発表には、HAProxyをCからRustへ書き換える社内テストでOpus 5.5が9.5時間、Fable 5.1が12時間で終え、コストは51%低かったという結果が載っています。長く走らせる仕事でも、Opus 5.5から試す順番が合理的です。
長文読解・大量ドキュメントの要約
コンテキスト長は引き分け。長文脈の強化はFable 5比での公式主張。1Mトークンのコンテキストウィンドウは3モデルとも同一です。Fable 5.1の強化領域(Fable 5比)には「1Mトークン全域にわたって details を推論しつなげる長文脈作業」が明記されています。Opus 5.5との優劣については、2026年10月2日時点で公式に記載なしです。一方でFable 5.1は「文書を要約するとき、原文の一節を引用と明示せずに再現しやすい」とも公式に注意書きがあります。社外に出す要約では、引用箇所の明示をプロンプト側で必ず指示してください。
リサーチ・事実確認
公式の主張が両方にあるので実測で決める。公式のモデル選定表はFable 5.1の例に「多段のディープリサーチ」を挙げ、Fable 5.1の強化領域にも「多段Web調査とディープリサーチの精度向上」が入っています。一方、Opus 5.5の発表には、四半期レポートを書かせる社内テストでOpus 5.5の18本中16本が品質基準を満たし、Fable 5.1とOpus 5は1本も満たさなかったという結果が載っています。なおFable 5.1は、低effortでは検索ツールを呼ばずに記憶から答える傾向が強まるとされています。鮮度が要る調査ではeffortを上げるか、会話途中でeffortを引き上げる運用にしてください。
エージェント実行(自律的な複数ステップ作業)
既定はOpus 5.5、届かないときだけFable 5.1。Anthropic公表のGDPval-AA v2.1(44職種の実務タスク)は、Opus 5.5が1846、Fable 5.1が1735です。数時間規模の長期エージェントは公式がFable 5.1の用途に挙げていますが、上げる条件は「Opus 5.5を高いeffortで回しても評価に届かない場合」です。なお強制ツール使用(tool_choice: any / tool)は、Opus 5.5でもFable 5.1でも400エラーになります。前世代のOpus 5やFable 5で使っていた実装は、どちらへ移る場合も改修が必要です。公式は代替として「tool_choiceはautoのままstrict tool useでスキーマを強制する」「structured outputsへ移す」「プロンプトで”このツールを使って回答して”と明示する」を挙げています。
ビジョン(グラフ・PDF内の表を読ませる)
両方に公式の主張がある。「密なグラフ、提出書類、PDF内に入れ子になった表を読む」ことがFable 5.1の強化領域(Fable 5比)として公式に列挙されており、グラフに対するクロップ&ズームツールの利用にも触れられています。Opus 5.5も密なグラフから値を読み取る精度が上がったと公式に書かれ、Anthropic公表のグラフ読み取り評価(Chartography・ツールあり)はOpus 5.5が89.0%、Fable 5.1が88.4%でほぼ並びます。画像化された表を扱う業務では、まずOpus 5.5で試してください。
大量バッチ処理
Opus 5.5が有利。バッチAPIの50%割引を適用すると、Opus 5.5は入力$2・出力$10/MTok、Fable 5.1は入力$5・出力$25/MTokで、割引後も単価は2.5倍のまま。キャッシュ読み取りの単価もOpus 5.5のほうが安いので、コスト面でFable 5.1が有利になる条件はありません。処理件数が多いタスクほど、この差は月額コストに直結します。
オフィス業務・資料作成(スプレッドシート・スライド生成)
両方に公式の主張があるので実測で決める。AnthropicはOpus 5.5を「長時間のエージェントコーディングと知識労働向け」と位置づけ、発表では、Excelの財務モデルと役員向けプレゼン資料を作らせる社内テストでOpus 5.5が63分、Opus 5が93分で終え、コストは50%低かったと報告しています。一方Fable 5.1も「最初の問いから、完成した文書・生きた数式入りスプレッドシート・白紙から組んだスライドデッキまで持っていく知識労働」を強化領域に挙げている。ここは公式の主張が重なる領域なので、自社のテンプレートと実データで両方回して比べるのが早いです。研修・コンサルの現場でも、経理・総務・営業事務からの相談で最も多いのが資料作成の効率化なので、ここは実測の価値が高い領域です。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
コスト差の実務インパクト——キャッシュが効かない場合の試算
前述のキャッシュありの試算に対して、こちらはキャッシュが効かない一般的なワークロードの場合です。以下はあくまで「同じトークン量の仕事をさせた場合」の仮定計算であり、実際のコストはタスク内容や出力の冗長さで変動します。
前提: 月間で入力1,000万トークン(業務文書・コード・会話履歴の投入)、出力300万トークン(生成される文章・コード)を消費するケースを想定。プロンプトキャッシュの利用率は0%とする。
| Opus 5.5 | Fable 5.1 | 差額 | |
|---|---|---|---|
| 入力コスト | 1,000万tok × $4 = $40.00 | 1,000万tok × $10 = $100.00 | $60.00 |
| 出力コスト | 300万tok × $20 = $60.00 | 300万tok × $50 = $150.00 | $90.00 |
| 月額合計 | $100.00 | $250.00 | $150.00(ちょうど2.5倍) |
キャッシュを使わない限り、入力・出力ともに単価がぴったり2.5倍に設定されているため、消費トークン量に関わらずFable 5.1の請求額はOpus 5.5のちょうど2.5倍になります。1ドル150円で換算すると、月15,000円と37,500円です。コストだけで見ればOpus 5.5が安いという結論は、ワークロードの形に関わらず変わりません。
自社がどちらの形に近いかは、請求の内訳(またはAPIレスポンスのusage)で分かります。cache_read_input_tokensが入力トークン全体の大半を占めているならキャッシュ型、ほぼゼロなら非キャッシュ型です。キャッシュ型ならFable 5.1との倍率は2.5倍より縮み、非キャッシュ型なら2.5倍のままです。Fable 5.1へ上げるかどうかは、コストではなく「Opus 5.5で評価に届くか」で決めてください。前世代のOpus 5を前提にした円換算の月額シミュレーションはClaude Opus 5料金完全ガイドにまとめています。
プロンプト3: 請求内訳からモデル適性を判定する
Claude APIの利用実績から、Claude Opus 5.5とClaude Fable 5.1のどちらが自社に向いているか判定してください。

【貼り付けるデータ】
直近1か月のusage内訳(1つでも分かる範囲で可):
- input_tokens: [記入]
- cache_creation_input_tokens: [記入]
- cache_read_input_tokens: [記入]
- output_tokens: [記入]
- 1セッションあたりの平均ターン数: [記入]
- 1セッションあたりの平均実行時間: [記入]

【判定してほしいこと】
1. キャッシュ読み取りが入力全体に占める割合(%)
2. 上記の割合から見て「キャッシュ型ワークロード」か「非キャッシュ型ワークロード」か
3. 単価(Opus 5.5: $4 / $20 / キャッシュ読み取り$0.20、Fable 5.1: $10 / $50 / キャッシュ読み取り$0.25 per MTok)を当てはめた両モデルの月額比較
4. 上記を踏まえた推奨と、判断が変わる境界条件

数値が欠けている項目は勝手に補わず、「不明」として扱い、その影響を明記してください。
処理速度・待ち時間の違い——体感のストレスに直結する数字
ベンチマークスコアと同じくらい実務で効いてくるのが、待ち時間の体感です。Anthropicの公式モデル比較表では、レイテンシの相対評価がOpus 5.5=Moderate、Fable 5.1=Slowerと明記されています(Sonnet 5.5がFast、Haiku 4.5がFastest)。つまり公式の建て付けとして、Fable 5.1は速さを犠牲にして深さを取るモデルです。Opus 5.5の発表では、出力の生成がOpus 5より30%以上速いともされています。
前世代どうしを比べたArtificial Analysisの計測(Opus 5とFable 5・2026年7月時点)では、出力速度はOpus 5が52.8トークン/秒、Fable 5が73.1トークン/秒でした。ただしFable 5は最初の1トークンが出るまでに平均90.7秒かかっており、チャット画面で「待たされている」と感じる時間はFable系のほうが長くなりやすい、という結果です。Opus 5.5とFable 5.1の計測値は、この記事では確認していません。
加えてFable 5.1では、UI設計に影響する変更が1つあります。公式は「長いツール実行中の進捗更新が減った。特に高いeffortでは、ツール呼び出しの合間にユーザー向けテキストを書く量が減る」と明記しています。既定のthinking.displayは"omitted"なので、進捗ブロックは空で返り、長いエージェントターンが利用者から見て”沈黙”に見える。対策としてdisplay: "updates"(beta)を設定すると、推論は隠したまま進捗更新だけをテキストとして受け取れます。ユーザー向け画面に進捗を出している製品は、移行前にここを確認してください。Opus 5.5でも、Opus 5ではtextブロックで返っていた合間の文章が思考ブロックで返るようになり、既定の表示設定では空になります。
Fable 5ユーザーの3択——「5.1へ上げる」「Opus 5.5へ降りる」「据え置く」
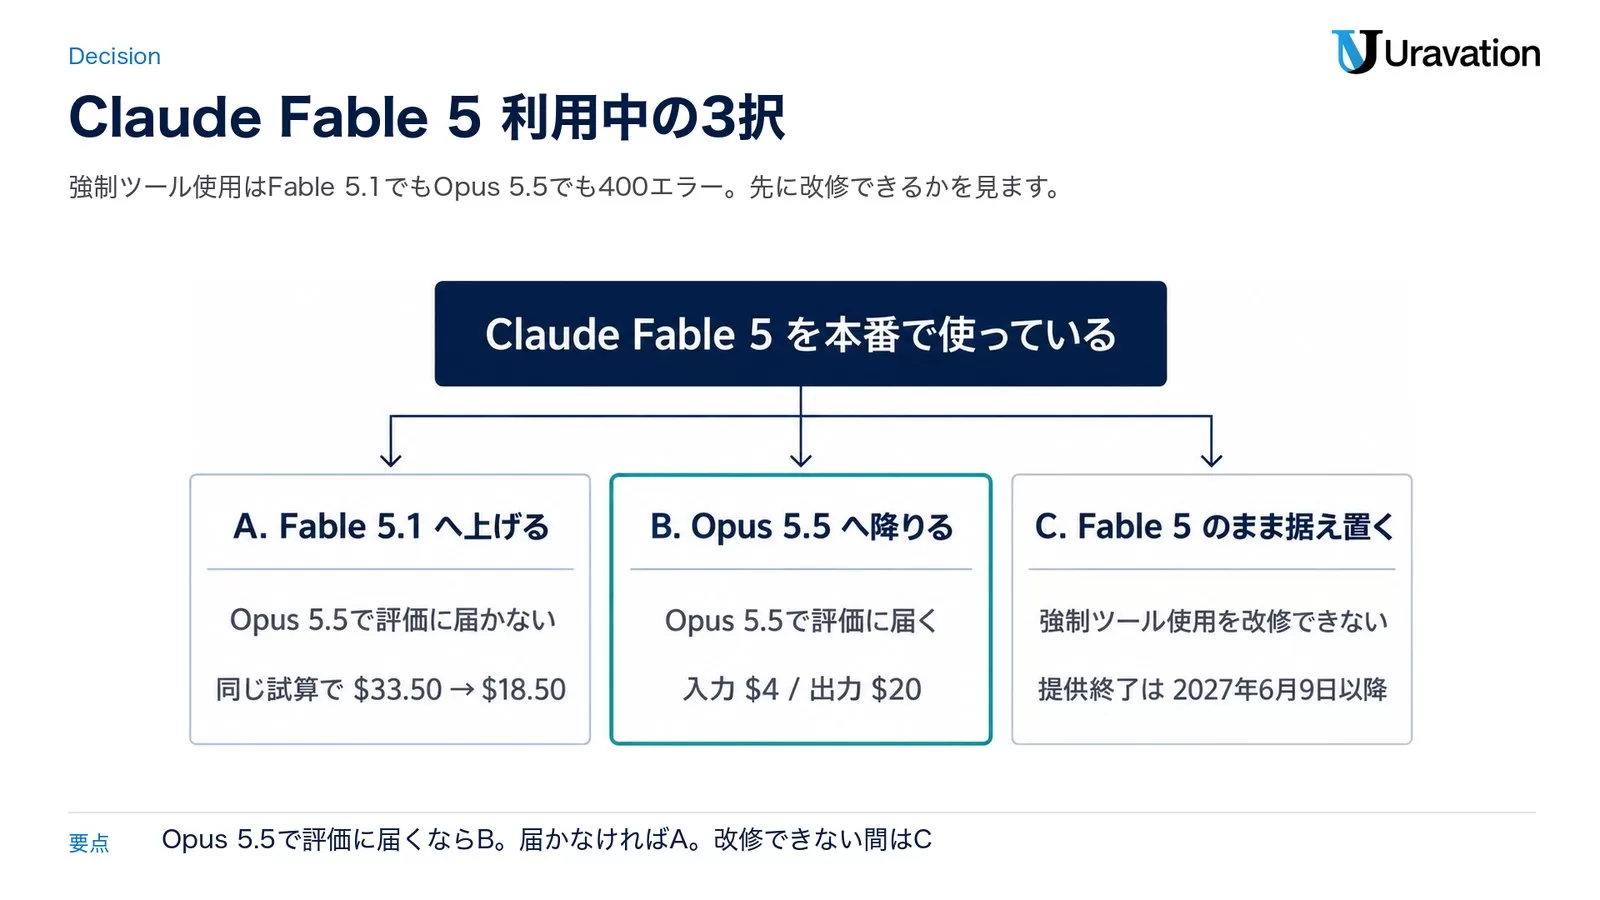
ここからが、Fable 5(無印)を本番運用している組織向けの本題です。5.1の登場でFable 5は前世代になりました(廃止スケジュールは Active のまま、モデルページは Legacy 表示・2026年10月2日確認)。退役は2027年6月9日より前にはないとされているので、明日止まるわけではありません。ただし「新機能はもう来ない世代」に乗り続ける判断は、意識的にすべきです。選択肢は3つあります。
ステップ1: まず破壊的変更3点に当てはまるか確認する
Fable 5.1への移行が「モデルIDを1行変えるだけ」で済むかどうかは、この3点で決まります。Anthropicが公式に破壊的変更(breaking changes)として挙げているものです。
| 破壊的変更 | 何が起きるか | 確認する場所 |
|---|---|---|
| 強制ツール使用が非対応 | tool_choiceに{"type":"any"}または{"type":"tool","name":"..."}を指定すると400 invalid_request_errorを返す。auto(既定)とnoneは従来どおり | APIリクエストを組み立てているコード全体をtool_choiceでgrep |
| 思考ブロックがモデルに紐づく | Fable 5.1の思考ブロックを、それより前のモデルは読めない。Fable 5.1へ移る会話は推論を引き継げるが、Fable 5.1から前のモデルへ戻す会話はその分を失う | ルーターやフォールバックで会話の途中にモデルを切り替えている箇所 |
| 過去ターンの編集で思考ブロックが無効化 | 思考ブロックより前(systemプロンプト、tools、過去メッセージ)を書き換えると、次のリクエストでエラーになるか、ブロックが破棄される | messages配列を自前で組み立てているコード。Claude Code・claude.ai・Claude Agent SDKは自動で保たれる |
3つ目は特に見落としやすい落とし穴です。公式が「後続の思考ブロックを全部無効にするパターン」として挙げているのは、過去ターンの編集・並べ替え・削除、リクエストごとに注入して次で消す一行リマインダー、同じ会話内でのsystemプロンプトやtools配列の作り直し、後のリクエストで違うバイトを返す画像/文書URLの4つ。「毎回systemプロンプトを組み立て直している」実装は、まさにこれに該当します。
逆に、後続ブロックを有効なまま保てるのは、先頭から古い順に思考ブロックを外すこと、サーバー側の圧縮やコンテキスト編集で履歴を削ること、cache_controlマーカーの移動、リクエスト間でのeffort変更です。会話を「追記のみ(append-only)」として扱うのが基本方針になります。
なお、このチェックが強制されるのは2026年8月31日以降に作成されたアカウントで、それ以前のアカウントではAPIが不一致を記録するだけで、リクエストがthinking.block_binding.prefix_mismatch_behaviorを指定したときにだけ作用します。既存アカウントだから今は動く、という状態に安心しないでください。
ステップ2: 3択を判定する
| 選択肢 | 選ぶべき条件 | やること | 注意点 |
|---|---|---|---|
| A. Fable 5.1へ上げる | 1セッションが数時間規模の長期エージェント/多段リサーチ/PDF内の表を読ませる作業が中心。強制ツール使用を使っていない、または改修できる | モデルIDをclaude-fable-5からclaude-fable-5-1へ。そのうえで公式の移行チェック5項目を実施 | 前掲の試算では同じセッションが$33.50→$18.50(約45%減)。ただし出力が増える傾向があるので評価セットの再実行は必須 |
| B. Opus 5.5へ降りる | コーディング・エージェント実行が中心で、Opus 5.5で評価に届く/請求額の2.5倍差が経営判断に直結している/ゼロデータ保持(ZDR)が契約要件 | モデルIDをclaude-opus-5-5へ。強制ツール使用の除去、履歴を書き換えない運用、拒否応答(refusal)の処理は、Opus 5.5でもFable 5.1と同じく必要 | Opus 5.5はFable系の思考ブロックを読めない(公式に明記)。会話の途中で降りると、その分の推論は引き継げない。effortの既定はmediumなので、明示して評価し直す |
| C. Fable 5のまま据え置く | 強制ツール使用に深く依存していて短期に改修できない/年度内に評価セットを回す工数が取れない/別システムの更改とタイミングを合わせたい | 2027年6月9日以降という提供終了の目安をカレンダーに登録し、移行の期限を決めておく | キャッシュ読み取りが$1.00/MTokのままなので、長時間セッションでは5.1より高い。据え置きコストを見える化しておく |
研修先やコンサル先でこの判断を一緒に整理する際、「両方を試して評価する期間を1〜2週間だけ設ける」ことを勧めています。ベンチマークの数字は目安であり、自社の実データ・実タスクで比較しないと最終判断はつきません。特に今回は、公式の推奨条件そのものが「Opus 5.5を高effortで回しても評価に届かない場合」という書き方になっている以上、評価セットを持っていない組織は、まず評価セットを作るところからです。
ステップ3: 移行後に必ず確認する5項目
Anthropicの移行手順に沿って、Fable 5から5.1へ上げた直後に確認すべきことをまとめます。
- tool_choiceの棚卸し:
anyとtoolを除去し、スキーマの強制はstrict tool use(tool_choice: autoのまま)かstructured outputsへ移す - 履歴の追記のみ化: 思考ブロックはそのまま返す。ターンごとのリマインダーはturn-scoped system message(beta)へ、systemやtoolsの変更は会話途中のsystem messageへ移す。コンテキストの削減はサーバー側のcontext editing/compactionで行う
- effortの再チューニング: 既定はhigh。セッション全体で1つの値を固定せず、会話途中で変える運用(beta)も検討する
- エージェントループの並列性: Fable 5が複数まとめて呼んでいた場面で1ターン1呼び出しになっていないか監視し、必要なら「独立したツール呼び出しはまとめて出す」という一行をプロンプトに追加する
- 評価セットの再実行: 拒否ハンドリング・フォールバック・フォールバッククレジット・トークン数は変更なしで引き継がれる。変わるのはキャッシュ読み取り価格と、前述の既定挙動
変更点の全体像と移行時の具体的なコード差分は、Claude Fable 5.1リリース|変更点・料金・移行【2026年9月】に整理しています。API実装を触る担当者はそちらもあわせて確認してください。
プロンプト4: Fable 5.1移行前のコード監査
Claude Fable 5からClaude Fable 5.1への移行にあたり、既存コードの監査チェックリストを作成してください。

【Fable 5.1の破壊的変更(3点)】
1. 強制ツール使用が非対応(tool_choiceのanyとtoolは400エラー。autoとnoneは従来どおり)
2. Fable 5.1の思考ブロックは、それより前のモデルが読めない(一方向)
3. 思考ブロックより前(systemプロンプト、tools、過去メッセージ)を編集すると、思考ブロックが無効化される

【監査してほしい観点】
- どのファイル/関数でtool_choiceを設定しているか、代替案(strict tool use / structured outputs / プロンプトでの明示指示)のどれが適切か
- messages配列を自前で組み立てている箇所で、過去ターンを編集・並べ替え・削除しているパターンがないか
- リクエストごとに注入して次で消しているテキスト(リマインダー、ステータス行)がないか
- 同じ会話内でsystemプロンプトやtools配列を作り直している箇所がないか
- 会話の途中でモデルを切り替えるルーター/フォールバックがあるか

【出力形式】
- 該当箇所 / リスク / 推奨する修正 / 想定工数(S・M・L)の4列の表
- 修正の優先順位(本番停止に直結する順)

対象コードは次に貼ります。読み取れない前提は勝手に補わず、質問してください。
[ここにコードを貼る]
補足: Opus 5を使っている場合——Opus 5.5へ上げる前の確認4点
Opus 5は廃止スケジュールで Active のまま、提供終了は2027年7月24日より前にはないとされています(2026年10月2日確認)。公式のモデルページはOpus 5.5への移行を勧めており、単価は入出力とも2割安く、キャッシュ読み取りは$0.50から$0.20へ下がりました。ただし、Opus 5で動いているコードに影響する破壊的変更が4つあります。
- 思考を無効化できない: thinkingのdisabledやbudget_tokensの指定は400エラー。深さはeffortで調整する
- 強制ツール使用が非対応: tool_choiceのanyとtoolは400エラー
- 思考ブロックがモデルと会話に紐づく: Opus 5.5の思考ブロックを読めるのはClaude API上のFable 5.1とMythos 5.1だけ。過去ターンを書き換えると無効になる
- 旧コンピュータ操作ツールが非対応: Claude APIとGoogle Cloudでは
computer_20251124が400エラー
エラーにならない変更も2つあります。effortの既定値がhighからmediumに変わったことと、ツール呼び出しの合間の文章が思考ブロックで返るようになったことです。effortを明示して評価セットを回し直してください。
併用戦略——タスクで振り分ける運用ルール
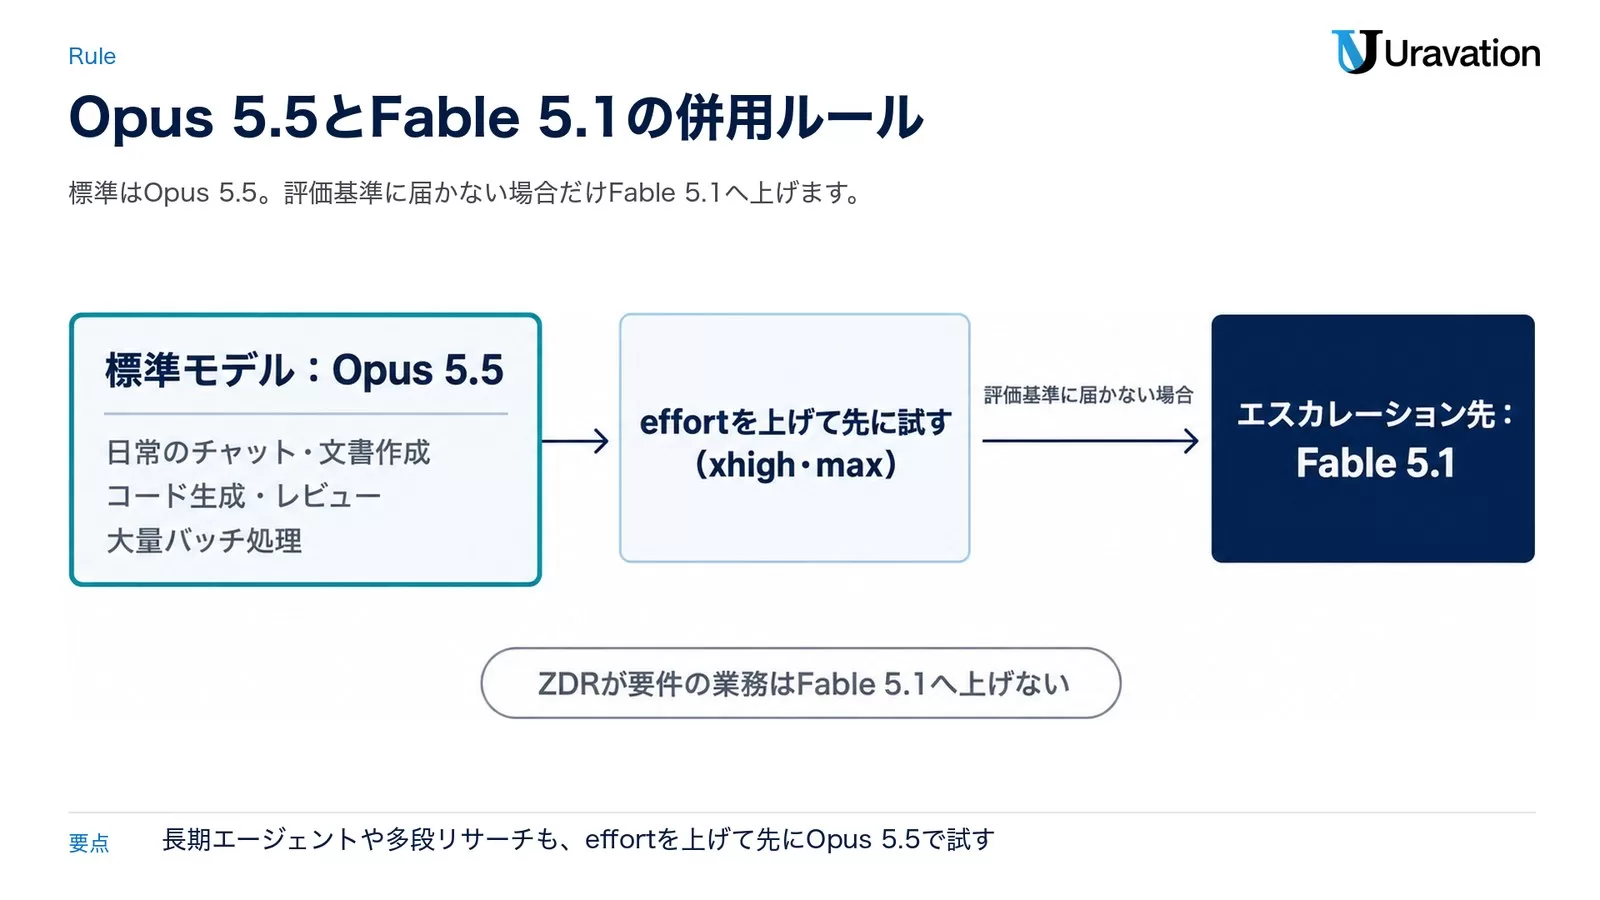
「どちらか一方に統一する」よりも、タスク単位でモデルを振り分ける方が、コストと精度のバランスが取れます。実際、Fable 5は2026年6月に輸出管理をめぐる措置で3週間にわたり全世界で利用停止になった実績があり(詳しくはFable 5利用再開の全経緯で解説)、単一モデルへの依存はコストだけでなく可用性の観点からもリスクです。以下は、実際の社内ルール策定で使える振り分け方針の一例です。
| 業務カテゴリ | 標準モデル | エスカレーション先 |
|---|---|---|
| 日常のチャット・文書作成・短時間のエージェント運用 | Opus 5.5 | 評価基準に届かない場合のみFable 5.1で再実行 |
| コード生成・レビュー(単発〜数十分) | Opus 5.5 | 設計判断が特に難しい局面だけFable 5.1 |
| 数時間走る長期エージェント(大規模リファクタ・移行) | Opus 5.5(effortを上げて先に試す) | xhigh・maxでも評価基準に届かない場合はFable 5.1 |
| 重要な調査・多段リサーチ・意思決定資料 | Opus 5.5 | 評価基準に届かない場合はFable 5.1(公式のモデル選定表が例に挙げる領域) |
| 密なグラフ・PDF内の表を読ませる作業 | Opus 5.5 | 読み取りの誤りが残る場合はFable 5.1でも試して比べる |
| 大量バッチ処理(件数優先) | Opus 5.5 | 原則エスカレーションなし |
| ゼロデータ保持(ZDR)が要件の業務 | Opus 5.5(契約窓口で要確認) | Fable 5.1は原則不可のためエスカレーション先にしない |
この表で1行だけ性質が違うのが最終行です。ZDR要件のある業務は「コストと精度で選ぶ」話ではなく「契約上使えるかどうか」の話なので、エスカレーションの選択肢そのものが存在しません。Fable 5.1とMythos 5.1は、Fable 5・Mythos 5と同じくCovered Modelに指定され、30日のデータ保持がかかり、Anthropicが明示的に許可しない限りゼロデータ保持では利用できないと公式に書かれています。ここは情報システム部門と法務部門の側で先に線を引いておくべき項目です。
もう1つ、9月1日から新しく考慮に入るのがコンテンツ来歴です。Fable 5.1とMythos 5.1が生成したテキストには、モデルが提供されている全プラットフォームでAnthropicの統計的テキスト透かしが入ります。Files API経由で取得した画像・動画には、署名付きのC2PA Content Credentialsが付く。公式は「透かしは出力の意味・品質・可読性を変えず、トークンを増やさず、隠し文字も入れず、利用者や組織の情報は持たない」と説明しています。とはいえ「AI生成物であることを判別可能にする仕組みが公式に入った」こと自体は、社内ガイドラインで触れておく価値があります。Opus 5.5も、発表で「Fable 5.1と同じく透かしの対策を備える」と明記されています。
プロンプト5: 併用ルール(社内運用ガイドライン)の雛形生成
Claude Opus 5.5とClaude Fable 5.1を併用する社内運用ガイドラインの雛形を作成してください。

【含めてほしい項目】
1. 標準モデルとエスカレーション条件(業務カテゴリ別に表形式で)
   - 既定はOpus 5.5。Fable 5.1へ上げるのは「数時間規模の長期エージェントや多段リサーチで、Opus 5.5を高effort(xhigh・max)で回しても評価基準に届かない場合」
2. モデル切り替えの承認フロー(誰が判断するか)
3. データ保持の制約(Fable 5.1はCovered Model指定・30日保持・原則ゼロデータ保持不可)を踏まえた、扱ってよいデータの線引き
4. 可用性リスク(過去の輸出管理による利用停止事例)を踏まえた代替手順
5. コスト超過時のアラート基準(キャッシュ読み取り比率も監視項目に入れる)
6. AI生成物であることの明示(Fable 5.1はテキスト透かしとC2PAに対応)に関する社内ルール

自社の組織構造[ここに部署名・承認者を記入]に合わせてカスタマイズしてください。
仮定した点は必ず"仮定"と明記してください。
プロンプト6: タスク振り分け判定(1タスクごとのその場判断)
これから依頼するタスクについて、Claude Opus 5.5とClaude Fable 5.1のどちらで処理すべきか判定してください。

【判定基準(2026年10月2日時点の公式方針に準拠)】
- 既定はOpus 5.5から始める
- 数時間規模の長期エージェント作業・大規模リファクタ・多段リサーチ → まずOpus 5.5を高いeffortで。評価基準に届かなければFable 5.1
- 密なグラフやPDF内の入れ子表を読む必要がある → まずOpus 5.5。読み取りの誤りが残ればFable 5.1
- Opus 5.5を高いeffortで回しても評価基準に届かなかった → Fable 5.1
- 件数の多いバッチ処理・キャッシュが効かない単発処理 → Opus 5.5
- ゼロデータ保持が要件 → Fable 5.1は使わない

【タスク内容】
[ここに依頼したいタスクを記入]

判定結果と理由を3行以内で回答してください。
判定に必要な情報が足りない場合は、推測せずに何が足りないかを1行で返してください。
プロンプト7: Fable 5からの3択判定(経営層への説明用)
当社はClaude Fable 5を本番で使っています。次の3択のどれを取るべきか、経営層に説明できる形で整理してください。

【3択】
A. Claude Fable 5.1へ上げる
B. Claude Opus 5.5へ降りる
C. Claude Fable 5のまま据え置く

【判断材料(2026年10月2日時点)】
- Fable 5は前世代(公式ステータスは Active)。退役は2027年6月9日より前にはない
- Fable 5.1は入力$10 / 出力$50でFable 5と同額。キャッシュ読み取りのみ$1.00→$0.25
- Opus 5.5は入力$4 / 出力$20、キャッシュ読み取り$0.20。強制ツール使用は非対応(Fable 5.1と同じ)
- Fable 5.1の破壊的変更は3点(強制ツール使用が非対応/思考ブロックがモデルに紐づく/過去ターンの編集で思考ブロックが無効化)

【当社の状況】
- 1セッションの平均実行時間: [記入]
- 強制ツール使用(tool_choiceのanyまたはtool)の利用: [あり/なし]
- messages配列を自前で組み立てているか: [はい/いいえ]
- ゼロデータ保持の契約要件: [あり/なし]
- 月間のAPI費用: [記入]

【出力形式】
1. 推奨する選択肢と理由(3行)
2. 選ばなかった2つを外した理由(各2行)
3. 実施した場合の想定コスト影響(増減の方向と概算)
4. 意思決定に必要だが今わからない情報のリスト

わからない項目を推測で埋めないでください。
【要注意】モデル選びでよくある失敗パターン
失敗1: 基本料金の行だけ見て「常に2.5倍」と決めつける
❌「Fable 5.1は入力$10・出力$50でOpus 5.5の2.5倍だから、長時間エージェントの総額も2.5倍になる」
⭕「キャッシュ読み取りはFable 5.1が$0.25、Opus 5.5が$0.20で差は1.25倍。自社のusage内訳でキャッシュ読み取りの比率を見てから総額で比べる」
なぜ重要か: キャッシュ読み取りはFable 5.1が基準入力の2.5%、Opus 5.5が5%で、基本料金とは倍率が違います。長時間エージェントほどキャッシュ読み取りが支配的になるため、前掲の試算では2.5倍が約1.97倍まで縮みました。逆に「キャッシュが効くならFable 5.1のほうが安い」という9月前半の理解は前世代のOpus 5との比較で、Opus 5.5には当てはまりません。
失敗2: 「モデルIDを1行変えるだけ」で移行できると思い込む
❌「claude-fable-5をclaude-fable-5-1に置換すれば移行完了」
⭕「破壊的変更3点(強制ツール使用の非対応・思考ブロックのモデル紐づき・過去ターン編集での無効化)を先にコードで確認してから置換する」
なぜ重要か: tool_choiceにanyやtoolを渡している実装は、置換した瞬間に400エラーで止まります。また、リクエストごとにsystemプロンプトを組み立て直している実装は思考ブロックが無効化されます。特に後者は2026年8月31日以降に作成したアカウントでのみ強制されるため、「開発環境では動いたのに新しく作った本番アカウントで落ちる」という順序で表面化しかねません。
失敗3: ベンチマークスコアの総合点だけで判断する
❌「Anthropicの公表値でOpus 5.5がFable 5.1を上回っているから、Opus 5.5がすべての面で優れている」
⭕「公表値は目安。Anthropic自身が、この水準ではスコアの差は実務の差を測りにくいと注記している。自社のタスクで両方を回して比べる」
なぜ重要か: 総合指標は複数の評価軸を平均したものです。自社の業務がどの評価軸に近いかを見極めないと、「総合1位のモデルなのに自社業務では期待通りの結果が出ない」という事態が起きます。また、7月時点の第三者計測(AA-OmniscienceやAA-Briefcase)は前世代のOpus 5とFable 5の比較です。Opus 5.5とFable 5.1の優劣として読まないでください。
失敗4: データ保持ポリシーの確認を後回しにする
❌「性能とコストだけ比較して契約し、あとからゼロデータ保持(ZDR)が使えないと気づく」
⭕「機密性の高いデータを扱う業務では、契約前にデータ保持ポリシー(Fable 5.1・Mythos 5.1はCovered Model指定で30日保持・原則ZDR不可)を必ず確認する」
なぜ重要か: 情報システム部門・法務部門が事後にポリシー違反に気づくケースは、研修現場でも実際によく相談を受けます。Fable 5.1でもこの制約は引き継がれたので、「新バージョンで緩和されたのでは」という期待で確認を飛ばさないでください。契約前のチェックリストに必ず含めるべき項目です。
失敗5: コスト削減のためにeffortを下げっぱなしにする
❌「Fable 5.1は高いから、effortをlowに固定して使えば安く済む」
⭕「鮮度が必要なターンだけeffortを上げる。会話途中でのeffort変更(beta)を使えば、プロンプトキャッシュを壊さずに切り替えられる」
なぜ重要か: 公式は「最も低いeffortでは検索・取得ツールの呼び出しが減り、記憶から答えることが増える」と明記しています。最新情報が要る調査でこれをやると、古い知識で断定した回答が返ってきます。安さのために正確さを捨てる設定になっていないか、運用ルールで担保してください。
よくある質問
Q1. Opus 5.5とFable 5.1、結局どちらを標準にすべきですか?
A. 2026年10月2日時点の公式方針ではOpus 5.5が標準です。公式のモデル一覧は「迷ったら、ほとんどのワークロードはClaude Opus 5.5から始めてください」と明記し、Fable 5.1の用途を「要求の厳しい推論と長期エージェント作業、またはOpus 5.5を高いeffortで回しても評価基準に届かない場合」としています。料金はOpus 5.5が入力$4・出力$20、Fable 5.1が入力$10・出力$50で、2.5倍の差があります。
Q2. Fable 5.1とFable 5は何が違いますか?
A. 入力$10・出力$50という基本料金は同じで、キャッシュ読み取りだけ$1.00から$0.25へ4分の1になりました。性能面では長時間エージェントコーディング・文書/スプレッドシート/スライドの知識労働・多段リサーチ・ビジョン・長文脈・コンピュータ操作の6領域が強化されています。Anthropicの発表では、Terminal-Bench-Science 0.1が24.7%から52.6%へ、Terminal-Bench 4.0が42.0%から55.8%へ伸びました。一方でAPIには破壊的変更が3点あるので、置換前にコードの確認が必要です。
Q3. Fable 5(無印)はいつまで使えますか?
A. 公式の廃止スケジュール(platform.claude.com model-deprecations)では2026年10月2日時点も Active で、退役は2027年6月9日以降と案内されています。すぐ止まるわけではありませんが、新機能が来ない世代なので、移行の期限をカレンダーに登録しておくことをおすすめします。なお提供終了の目安は、Fable 5.1が2027年9月1日以降、Opus 5.5が2027年9月22日以降、前世代のOpus 5が2027年7月24日以降とされています。
Q4. コンテキストウィンドウは同じですか?
A. はい。Opus 5.5・Fable 5.1・Fable 5とも1Mトークンのコンテキストウィンドウ、最大出力128kトークンで同一です。キャッシュ可能な最小プロンプト長も512トークンで共通。長文処理の”入る/入らない”では差がつきません。なおFable 5.1は「1Mトークン全域にわたって details を推論しつなげる長文脈作業」が、Fable 5比の強化領域として公式に挙げられています。
Q5. Claude Pro・Maxプランではどちらが使えますか?
A. Opus(現行はOpus 5.5)はPro以上の有料プランで使えます。公式の料金ページの比較表では、OpusはFreeが「No」、Pro・Maxが「Yes」です(2026年10月2日確認)。Fable 5.1はAnthropic公式ヘルプ「Claude Fable models on your plan」(2026年10月2日確認)によると、Maxプランと、Team・席数制EnterpriseのPremium席では週次利用上限の50%まで追加費用なしで使え(総量は増えず他モデルと同じ枠を消費)、ProプランとTeamのStandard席では従量課金の利用クレジットのみ、Freeプランでは利用できません。Fable 5.1は7月に終了したFable 5のプロモーション枠の対象になったことはありません。
Q6. 両方を契約する意味はありますか?
A. あります。第一に用途の分担です(既定はOpus 5.5、Opus 5.5で評価に届かない長期エージェントや多段リサーチはFable 5.1)。第二に可用性リスクで、Fable 5には2026年6月に輸出管理措置で3週間の全世界停止があった実績があり、単一モデルへの依存はリスクになります。第三に、Fable 5.1の安全分類器が拒否応答を返したときに指定できるフォールバック先がClaude Opus 4.8とClaude Opus 5に限られているため(公式に明記・2026年10月2日確認)、Opus系を使える状態にしておくこと自体が運用上の前提になります。
Q7. 拒否応答が返ってきたときの課金はどうなりますか?
A. 拒否の区分で変わります。出力が始まる前に返ってきた拒否は、区分(stop_details.category)が bio・frontier_llm・reasoning_extraction なら課金され、cyber・general_harms と区分なしなら課金されません(2026年9月24日より前は、どれも課金されませんでした)。Fable 5.1では、フォールバッククレジットによってモデル切り替え時のプロンプトキャッシュのコストが返金されます。拒否はstop_reason: "refusal"とともにHTTP 200で返り、stop_detailsにどのポリシー領域が反応したかが入ります。エラーではなく正常応答として返る点に注意してください。Opus 5.5も同じ形で拒否を返します。
Q8. Sonnet 5.5との違いも知りたいのですが?
A. Sonnetの現行版は2026年9月28日公開のSonnet 5.5で、入力$2・出力$10。速度とコストのバランスを重視したモデルです。レイテンシの相対評価もFast(Opus 5.5はModerate、Fable 5.1はSlower)。SonnetとOpusの使い分けはClaude SonnetとOpus 5の違いで、Fable系とSonnetの組み合わせはFable 5とSonnet 5どっちを使う?使い分け基準で詳しく解説しています。
Q9. Claude Codeでの利用にはどちらが向いていますか?
A. 日常的な開発作業はOpus 5.5を標準にし、Opus 5.5のeffortを上げても評価に届かない大規模リファクタや移行だけFable 5.1へ上げる運用が費用対効果に優れます。Claude Code・claude.ai・Claude Managed Agents・Claude Agent SDKは、思考ブロックの前提となる履歴のプレフィックスを自動で保ってくれるため、Fable 5.1の破壊的変更3点目(過去ターン編集での無効化)を自前で気にする必要がない点も利点です。
Q10. GPT-5.6など他社モデルとの比較も必要ですか?
A. Artificial Analysis Intelligence IndexではGPT-5.6 Sol(maxモード)が59点で3位圏につけており、Opus 5・Fable 5とは僅差でした(2026年7月時点)。他社モデルとの3社比較はGPT-5.6 vs Fable 5/Opus 4.8比較で解説しているので、Anthropic以外の選択肢も検討する場合はあわせて参照してください。
参考・出典
- Claude Fable 5.1 – overview — Anthropic公式ドキュメント(参照日: 2026-10-02)
- What’s new in Claude Fable 5.1 — Anthropic公式ドキュメント(参照日: 2026-10-02)
- Migrating to Claude Fable 5.1 — Anthropic公式ドキュメント(参照日: 2026-10-02)
- Claude Fable 5.1 and Claude Mythos 5.1 — Anthropic公式ニュース(参照日: 2026-10-02)
- Model deprecations — Anthropic公式ドキュメント(参照日: 2026-10-02)
- Pricing – Claude Platform Docs — Anthropic公式ドキュメント(参照日: 2026-10-02)
- Refusals and fallback — Anthropic公式ドキュメント(参照日: 2026-10-02)
- Introducing Claude Opus 5 — Anthropic公式ニュース(参照日: 2026-07-25)
- What’s new in Claude Opus 5 — Anthropic公式ドキュメント(参照日: 2026-07-25)
- Models overview – Claude Platform Docs — Anthropic公式ドキュメント(参照日: 2026-10-02)
- Claude Opus 5.5 – overview — Anthropic公式ドキュメント(参照日: 2026-10-02)
- What’s new in Claude Opus 5.5 — Anthropic公式ドキュメント(参照日: 2026-10-02)
- Introducing Claude Opus 5.5 — Anthropic公式ニュース(参照日: 2026-10-02)
- Choosing the right model — Anthropic公式ドキュメント(参照日: 2026-10-02)
- Claude Opus 5 – Intelligence, Performance & Price Analysis — Artificial Analysis(参照日: 2026-07-25)
- Claude Fable 5 – Intelligence, Performance & Price Analysis — Artificial Analysis(参照日: 2026-07-25)
- Opus 5: Fable 5 level intelligence at a lower cost per task — Artificial Analysis(参照日: 2026-07-25)
- Claude Opus 5: the new leader in agentic knowledge work — Artificial Analysis(参照日: 2026-07-25)
まとめ:今日から始める3つのアクション
- 今日: 直近1か月のusage内訳を開き、
cache_read_input_tokensが入力全体の何%かを確認する。ここが大きいほどFable 5.1との倍率は2.5倍から縮みますが、Opus 5.5より安くはなりません。コストで選ぶならOpus 5.5です - 今週中: 「プロンプト1」でキャッシュ込みの総額試算を行い、自社のワークロードでFable 5.1がOpus 5.5の何倍になるかを小数第2位まで出す。あわせて「プロンプト4」で
tool_choiceの棚卸しをする(強制ツール使用はOpus 5.5でも非対応) - 今月中: Fable 5を使っているなら「プロンプト7」で3択を判定し、Aを選ぶなら移行後チェック5項目まで実施する。Cを選ぶ場合も、2027年6月9日以降という提供終了の目安を移行期限としてカレンダーに入れる。Opus 5を使っているなら、補足の確認4点を先に済ませる
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』(SBクリエイティブ)。
SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。
監修:株式会社Uravation(生成AI活用書籍シリーズ累計59,900部の著者チームが運営。自社7メディアの実運用でAI検索からの引用・流入を継続計測し、その知見に基づいて編集しています。仕様・料金が変わりやすい領域のため、重要な意思決定の前には各公式情報の最新版をご確認ください)
この記事の内容を社内展開する方へ: Claude Fable 5.1 法人導入・安全運用ガイド(無料・PDF 32ページ+Excel/Word) をダウンロードできます。