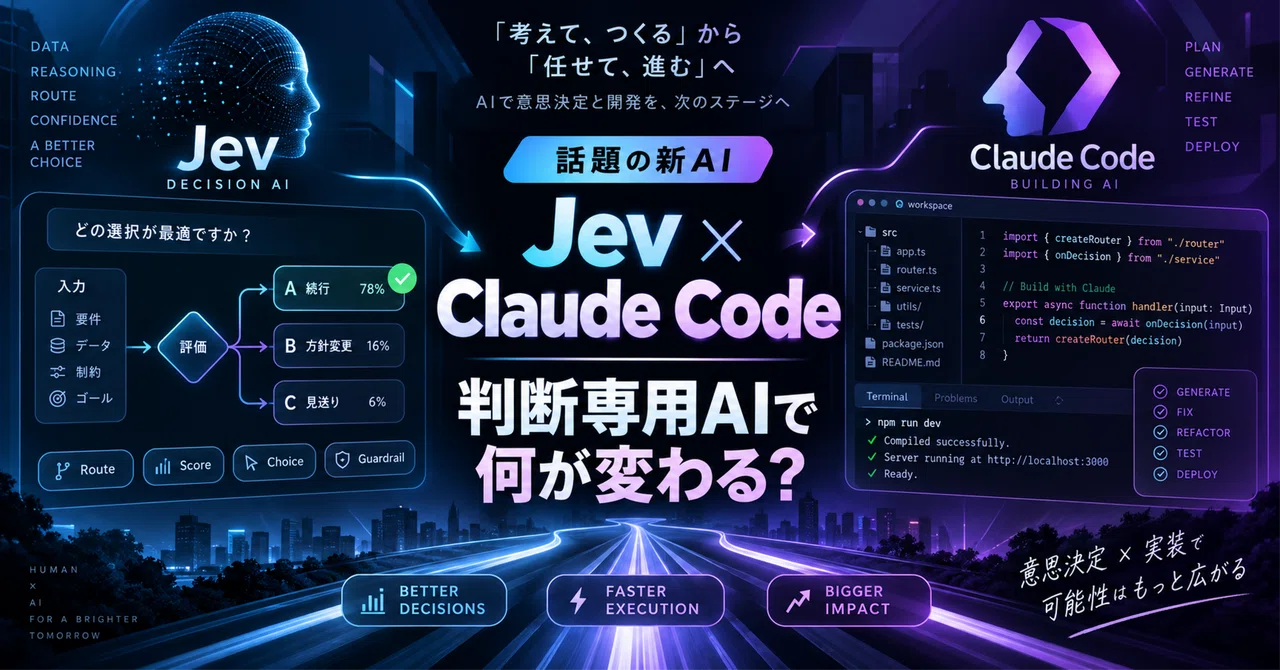
【Jev × Claude Code】判断専用AIを入れると何が変わる?「考えるAI」と「決めるAI」を分業させる方法

「Jev」というAIが、ここ数日で一気に話題になっています。
でも、最初に一つだけ整理しておきたいことがあります。
Jevは、ClaudeやChatGPTの代わりになるAIではありません。
文章を書かせるものでも、コードを書かせるものでも、長時間考えさせるものでもない。
むしろ逆です。
Jevが得意なのは、
「この条件なら、どちらを選ぶ?」
「これは危険か?」
「どの担当に回す?」
「続行する?止める?」
といった、小さな「判断」です。
そして調べれば調べるほど、
これ、Claude Codeと組み合わせるとかなり面白いのでは?
と思うようになりました。
今回は、2026年9月18日時点の公式情報と公開されている実装を調べながら、
JevをClaude Codeに組み合わせると何が変わるのか
を整理してみます。
そもそもJevとは?
JevはTypeSafe AIが公開した「System One Model」と呼ばれる新しいタイプのAIです。
普通のLLMは、
入力
↓
考える
↓
文章を生成する
↓
その文章をプログラム側で解釈する
という流れになっています。
Jevは違います。
入力された状態に対して、
Yes / No
複数候補から1つ選択
スコアリング
などの構造化された判断そのものを返します。
しかも、判断には確率やconfidenceが付く。
TypeSafeはこれを、
「unstructured state in, typed probabilistic decisions out」
という考え方で説明しています。Jevは文章生成を捨て、ソフトウェア内部で利用する判断に特化しています。
ここが非常に重要です。
Jevに、
「Pythonでアプリを作って」
と言っても意味がありません。
一方、
「この変更はレビューが必要か?」
「この問い合わせは営業・請求・技術のどこに送るべきか?」
「この検索結果は今の調査に必要か?」
のような質問は、まさにJev向けです。
Claude Codeと役割がまったく違う
Claude Codeはかなり賢いです。
コードベースを調べる。
設計する。
コードを書く。
テストする。
エラーを読んで修正する。
必要なら複数ステップで考える。
つまりClaude Codeは、
「考えて、作るAI」
です。
一方でJevは、
「決めるAI」
に近い。
この2つを同じ種類のAIとして比較するより、
Claude Code
考える・作る・調査する・修正する
Jev
分類する・判定する・選ぶ・評価する
通常のプログラム
絶対に守るルールを実行する
という3層に分けたほうが理解しやすいと思います。
TypeSafe自身も、Jevの用途として「classify」「route」「score」「verify」「guardrail」などを挙げています。
ではClaude CodeにJevを入れると何が変わるのか?
ここからが本題です。
たとえばClaude Codeに大きな開発を任せているとします。
Claude Codeは作業中、内部的には大量の小さな判断をしています。
「次にどのファイルを見る?」
「このエラーは重要?」
「この変更は危険?」
「追加調査する?」
「もう作業終了してよい?」
こうした判断すべてに、大きなLLMの推論を使う必要があるのでしょうか。
ここにJevを入れる余地があります。
① ツール実行前のチェック
例えばClaude Codeが、
ファイルを書き換える
シェルコマンドを実行する
外部ツールを呼ぶ
プロジェクト外へアクセスする
とします。
実行前にJevへ、
「この操作は今回の依頼と整合しているか?」
「レビューが必要な操作か?」
と判断させる。
そして、
高confidence → 続行
中confidence → Claudeに再確認
低confidence → 人間確認
のように分岐させる。
これはかなり面白い使い方です。
実際、コミュニティではすでにClaude Codeのツール呼び出し前後にJevを組み込む「jevwire」というプロジェクトが登場しています。
ツール実行前、取得結果の後、作業終了前などにJevの判断を挟む設計です。
まだ初期段階の実装なので、これ自体をセキュリティ境界として信用するべきではありません。
ただ、
「AIエージェントの行動の間に、小さな判断AIを大量配置する」
という方向性はかなり興味深いです。
② Claude Codeが読む情報を選別する
個人的に、かなり期待している用途がこれです。
Claude Codeで大きなプロジェクトを扱うと、
「必要な情報を探すために大量のファイルを読む」
という場面が増えます。
しかし、全部をClaudeのコンテキストへ入れていたら重くなる。
そこで検索結果やファイル候補をJevに渡して、
「今回の問題解決に関係する可能性が高いか?」
だけ判定させる。
関連度が高いものだけClaudeに渡す。
つまり、
100個候補
↓
Jevで選別
↓
本当に必要そうな10個
↓
Claude Codeが精読
という構造です。
これはJevの「判断は高速・安価」という特性と非常に相性が良いです。
TypeSafeの現在の価格は、入力100万トークンあたり**$0.042、出力は無料**。OpenRouterでもJev 1.13が同価格で提供され、32Kコンテキストとして掲載されています。
③ 「どのAIに仕事を渡すか」をJevに決めさせる
これもすでに実装が始まっています。
例えば、
簡単な修正 → 軽量モデル
難しい設計 → 高性能モデル
調査 → 検索担当
テスト → テスト担当
というように複数のモデルやAgentを使い分ける場合。
「どれに渡すか」を毎回高価なLLMに考えさせるのは少しもったいない。
そこでJevをルーターにする。
実際にClaude CodeやCodexのリクエストをJevで分類し、適切なモデルへ振り分けようとする「jev-router」のようなプロジェクトもすでに登場しています。
これは今後、
AIがAIを選ぶ
ための小さな判断層になる可能性があります。
④ コードレビューを常時走らせる
もう一つ興味深かった実例があります。
公開されている「Jev Realtime Code Check」では、コード保存時に多数のルールへ照らしてJevでチェックする仕組みが試されています。
公開記事では、370個のテキストルールを2秒以内で評価する使用例が報告されています。
ただし、毎回370個すべてを送るのではなく、変更したファイルに当てはまるルールだけを送る仕組みです(370個は11種類のファイル向けに用意したルールの合計)。
もちろんこれは第三者による特定環境での実測であり、すべての環境で同じ性能になるという意味ではありません。
それでも、
「PRを作ってからレビュー」
ではなく、
「コードを書いている最中ずっとAIレビュー」
という方向が現実的になってきたことは面白いです。
Claude Codeがコードを書く。
Jevが横で、
「このルールに違反していない?」
「変更リスクは高い?」
「テスト不足では?」
と高速判定する。
人間+Claude Code+Jev。
かなり新しい開発スタイルになりそうです。
そして、すでにClaude Code向け公式Skillまである
調べていて驚いたのですが、TypeSafe自身がすでにClaude Code向けAgent Skillを公開しています。
Claude Codeでは、
claude plugin marketplace add typesafe-ai/skills
続いて、
claude plugin install typesafe@typesafe-ai
で導入できます。
このSkillは、Claude CodeにTypeSafeの仕組みやJev向けのワークフロー設計を理解させるための公式Skillです。
つまり、
「いつかClaude Codeと連携できそう」
という段階ではありません。
すでにClaude Codeを使ってJevワークフローを作るための公式導線が存在します。
JevをClaude Codeから直接呼ぶMCPも出てきた
さらにコミュニティ側ではMCP化も始まっています。
例えば「jev-mcp」は、
claimの検証
コンテンツのscreening
候補のranking
などをJevへ渡すMCPサーバーです。
Claude Codeから登録する方法も公開されています。
別の「typesafe-mcp」では、
Claude Code
↓
MCP
↓
Jev
↓
typed JSON
というかなり分かりやすい構成になっています。
つまり現在すでに、
Claude Codeの横に「判断専用AI」を置く
こと自体は実験できる状態です。
「JevならClaudeの代わりになる」は間違い
ただし、ここはかなり重要です。
Jevの料金や速度だけを見ると、
「これClaudeより圧倒的に安いじゃん」
と思ってしまいます。
でも比較対象が違います。
Claude Codeに、
「このプロジェクトを調査して設計し直して」
と依頼できます。
Jevにはできません。
Jevは文章生成を捨てることで、構造化された判断へ特化しています。TypeSafe自身も、公開評価の最大193.6倍高速・444.6倍安価という数字について、実環境で得られる改善としては高い側の結果だと明記しています。
なので、
Claude vs Jev
ではなく、
Claude + Jev
で考えた方がよい。
「Zero Hallucinations」も誤解しない方がいい
TypeSafeはJevについて「Zero Hallucinations」というかなり強い言葉を使っています。
ただ、これは、
Jevが絶対に間違った判断をしない
という意味ではありません。
事前に定義された型の外へ飛び出した回答を生成しない、という部分が重要です。
TypeSafe自身も、Jevについて「No type errors」は保証できる一方、より大胆な性能主張については評価条件やバイアスの可能性まで説明しています。
例えば、
候補が
A:営業
B:請求
C:技術
しかなければ、
突然、
「D:宇宙開発部」
と生成するようなことは防げる。
しかし、
本当はBなのにAを選ぶ
可能性までゼロになるわけではありません。
ここはかなり重要な違いです。
Jevの本当の価値は「賢いAI」ではないかもしれない
今回かなり調べてみて、個人的に一番面白いと思ったのはここです。
AIの進化というと、
「もっと大きいモデル」
「もっと賢いモデル」
「もっと長く考えるモデル」
ばかり注目されます。
Jevは逆方向です。
大きなAIに考えさせなくてもいい判断を切り離す。
Claude Codeにすべて考えさせるのではなく、
Claudeにしかできない仕事だけClaudeに渡す。
高速な判断はJev。
絶対ルールは普通のコード。
人間が決めるべきことは人間。
この分業が成立すると、
AIエージェントの作り方そのものが変わる可能性があります。
ZEN AI LABでも実際に検証してみる
ここまで調べると、やはり実測したくなります。
なので次は、
Jevに同じ種類の判断を100回させてみます。
確認したいのは単純な速度だけではありません。
日本語でも安定するのか
同じ質問で判断がブレるのか
confidenceは信用できるのか
質問を分解すると精度は変わるのか
Claudeに判断させる場合と何が違うのか
実際のAPI料金はいくらになるのか
ここまで測ります。
Jevはまだ登場したばかりです。
だからこそ、
「すごいらしい」
で終わらせず、
実際に使えるのかを検証していきます。
次回、
「Jevに100回判断させたらどうなる?日本語で独自ベンチマーク」
をやります。
Jev研究室のほかの記事
Claude Codeが自分でモデルを選ぶ時代へ。JevでHaiku・Sonnet・Opusを自動振り分けする仕組みが出てきた
JevはClaude Codeの「安全装置」になれる?危険コマンドとPrompt Injectionを止める実装が始まった
※本記事は2026年9月18日時点のTypeSafe公式情報、Vercel AI Gateway、OpenRouter、TypeSafe公式GitHubおよび公開されているコミュニティ実装をもとに整理しています。Jevはリリース直後のため、モデル・料金・仕様・連携方法が短期間で変更される可能性があります。
参考にした公開情報
