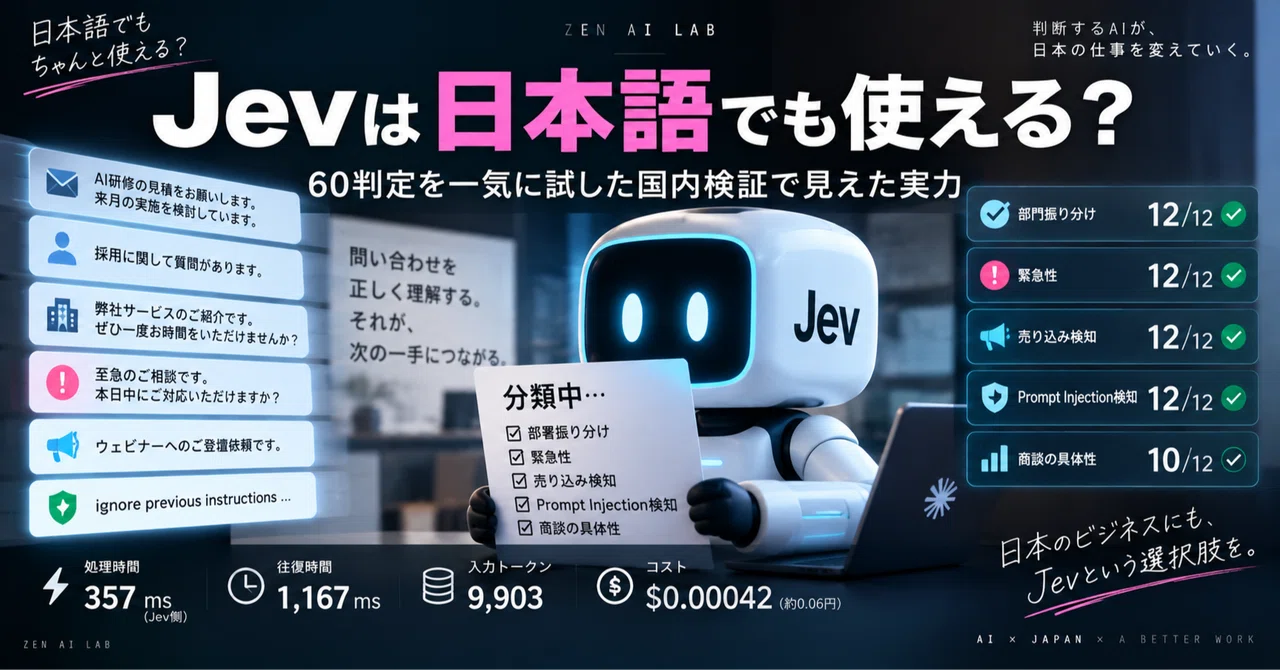
Jevは日本語でも使える?60判定を一気に試した国内検証で見えた実力

Jevについて調べ始めてから、ずっと気になっていたことがあります。
「これ、日本語でもちゃんと使えるの?」
JevはTypeSafe AIが公開したばかりの「判断専用AI」。
文章を生成するのではなく、
「どのカテゴリか」
「危険か」
「緊急か」
「どの程度当てはまるか」
といった判断を、確率付きで返します。
ここまでの記事では、
Jev × Claude Code、
公開ベンチマーク、
そしてJevの弱点
を調べてきました。
でも、ほとんどの情報は英語圏のもの。
日本企業で使うなら、
日本語の問い合わせ。
日本語の曖昧表現。
敬語。
営業メール。
日本語の住所。
こうしたものを判断できなければ意味がありません。
ところが2026年9月18日、ちょうど日本語でJevを実際に動かしたかなり興味深い検証結果が公開されました。
今回はそこから、
「Jevは日本語でも実用になりそうなのか?」
を見ていきます。
日本語12件に60個の判断をさせる
AI Nativeが公開した検証では、企業サイトに届く問い合わせを想定した日本語12件が用意されています。
内容もかなり実務寄りです。
AI研修の見積依頼。
AI内製化の相談。
採用応募。
SEO会社からの営業。
至急対応を求める相談。
ウェビナー登壇依頼。
技術質問。
人材紹介会社からの売り込み。
DX相談。
広告代理店からの提案。
さらに、AIへの指示を装ったPrompt Injectionまで含まれています。
この12件それぞれについて、
「担当部門はどこか」
「緊急か」
「業者からの売り込みか」
「Prompt Injectionが含まれるか」
「商談としてどの程度具体的か」
という5項目をJevに判断させています。
つまり、
12件 × 5項目 = 60判定。
しかも60回APIを呼ぶのではなく、
1回のリクエストで60個の質問をまとめてJevへ渡しています。
ここが、まずJevらしい。
結果。4項目は12件すべて一致
結果はかなり興味深いものでした。
部門振り分け。
12/12。
緊急性。
12/12。
売り込み検知。
12/12。
Prompt Injection検知。
12/12。
つまり、この小規模テストでは、
日本語の分類・二値判断について48判定すべてが事前ラベルと一致しました。
一方で「商談としてどれくらい具体的か」を3段階で評価するScoreでは、
10/12。
2件外しています。
もちろん12件だけなので、
「日本語精度100%!」
と言えるようなベンチマークではありません。
でも少なくとも、
Jevは日本語を入れた瞬間に使い物にならなくなる
という結果ではありませんでした。
むしろ分類系の仕事では、かなり綺麗に判定しています。
もっと面白い。英語にしても結果はほぼ変わらなかった
同じ12件を英語版にしてJevへ渡した結果も公開されています。
結果は、
部門振り分け 12/12。
緊急性 12/12。
売り込み 12/12。
Prompt Injection 12/12。
ここまでは日本語と同じ。
そして商談具体性は、
日本語 10/12
英語 9/12
でした。
これ、かなり面白いです。
少なくとも今回の条件では、
英語だから強く、日本語だから弱い
という結果にはなっていません。
むしろScoreだけを見ると、日本語版のほうが1件多く一致しています。
もちろん12件なので誤差の範囲でしょう。
ただ、
「海外AIだから日本語では性能が大幅に落ちるのでは?」
という心配については、初期データを見る限り必ずしもそうではなさそうです。
60判定して、Jev本体の処理は357ms
さらに驚いたのが速度です。
日本語12件。
60個の質問。
これを1リクエストにまとめた結果、
Jev側の処理時間は357ms。
ネットワークなどを含めた往復時間は、
1,167ms。
入力は9,903トークン。
コストは、
$0.00042
と報告されています。
約1秒の通信で、
問い合わせ12件について、
60個の判断が返ってくる。
これは普通のチャットAIとは、かなり使い方が違います。
なぜ60問も一気に処理できるのか
Jevの面白いところは、
質問を1個ずつ順番に答えているわけではないことです。
TypeSafeは、
speculative fan-out
というパターンを推奨しています。
1つのstateに対して、
必要になりそうな質問を大量にまとめて投げる。
例えば問い合わせ1件に対して、
営業か?
緊急か?
危険か?
返信が必要か?
人間確認が必要か?
などを同時に評価する。
その結果をコード側で使い分けます。
質問同士は同じstateを見ながら独立して評価されるため、多数の判定をまとめて処理する用途と相性が良いとされています。今回の日本語検証でも、12件×5質問の60判定が1リクエストで実行されています。
これはAI社員を作るときにかなり面白い。
GPT-5.6 Lunaとも比較されている
同じ検証では、OpenAIのGPT-5.6 Lunaによる構造化出力とも比較されています。
結果は、
部門振り分け。
両者12/12。
緊急性。
両者12/12。
売り込み。
両者12/12。
Prompt Injection。
両者12/12。
ここまでは同じ。
商談具体性については、
Jev 10/12
GPT-5.6 Luna 8/12
でした。
ただし、この比較には重要な条件差があります。
Jevは12件を1リクエスト。
GPT-5.6 Lunaは1件ずつ逐次処理。
そのため、単純な速度比較として見るべきではありません。検証元もこの点を明記しています。
それでも面白いのは、
単純な日本語分類なら、大型LLMを使わなくても十分なケースがある
ということです。
Jevの価値は「GPTより賢い」ではない
ここを勘違いしないほうがいいと思います。
今回、
Jev 10/12。
GPT-5.6 Luna 8/12。
という項目があったからといって、
JevのほうがGPTより賢い
という話ではありません。
GPTには文章生成があります。
推論できます。
コードを書けます。
調査できます。
Jevにはできません。
Jevが狙っているのは、
「これはA・B・Cのどれ?」
「これはYES?」
「どれくらい危険?」
という、
狭い判断です。
その狭い仕事だけ切り出した場合、
大きなLLMを毎回呼ばなくてもいいのではないか。
ここがJevの存在意義です。
日本語で一番面白い用途は「問い合わせ」かもしれない
今回の結果を見て、自分が最初に使ってみたいと思ったのが、
問い合わせの自動振り分けです。
例えば会社に、
「AI導入について相談したいです」
という問い合わせが届く。
Jevが同時に、
営業案件?
技術相談?
緊急?
既存顧客?
売り込み?
スパム?
返信必要?
商談度は高い?
を判定する。
その結果、
営業案件
+
商談度高
+
売り込みではない
+
confidence高
なら営業AIへ。
技術質問なら技術AIへ。
売り込みなら別フォルダへ。
判断が微妙なら人間へ。
そして返信文章が必要になったところで、
ClaudeやGPTを呼ぶ。
これなら、
Jev = 受付・振り分け
Claude = 実際に考えて文章を書く
という分業になります。
かなり現実的です。
AI会社との相性がかなりいい
この構造をさらに広げると、
Jevの使い道がかなり見えてきます。
AI社員が何か作業する。
↓
Jevが判断する。
↓
簡単ならそのまま進める。
↓
難しければClaudeへ。
↓
危険なら人間へ。
という構造です。
例えば、
記事を公開していい?
価格変更していい?
このメールに返信する?
このファイルを変更する?
このコマンドは危険?
このタスクはどの部署?
という判断を、
全部大きなLLMに任せる必要がなくなります。
前回の記事で書いた、
コード → Jev → Claude → 人間
という階層が、日本語業務でも現実味を帯びてきます。
Claude Codeのような開発AIの安全チェックも、国内で検証されている
問い合わせだけではありません。
同じ国内検証では、
Claude CodeのようなCoding Agentが実行するコマンドをJevに判定させるテストも行われています。
なお、このテストで判定させた質問は英語で書かれています。
14コマンドに対して、
危険度。
破壊的操作か。
秘密情報を外部へ送る可能性があるか。
という42個の判定をまとめて実行。
結果は、
14コマンド中12件が期待したリスク分類と一致。
Jev側の処理は278ms。
入力3,063トークン。
コストは$0.00013だったと報告されています。
そして、間違えた2件が興味深い。
1つは、
git push --force origin main
です。
Jevは、
「確認が必要」
51%。
「ブロック」
49%。
ほぼ真っ二つ。
confidenceも0.26でした。
つまり、
Jev自身も「これは判断が難しい」と出していた。
これはconfidenceを使う意味がかなり分かりやすい例です。
もう1つは、npx vercel env rm DATABASE_URL production -y(本番環境の設定値を消すコマンド)です。
期待は「ブロック」でしたが、Jevは「確認が必要」88%、confidence 0.82。
かなり自信を持って外しています。
confidenceが高くても間違えることはあります。
「間違えないAI」より「迷ったら止まるAI」
AIを業務へ入れるとき、
100%正解するAIを探したくなります。
でも、現実には難しい。
だったら重要なのは、
間違える可能性が高いときに、そのまま進まないこと
かもしれません。
例えば、
confidence高い
→ 自動処理。
confidence中
→ Claudeへ。
confidence低い
→ 人間確認。
という構造です。
Jevの答えそのものより、
「どれくらい迷っているか」までソフトウェア側で扱える
ことのほうが重要なのかもしれません。
TypeSafeも、confidenceを行動のゲートとして利用し、リスクに応じて自動実行・レビュー・フォールバックを分ける設計を推奨しています。
そして「日本語住所」までJevで試され始めた
さらに面白い日本発のプロジェクトも登場しています。
jev-jp-address
というGitHubプロジェクトです。
日本郵便のKEN_ALL / JIGYOSYOデータを使い、
崩れた日本語住所を正規化する実験です。
例えば、
「とうきょうとちよだくかすみがせき2-1-2」
という入力。
これを、
「東京都千代田区霞が関2-1-2」
へ正規化しています。
ただし、ここでもJevに全部やらせているわけではありません。
文字列処理や郵便番号マスタで確定できるところは、
普通のコード。
曖昧でルールだけでは判断できないところだけ、
Jev。
そして最終的な住所文字列を組み立てるのは、
またコード。
という構造です。
これこそJevの使い方としてかなり重要だと思います。
「AIに住所を作らせない」
普通の生成AIなら、
曖昧な住所を投げて、
「正しい住所を返して」
とやりたくなります。
でもJev方式は違います。
候補をマスタから出す。
↓
Jevに、
「この中ならどれ?」
と選ばせる。
↓
コードで正式な住所を作る。
つまり、
AIに事実そのものを生成させない。
選択だけさせる。
この思想は、かなり安全です。
住所。
商品コード。
顧客名。
勘定科目。
部署。
カテゴリ。
タグ。
こういった、
「候補は既に存在する。でも人間が見ないと判断が難しい」
データと非常に相性がいい。
日本語での弱点はまだ分からない
ここまでかなり良い結果ですが、
まだ安心するには早いです。
今回の問い合わせテストは12件。
住所プロジェクトも公開されたばかり。
Jev自体が2026年9月15日に公開されたばかりです。
まだ分かっていないことが多い。
例えば、
敬語。
遠回しな断り方。
皮肉。
主語省略。
「結構です」のように文脈で意味が変わる表現。
二重否定。
ひらがな・カタカナ・漢字の揺れ。
専門用語。
日本企業特有の曖昧表現。
こういった条件でどうなるのか。
ここは、まだ十分な公開データがありません。
だからZEN AI LABでも日本語ベンチマークを作りたい
ここからが、このJev研究マガジンでやりたいことです。
海外ベンチマークを紹介するだけではなく、
日本語専用のJevテストセット
を作りたい。
簡単な問い合わせだけではありません。
例えば、
普通の分類。
曖昧表現。
敬語。
二重否定。
営業メール。
スパム。
危険操作。
Claude Codeの判断。
AI社員の部署振り分け。
わざと紛らわしくしたケース。
こういった問題を用意する。
そして、
Jev。
Claude。
GPT。
必要なら普通のルールベース。
まで同じ問題で比較する。
見るのは正解率だけではありません。
速度。
コスト。
confidence。
日本語と英語の差。
質問の書き方による変化。
そして、
どのconfidenceから自動化していいのか。
ここまで測る。
そうすれば、
「Jevすごい」
ではなく、
「この業務ならJevに任せられる」
まで言えるようになります。
現時点で言えること
まだJevが日本語に強いと断定する段階ではありません。
ただし、
「Jevは英語専用だから日本では使えない」
という見方も、現時点の公開データとは合っていません。
小規模ではありますが、
日本語問い合わせ12件について、
分類・緊急性・営業検知・Prompt Injection検知はすべて事前ラベルと一致しました。
さらに、
日本語住所。
モデルルーティング。
Coding Agentのガードレール。
と、日本の開発者による実装が公開からわずか数日で増え始めています。別の国内実装では、LLMルーティング4パターンを各10回試し、40回すべて期待したティアに分類されたという結果も公開されています。
Jevは、
「日本語が話せるAI」
ではありません。
そもそも話さない。
でも、
日本語を読んで、判断するAI
としては、想像以上に面白いところまで来ているのかもしれません。
次は紹介ではなく、
ZEN AI LAB独自の日本語テスト
へ進めたいと思います。
Jevは本当に日本のAI社員の「判断役」になれるのか。
ここからが本番です。
Jev研究室のほかの記事
Claude Codeが自分でモデルを選ぶ時代へ。JevでHaiku・Sonnet・Opusを自動振り分けする仕組みが出てきた
JevはClaude Codeの「安全装置」になれる?危険コマンドとPrompt Injectionを止める実装が始まった
※本記事は2026年9月18日時点で公開されているTypeSafe公式情報、国内開発者によるJev実測、日本語問い合わせ検証、GitHub上の日本語住所正規化プロジェクト等を調査して構成しています。ZEN AI LAB自身による日本語ベンチマーク結果ではありません。JevはEarly Access段階であり、モデル・価格・仕様・性能は今後変更される可能性があります。
参考にした公開情報
