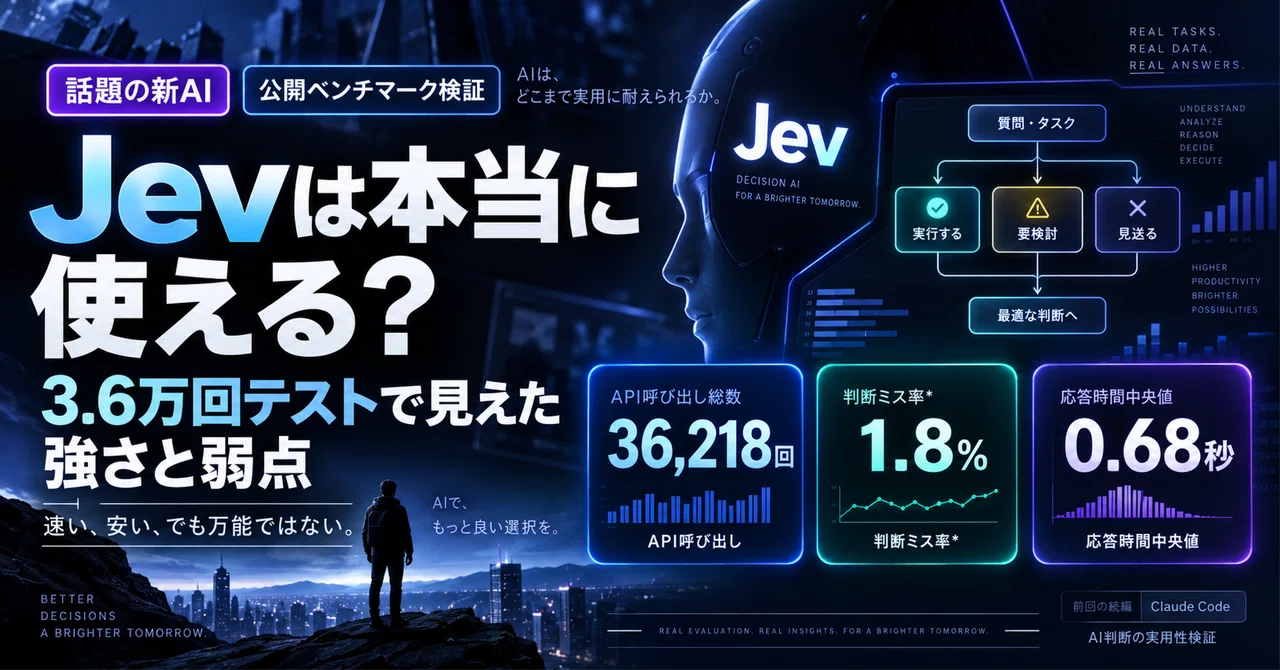
Jevは本当に使える?第三者の3.6万回テストで見えた「強さ」と意外な弱点

Jevについて調べ始めたとき、
「速い」
「安い」
「文章を書かず、判断だけするAI」
という特徴にかなり驚きました。
でも、一番知りたいのはそこではありません。
結局、本番環境で使えるのか?
です。
前回は、JevをClaude Codeと組み合わせる可能性について整理しました。
今回はさらに一歩進めます。
Jevの公開から数日しか経っていませんが、すでに第三者によるかなり大規模なテスト結果が出始めています。
その中でも特に興味深かったのが、
36,218回のJev呼び出し
を行った検証です。
結果を見ていくと、
「Jevめちゃくちゃ強いじゃん」
と思う部分と、
「ここを勘違いすると危ない」
という部分が、かなりはっきり分かれてきました。
19,118件の「実際のAI作業」をJevに判定させた
Nexus Agentチームが2026年9月17日に公開した検証では、実際のAIエージェント運用から集めた19,118件の場面が使用されています。
ユーザーのメッセージ。
ツール実行。
AIの回答。
タスク状態の変更。
こうした実際のエージェント作業を材料に、合計36,218回Jevを呼び出しています。
単なる10問、100問レベルのデモではありません。
公開直後のJevについて、現時点ではかなり興味深い第三者のデータです。
そして、この結果が面白い。
「判断したとき」のミス率は1.8%
テストでは、469件の同じケースに対して、
固定ルール、
Claude Haiku 4.5、
Claude Sonnet 5、
Jev
を比較しています。
Jevは274件について自分で判断し、そのうち間違えたのは5件。
つまり、Jevが「ここは自分で判断できる」としたケースでは、報告上のミス率は**1.8%**でした。
同じ検証では、
Haiku 4.5が13.7%、
Sonnet 5が7.0%
だったと報告されています。
この比較には条件があります。
Nexus の報告によると、Haiku と Sonnet にも「確信があるときだけ答える」よう指示していました。
誤りは Jev 5件、Sonnet 5 が22件、Haiku 4.5 が47件。
誤り率から逆算すると、Sonnet は約314件、Haiku は約343件に答えていて、Jev(274件)より多く判断しています。
答えた件数が違うので、誤り率だけでは優劣を決められません。
ただし、ここだけ切り取って、
「JevはClaudeより賢い」
と考えるのは危険です。
なぜなら、今回の結果にはJevのかなり重要な特徴が隠れているからです。
Jevは「分からない」ときに判断しない
Jevは469件すべてを自動判断したわけではありません。
自分で判断したのは274件。
カバー率は58%です。
残り42%については、confidenceが設定された基準に届かなかったため、既存ルールへ判断を戻しています。
これが、Jevを理解するうえでかなり重要です。
Jevの強みは、
「全部正解できる」
ことではありません。
むしろ、
「自信があるところだけ自動化する」
という設計にあります。
例えば、
95%以上 → 自動実行
80〜95% → 別AIで再確認
80%未満 → 人間確認
というような仕組みを作れる。
もちろん、この数値自体は用途ごとに検証して決める必要があります。
でも考え方としては非常に重要です。
AIに、
「絶対に答えろ」
と要求するのではなく、
「分からないものは上に回せ」
とできるわけです。
実はこの仕組み、AI会社とかなり相性がいい
例えばAI社員に問い合わせ処理をさせるとします。
問い合わせが来た。
Jevが最初に判断する。
「営業?」
「技術?」
「請求?」
「緊急?」
「人間確認が必要?」
confidenceが十分なら、そのまま担当AIへ回す。
微妙ならClaudeへ渡す。
さらに重要な案件なら人間へ渡す。
つまり、
Jev
↓
Claude
↓
人間
という判断の階層が作れます。
すべてを最初から大きなAIへ投げなくていい。
ここが個人的にはJevの一番面白いところだと思っています。
しかも速い
36,218回のAPI呼び出しでは、Jevの応答時間中央値は0.68秒。
95%が1.79秒以内だったと報告されています。
一方、同じ検証におけるClaude Haiku 4.5は約6.0秒、Sonnet 5は約6.3秒でした。
TypeSafe自身はJevについて70〜500msという数字を出していますが、Nexus Agentの実測はそれより遅い。
これはむしろ興味深いところです。
TypeSafeのテスト環境だけではなく、
実際にインターネット越しで、長めのコンテキストを渡したらどうなるか
という数字が見え始めたからです。
それでも0.68秒。
AIエージェントの1操作ごとに判断を挟む用途なら、十分面白い速度です。
コスト差はさらに大きい
同じ比較では、1回答あたりのコストが、
Jev:約$0.00008
Haiku 4.5:約$0.0065
Sonnet 5:約$0.0178
と報告されています。
今回の条件では、JevはHaikuより約79倍、Sonnetより約214倍安かったという結果です。
TypeSafe公式価格も現在、
入力100万トークン $0.042
出力トークンについては課金しない料金体系です。
ここまで安くなると、使い方が変わります。
「重要なところだけAIを使う」
ではなく、
「ほぼ全部の処理の途中にAI判断を置く」
ことが現実的になってくる。
これこそJevが狙っている世界だと思います。
別の第三者検証でも777判断が0.7秒未満
EveryのHead of EvalsであるMike Taylor氏もJevをテストしています。
自分の記事27本とAI風に作った文章10本。
合計37文書に対して21項目を判定。
つまり、
37 × 21 = 777判断
です。
これをJevにまとめて処理させたところ、0.7秒未満だったと報告されています。
推定コストは約0.25セント。
さらに別の小規模テストでは、文章に意図的に仕込んだ7個の問題のうち、
Jevは6個、
Claude Fable 5.1は7個
を検出しました。
中央値の応答時間は、
Jev 0.35秒、
Fable 8.83秒。
つまりここでも、
精度では大型モデルに少し負ける一方、速度とコストでは大差
というJevらしい結果になっています。
ここで重要。「Jevに全部やらせる」は違う
ここまで読むと、
「じゃあ全部Jevに置き換えればいいじゃん」
と思うかもしれません。
でもTypeSafe自身の設計を見ると、むしろ逆です。
公式の「Invoice Processing」というワークフローがあります。
請求書を読ませて、
支払う、
保留する、
承認へ回す、
訂正を要求する、
不正確認へ回す、
などを判断するシステムです。
ここで非常に面白いことをしています。
合計金額、日付、口座番号、ステータスなどはJevに判断させず、コードで計算しています。
つまりTypeSafe自身も、
何でもAIにやらせているわけではない。
計算できるもの → コード
曖昧な意味判断 → Jev
複雑な生成・推論 → LLM
という分業をしています。
これはかなり重要です。
「AIが賢いか」ではなく「仕事をどう分解するか」
Jevを見ていると、今後のAI開発で重要になるものが少し変わってくる気がします。
これまでは、
「どのモデルが一番賢い?」
という比較が中心でした。
GPTか。
Claudeか。
Geminiか。
しかしJevが提示しているのは、
そもそも全部を1モデルにやらせる必要ある?
という考え方です。
文章を書くならLLM。
コードを書くならCoding Agent。
判断ならJev。
計算なら普通のコード。
検索なら検索システム。
そして必要なところだけ人間。
このほうが速く、安く、制御しやすい。
Jev自体が革命なのかどうかは、まだ分かりません。
公開されて数日です。
ただし、
「AIに全部考えさせる」から「AIを仕事ごとに分業させる」へ
という方向は、かなり面白いと思っています。
「Zero Hallucinations」には注意が必要
Jevについて特に誤解されそうなのが、
Zero Hallucinations
という表現です。
TypeSafeはJevについて、型として許可されていない回答を返さないことを強調しています。
これは強力です。
例えば選択肢が、
営業
請求
技術
の3種類なら、
Jevが突然、
「マーケティング部」
という存在しない4つ目を生成することはありません。
TypeSafeはこの「type errorがない」という点について、経験的な成功率ではなく構造上の保証だと説明しています。
しかし、
営業を請求と間違える
ことはあります。
つまり、
「存在しない答えを生成しない」
と
「答えを間違えない」
は別です。
ここを一緒にすると危険です。
Jev最大の武器は「confidence」かもしれない
調べる前は、Jev最大の魅力は速度だと思っていました。
でも今は少し考えが変わっています。
一番重要なのは、
確信度を前提にシステムを設計できること
なのかもしれません。
普通の生成AIは、自信満々に間違えることがあります。
Jevの思想は違う。
100%自動化をいきなり狙わない。
簡単な70%をJev。
難しい20%を大型AI。
本当に危険な10%を人間。
例えばこんな構造が作れる。
そしてJevの精度が上がれば、
人間が担当していた範囲が少しずつ下へ移る。
これならAIを業務へ入れるときも現実的です。
TypeSafe公式サイトも、confidence thresholdを設定し、自律実行とレビューへのエスカレーションを分ける設計を前面に出しています。
ただし、まだ「勝ち確モデル」ではない
ここは冷静に見たいところです。
TypeSafe自身も、公式ベンチマークの193.6倍高速・444.6倍安価という結果について、
実世界で期待される改善幅の高い側
だと明記しています。
また、公式評価では「正解」を完全な人間ラベルだけで作っているわけではなく、大型モデルの回答を参照値として使用するものもあります。
TypeSafe自身がその評価方法やバイアスの可能性をかなり詳しく公開しています。
公開数日後の現在、Jevについて分かっているのは、
速度と価格はかなり強そう。
特定の判断タスクでも面白い結果が出始めている。
でも、
どんな判断でも大型LLM並みにできると証明されたわけではない。
という段階だと思います。
それでもJevを追う理由
では、なぜここまでJevを追っているのか。
理由は単純です。
Jevそのものより、
Jevが示しているAIシステムの作り方
が面白いからです。
巨大なAIを1体置く。
全部そいつに考えさせる。
ではなく、
考えるAI。
作るAI。
判断するAI。
検索するAI。
そしてコード。
それぞれを組み合わせる。
AIエージェントが普及するほど、
この「AIを管理するためのAI」は重要になる可能性があります。
Jevは、その判断層を取りに来ているように見えます。
次は日本語で実際に試したい
海外の検証データはかなり増えてきました。
ただ、まだ足りないものがあります。
日本語です。
英語で高精度でも、
日本語のニュアンス、
敬語、
曖昧な表現、
二重否定、
問い合わせ分類、
危険操作判定
で同じ性能になるとは限りません。
そこで次は、
Jevを日本語で実際に検証できるテストセット
を作ってみたいと思います。
単に100問投げるだけではなく、
簡単な判断。
曖昧な判断。
意地悪な判断。
業務判断。
Claude Code関連の判断。
まで分ける。
Jevは本当に、
「AI社員の判断役」
になれるのか。
ここからは自分たちでも確かめていきます。
Jev研究室のほかの記事
Claude Codeが自分でモデルを選ぶ時代へ。JevでHaiku・Sonnet・Opusを自動振り分けする仕組みが出てきた
JevはClaude Codeの「安全装置」になれる?危険コマンドとPrompt Injectionを止める実装が始まった
※本記事は2026年9月18日時点のTypeSafe公式情報、公式Workflow Evals、Every、Nexus Agentなどの公開情報を調査して構成しています。Jevは公開直後のモデルであり、仕様・料金・性能は今後変更される可能性があります。Nexus の数字は同社の LinkedIn での公開報告によるもので、投稿本文と元データは確認できていません。
参考にした公開情報
