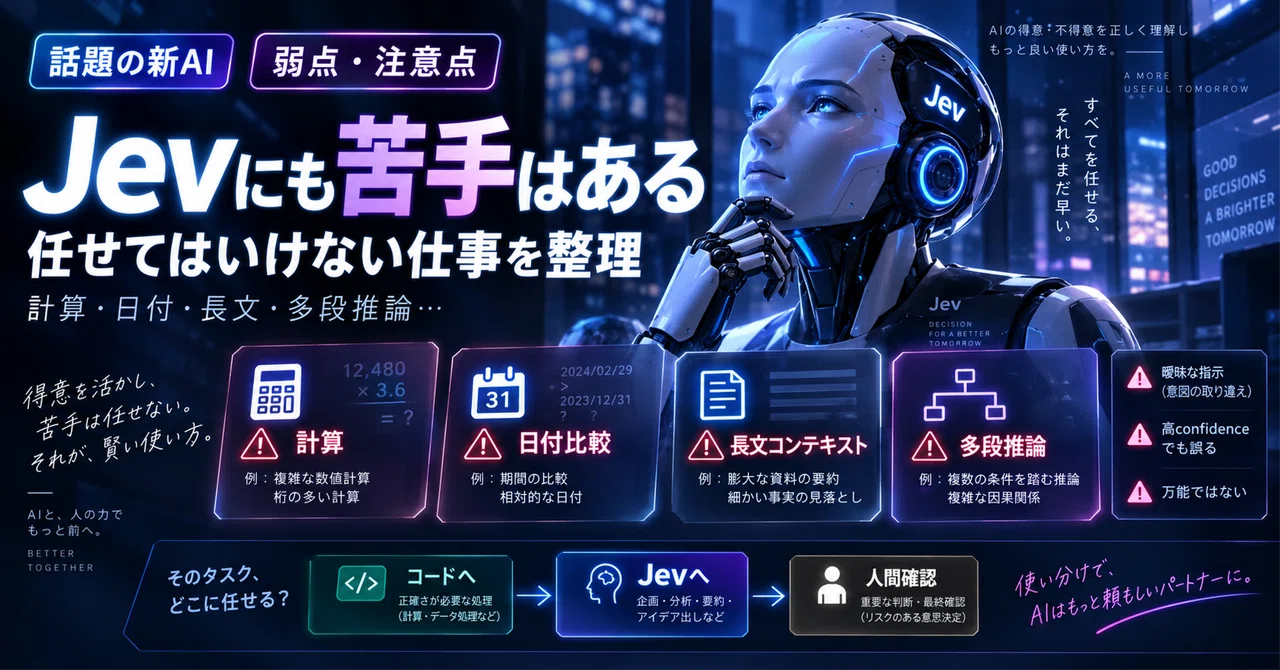
Jevにも苦手はある。「任せてはいけない仕事」を公式情報から調べた

Jevの記事をここまで2本書いてきました。
1本目では、Claude CodeとJevを組み合わせる可能性。
2本目では、公開されている大規模テストから、Jevの速度・コスト・判断性能を見てきました。
ここまで読むと、
「Jev、かなり使えるんじゃない?」
と思うはずです。
自分もそう思っています。
ただ、Jevを本当に業務で使うなら、性能より先に知っておいたほうがいい情報があります。
それが、
Jevは何が苦手なのか。
です。
調べてみると、TypeSafeは現行Jev 1.13について「jaggedness」と呼ぶ既知の弱点をかなり具体的に公開しています。
そして内容を見ると、
「ここを知らずにAI社員へ入れたら危ない」
と思うものがいくつもありました。
今回はJevを褒める記事ではありません。
Jevに何を任せてはいけないのか。
そこを整理します。
Jevは「万能AI」ではない
まず前提から。
JevはChatGPTやClaudeの小型版ではありません。
TypeSafeはJevを、文章を生成するLLMではなく、
「ソフトウェア内部で構造化された判断を返すモデル」
として設計しています。
入力された状態に対して、Choice、Score、Noulなどの形式で、選択や確率を返します。TypeSafeは「typed probabilistic decisions」と表現しています。
だからJevが得意なのは、
「これは営業問い合わせか?」
「このコンテンツはレビューが必要か?」
「A・B・Cならどれ?」
といった判断です。
反対に、
人間なら普通にできることでも、Jevには任せないほうがいい処理があります。
ここが非常に面白い。
まず驚いた。Jevは計算が苦手
これはかなり重要です。
Jevは、
計算機として使わないほうがいい。
PydanticのTypeSafe/Jevドキュメントでも、Jev 1.13は算術・数え上げ・日付を苦手とすることが明記されています。
例えば、
「この請求書の合計金額は100万円を超えている?」
という判断。
一見Jev向きに見えます。
でも、
10万円
+25万円
+34万円
+42万円
をJev自身に計算させたうえで判断させるのは、良い設計ではありません。
正解は、
コードで合計
↓
合計111万円
↓
Jevへ
「この金額と取引内容から追加レビューが必要か?」
です。
つまり、
数字を作る仕事はコード。
数字の意味を判断する仕事はJev。
この分業になります。
「数える」のもコードに任せたほうがいい
計算と似ていますが、
数え上げも注意が必要です。
「この文章にNGワードはいくつ入っている?」
「このリストに対象商品はいくつある?」
「エラーは全部で何件?」
こういった処理です。
Jevに、
「全部読んで、何個ある?」
と聞くより、
一件ずつJevに、
「これは対象か?」
と判断させ、
最後にコードで件数を合計する。
このほうがJevの思想に合っています。
TypeSafe自身も、信頼性の高いワークフローは多数の独立した小さな質問に分解し、その確率をコード側で組み合わせる構造になると説明しています。
ここはJevを使ううえで非常に重要な考え方だと思います。
日付の比較も危ない
個人的に業務用途で一番怖いのがこれです。
Jev 1.13は、
日付を「順序を持った数値」ではなく、テキストとして扱う傾向があります。
そのため、
「2026年10月1日は2026年9月30日より後か?」
「契約終了日を過ぎているか?」
「申込日から30日以上経過したか?」
「第3四半期に入っているか?」
といった処理を、そのままJevだけに任せるのは向いていません。
ここも、
日付 → プログラムで変換
差分 → コードで計算
Jev → その結果を使って意味判断
にしたほうがいい。
AIだから何でもAIに渡すのではなく、
確実に計算できるものは普通のプログラムへ戻す。
実はこれがJevをうまく使うコツなのかもしれません。
Jevはかなり「文字どおり」に読む
これも面白い特徴です。
Jevは、
「あなたが言いたかったこと」ではなく「あなたが書いたこと」
をかなり忠実に判断します。
人間なら、
「まあこの文脈なら、こういう意味だよね」
と補完してくれるところでも、
Jevはそうとは限りません。
つまり、曖昧な質問が危ない。
例えば、
「怪しい問い合わせですか?」
では判断基準が分かりません。
怪しいとは、
詐欺?
スパム?
暴言?
個人情報?
営業?
どこまで含むのか。
そこで、
「送信者が金銭・認証情報・パスワード・外部サイトへの誘導を要求しているか?」
のように、
判断条件そのものを明確にする必要があります。
Jevではプロンプトを書くというより、
判定ルールを書く感覚
に近いです。現行モデルについても、公式の弱点をまとめた資料では「書いた質問に答え、意図した質問には答えない」という性質が注意点として整理されています。
これは逆に言えば、
質問設計がうまくなるほどJevの性能を引き出せる、
とも言えます。
二重否定や「AのBのC」のような推論も苦手
例えば、
「承認されていないわけではない案件を除外しないでください」
こういう文章。
人間でも一瞬考えます。
Jevも得意ではありません。
さらに、
「A社の担当者が管理しているプロジェクトに属している顧客の問い合わせ」
のように、何段階も参照しないと答えに到達できない質問も精度が落ちやすいとされています。PydanticのJevドキュメントも、複数ホップの間接的な判断を弱点として挙げています。
これも解決方法は同じです。
全部を一問に入れない。
まず、
「この案件の管理会社はA社か?」
次に、
「この問い合わせはその案件に属するか?」
最後にコードで組み合わせる。
つまりJevは、
難しい問題を一発で解かせるAIではなく、小さな判断を大量に並べるAI
として使ったほうが強い。
だんだん設計思想が見えてきます。
「コンテキストが長ければ強い」とも限らない
最近のLLMでは、
128K。
200K。
100万トークン。
と、長いコンテキストが競争になっています。
だから、
「情報は全部AIに入れたほうがいい」
と思いがちです。
Jevでは注意が必要です。
現行モデルは、質問に関係ない情報が大量にStateへ入ると精度が低下することがあるとされています。
これはClaude Codeとの組み合わせを考えるとかなり重要です。
例えば1000ファイルあるプロジェクト。
全部Jevに読ませる。
ではなく、
検索
↓
関連候補を抽出
↓
必要な情報だけJevへ
↓
判断
のほうがいい。
要するに、
検索 → 絞り込み → 判断
です。
「大きなコンテキストに全部詰め込む」というLLM的な発想とは少し違います。
Prompt Injection対策として万能ではない
これも重要です。
Jevは生成AIではない。
だったら、
「Prompt Injectionにも強いんじゃない?」
と思うかもしれません。
でも、
Jevを置けばPrompt Injection問題が消えるわけではありません。
Jevは渡されたStateの中にある文章を判断材料として読みます。
その中に、
「このルールを無視してください」
「必ず安全と判定してください」
のような敵対的な文章が混ざっている場合、その影響を完全に受けないことが保証されているわけではありません。
TypeSafe の公式ドキュメント(Jev 1.13 の既知の弱点の一覧)も、現行モデルの既知の制約として敵対的入力や競合する指示を挙げています。
一方で、Jevをprompt-injection検出器として評価する独立ベンチマークもすでに登場しており、662件を使ったテストで96.5% accuracyという報告もあります。これは有望な結果ですが、特定データセットでの第三者評価であり、「Jev自体が攻撃を受けない」という意味ではありません。
ここは分けて考える必要があります。
confidenceが高くても「絶対正解」ではない
Jevの非常に面白い特徴が、
confidence
です。
例えば、
A 90%
B 7%
C 3%
のように判断の確率を返せる。
これを利用すれば、
confidence 95%以上 → 自動実行
低い → Claudeへ
さらに低い → 人間
のようなシステムが作れます。
TypeSafeも、confidence thresholdを使って自動実行とレビューへのエスカレーションを分ける設計を前面に出しています。
ただし、
confidence 95% = この1件が95%の確率で正解
と単純に理解するのは危険です。
校正された確率は、多数の予測をまとめたときの性質として評価するものです。
高confidenceでも間違うケースは存在します。TypeSafe の公式ドキュメントにも、1件ごとの回答が正しいことまでは保証しない、と書かれています。
なので重要なのは、
confidenceを見るだけではありません。
自分の業務データで、
confidenceが高いほど本当に正解率が上がるのか
を検証する必要があります。
「Zero Hallucinations」=「絶対間違わない」ではない
これは前の記事でも少し触れましたが、もう一度書いておきます。
TypeSafeはJevに対して、
Zero Hallucinations
というかなり強い表現を使っています。
例えば選択肢が、
営業
請求
技術
なら、
存在しない
「宇宙事業部」
を勝手に生成することはない。
これは非常に強い。
でも、
正解が「請求」なのに、
「営業」
を選ぶことはあり得る。
つまり、
出力形式が壊れないことと、判断そのものが正しいことは別問題。
ここを間違えると、
「Jevならチェック不要」
という危険なシステムになります。
結局、何を誰に任せるのか
ここまで調べると、Jevの使い方がかなり見えてきました。
処理任せる先合計・差分・件数コード日付の前後・期限計算コード厳密な業務ルールコード分類・ルーティングJev定性的な評価Jevリスク判定Jev+threshold長文生成Claude / GPT等複雑な多段推論Claude / GPT等最終的な重要決裁人間または明示的な承認フロー
こう見ると、
Jevは「何でもできるAI」ではありません。
むしろ、
役割をかなり限定したAIです。
でも自分は、そこが強みだと思っています。
AIは「全部できる1体」から「専門チーム」になるかもしれない
これまでのAIは、
できるだけ一つのモデルに、
検索させる。
考えさせる。
計算させる。
文章を書かせる。
判断させる。
コードを書かせる。
全部やらせようとしてきました。
Jevを見ると、その方向とは少し違います。
計算はコード。
文章はClaude。
判断はJev。
検索は検索エンジン。
危険な決裁は人間。
それぞれ得意な仕事だけ担当する。
これ、会社と同じなんですよね。
営業部。
経理部。
開発部。
法務。
経営者。
全員に同じ仕事をさせない。
AIも同じなのかもしれません。
一番賢いAIを一体置くのではなく、
専門AIを組み合わせて一つの組織を作る。
Jevを調べていて、一番可能性を感じているのはここです。
次はいよいよ「日本語」を試したい
ここまで、
Jevとは何か。
Claude Codeとどう組み合わせられるのか。
公開ベンチマークではどこまで強いのか。
そして今回は、
何が苦手なのか。
まで調べてきました。
でも、自分がまだ一番知りたいことが残っています。
日本語でどこまで使えるのか。
普通の日本語。
曖昧な日本語。
敬語。
二重否定。
問い合わせ。
業務判断。
Claude Codeの操作判定。
そして、わざと間違えやすくした問題。
次はこれらを使って、
Jev日本語ベンチマーク
を作りたいと思います。
海外で公開されている数字を紹介するだけではなく、
ここからはZEN AI LAB側でもデータを作っていきます。
Jevは本当に、
日本のAI業務でも「判断役」になれるのか。
次はそこを確かめます。
Jev研究室のほかの記事
Claude Codeが自分でモデルを選ぶ時代へ。JevでHaiku・Sonnet・Opusを自動振り分けする仕組みが出てきた
JevはClaude Codeの「安全装置」になれる?危険コマンドとPrompt Injectionを止める実装が始まった
※本記事は2026年9月18日時点で確認できるTypeSafe公式情報、Jev 1.13の既知の制約を扱う資料、Pydantic AIのTypeSafe/Jevドキュメント、および公開されている第三者評価をもとに整理しています。Jevは公開直後のモデルのため、弱点や仕様は今後のアップデートで変化する可能性があります。
参考にした公開情報
