結論(2026年9月時点):OllamaでQwen 3.5を動かすなら、Ollamaを入れて「ollama run qwen3.5:9b」を実行するだけです。初回のみ約6.6GBのモデルをダウンロードし、以降はオフラインでも動きます。快適に使う目安はRAM 16GB以上のApple Silicon Mac、またはNVIDIA GPU搭載のWindows機です。
結論: Qwen 3.5 9Bは16GB RAMのPCで動き、120Bより大きなモデルを超える性能を発揮します。ollamaなら「ollama run qwen3.5:9b」の1コマンドで動作します。
この記事の要点:
- 要点1: Qwen 3.5 9BはMMLU-Pro 82.5点で、3倍大きいQwen3-30B-A3B(80.9点)を上回る(2026年9月5日時点の公式モデルカード)
- 要点2: RAM 16GB以上のPC(Apple Silicon Mac・Windows NVIDIA GPU機)で快適動作
- 要点3: データが外部に出ないため、機密情報を扱う企業でも安心して使える
対象読者: ローカルAIに興味がある企業のIT担当者・開発者・プライバシー重視の業務担当者
読了後にできること: 今日中にQwen 3.5をローカルPCで動かし始められる
「クラウドAIを使いたいけど、情報漏洩が怖い」
この悩みを抱えている企業担当者が本当に多いんです。先日も、顧問先の法律事務所から「クライアントの案件情報をAIに入力するのは規約上NGで、使い方が限られている」という相談を受けました。
そこで提案したのがローカルAIです。Qwen 3.5 9Bなら、16GB RAMの普通のPCで動いて、データが一切外部に出ない。しかも性能は驚くほど高い。試してもらったところ、「これが無料で手元のPCで動くの!?」と相当びっくりされていました。
この記事では、2026年3月リリースのQwen 3.5 9Bをローカルで動かす方法を、ollamaからllama.cpp、vLLMまで完全解説します。初めてローカルAIを触る方でも、今日中に動かせるようにステップバイステップで説明します。
まず5分で動かす:ollama最速セットアップ
難しい設定不要。このコマンドだけでQwen 3.5 9Bが動きます。
# ステップ1: ollamaのインストール
# Mac:
brew install ollama
# または https://ollama.com からGUIインストーラーをダウンロード

# Windows/Linux:
# https://ollama.com/download からダウンロード

# ステップ2: Qwen 3.5 9Bを起動(初回は約6.6GBのダウンロードが走る)
ollama run qwen3.5:9b

# ステップ3: 質問してみる
# プロンプト: 「このメールの返信文を日本語で書いてください: [メール本文]」
これだけです。びっくりするほど簡単でしょ。初回のダウンロードが終われば、次回からはオフラインでも動きます。
ローカルAIの基本概念や、クラウドAIとの使い分けについては、AI導入戦略ガイドで詳しく解説しています。
Qwen 3.5 9Bとは?なぜ今注目されているのか
Qwen 3.5は、中国のAlibabaが開発したオープンウェイト(無料公開)のLLMシリーズです。2026年3月2日にリリースされた9Bモデルは、スモールモデルの常識を覆すような性能を発揮しています。
性能比較(2026年3月時点)
| ベンチマーク | Qwen 3.5-9B | Qwen3-30B-A3B-Thinking-2507(旧世代) | Qwen3-Next-80B-A3B-Thinking(旧世代) |
|---|---|---|---|
| MMLU-Pro | 82.5 | 80.9 | 82.7 |
| GPQA Diamond | 81.7 | 73.4 | 77.2 |
| LongBench v2 | 55.2 | 44.8 | 48.0 |
| モデルサイズ | 9B(約6.6GB) | 30B(約20GB) | 80B(約48GB) |
公式モデルカード(2026年9月5日確認)では、9BはQwen3-30B-A3B-Thinking-2507(80.9/73.4/44.8)を全項目で上回り、Qwen3-Next-80B-A3B-Thinking(82.7/77.2/48.0)に対してもGPQA DiamondとLongBench v2で上回っています。モデルの「効率性」という点で、Qwen 3.5 9Bは現時点で最高クラスです。
あわせて読みたい(2026年9月更新の関連記事)
必要なシステムスペック
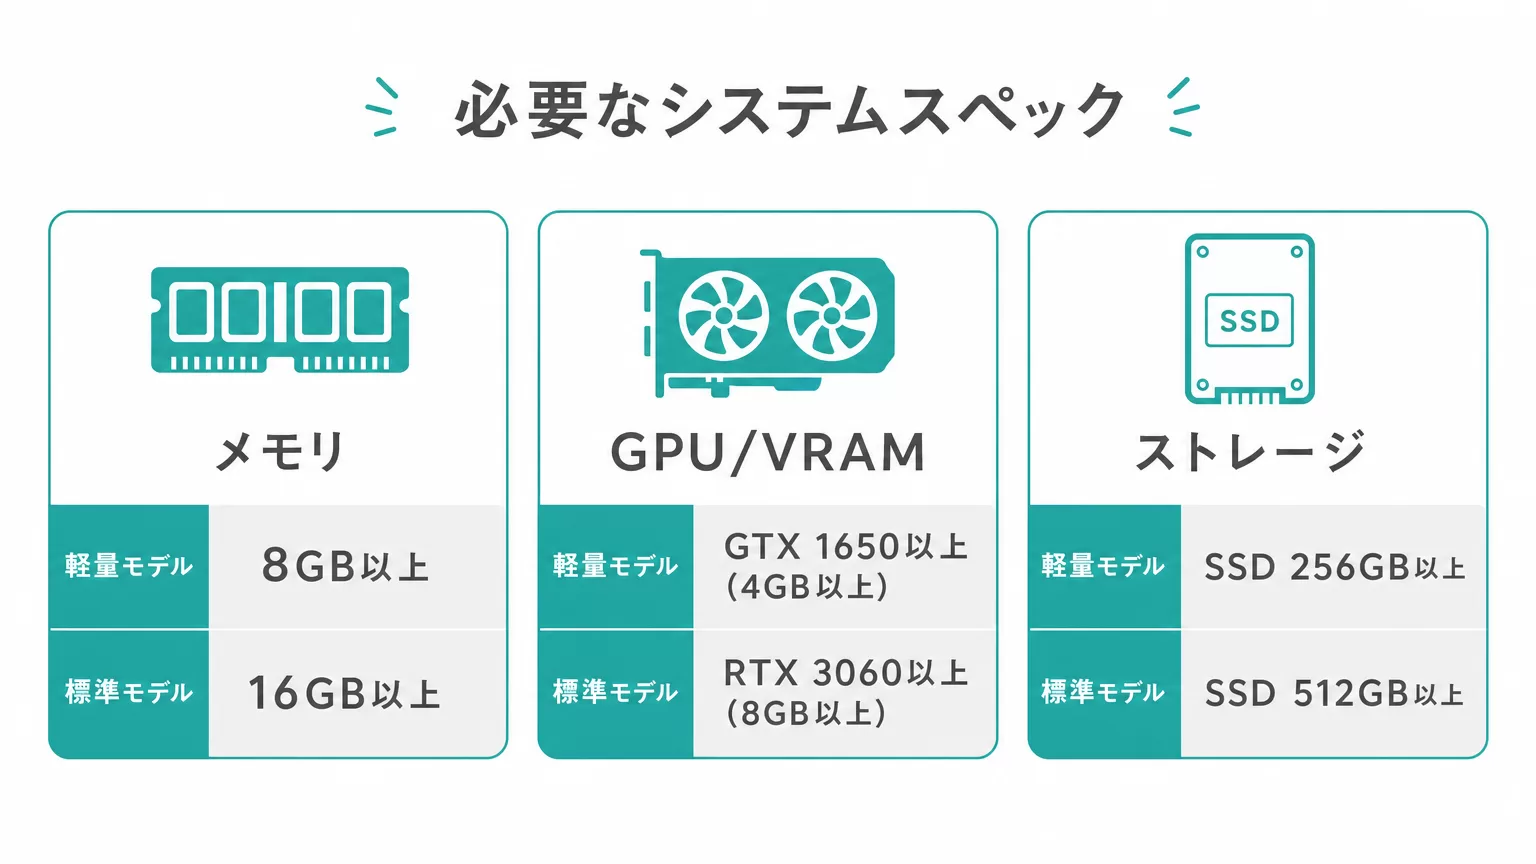
| 項目 | 最低スペック | 推奨スペック | コメント |
|---|---|---|---|
| RAM | 8GB | 16GB以上 | 8GBでも動くが遅い。16GBで快適 |
| GPU(NVIDIA) | 8GB VRAM | 12GB VRAM以上 | GPUがあると推論速度が10倍以上速い |
| Apple Silicon | M1(16GB) | M2/M3/M4(16GB+) | 統合メモリで超高速。MacBook Proで実用的 |
| ストレージ | 10GB空き | 20GB以上 | モデルファイル約6GB+余裕 |
| OS | macOS 12以上, Windows 10以上, Ubuntu 20.04+ | 同左 | 3プラットフォーム対応 |
Apple Silicon Mac(M1以降)は特におすすめです。GPU・CPUのメモリが統合されているため、16GBのMacBook Proでも非常に快適に動きます。私自身もM3 MacBook Proで使っていますが、レスポンス速度はクラウドAIとほぼ変わりません。
ollama詳細設定ガイド
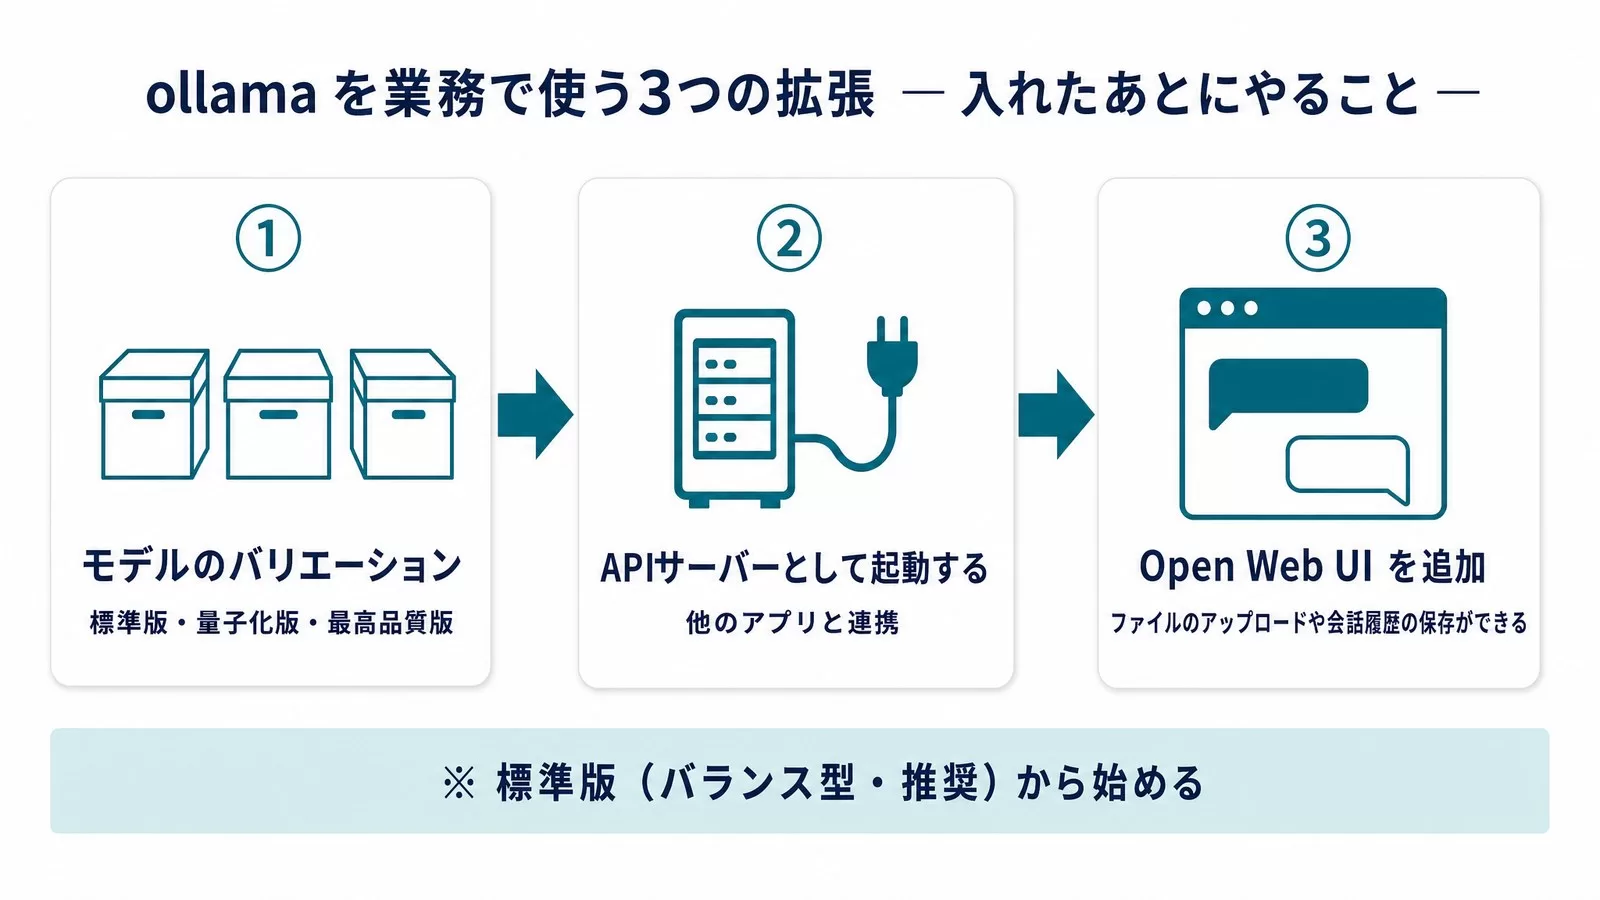
モデルのバリエーション
# 標準版(バランス型・推奨)
ollama run qwen3.5:9b

# 量子化版(RAMが少ない場合)
ollama run qwen3.5:9b-q4_K_M    # 4bit量子化(既定のqwen3.5:9bと同じ約6.6GB・2026年9月5日時点のタグ名)

# 最高品質版
ollama run qwen3.5:9b-bf16    # フル精度・約19GB(2026年9月5日時点のタグ名)
APIサーバーとして起動する(他のアプリと連携)
# ollamaサーバーを起動(バックグラウンド)
ollama serve

# ローカルAPIにアクセス(http://localhost:11434)
curl -X POST http://localhost:11434/api/generate
  -H "Content-Type: application/json"
  -d '{
    "model": "qwen3.5:9b",
    "prompt": "以下のメールを3行で要約してください: [メール本文]",
    "stream": false
  }'
Open Web UIで使いやすいインターフェースを追加
# DockerでOpen Web UIをインストール(ChatGPT風のUIが使える)
docker run -d -p 3000:8080
  --add-host=host.docker.internal:host-gateway
  -v open-webui:/app/backend/data
  --name open-webui
  ghcr.io/open-webui/open-webui:main

# ブラウザで http://localhost:3000 を開く
# ollamaと自動連携されてQwen 3.5が使える
Open Web UIを使うと、ファイルのアップロードや会話履歴の保存ができるようになり、実用性が大幅に上がります。研修先でも「ChatGPTっぽいUIで使えるなら分かりやすい」と好評でした。
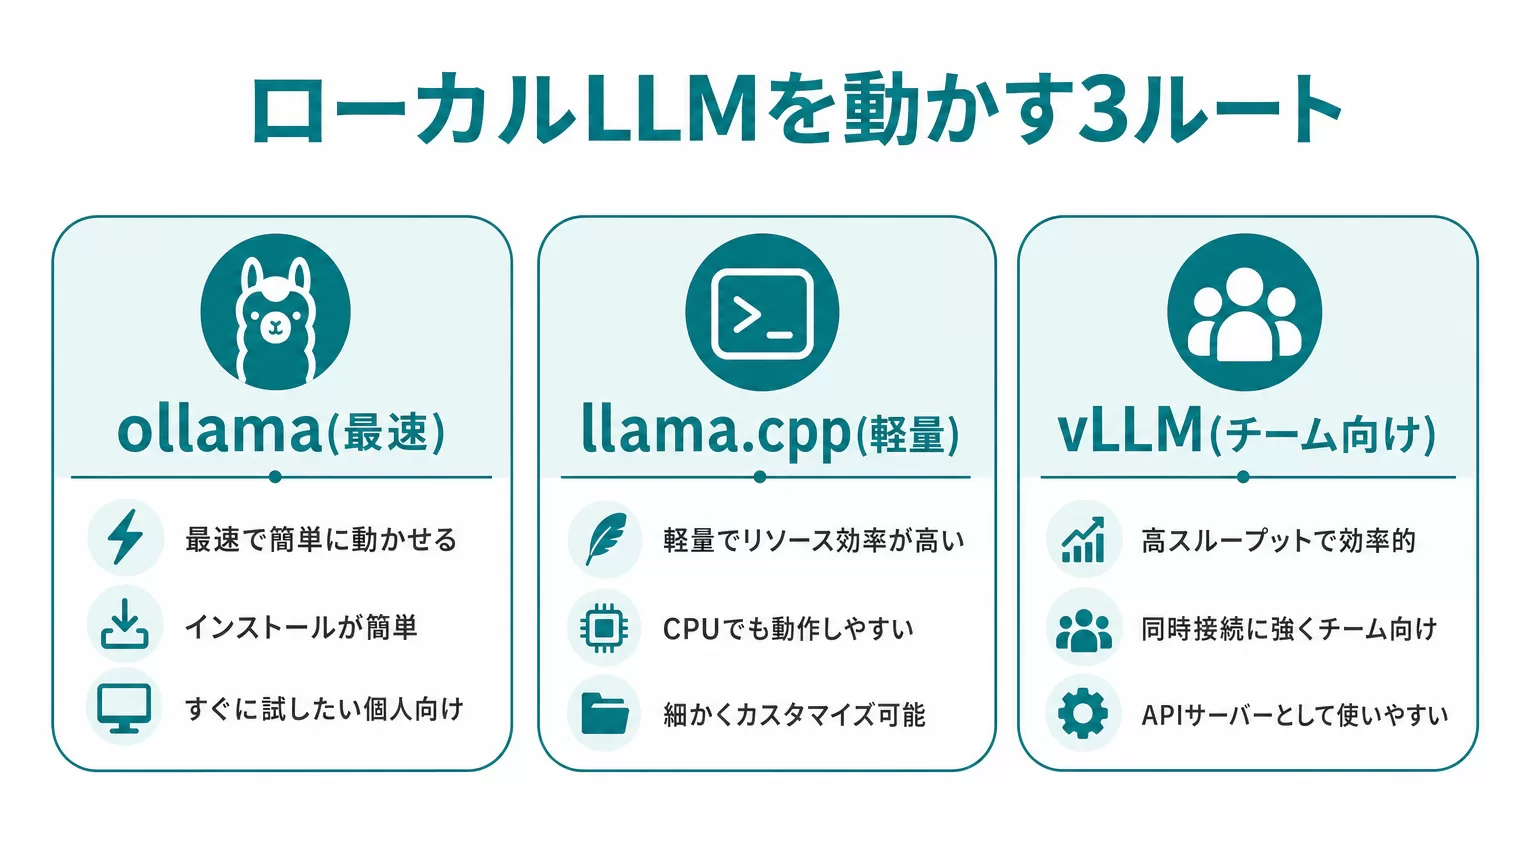
llama.cppでの実行方法(軽量・高速)
ollamaが内部的に使っているエンジンがllama.cppです。直接使うと、より細かい設定が可能になります。
# ビルド(Mac/Linux)
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
cmake -B build && cmake --build build --config Release -j 8   # CPU推論(2026年9月5日時点の公式手順)
# または NVIDIA GPU使用の場合:
# cmake -B build -DGGML_CUDA=ON && cmake --build build --config Release -j 8

# Qwen 3.5 9BのGGUFファイルをHugging Faceからダウンロード
# https://huggingface.co/Qwen/Qwen3.5-9B-GGUF

# 実行
./llama-cli -m qwen3.5-9b-q4_k_m.gguf
  --prompt "あなたは優秀なビジネスアシスタントです。[ここに指示]"
  -n 512
  --ctx-size 8192
重要な注意点: Qwen 3.5の初期対応版(ollama v0.17.4〜0.17.6・2026年3月)にはクラッシュや繰り返し出力の不具合があり、v0.17.5以降で順次修正されています(2026年9月5日時点の最新はv0.33.3)。不具合が出た場合はまずollamaを更新し、それでも動かなければllama.cppを直接使ってください。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
vLLMでの実行方法(チーム・API利用向け)
複数メンバーで使う場合やAPIとして社内展開する場合は、vLLMが最適です。
# vLLMのインストール
pip install vllm

# Qwen 3.5 9Bをvllmサーバーとして起動
vllm serve Qwen/Qwen3.5-9B
  --max-model-len 8192
  --host 0.0.0.0
  --port 8000

# 使用例(OpenAI互換API)
curl http://localhost:8000/v1/chat/completions
  -H "Content-Type: application/json"
  -d '{
    "model": "Qwen/Qwen3.5-9B",
    "messages": [
      {"role": "user", "content": "社内ナレッジベースの検索方法を教えてください"}
    ]
  }'
vLLMの特徴はOpenAI互換APIを提供することです。ChatGPTのAPIを使って作ったアプリケーションのURLだけ変えれば、そのままQwen 3.5に切り替えられます。APIコストをゼロにできるのは大きなメリットです。
日本語性能の検証結果
実際に研修先のIT部門で、日本語の実務タスクを検証しました。
事例区分: 想定シナリオ
以下は複数の企業担当者へのヒアリングと一般的な使用パターンをもとに構成した典型的なシナリオです。
| タスク | Qwen 3.5 9B | GPT-4o mini(参考) | 評価 |
|---|---|---|---|
| メール文章作成 | 自然で読みやすい | 自然 | ほぼ同等 |
| 技術文書の要約 | 重要ポイントを適切に抽出 | 同等 | ほぼ同等 |
| コード生成 | Python/JSは高品質 | 同等 | ほぼ同等 |
| データ分析 | 論理的な分析が得意 | 同等 | ほぼ同等 |
| 複雑な推論 | 9B比では優秀だが限界あり | やや優位 | GPT-4o miniがやや上 |
日常的なビジネスタスクでは、クラウドの有料AIとほぼ遜色ない品質を発揮します。「複雑な多段階推論」だけは大型クラウドモデルに分があります。「日常的な文書作成やコーディング補助はQwen 3.5、高度な分析はGPT-6 Astra/GPT-5.6 SolやGemini 3.1 Pro(2026年9月5日時点の各社公式モデル一覧)」という使い分けが実用的です。
プライバシー重視の企業での活用シーン
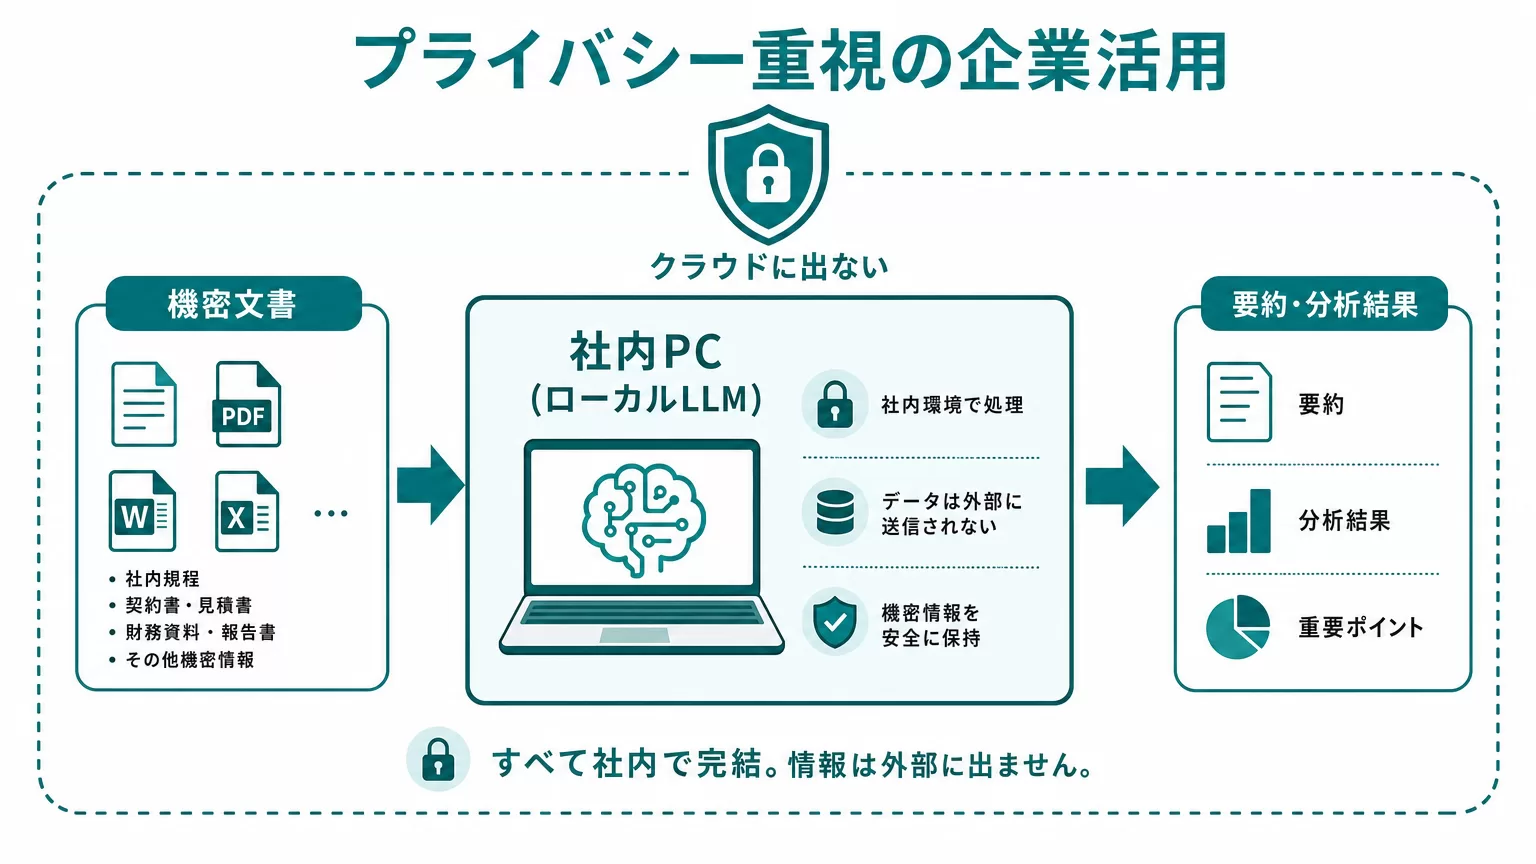
活用シーン1:法律・会計事務所(機密文書の処理)
クライアントの契約書や財務情報をAIに入力するのは、利用規約上NGな場合が多いです。ローカルAIならデータが外部に出ないため、この問題を解決できます。
以下の契約書の要点を整理してください。

[契約書の本文をここに貼り付け]

整理の観点:
1. 主要な義務事項(甲・乙それぞれ)
2. リスク条項(ペナルティ・免責・解除条件)
3. 不明確な表現(法的リスクがある箇所)
4. 確認が必要な事項

法的判断は含めず、事実の整理のみを行ってください。
不足している情報があれば、最初に質問してから作業を開始してください。
活用シーン2:医療・介護施設(患者情報の要約)
診療記録や介護記録のような個人情報は、クラウドAIへの入力が禁じられているケースがほとんどです。ローカルAIで記録の整理や引き継ぎ文書の作成ができます。
以下の記録から、週次の状況報告書を作成してください。

[記録をここに貼り付け]

報告書の形式:
- 今週の主要な変化(健康状態・気分・活動)
- 特記事項
- 来週の注目ポイント
- 担当者への申し送り事項

個人が特定できる情報は「対象者」と表記してください。
活用シーン3:製造業(設計仕様書・マニュアルの活用)
未公開の設計仕様書や製造マニュアルをAIに読み込ませて、問い合わせ対応や教育資料作成に活用できます。競合他社に見られたくない独自技術も安心です。
以下の製造マニュアルを参照して、新入社員向けの操作手順チェックリストを作成してください。

[マニュアルの本文をここに貼り付け]

チェックリストの要件:
- ステップごとに1行(20字以内)
- 安全上の注意は【要注意】マークをつける
- 作業時間の目安を各ステップに追加

分からない箇所は「[確認要]」と記載してください。
【要注意】ローカルAI導入でよくある失敗パターン
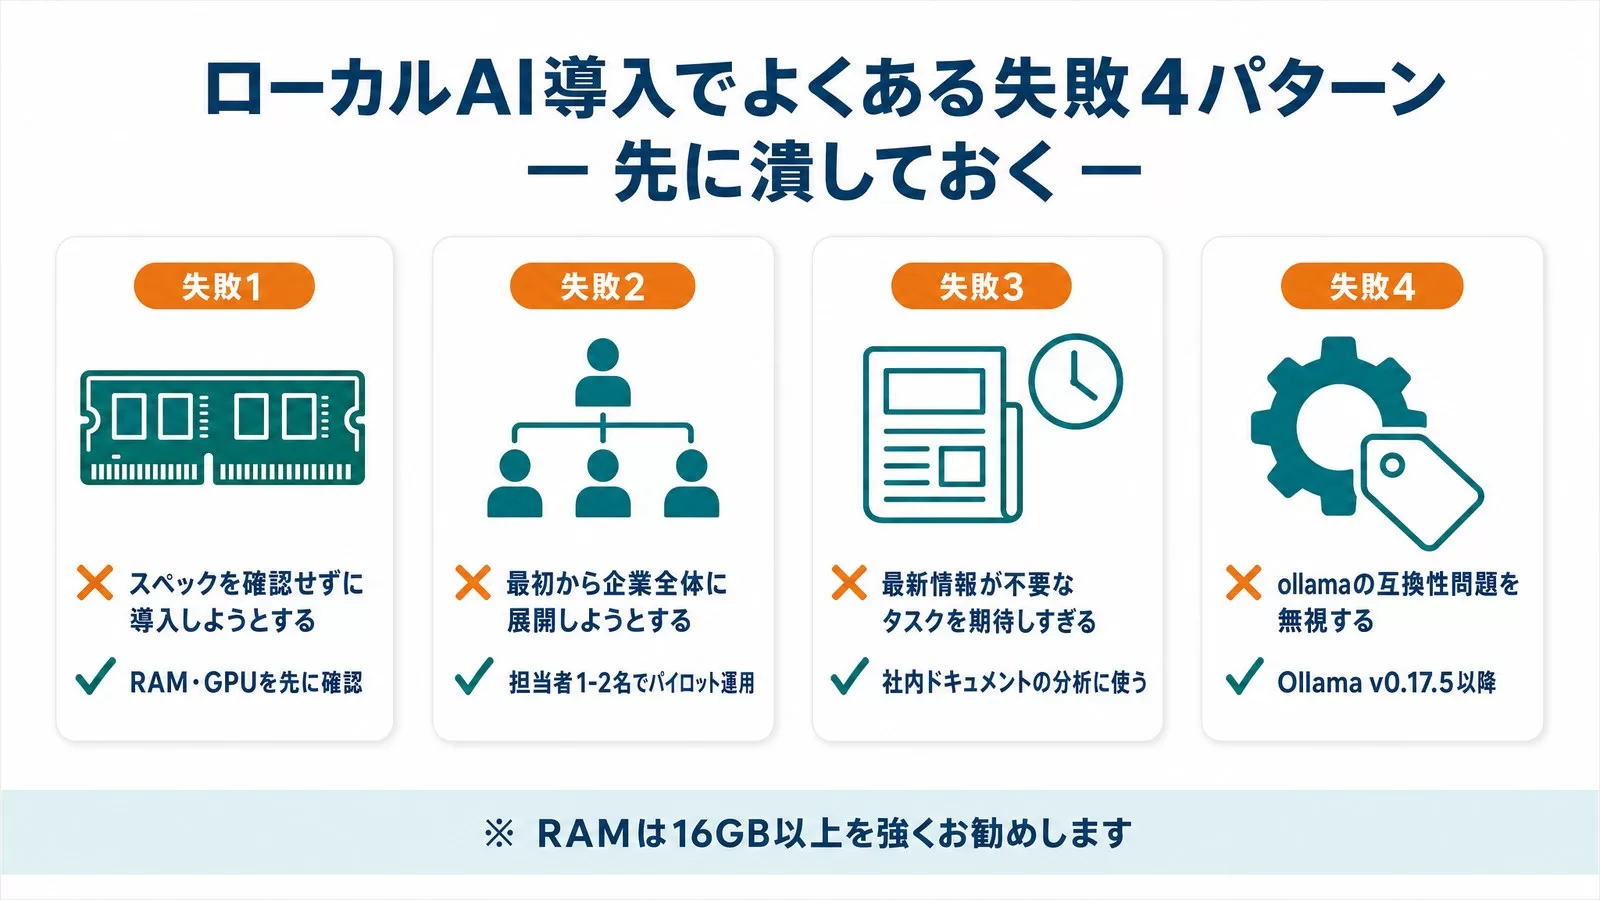
失敗1:スペックを確認せずに導入しようとする
❌ 「8GBのPCに入れたら重すぎて使い物にならない」
⭕ 「まず自分のPCのRAM・GPUを確認してから、適切な量子化バージョンを選ぶ」
なぜ重要か: Qwen 3.5 9Bの標準版はおよそ8GB必要です。RAMが8GBしかない場合は、既定の9b(4ビット量子化q4_K_M・約6.6GB)でも余裕がないため、より小さいqwen3.5:4bを使えば動きますが、品質がやや落ちます。16GB以上を強くお勧めします。
失敗2:最初から企業全体に展開しようとする
❌ 「全員のPCに一斉導入した結果、スペックが足りなくてトラブル続出」
⭕ 「まずITリテラシーの高い担当者1-2名でパイロット運用して、手順書を整備してから展開」
なぜ重要か: ローカルAIの導入はクラウドと違い、各PCのスペック確認・ソフトウェアの互換性確認が必要です。パイロット運用で問題を洗い出してから展開するのが鉄則。
GPUやモデルの選定を社内で判断しきれない場合は、構成の設計から支援するローカルLLM導入支援のページも参考にしてください。
失敗3:最新情報が不要なタスクを期待しすぎる
❌ 「今日のニュースを要約して」→ モデルの学習データに最新情報が含まれていない
⭕ 「文書の要約・コード生成・社内ドキュメントの分析」→ これが真の強み
なぜ重要か: ローカルLLMは学習時点以降の情報を持っていません。最新情報が必要なタスクはクラウドAI(特にPerplexityやGemini)に任せ、ローカルAIは社内情報の処理に特化させるのが賢明です。
失敗4:ollamaの互換性問題を無視する
❌ 「ollamaのバージョンを確認せずに古いバージョンで動かそうとしてエラー」
⭕ 「Qwen 3.5(9B)はOllama v0.17.5以降が必要。事前にバージョン確認してからインストール」
なぜ重要か: Qwen 3.5の初期対応版(ollama v0.17.4〜0.17.6・2026年3月)にはクラッシュや繰り返し出力の不具合があり、v0.17.5以降で修正されています(2026年9月5日時点の最新はv0.33.3)。古いollamaを使っている場合はまず更新し、問題が残る場合はllama.cppを直接使う選択肢も覚えておいてください。
既存のQwen 3.5概要記事との差別化
当サイトのQwen 3.5完全ガイド(概要・比較)では、クラウドAPIや他モデルとの比較を詳しく解説しています。本記事は「ローカル実行」に特化した実践ガイドです。
- 概要・比較記事: Qwen 3.5の特徴・他モデルとのベンチマーク比較・クラウドAPI利用法
- 本記事(ローカルガイド): ollama/llama.cpp/vLLMでのセットアップ・スペック要件・企業活用シーン
参考・出典
- Qwen 3.5 Beats 120B Models on 16GB RAM: Local Setup Guide — ByteIOTA(参照日: 2026-03-23)
- How to Run Qwen 3.5 Locally on a Single GPU: Step-by-Step Guide — DataCamp(参照日: 2026-03-23)
- Qwen/Qwen3.5-9B — Hugging Face公式(参照日: 2026-03-23)
- MacBookで動くし、ぶっ壊れ性能。いま最強のローカルLLM「Qwen3.5」を解説 — Gizmodo Japan(参照日: 2026-03-23)
- Qwen3.5 Usage Guide – vLLM Recipes — vLLM公式ドキュメント(参照日: 2026-03-23)
まとめ:今日から始める3つのアクション
- 今日やること: ollamaをインストールして「ollama run qwen3.5:9b」を実行。5分で動作確認できる
- 今週中: 自社でローカルAIが最も効果的なユースケース(機密文書処理・社内マニュアル活用等)を1つ特定し、パイロット検証する
- 今月中: チームの中でIT担当者を中心にローカルAI運用の手順書を作成し、展開可否を判断する
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。早稲田大学法学部在学中に生成AIの可能性に魅了され、X(@SuguruKun_ai)フォロワー約10万人。100社以上の企業向けAI研修・導入支援を展開。著書『AIエージェント仕事術』(SBクリエイティブ)。SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。
よくある質問
Qwen 3.5 をローカルで動かすには何が必要ですか?
RAM 16GB 以上のPCがあれば動きます(Apple Silicon の Mac も対象)。ollama を入れていれば ollama run qwen3.5:9b の1コマンドで起動します。必要スペックの詳細は本記事にまとめています。
9B は小さいモデルですが、性能は足りますか?
足ります。ベンチマークでは3倍大きい Qwen3-30B を上回る結果が出ています。「パラメータ数が大きいほど賢い」という前提が崩れているので、手元のPCで動くサイズでも実務に使える水準です。日本語での検証結果も本記事に載せています。
ollama 以外の動かし方はありますか?
あります。llama.cpp(軽量・高速に寄せたい場合)とvLLM(チームで共有したりAPIとして立てたい場合)の手順を本記事に載せています。まず試すだけなら ollama が最短です。
📌 関連サービス
ローカルLLM導入の社内セキュリティ設計、お任せください
Qwen 3.5などのローカルLLMを業務に取り入れたいが、社内のセキュリティ承認や運用設計で詰まっていませんか。Uravationは100社以上の企業向けに、社内専用AI環境の設計・導入支援を提供しています。
- ✅ 100社以上の企業向けAI研修・導入支援実績
- ✅ Claude Code・Codex・ChatGPTの実務導入支援
- ✅ AI顧問・伴走支援(月次運用・KPI設計)
監修:株式会社Uravation(生成AI活用書籍シリーズ累計59,900部の著者チームが運営。自社7メディアの実運用でAI検索からの引用・流入を継続計測し、その知見に基づいて編集しています。仕様・料金が変わりやすい領域のため、重要な意思決定の前には各公式情報の最新版をご確認ください)
この記事の内容を社内展開する方へ: ローカルLLM 社内導入チェックシート(無料・PDF 32ページ+Excel) をダウンロードできます。