2026年10月3日 更新|先に結論
Ollamaは、社内のPCやサーバーでオープンモデルのLLMを動かせる無料(MITライセンス)のローカルLLM実行環境です。Mac/Windows/Linux/Dockerに対応し、コマンド1つでモデルの取得と実行ができます。Claude Codeは ANTHROPIC_BASE_URL を切り替えるだけでローカルモデルを呼び出せます。2026年8月25日からはClaude Desktopの接続先にも設定でき、8月31日の料金改定でOllama CloudのPro/Max/Teamは月額に使用量クレジットが付く従量制になりました。9月29日のOllama 0.35では決定モデル(Jev型)のAPIも入っています(本文は2026年10月3日時点・v0.35.1)。
結論: Ollamaは、社内のPCやサーバー上でオープンモデルのLLMを直接動かせる無料のローカルLLM実行環境です。2026年10月3日時点の最新版はv0.35.1(GitHub公式リリース、2026年9月29日付)で、2026年1月にAnthropicのMessages API互換機能が追加されたことで、Claude Codeをそのままローカルモデルで動かす、あるいはローカルモデルとクラウドのClaudeを使い分けるという運用が現実的になりました。
この記事の要点:
- 要点1: Ollama自体はMITライセンスの無料ソフトウェアで、Mac/Windows/Linux/Dockerに対応し、コマンド1つでモデルをダウンロード・実行できます
- 要点2:
ANTHROPIC_BASE_URLを切り替えるだけでClaude CodeからOllama上のローカルモデルを呼び出せるため、機密性の高いコードベースをクラウドAPIに一切送らずに検証する、というセキュリティ要件の高い現場での使い分けが可能です - 要点3: Ollama本体はMITライセンスでも、配布されているモデルごとにライセンスが異なるため、商用利用の可否は各モデルの配布元表記を個別に確認する必要があります
対象読者: 社内の機密データやコードを扱う業務でAI活用を検討している情報システム部門・エンジニア組織の責任者、Claude Codeの利用拡大でAPIコストやデータ送信範囲に不安を感じている経営者
読了後にできること: Ollamaのインストールからモデル実行、Claude CodeとのローカルLLM連携までを自分の手で試し、自社でローカルLLMを検討すべきかどうかを判断できるようになります
「Claude Codeの利用が増えてきて、正直API従量課金がどこまで膨らむか読めない」——エンジニア組織向けのAI研修で、この手の相談を受ける機会が増えています。もう一つ多いのが「社内の機密性が高いリポジトリを、外部のクラウドAPIに投げてよいものか判断がつかない」という声です。
この2つの悩みに対する現実的な選択肢の一つが、ローカルLLM実行環境の「Ollama」です。オープンモデルを自社のPCやサーバー上で直接動かせるため、コードやデータを外部に送信せずに検証できますし、従量課金も発生しません。2026年1月にはOllamaがAnthropicのMessages API互換を実装したことで、使い慣れたClaude Codeのインターフェースのまま、ローカルモデルとクラウドのClaudeを使い分けるという運用も現実的になりました。
正直に言うと、Ollamaで動くローカルモデルは、クラウドの最新Claudeと完全に同じ精度が出るわけではありません。とはいえ「軽い調査・下読み・機密性の高い一次検証はローカル、最終的な仕上げや複雑な設計判断はクラウドのClaude」というように使い分ければ、コストと安全性のバランスを取ることができます。
この記事では、Ollamaのインストールから、モデルの取得・実行、API連携、Claude Code・MCPとの連携方法、そして法人導入で確認すべきライセンス・セキュリティの注意点まで、実務で使う順番に沿って解説します。100社以上のAI研修・導入支援で聞かれてきた質問をベースに、法人の意思決定者が知っておくべきポイントに絞ってお伝えします。
Ollamaとは?無料で使えるローカルLLM実行環境の基本
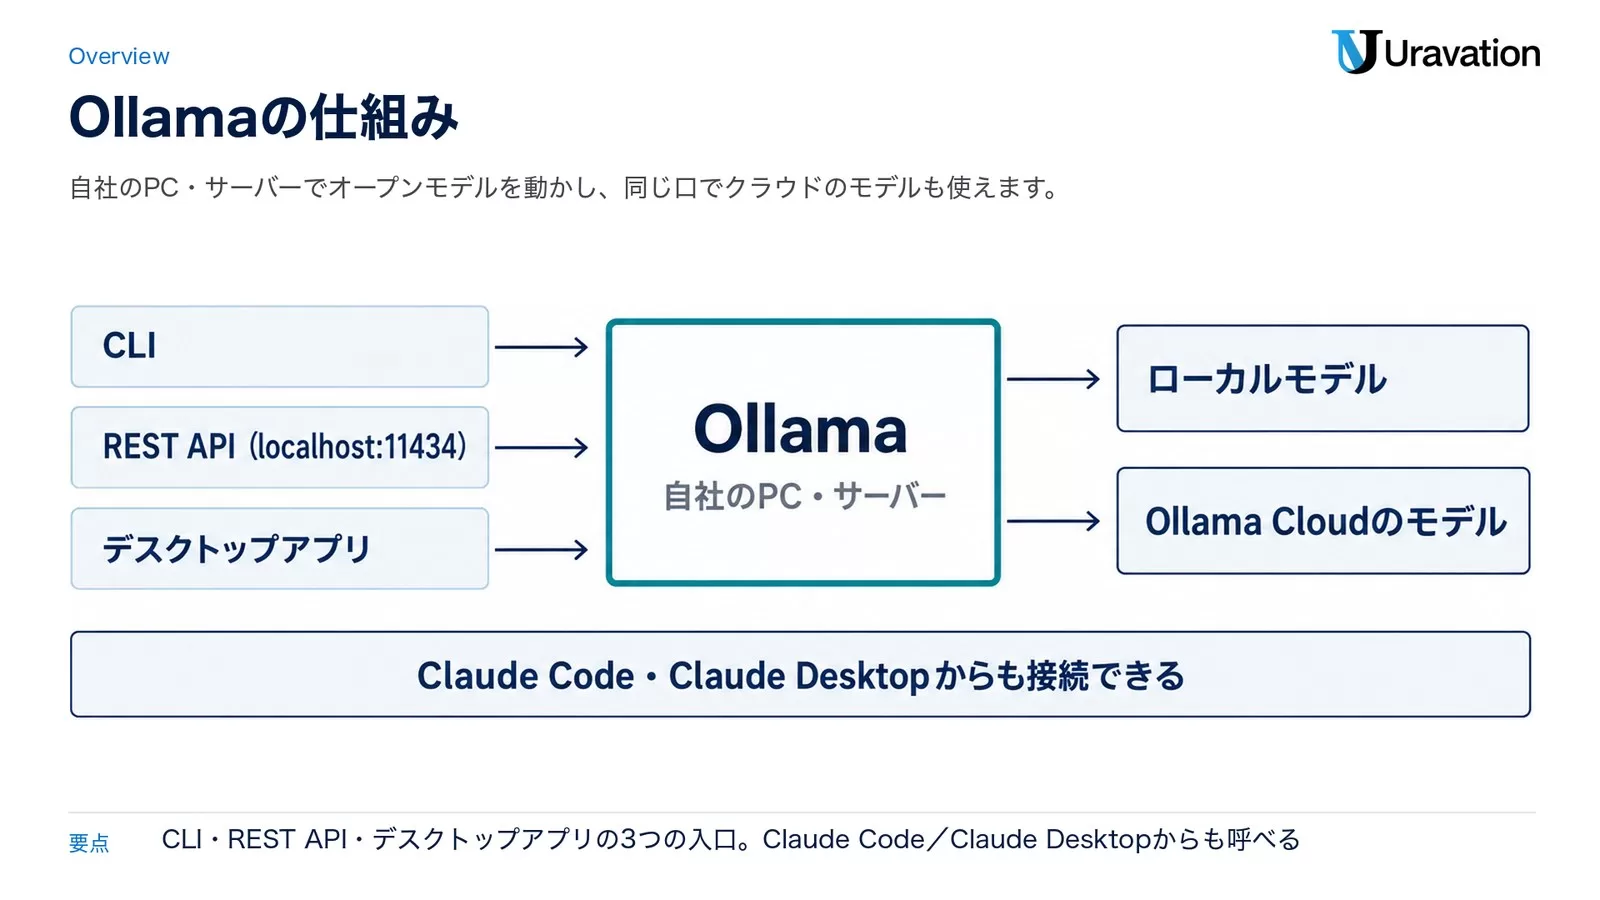
Ollamaとは、Meta LlamaやGoogle Gemma、Alibaba Qwenといったオープンモデルの大規模言語モデル(LLM)を、自社のPCやサーバー上でダウンロードして直接実行できる無料のソフトウェアです。公式サイトでは「Build with open models, on your computer and in the cloud」と説明されており、コマンドライン(CLI)から数コマンドでモデルの取得・起動・API公開までを完結できるのが特徴です。
| 項目 | 内容 |
|---|---|
| 提供元 | Ollama(Copyright (c) Ollama、GitHub: ollama/ollama) |
| ライセンス | MITライセンス(ソフトウェア本体) |
| 2026年10月時点の最新版 | v0.35.1(2026年9月29日リリース、GitHub公式リリースページ確認) |
| 対応OS | macOS/Windows/Linux/Docker |
| 料金 | ソフトウェア自体は無料。クラウドモデル利用時のみOllama Cloudの有料プランが必要になる場合あり |
| 主なインターフェース | CLI(ターミナル)、REST API(http://localhost:11434)、デスクトップアプリ |
ローカルAI全般の仕組みや企業導入の判断基準はローカルAIとは|企業導入のメリットと判断基準でも整理していますので、Ollama単体の話に入る前に全体像をつかみたい方はあわせてご覧ください。
インストール方法(Mac/Windows/Linux/Docker)
Ollamaのインストールは、公式ドキュメント(docs.ollama.com)で案内されている方法であればどれも数分で完了します。社内PCに入れる場合は、情報システム部門の許可を取ったうえで進めてください。
macOS
curl -fsSL https://ollama.com/install.sh | shHomebrewを使っている場合はbrew upgrade ollamaでのアップデートにも対応しています。DMGファイルを手動ダウンロードしてインストールすることも可能です。
Windows
irm https://ollama.com/install.ps1 | iexPowerShellから上記コマンドを実行するか、公式サイトからセットアップファイルをダウンロードして実行します。
Linux
curl -fsSL https://ollama.com/install.sh | shLinuxもシェルスクリプト実行、またはマニュアルインストールに対応しています。
Docker(社内サーバーで動かす場合)
docker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama公式イメージollama/ollamaがDocker Hubで公開されています。GPU搭載サーバーで動かす場合は、NVIDIA Container Toolkit等の追加設定が必要です。
インストール後、以下でバージョンを確認できます。
ollama --versionモデルを取得して動かす(ollama pull/ollama run)
インストールが終わったら、モデルをダウンロードして実行します。基本の流れは「pullでダウンロード → runで起動して対話」の2ステップです。
# モデルをダウンロード
ollama pull gemma4

# モデルを起動して対話開始
ollama run gemma4
ダウンロード済みモデルの一覧確認や、実行中モデルの停止は以下のコマンドで行います。
# ダウンロード済みモデルの一覧
ollama list

# 実行中のモデルを停止
ollama stop gemma4
ollama.com/libraryでは、Gemma 4、Qwen 3.5/3.6、Kimi K2.6/K3、GLM-5.3、DeepSeek V4/V4.1、Mistral Large 3、NVIDIA Nemotron 3など複数のオープンモデルが公開されています(2026年10月3日時点、公式ライブラリと料金ページのモデル一覧で確認)。それぞれ0.8B〜100B超までパラメータサイズの異なるバージョンが用意されており、手元のPCスペックに応じて選択できます。Gemma 4の詳しい性能・使い方はGoogle Gemma 4完全ガイドで解説しています。
GPUが使われない・動作が遅いときの確認ポイント
「Ollamaを入れたのにCPUだけで動いていて遅い」という質問は、AI研修の場でも実際によく出ます。Ollama公式ドキュメント(docs.ollama.com/gpu)によると、対応GPUと確認方法は以下の通りです。
| GPU種別 | 対応条件 | 確認コマンド |
|---|---|---|
| NVIDIA | Compute Capability 5.0以上・ドライバ550以上 | nvidia-smi -L |
| AMD | ROCm v7ドライバ経由(Radeon RX 7000/9000系、Instinct MI100/MI200/MI300系) | rocminfo |
| Apple Silicon | Metal API経由で自動的にGPUアクセラレーションが有効 | 特別な設定不要 |
GPUが認識されない場合、公式ドキュメントでは主に「ドライバのバージョンが古い」「スリープ復帰後にドライバが再読込されていない(NVIDIAの場合はsudo rmmod nvidia_uvm && sudo modprobe nvidia_uvmで対処)」「Vulkanランタイムやドライバが未導入」といった原因が挙げられています。まずはGPUドライバのバージョンを最新にし、上記コマンドでGPUがOSから認識されているかを確認するのが最初の一手です。
Ollama API・SDKで自社ツールから呼び出す方法
Ollamaを起動すると、ローカルの11434番ポートでREST APIが立ち上がります。社内ツールやスクリプトから呼び出す場合はこのAPIを使います。
curl http://localhost:11434/api/chat -d '{
  "model": "gemma4",
  "messages": [
    { "role": "user", "content": "この議事録を3行に要約してください" }
  ]
}'
Python・JavaScript向けの公式ライブラリも提供されており、既存の社内ツールにローカルLLMを組み込む際に利用できます(詳細はGitHub ollama/ollamaのREADME参照)。
決定モデル(Jev型)のAPI /v1/systemone(Ollama 0.35〜)
2026年9月29日の公式ブログによると、Ollama 0.35からTypeSafeのJev APIに準じた「決定モデル」を /v1/systemone エンドポイントで使えます。本文を state として渡し、名前を付けた複数の質問(選択・はい/いいえ・スコア)を1回のリクエストでまとめて答えさせる仕組みで、チケットの振り分け、モデルのルーティング、コンテンツの審査のような速い判断向けです。公開時点のモデルは nimble(Bespoke Labs・9B・オープンソース)、tev1(Together AI・4B・実験的)、tev1:0.8b の3つで、ollama pull nimble で取得できます。公式の例では、M5 MaxのMacBook Proでローカル実行した nimble が1判断あたり平均91ミリ秒でした。追加の費用はかからず、ネットワークを経由しない分だけ遅延が小さいのが利点です。
ollama pull nimble
curl http://localhost:11434/v1/systemone -d '{
  "model": "nimble",
  "state": { "ticket": "二重に課金されました。余分な支払いを返金してください。" },
  "questions": {
    "team": { "type": "choice", "instructions": "どのチームが担当するか",
              "criteria": { "billing": "支払い・返金", "technical": "不具合・連携", "other": "その他" } },
    "refund": { "type": "noul", "instructions": "返金を明示的に求めているか" },
    "urgency": { "type": "score", "instructions": "緊急度", "criteria": ["通常", "早め", "緊急"] }
  }
}'
応答は質問ごとに choice(選択肢と確率・confidence)、noul(0〜1)、score(0〜1と凡例)の形で返ります。Ollamaのクラウド側で動く決定モデルも「近日」とされています。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
Claude CodeをOllamaのローカルモデルで動かす方法
ここが法人利用の観点で最も注目したいポイントです。Ollamaは2026年1月16日にAnthropicのMessages API互換機能を発表しており(Ollama公式ブログ確認)、これによってClaude CodeのリクエストをそのままローカルのOllamaサーバーへ向けることができるようになりました。
最も簡単なセットアップ
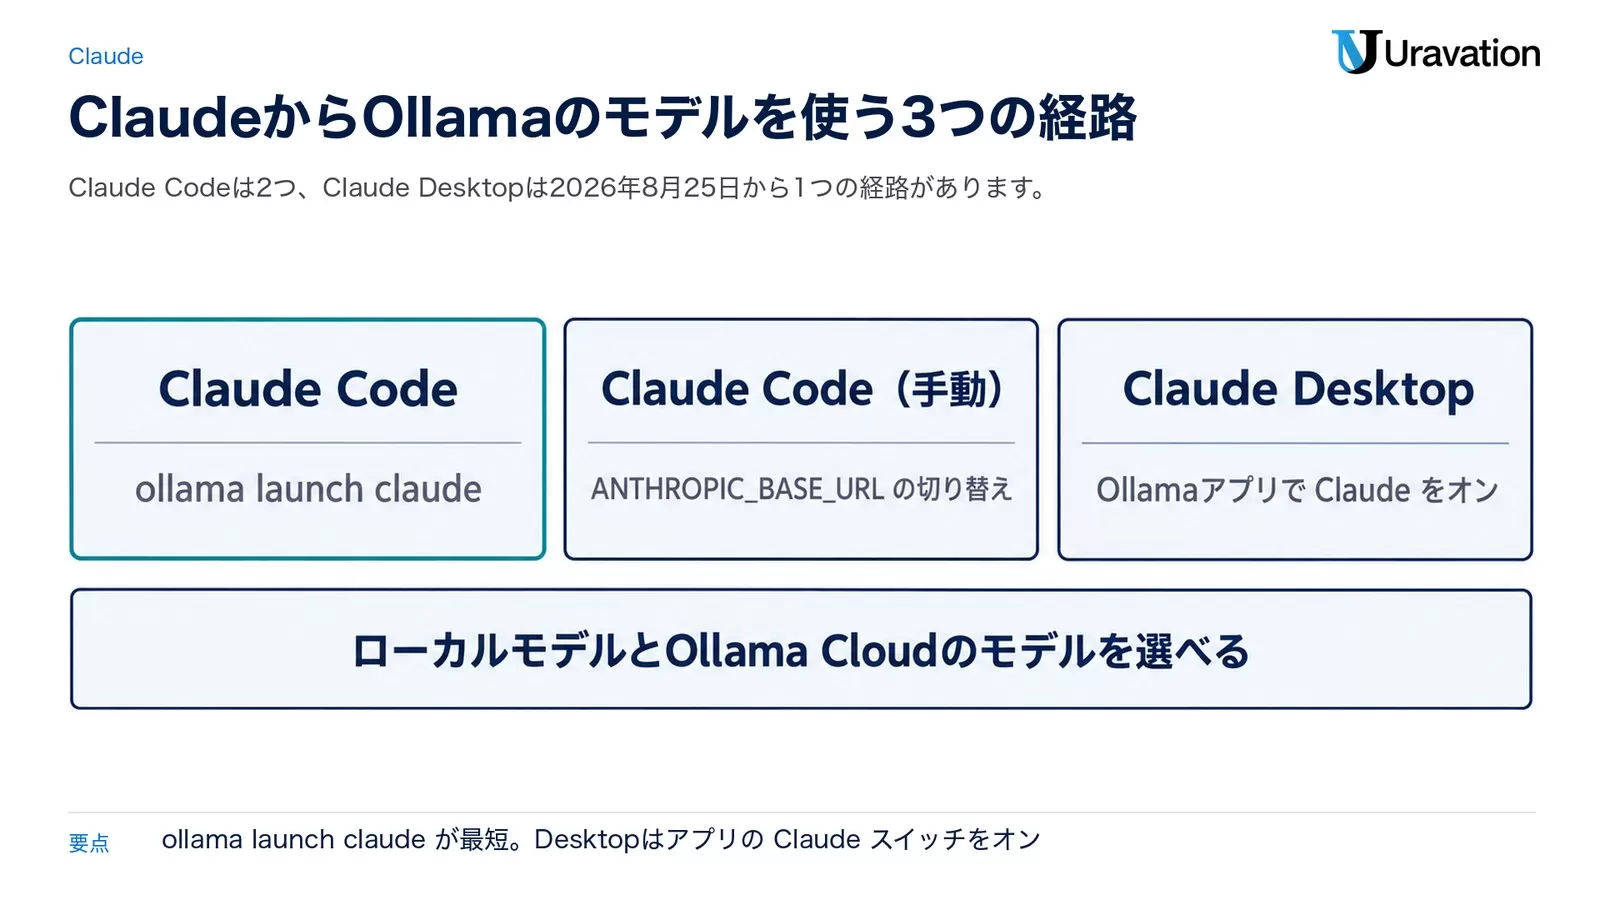
ollama launch claude公式ドキュメント(docs.ollama.com/integrations/claude-code・2026年10月3日確認)によると、このコマンド1つでClaude Codeの起動からローカルモデルへの接続までを自動化できます。同じページは、Claude Code側の機能としてチャット・コマンド実行・ツール呼び出し・ファイル編集・サブエージェント・Web検索・Webフェッチ・画像入力・思考の制御に対応し、ローカルモデルは64k以上のコンテキスト長を設定するよう案内しています。
手動セットアップ(環境変数を明示したい場合)
# 1. Claude Codeをインストール(Mac/Linux)
curl -fsSL https://claude.ai/install.sh | bash

# 2. 環境変数でOllamaサーバーを指定
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434

# 3. Claude Codeを実行(ローカルモデルを指定)
claude --model qwen3.5
公式ドキュメントでは、大規模なリポジトリを扱う場合はコンテキスト長64k以上のローカルモデルを推奨するとしています。非対話モードでの実行例(CI・スクリプト向け)も用意されています。
ollama launch claude --model gemma4:cloud --yes -- -p "このリポジトリの構成を説明して"研修先のエンジニア組織からは「Claude CodeのAPI従量課金が読みづらいので、下読み・軽い調査だけでもローカルに逃がしたい」という相談を受けることが多く、このANTHROPIC_BASE_URLの切り替えは、まさにその要望に対する具体的な答えになります。ただし、ローカルモデルはクラウドのClaude最新モデルと比べて出力精度に差が出ることが多いため、「最終成果物の品質を求める作業はクラウド、機密性の高い一次検証や単純作業はローカル」という使い分けが現実的です。Claude Codeの料金体系そのものはClaude Code料金完全ガイドで解説しています。
MCPサーバーとしてOllamaを活用する
Ollamaはさらに、MCP(Model Context Protocol)サーバーとして組み込むこともできます。Ollama SDKをMCPツールとして公開するサーバー実装(ollama-mcp等)を使うと、Claude DesktopやCline、その他MCP対応アプリケーションから「ローカルモデルを1つのツールとして呼び出す」構成が作れます。たとえば、機密性の高い社内ドキュメントの一次要約だけをローカルモデルに任せ、最終的な意思決定や複雑な推論はクラウドのClaudeに任せる、という役割分担が可能です。
Claude Desktopの接続先にOllamaを設定する(2026年8月25日〜)
2026年8月25日の公式ブログによると、Claude Desktopの「サードパーティゲートウェイ」としてOllamaを設定できるようになりました。Ollamaアプリで Claude を選んでスイッチをオンにするとOllama側がゲートウェイの設定を書き換え、ローカルモデルもOllama Cloudのモデルも Claude Desktop の画面から使えます。オフに戻せば元のAnthropicの設定に戻ります。公式FAQは、テレメトリは既定でオフ、クラウドもローカルもゼロデータリテンション、Anthropicのモデルとの切り替えはOllama側のトグルで行う、と説明しています。ローカルモデルを使う時は設定ページでモデルを指定します。
Claude CodeとMCPサーバーを組み合わせた企業導入の実装パターンはClaude Code×MCP連携完全ガイドで7パターンに分けて解説しています。社内システムとの接続を検討している場合は、あわせてご覧ください。
モデルのライセンスと商用利用で確認すべきこと
注意が必要なのは、Ollama本体のMITライセンスと、Ollama経由でダウンロードする個々のモデルのライセンスは別物だという点です。ollama.com/libraryで配布されているモデルは、モデルごとに異なるライセンス(Apache 2.0、MIT、開発元独自の利用規約など)で提供されています。
Ollama本体を無料・オープンソースで使えるからといって、ダウンロードしたモデルの出力を商用サービスに組み込んでよいかどうかは、モデルごとに個別の確認が必要です。2026年10月3日時点で、各モデルの正確なライセンス条件はollama.com/libraryの各モデルページ、またはHugging Face等の配布元の一次情報でしか確定的に確認できません。本記事では特定モデルのライセンス種別を断定せず、「導入前に必ず配布元の一次情報を確認する」ことを推奨します。ローカル生成AI全般のライセンスの落とし穴については動画生成AIローカル比較|商用利用ライセンスの落とし穴でも同種の注意点を扱っています。
Ollama Cloudの料金プラン
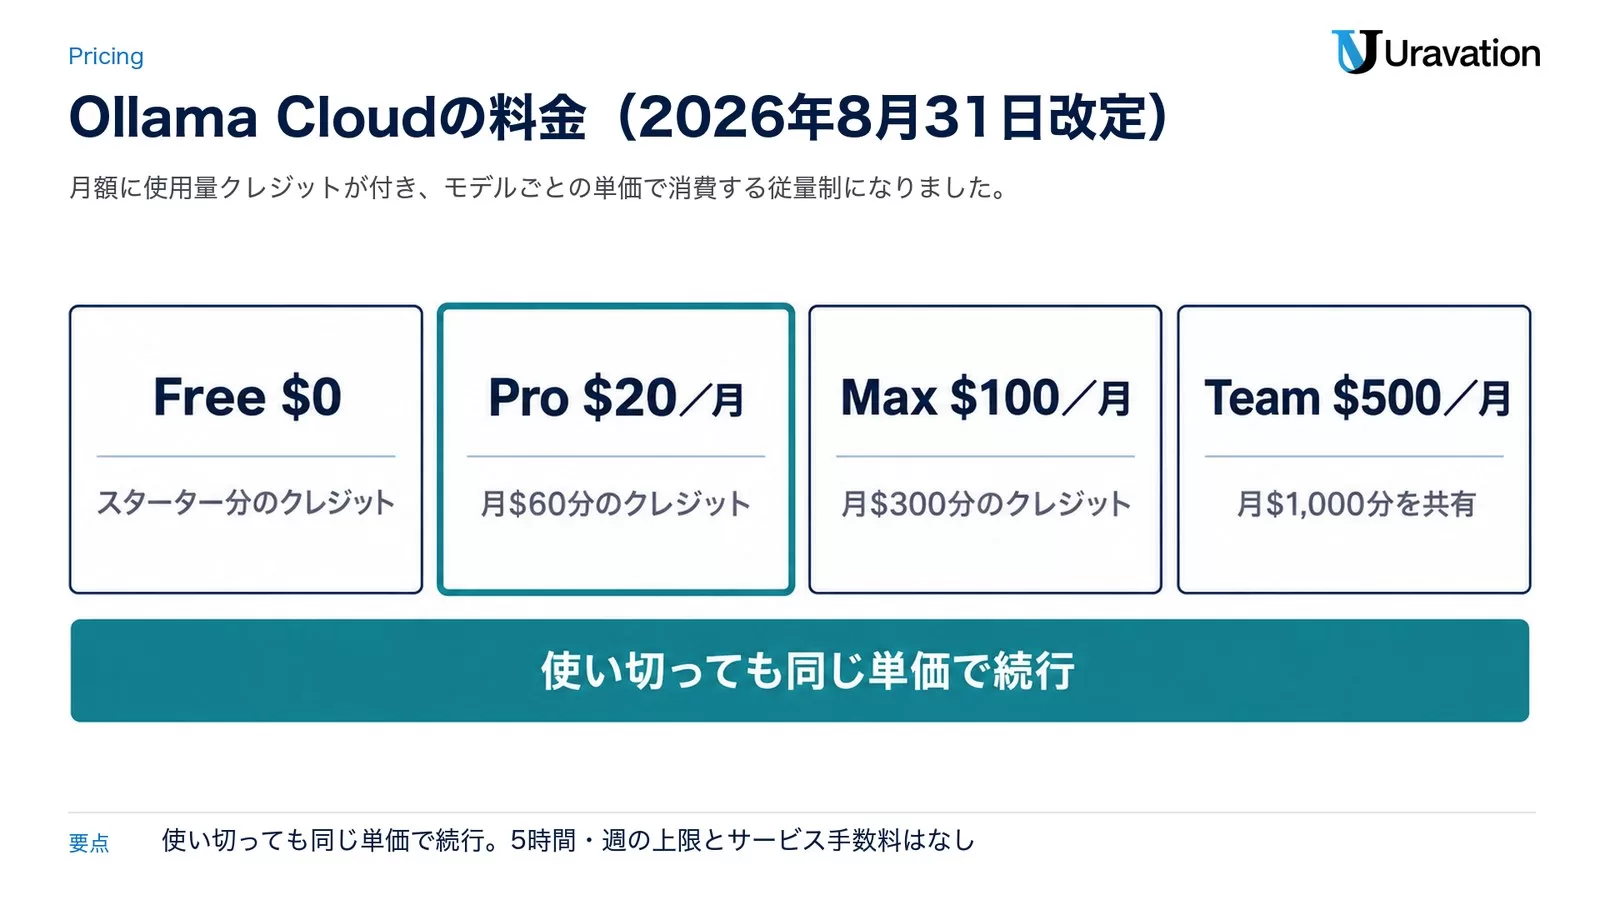
「自社のPCスペックでは大きいモデルが動かせない」場合の選択肢として、Ollamaはクラウド上でモデルを実行する「Ollama Cloud」も提供しています。料金は2026年8月31日に改定され、2026年10月3日時点で公式の料金ページ(ollama.com/pricing)では次のように案内されています(米ドル建て。日本円換算額は為替レートにより変動するため、契約前に公式サイトの最新表示を確認してください)。各プランに月ごとに補充される使用量クレジットが付き、モデルごとに公開された100万トークンあたりの単価で消費する従量制です。
| プラン | 料金 | 内容 |
|---|---|---|
| 無料プラン | $0 | ローカルでのモデル実行+スターターモデル向けの少額の使用量クレジット。クレジットを追加購入すれば全モデルを従量で利用できる(サービス手数料なし) |
| Pro | $20/月(年払い$200) | 月$60分の使用量クレジット、より大きなProモデルへのアクセス、複数モデルの同時実行 |
| Max | $100/月 | 月$300分の使用量クレジット、最新モデルへの早期アクセス、同時10リクエスト |
| Team | $500/月 | ユーザー数無制限、チームで共有する月$1,000分の使用量クレジット、一括請求と管理、優先サポート(早期アクセス) |
| Enterprise | カスタム見積もり | モデルのアクセス制御、ユーザー・APIキーごとの予算設定、専用サポート |
公式ブログ(2026年8月31日)によると、新しいプランにはサービス手数料や5時間・週ごとの上限がなく、月のクレジットを使い切った後も同じ単価で使い続けられます。改定前のPro/Max/Teamの契約はそのまま続き、アカウント設定から新料金へ切り替えられます。処理は米国と欧州の専用の計算資源(一部のQwenモデルはシンガポール)で行い、ゼロデータリテンション(プロンプトを記録しない・学習に使わない)と明記されています。モデル別の単価は料金ページに一覧があり(例: deepseek-v4.1-flash は入力$0.30/出力$1.20、gemma4 は入力$0.14/出力$0.40)、平日12〜18時(UTC)以外と週末はオフピーク単価が適用されます。
法人導入で確認すべき5つのセキュリティ・運用ポイント
Ollama自体はデータを外部に送らずローカルで完結させられるツールですが、「ローカルで動く=何も考えなくてよい」わけではありません。AI研修・導入支援の現場で実際に確認をお願いしているポイントを5つ整理します。
1. 導入するモデルの出所とライセンスを台帳化する
どのモデルを・どのバージョンで・どのライセンスのもとで使っているかを、社内で一覧管理してください。ライセンス条件はモデルの更新で変わることもあるため、定期的な棚卸しが必要です。
2. ネットワーク設計(外部送信の遮断範囲)を明確にする
ローカルモデル自体は外部にデータを送りませんが、Ollama CloudやMCPサーバー経由で他のクラウドサービスと連携する構成にすると、その部分は外部送信が発生します。「どこまでがローカル完結で、どこから外部と通信するか」を図で可視化しておくと、承認プロセスがスムーズになります。
3. Claude Codeとの使い分けルールを明文化する
「機密性の高いリポジトリの一次検証はローカルモデル」「最終成果物や複雑な設計判断はクラウドのClaude」というように、業務の性質ごとに使うモデルを事前にルール化しておくと、現場での判断のばらつきを防げます。Claude Codeのセキュリティ設定全般はClaude Codeセキュリティ設定完全ガイドで7項目のチェックリストとしてまとめています。
4. GPUリソースを含めた運用担当を決める
モデルの更新、GPUドライバの保守、障害時の切り分けを誰が担当するかを事前に決めておかないと、「導入したが誰もメンテしていない」状態に陥りやすくなります。
5. 社員への使い分け教育を行う
ローカルLLMとクラウドAIのどちらを使うべきかの判断は、現場の社員に委ねきりにすると精度がばらつきます。中小企業のAIセキュリティ対策全般は中小企業のAIセキュリティ対策|情報漏洩を防ぐ実践プロンプトでも扱っていますので、社内ルール整備の参考にしてください。
【要注意】よくある失敗パターンと回避策
失敗1:無料だからという理由だけでGPUなしPCに導入してしまう
❌ よくある間違い:「タダで動くらしい」という情報だけでノートPCに入れ、CPUのみで実行して「遅くて使い物にならない」と結論づけてしまう。
⭕ 正しいアプローチ:導入前にモデルの推奨スペック(GPU有無、VRAM容量)を確認し、対応するハードウェアで試す。研修の場でも「まずCPUで試して失望する」というパターンは非常によく見かけます。
失敗2:ローカルモデルにクラウド最新モデルと同じ精度を期待する
❌ よくある間違い:ローカルで動く軽量モデルに、クラウドの最新Claudeと同水準の複雑な推論やコード生成を期待し、「使えない」と判断してしまう。
⭕ 正しいアプローチ:ローカルモデルは「機密性が高い一次検証」「定型的な繰り返しタスク」向けと割り切り、複雑な設計判断や最終成果物はクラウドのClaudeに任せる、という役割分担を最初から前提にする。
失敗3:モデルライセンスを確認せずに商用サービスへ組み込む
❌ よくある間違い:Ollama本体が無料・オープンソースであることをもって、ダウンロードした全モデルが商用利用も自由だと思い込んでしまう。
⭕ 正しいアプローチ:モデルごとにライセンスが異なることを前提に、商用利用前に必ず配布元の一次情報を確認する運用ルールを社内に定める。
失敗4:導入後の運用担当を決めないまま放置する
❌ よくある間違い:PoCまでは盛り上がったものの、モデル更新・GPUドライバ保守の担当が決まらないまま放置され、いつの間にか誰も触らなくなる。
⭕ 正しいアプローチ:導入前に「誰が更新するか」「トラブル時の一次対応は誰か」を決め、前述のチェックリストの一部として運用体制まで含めて計画する。
Ollama vs LM Studio、結局どちらを選ぶべきか
ローカルLLM実行環境としては、Ollamaのほかに「LM Studio」もよく比較対象に挙がります。Ollamaはコマンドライン(CLI)中心でAPI連携がしやすく、サーバーサイドやCI/CDへの組み込み、Claude CodeやMCPとの連携など「エンジニア組織が業務システムに組み込む」用途に向いています。一方でLM Studioはグラフィカルなデスクトップアプリが中心で、コードを書かずにモデルを試したい非エンジニアのユーザーに向いているとされています。どちらを選ぶかは「CLI・API連携を前提にした業務組み込みか」「GUIで手軽に試したいだけか」という用途で判断するとよいでしょう。
よくある質問
Q. Ollamaは無料ですか?
A. Ollama本体(ソフトウェア)はMITライセンスの無料オープンソースです。ローカルのハードウェアでモデルを動かす分には追加課金はありません。無料プランにもスターターモデル向けの少額の使用量クレジットがあり、全てのクラウドモデルを使うにはクレジットの追加購入か、Ollama Cloudの有料プラン(Pro $20/月〜・月$60分のクレジット付き)が要ります(2026年8月31日の料金改定後の内容)。
Q. Ollamaで使えるモデルは?
A. 2026年10月3日時点で、ollama.com/libraryにGemma 4、Qwen 3.5/3.6、Kimi K2.6/K3、GLM-5.3、DeepSeek V4/V4.1、Mistral Large 3、NVIDIA Nemotron 3など複数のオープンモデルが公開されています。パラメータサイズも0.8B〜100B超まで幅広く用意されており、手元のPCスペックに応じて選択できます。
Q. Ollamaは安全ですか?
A. モデルの推論処理自体はローカルで完結し、入力データが外部のクラウドサーバーに送信されることはありません。ただし、Ollama CloudやMCPサーバー経由で外部サービスと連携する構成にした場合は、その部分について別途データの流れを確認する必要があります。
Q. Ollamaでgpuが使われないのはなぜですか?
A. GPUドライバのバージョンが古い、スリープ復帰後にドライバが再読み込みされていない、Vulkanランタイムが未導入といった原因が代表的です。まずnvidia-smi -L(NVIDIA)やrocminfo(AMD)でOS側からGPUが認識されているかを確認してください。
Q. Claude CodeでOllamaのローカルモデルを使うと、精度は落ちますか?
A. ローカルで動く軽量モデルは、クラウドの最新Claudeと比べて複雑な推論やコード生成の精度で劣る場合があります。機密性の高い一次検証や定型的なタスクはローカル、最終的な設計判断や複雑な実装はクラウドのClaude、という使い分けが現実的です。
LOCAL LLM
社外にデータを出せない業務は、ローカルLLM導入支援へ
クラウドAIが使えない業務向けに、オンプレGPUとオープンモデルで社内完結する構成を設計。モデル選定・GPU構成・PoC・閉域内で動くAI社員の構築まで、段階移行の計画込みで伴走します。
まとめ:今日から始める3つのアクション
- 今日やること: 自分のPCにOllamaをインストールし、軽量モデルを1つ
ollama runで動かしてみる - 今週中:
ANTHROPIC_BASE_URLを切り替えてClaude Codeからローカルモデルを呼び出し、社内の機密性が高いリポジトリの一次検証に使えそうか試す - 今月中: 情報システム部門と、ローカルモデルとクラウドAIの使い分けルール(本記事の5つのセキュリティ・運用ポイント)を社内で明文化する
あわせて読みたい:
- ローカルAIとは|企業導入のメリットと判断基準 — ローカルAI全般の仕組みと導入判断のフレームワーク
- Claude Code×MCP連携完全ガイド — サーバー導入7パターンと認可OAuth設定
参考・出典
- Ollama公式サイト — Ollama(参照日: 2026-10-03)
- GitHub – ollama/ollama — Ollama公式リポジトリ(バージョン・ライセンス・READMEを確認、参照日: 2026-10-03)
- GitHub ollama/ollama Releases — 最新バージョンv0.35.1(2026年9月29日リリース、参照日: 2026-10-03)
- Ollama公式ドキュメント:Claude Code連携 — Ollama(参照日: 2026-10-03)
- Ollama公式ドキュメント:GPUサポート — Ollama(参照日: 2026-10-03)
- Ollama料金ページ(Pricing) — Ollama(参照日: 2026-10-03。旧URLの ollama.com/cloud からの転送先)
- Ollama’s transparent pricing — Ollama Blog(公開日: 2026-08-31、参照日: 2026-10-03)
- Claude Desktop support with Ollama — Ollama Blog(公開日: 2026-08-25、参照日: 2026-10-03)
- Ollama now supports Jev-style decision models — Ollama Blog(公開日: 2026-09-29、参照日: 2026-10-03)
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。X(@SuguruKun_ai)フォロワー約10万人。
100社以上の企業向けAI研修・導入支援。著書『AIエージェント仕事術』(SBクリエイティブ)。
SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。
この記事の内容を社内展開する方へ: ローカルLLM 社内導入チェックシート(無料・PDF 32ページ+Excel) をダウンロードできます。