結論: Gemini 3.1 Flash(正式なモデル名はGemini 3.1 Flash-Lite)はGoogleが2026年3月3日にプレビュー公開し、5月7日に正式版へ移行した高速・低コストのAIモデルで(Flash系の最新は2026年9月2日公開のGemini 3.8 Flash・2026年9月6日時点)、GPT-4oを複数のベンチマークで超えつつ、API料金はGemini 3 Flashの半分以下という業界最安級のコスパを実現しています。
この記事の要点:
- Gemini 3.1 Flash-Liteの料金は$0.25/1Mトークン(inputコスト)で、GPT-4oの約1/10以下
- GPQA Diamondで86.9%・MMMU Proで76.8%(公式モデルカード)と、Flash世代ながらフロンティア級の性能
- 1M トークンコンテキスト・マルチモーダル対応で、企業の大量処理バッチに最適
対象読者: AI APIを業務に活用している開発者・DX推進担当者、コスト最適化を検討中の企業担当者
読了後にできること: Gemini 3.1 Flash-Lite のAPIキーを取得して、既存のOpenAI呼び出しをコスト比較できる
「ChatGPT APIを使っているけど、コストがかさんできた…もっと安いモデルはないのかな?」
企業向けAI研修やAPI導入支援の現場で、2026年に入って急増しているのがこの相談です。GPT-4oやClaude Sonnetで構築したシステムが本番稼働し始めると、月のAPI費用が想定の3〜5倍になるケースが後を絶ちません。
そんな中、2026年3月にGoogleがリリースしたのがGemini 3.1 Flashシリーズです。「Flash」という名が示す通り、高速・低コストを極限まで追求しながら、従来の格安モデルとは桁違いの性能を実現しています。100社以上のAI研修・導入支援を通じて様々なモデルを見てきた経験から言うと、「ここまでコスパが良いモデルが出てきたか」と正直驚きました。
この記事では、Gemini 3.1 FlashとFlash-Liteの性能・料金を詳細に解説し、GPT-4oとの比較や、企業でのコスト最適化活用法まで徹底的にまとめます。既存のGeminiシリーズの記事と合わせて読むと、Googleのモデル戦略全体像が見えてきます。
Gemini 3.1 Flashとは? — 2026年3月リリースの最新モデル
📘 関連ガイド:企業の生成AI導入戦略|中小企業向け実践ロードマップ — 業界別アプローチ、ROI計算、補助金活用まで体系的に整理しています。
Gemini 3.1 Flash-Lite(gemini-3.1-flash-lite)はGoogleが2026年3月3日にプレビュー公開し、2026年5月7日に正式版となった、Gemini 3ファミリーの軽量・高速モデルです(Flash系の最新は2026年9月2日公開のGemini 3.8 Flash・2026年9月6日時点)。Gemini 3シリーズは大きく3つのモデルに分かれています。
| モデル | 位置づけ | 特徴 |
|---|---|---|
| Gemini 3 Pro | 最高性能 | 複雑な推論、マルチステップタスク |
| Gemini 3 Flash | バランス型 | Pro級推論をFlash速度で実現 |
| Gemini 3.1 Flash-Lite | コスト最優先 | 業界最安級料金、大量バッチ処理向け |
重要なポイントは、Gemini 3.1 Flash-Liteが「3.1」という世代番号を持つことです。これはGemini 3 Flashのマイナーアップデート版で、コスト効率をさらに突き詰めた設計になっています。
AIエージェントの基礎知識や、AI導入を始める際のモデル選定については、AIエージェント導入完全ガイドで体系的にまとめています。
性能ベンチマーク — GPT-4oを超えた数字の意味
「Flashなのに性能が高い」という点が、今回のGemini 3.1シリーズ最大の驚きです。主要ベンチマークの結果を見てみましょう。
主要ベンチマーク比較表
| ベンチマーク | Gemini 3.1 Flash-Lite | Gemini 3 Flash | GPT-4o |
|---|---|---|---|
| GPQA Diamond(PhD科学) | 86.9% | 90.4% | 53.1%(gpt-4o-2024-08-06・OpenAI simple-evals) |
| MMMU Pro(マルチモーダル推論) | 76.8% | 81.2% | 公式値の公表なし |
| 処理速度(tokens/sec) | 381 | — | ~80-120 |
GPQA Diamond(大学院レベルの科学問題を解くベンチマーク)でGPT-4oを10ポイント以上上回っているのは、Flashクラスのモデルとしては異例です。さらに処理速度は381 tokens/secと、GPT-4oの3〜4倍の速さです(参照日: 2026-03-24)。
100社以上のAI研修・コンサル経験から見ると、ベンチマークスコアが10ポイント差になると、実業務での回答品質に明確な違いが出始めます。特に「資料の要約精度」「多段階の論理推論を要する回答」で差が大きくなる傾向です。
Gemini 3 Flash vs 3.1 Flash-Lite の選び分け
同じFlashシリーズでも、用途によって選択が変わります。
- Gemini 3 Flash: 高い推論精度が必要なタスク(契約書レビュー、複雑なデータ分析)
- Gemini 3.1 Flash-Lite: 大量バッチ処理、定型文生成、コスト最優先のプロジェクト
Flash-Liteの処理速度(381 tokens/sec)はFlash比で2.5倍高速で、Time to First Token も2.5倍短縮されています。大量のメール返信自動化や、数千件の商品説明文生成のような用途では、Flash-Liteの優位性が際立ちます。
【2026年9月更新】Flash-Lite料金の現行公式値
2026年9月6日に公式料金ページを再確認したところ、Gemini 3.1 Flash-Liteは入力$0.25/出力$1.50(1Mトークンあたり)のままで、下表の料金は現行値と一致しています(公式の廃止予定表での最短シャットダウン日は2027年5月7日)。その後の追加モデルとして、Gemini 3.5 Flash-Lite(入力$0.30/出力$2.50)と、Gemini 3.8/3.7/3.6 Flash(いずれも入力$0.75/出力$3.75・2026年12月31日までの価格、2027年1月1日から$1.50/$7.50。3.8 Flashは2026年9月2日公開)が登場しています。なおPro系の現行はGemini 3.1 Pro Preview(入力$2.00/出力$12.00・20万トークン以下時)で、下表のGemini 3 Pro($2.00/$8.00)から改定されています。出典: Gemini API料金(公式) / Gemini APIモデル廃止予定(公式)
API料金徹底比較 — 業界最安級の実力
Gemini 3.1 Flashシリーズの最大の武器はコストです。主要モデルの料金を比較してみましょう。
2026年3月時点のAPI料金比較(1Mトークンあたり)
| モデル | Input料金 | Output料金 | 特記 |
|---|---|---|---|
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | 業界最安級 |
| Gemini 3 Flash | $0.50 | $3.00 | Flash-Liteの2倍 |
| Gemini 3 Pro | $2.00 | $8.00 | 最高性能 |
| GPT-4o | $2.50 | $10.00 | OpenAI主力モデル |
| Claude Sonnet 4.6 | $3.00 | $15.00 | Anthropic主力 |
(出典: Google AI for Developers 公式料金ページ・各社公式サイト、参照日: 2026-03-24)
Gemini 3.1 Flash-LiteのInput料金($0.25/1M)は、GPT-4o($2.50/1M)の1/10です。Output料金も$1.50 vs $10.00で同じく1/10以下です。
月間1億トークンを処理する企業の場合、GPT-4oからGemini 3.1 Flash-Liteに切り替えると月額コストが以下のように変わります:
試算例(月間1億トークン処理、Input/Output比率6:4)
GPT-4o: $0.0000025×60M + $0.00001×40M = $150 + $400 = $550/月
Gemini 3.1 Flash-Lite: $0.00000025×60M + $0.0000015×40M = $15 + $60 = $75/月
コスト削減率: 約86%削減
ただし、これはモデルの料金のみの比較です。実際の移行時にはAPI仕様の違い、プロンプト調整工数、品質検証コストも発生します。後述の「移行時の注意点」を参照してください。
Gemini 3.1 Flashの主要機能
1Mトークンコンテキストウィンドウ
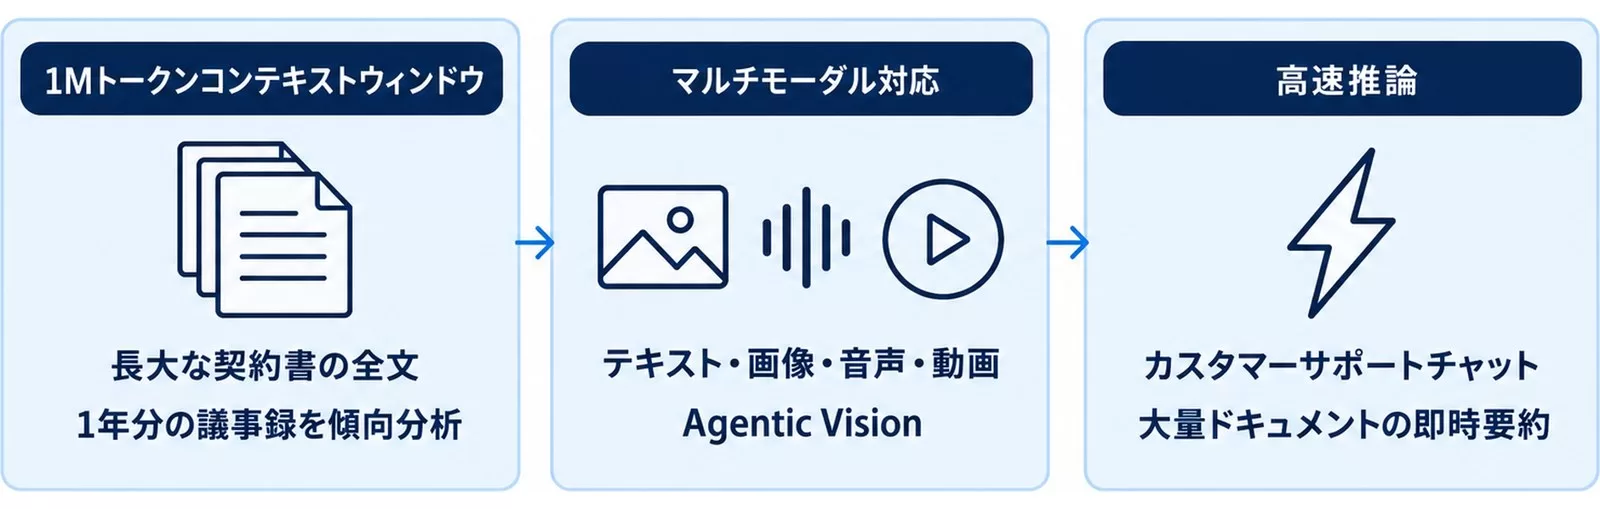
Gemini 3シリーズ共通の特徴として、100万トークンのコンテキストウィンドウがあります。これは日本語で約80万文字(文庫本約5〜6冊分)に相当します。
企業での活用例としては「長大な契約書の全文を一度に送って矛盾箇所を検出する」「1年分の議事録を渡して傾向分析する」といったユースケースが実用的です。GPT-4oの128Kトークン(日本語約10万文字)と比べて8倍弱の差があります。
マルチモーダル対応
テキスト・画像・音声・動画を横断した推論が可能です。特に「Agentic Vision」機能は、画像を見ながらコードを実行して検証するユニークな機能です。たとえば「この棚の在庫写真を分析して、在庫が少ない商品をリストアップして」といった指示を自律的に実行できます。
高速推論(Flash-Lite: 381 tokens/sec)
Gemini 3.1 Flash-LiteはGoogle APIで381 tokens/secを記録しています(Artificial Analysis調べ、2026年3月)。これはGPT-4oの約3〜4倍の速さです。リアルタイム性が求められるカスタマーサポートチャットや、大量ドキュメントの即時要約処理に適しています。AIモデルの外部ツール接続についてはMCP(Model Context Protocol)の活用も注目されています。詳しくはMCP入門ガイドをご覧ください。
企業でのコスト最適化活用法
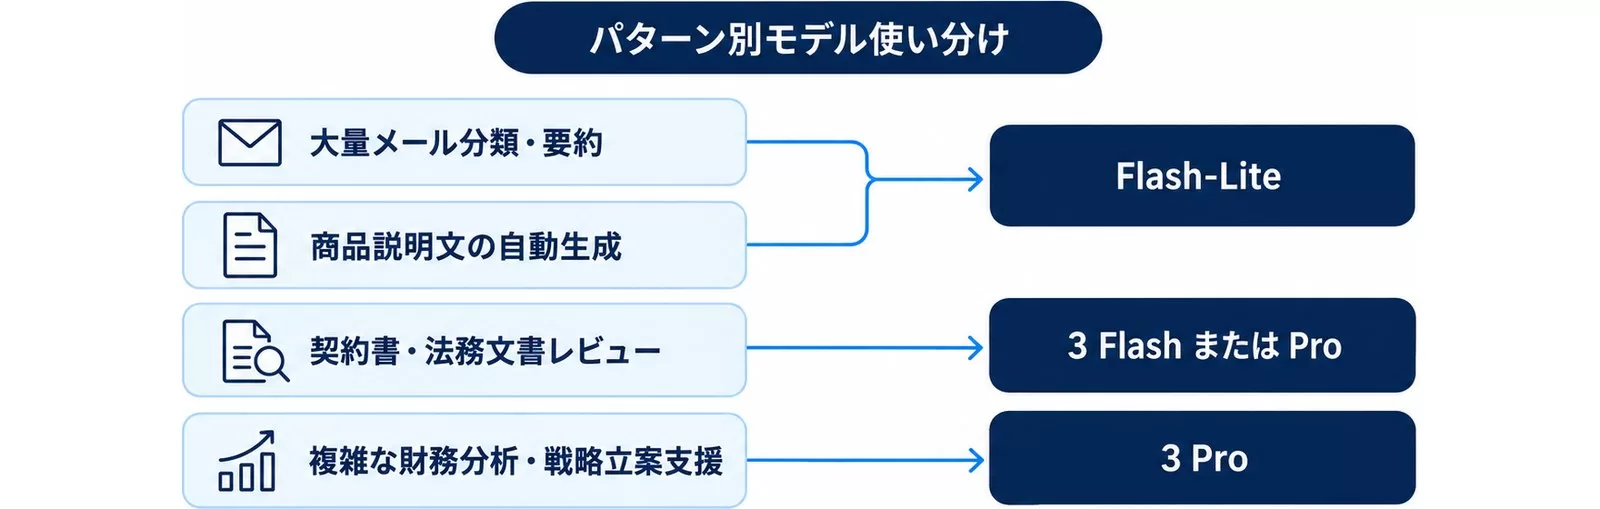
パターン別モデル使い分け戦略
すべてのAPI呼び出しをFlash-Liteに切り替えるのは得策ではありません。タスクの重要度と複雑さに応じてモデルを使い分けるのが現実的なコスト最適化策です。
| タスク種別 | 推奨モデル | 理由 |
|---|---|---|
| 大量メール分類・要約 | Flash-Lite | 定型処理、精度よりコスト |
| 商品説明文の自動生成(千件規模) | Flash-Lite | バッチ処理、高速化も重要 |
| 契約書・法務文書レビュー | 3 Flash または Pro | 高精度推論が必要 |
| 複雑な財務分析・戦略立案支援 | 3 Pro | 誤りのコストが高い |
実際の活用例として、ある流通業の企業では商品データベースの説明文(約15,000件)を月次で更新していましたが、GPT-4oからFlash-Liteに切り替えたことで月間APIコストを約80%削減しつつ、品質は人手チェックで変わらないと評価されました(想定シナリオ — 100社以上の研修経験をもとに構成)。
事例区分: 想定シナリオ
以下は100社以上の研修・コンサル経験をもとに構成した典型的なシナリオです。
Gemini API活用のコピペ可能コード
Gemini 3.1 Flash-Liteの呼び出し例です。今日すぐ試せます。
import google.generativeai as genai

# APIキーはAIStudioで無料取得可能
genai.configure(api_key="YOUR_API_KEY")

model = genai.GenerativeModel("gemini-3.1-flash-lite")  # preview版IDは2026年5月25日に提供終了(2026年9月6日時点の正式版ID)

response = model.generate_content(
    "以下のメールを3行で要約してください:nn[メール本文をここに貼り付け]",
    generation_config={"temperature": 0.2}
)

print(response.text)

# 不足している情報があれば、最初に質問してから作業を開始してください。
既存のOpenAI Python SDK利用者向けに、最小限の変更でGeminiに切り替えるコードも示しておきます。
# OpenAI互換エンドポイント(Vertex AI経由)での切り替え例
from openai import OpenAI

client = OpenAI(
    base_url="https://generativelanguage.googleapis.com/v1beta/openai/",
    api_key="YOUR_GEMINI_API_KEY"
)

response = client.chat.completions.create(
    model="gemini-3.1-flash-lite",
    messages=[{"role": "user", "content": "こんにちは。今日のタスクを整理してください。"}]
)

# 仮定した点は必ず"仮定"と明記してください。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
Gemini 3.1 Flash vs Gemini 2.5 Flash — 前世代との違い
「Gemini 3.1 FlashはGemini 2.5 Flashと何が違うのか?」という質問は非常によく受けます。Googleのモデル体系はバージョン番号が複雑で混乱しやすいので、整理しておきます。
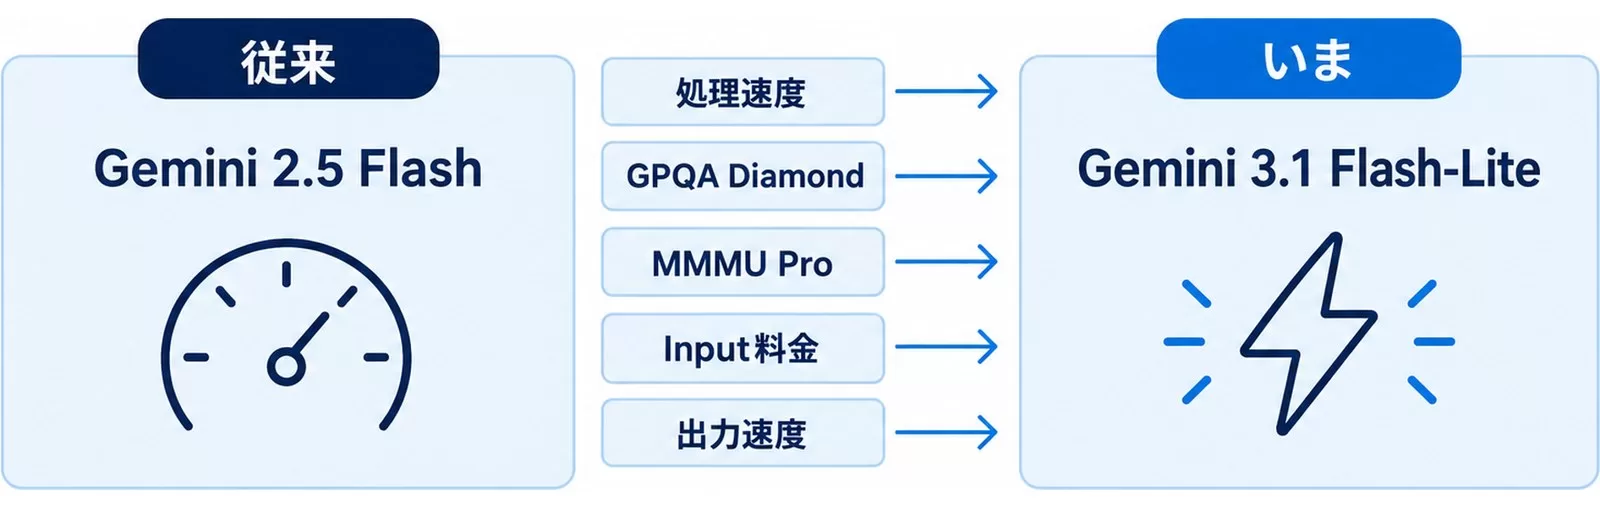
世代間の主要な変化点
| 比較項目 | Gemini 2.5 Flash | Gemini 3.1 Flash-Lite |
|---|---|---|
| リリース時期 | 2025年4月 | 2026年3月3日 |
| 処理速度 | ベースライン | 2.5倍高速 |
| GPQA Diamond | 82.8%(2.5 Flash Dynamic) | 86.9% |
| MMMU Pro | 66.7%(2.5 Flash Dynamic) | 76.8% |
| Input料金 | $0.15/1M(Short), $0.375/1M(Long) | $0.25/1M(統一) |
| 出力速度 | ベースライン | 45%向上 |
Gemini 3.1 Flash-Liteは2.5 Flashと料金が近い水準ながら、性能と速度が大幅に向上しています。もし現在2.5 Flashを使用しているシステムがあれば、3.1 Flash-Liteへの移行を検討する価値があります。
なお、3.1 Flash-Liteは2026年5月7日に正式版(モデルID:gemini-3.1-flash-lite)となり、プレビュー版(gemini-3.1-flash-lite-preview)は2026年5月25日に提供終了しました(公式の廃止予定表・2026年9月6日時点)。プレビューIDのままのコードは動かないため、正式版IDへ切り替えてください。正式版の提供終了予定日は2027年5月7日で、後継はGemini 3.5 Flash-Liteです。
他のGeminiモデル・GPT-4oとの総合比較
用途別おすすめ早見表
| 用途 | 最適モデル | 理由 |
|---|---|---|
| API費用を最小化したい | Gemini 3.1 Flash-Lite | 業界最安級。Flash世代最高速 |
| バランス型(性能×コスト) | Gemini 3 Flash | Pro级推論をFlash速度・料金で |
| 最高精度が必要 | Gemini 3.1 Pro Preview | GPQA Diamond 94.3%、複雑推論(3 Pro Previewは2026年3月9日に提供終了) |
| エコシステム優先(Plugins等) | GPT-4o | OpenAIの豊富なプラグイン・ツール連携 |
| 長文・コード品質優先 | Claude Sonnet/Opus | SWE-benchで高スコア |
【要注意】Gemini 3.1 Flash移行時の落とし穴と回避策
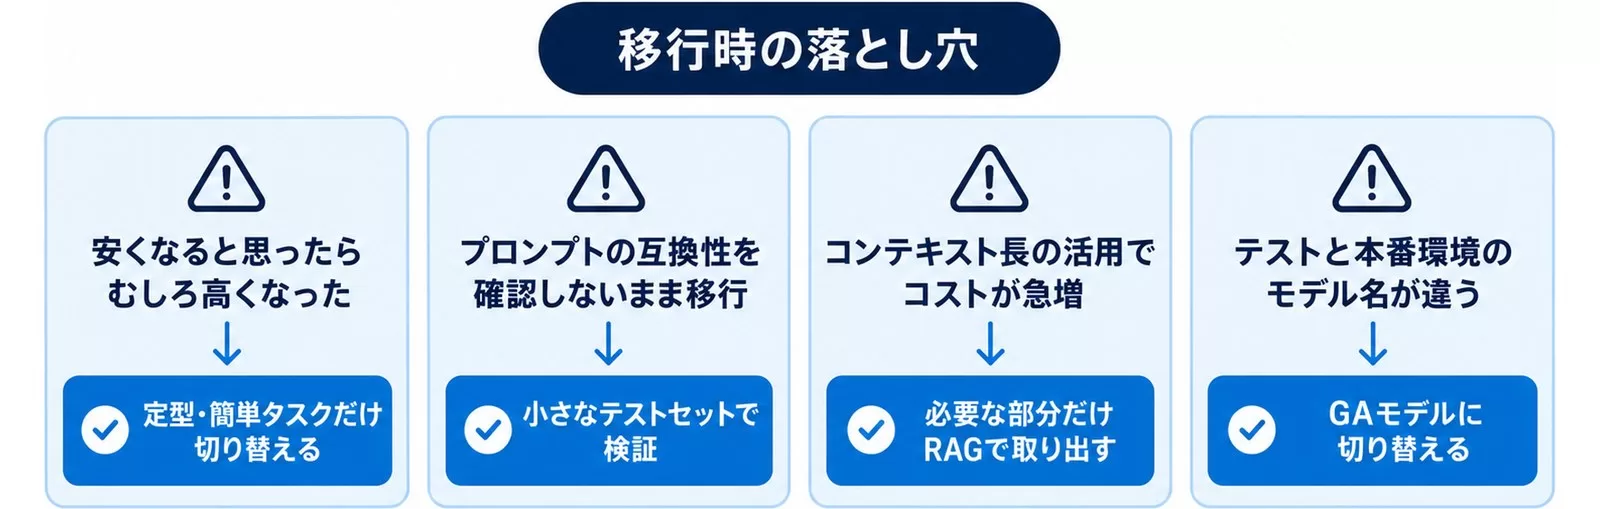
落とし穴1: 安くなると思ったらむしろ高くなった
❌ 「とりあえずFlash-Liteに全替えしたら、精度が落ちてリトライが増え、トークン消費が3倍になった」
⭕ タスクを分類し、定型・簡単タスクだけFlash-Liteに切り替える。複雑タスクはFlashまたはProを維持する。
なぜ重要か: 安いモデルでの品質低下がリトライやエラー処理コストを増加させると、トータルコストが逆転するケースがあります。
落とし穴2: プロンプトの互換性を確認しないまま移行した
❌ GPT-4o用に最適化したプロンプトをそのままGemini APIに貼った
⭕ Gemini APIはシステムプロンプトの書き方が異なる。`system_instruction`パラメータを使い、小さなテストセットで出力を検証してから本番投入する。
なぜ重要か: モデル間でのプロンプト移行には、必ず検証フェーズが必要です。
落とし穴3: コンテキスト長の活用でコストが急増
❌ 「1Mトークンあるから全部入れていいや」と長大なコンテキストを毎回送信した
⭕ 1Mトークンのコンテキストを毎回使うとコストは比例して増加する。必要な部分だけRAGで取り出すか、キャッシュAPIを活用する。
なぜ重要か: Flash-Liteでも1M全部使えば100万トークン×料金がかかります。コンテキスト長は「必要な時に使える」保険と位置づける。
落とし穴4: Google AI Studioでのテストと本番環境のモデル名が違う
❌ AI Studioで動いたから本番に投入したら「モデルが見つからない」エラー
⭕ プレビューモデルは`-preview`サフィックスが付く。本番GA版はサフィックスなし。リリースノートを確認し、GAモデルに切り替えるタイミングを把握しておく。
日本企業への影響 — コスト革命の現実
Gemini 3.1 Flash-Liteのリリースは、日本の中小企業のAI活用コストに大きな影響を与えます。これまで「API費用が高すぎて本番稼働に踏み切れない」という声が多かった中小企業にとって、GPT-4o比で1/10のコストは非常に大きな差です。
具体的に影響が大きい業種として、以下が挙げられます。
- EC・小売業: 商品説明文・SEOコンテンツの大量自動生成
- 人材・採用業: 求人票の自動作成、応募書類スクリーニング
- カスタマーサービス: FAQへの自動回答生成、問い合わせトリアージ
- 製造・物流: 作業マニュアルの多言語自動翻訳
一方、医療・法務・金融など誤答コストが高い分野では、依然としてFlash-Liteの単独活用は慎重にすべきです。必ず上位モデルとのアンサンブルや、人間レビューフローを組み合わせることをおすすめします。
Gemini 3.1 Pro(より高性能な上位モデル)の詳細については、Gemini 3.1 Pro完全ガイドも参照してください。
企業がとるべきアクション
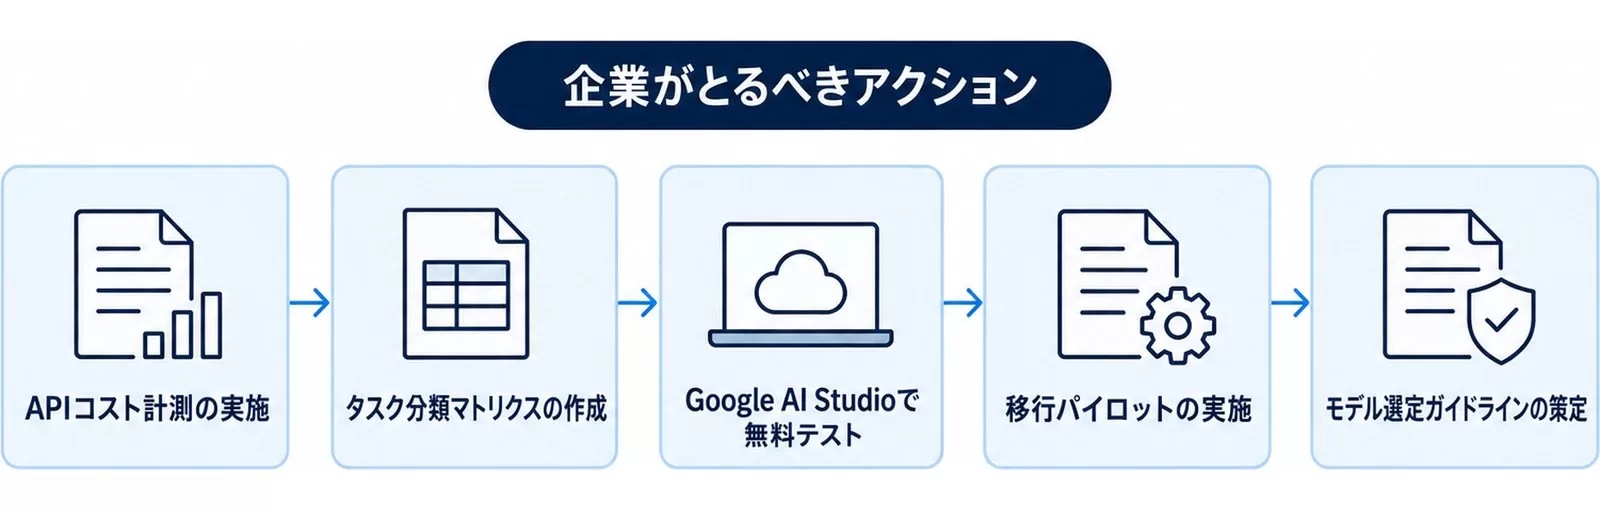
- APIコスト計測の実施: 現在使用中のモデルの月間トークン使用量を計測し、Flash-Liteへの移行でどれだけコスト削減できるか試算する
- タスク分類マトリクスの作成: 「定型・大量処理」と「複雑・高精度」に分類し、前者のみFlash-Liteに切り替えるロードマップを策定する
- Google AI Studioで無料テスト: Flash-Liteはプレビュー期間中、一定量の無料枠あり。既存プロンプトの互換性を無料で検証できる
- 移行パイロットの実施: 1つの非クリティカルな業務プロセスで1ヶ月間パイロット運用し、品質・コスト・速度を評価する
- モデル選定ガイドラインの策定: 「このタスクにはこのモデル」という社内基準を整備し、開発者がバラバラに高コストモデルを使うのを防ぐ
Gemini API活用の実践的なヒント
Google AI Studioで無料テストする方法
Gemini APIを試すにはまずGoogle AI Studio(aistudio.google.com)にアクセスし、Googleアカウントでログインするだけです。APIキーの発行も数クリックで完了します。2026年3月時点でFlash-Liteは一定量のリクエストが無料で利用でき、プロトタイプ検証のコストがゼロになっています。
研修先でAPIを初めて触る担当者に「まずAI Studioで遊んでみてください」と勧めると、多くの方が「こんなに簡単に使えるとは思わなかった」と驚かれます。OpenAI APIのようにクレジットカードを入力する前から動作確認ができるのは、Gemini APIの大きなアドバンテージです。
既存のOpenAI実装からの移行チェックリスト
GPT-4oからGemini Flash-Liteに移行する際、最低限確認すべき5項目を整理しておきます。
- システムプロンプトの書き方の違い(`system_instruction`パラメータを使用)
- レスポンス形式の違い(`.choices[0].message.content` → `.text`)
- ストリーミングAPIのインターフェース差異
- 関数呼び出し(Function Calling)の記法の違い
- エラーコードとリトライ設計(503エラーはFlash-Proで発生しやすい)
OpenAI互換エンドポイント(`/v1beta/openai/`)を使えば既存コードの変更量を最小化できますが、Gemini固有の機能(Agentic Vision、グラウンディング)はネイティブSDKを使う方が活用しやすいです。移行の段階に応じて使い分けることをおすすめします。
Gemini 3.1 Flashのリリースノートと今後のロードマップ
Gemini 3.1 Flashのリリースノートとは、Googleが公式に発表するモデルのアップデート履歴・変更点・既知の制限事項をまとめた技術文書です。API利用者が安定運用するために必ず確認すべきドキュメントです。
| 日付 | バージョン | 主な変更点 |
|---|---|---|
| 2025年12月17日 | 3 Flash | プレビュー公開(gemini-3-flash-preview)。GPQA Diamond 90.4%。2026年9月6日時点でも正式版は未提供で、公式の移行先はGemini 3.6 Flash |
| 2026年3月3日 | 3.1 Flash-Lite Preview | 初回リリース。381 tokens/sec、$0.25/1M input |
| 2026年5月7日 | 3.1 Flash-Lite(正式版) | 正式版ID gemini-3.1-flash-lite を公開。プレビューIDは2026年5月25日に提供終了。正式版の提供終了予定日は2027年5月7日(後継はGemini 3.5 Flash-Lite) |
3.1 Flash-Liteのプレビュー期間は約2か月で、2026年5月7日に正式版(gemini-3.1-flash-lite)が公開され、-preview付きのモデルIDは5月25日に提供終了しました(2026年9月6日時点)。本番システムは正式版IDへ切り替えてください。リリースノートはGoogle AI for Developersの公式モデルページで確認できます。
料金はいくら?他モデルとの価格比較
Gemini 3.1 Flash-Liteの料金体系は、AI API業界の中でも際立って低コストです。
| モデル | 入力(100万トークン) | 出力(100万トークン) | コンテキスト窓 |
|---|---|---|---|
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | 100万トークン |
| GPT-5.6 Terra(gpt-5.6-terra) | $2.00 | $12.00 | 105万トークン |
| GPT-5 Mini(gpt-5-mini・2025-08-07版は2026年12月11日に提供終了予定) | $0.25 | $2.00 | 40万トークン |
| Gemini 3.1 Pro Preview | $2.00 | $12.00 | 100万トークン(20万トークン超は$4.00/$18.00) |
| Claude Opus 4.6(Opus 5も同額) | $5.00 | $25.00 | 100万トークン |
| DeepSeek V4 Flash(2026年7月31日版) | $0.22〜$0.44(時間帯別・キャッシュ未命中) | $0.66〜$1.32(時間帯別) | 100万トークン |
GPT-5.6 Terra(入力$2.00/出力$12.00・2026年9月6日時点の公式料金)と比較すると、入力コストも出力コストも8分の1です。企業が月間に入力10億トークン・出力10億トークンを処理する場合、GPT-5.6 Terraでは約$14,000かかるところ、Flash-Liteなら約$1,750で済みます。年間で約$147,000(1ドル150円換算で約2,200万円)のコスト削減が可能です。
DeepSeekは2026年9月6日時点で公式料金ページの現行モデルがV4 Flash/V4 Proに切り替わり、いずれも100万トークンのコンテキスト窓を持ちます。V4 Flashの料金水準はFlash-Liteとほぼ同等ですが、平日のピーク時間帯(UTC 1〜4時と6〜10時=日本時間10〜13時と15〜19時)は料金が2倍になる時間帯別課金です。日本の業務時間帯に集中して使う場合は、時間帯によらず固定料金のFlash-Liteの方がコストを見積もりやすくなります。
なお、Google AI StudioとVertex AIの両方から利用でき、Vertex AIではBatch APIによるさらに50%の割引も適用可能です。
Gemini 3 Flash / 3.1 Flash よくある質問(FAQ)
Q1. Gemini 3 Flash と Gemini 3.1 Flash はどう違いますか?
A. 2026年9月6日時点の公式モデル一覧に「Gemini 3.1 Flash」というテキストモデルはなく、3.1世代のFlash系はGemini 3.1 Flash-Lite(gemini-3.1-flash-lite)です。3.1 Flash-Liteは3 Flash(gemini-3-flash-preview・入力$0.50/出力$3.00)の半額(入力$0.25/出力$1.50)で、公式ベンチマークではGPQA Diamond 86.9%(3 Flashは90.4%)と精度は一段下です。3 Flashの後継として公式に案内されているのはGemini 3.6 Flashで、その後3.7/3.8 Flash(入力$0.75/出力$3.75・2026年内の価格)も公開済みです。新規プロジェクトはコスト最優先なら3.1 Flash-Lite、精度も欲しいなら3.8 Flashと考えて問題ありません。ただし、本番運用中の API 呼び出しでモデル名を gemini-3-flash で明示している場合は、3.1 Flash への切り替え時に動作差を必ず検証してください。
Q2. Gemini 3 Flash と Flash-Lite / Pro の使い分けは?
A. 「速度・コスト重視 = Flash-Lite」「バランス = Flash」「品質重視・長尺推論 = Pro」が基本判断です。本記事の「Gemini 3.1 Flash vs Gemini 2.5 Flash」セクションと「他のGeminiモデル・GPT-4oとの総合比較」セクションで詳細な数値比較を載せています。具体的には Flash-Lite は数十円/1Mトークン、Pro はその数倍〜10倍の料金差です。
Q3. 無料で試すには?
A. Google AI Studio(aistudio.google.com)で無料試用枠があります。本格運用前に「自社の代表的なプロンプト」を 5-10 本投げて、応答品質・速度・コストを実測してから API 統合するのが推奨フローです。研修現場でも、「いきなり本番API契約」より「AI Studio で2週間試してから判断」した企業の方が、選定ミスが圧倒的に少ないです。
Q4. 日本語性能は GPT-4o / Claude と比べてどうですか?
A. 2026年5月時点では Gemini 3.1 Flash は日本語実用レベルです。特に「業務文書の要約」「Excel/CSV データの分析」「日常会話の応答」では GPT-4o mini や Claude Haiku 4.5 と互角〜やや有利(Claude 3.5 Haikuは2026年2月19日にAPI提供終了)。一方、「高度なクリエイティブライティング」や「複雑なロジック推論」では Gemini 3 Pro / Claude Sonnet / GPT-5 系に劣ります。コストパフォーマンスでは現状トップクラスです。
Q5. 中小企業が今すぐ採用すべきユースケースは?
A. ①カスタマー問い合わせの一次返信生成(速度が速いのでチャット応答に最適)、②営業日報・議事録の要約バッチ(コスト最安級で大量処理OK)、③商品説明文の多言語化の3つが現実的な入口です。Uravation の AI導入戦略ガイドでも、Flash 系モデルは「業務オペレーション系の効率化」での費用対効果が最も高いと整理しています。
まとめ:今日から始める3つのアクション
- 今日やること: Google AI StudioでGemini 3.1 Flash-Liteを無料テスト。現在使っているプロンプトを1つ貼り付けて出力品質を確認する
- 今週中: 自社システムの月間APIトークン使用量を調べ、Flash-Liteへの移行でのコスト削減額を試算する
- 今月中: 非クリティカルな1業務をFlash-Liteで試験運用し、コスト・品質・速度を評価してモデル選定ガイドラインを作成する
関連メディア
参考・出典
- Gemini 3.1 Flash Lite: Our most cost-effective AI model yet — Google Blog(参照日: 2026-03-24)
- Introducing Gemini 3 Flash: Benchmarks, global availability — Google Blog(参照日: 2026-03-24)
- Gemini Developer API pricing — Google AI for Developers(参照日: 2026-03-24)
- Gemini 3.1 Flash-Lite Preview — Intelligence, Performance & Price Analysis — Artificial Analysis(参照日: 2026-03-24)
- Google releases Gemini 3.1 Flash Lite at 1/8th the cost of Pro — VentureBeat(参照日: 2026-03-24)
関連記事
あわせて読みたい
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。早稲田大学法学部在学中に生成AIの可能性に魅了され、X(旧Twitter)で活用法を発信(@SuguruKun_ai、フォロワー約10万人)。100社以上の企業向けAI研修・導入支援を展開。著書『AIエージェント仕事術』(SBクリエイティブ)。SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談はお問い合わせフォームからお気軽にどうぞ。
📌 関連サービス
Gemini 3.1 Flash の社内活用、Uravationが伴走支援します
Gemini 3.1 Flashを業務で本格活用したいが、社内ガバナンスや人材育成で悩んでいませんか。Uravationは中小企業〜大企業向けに、Geminiを含む主要AIツールの導入・研修・運用支援を一貫提供しています。
- ✅ 100社以上の企業向けAI研修・導入支援実績
- ✅ Claude Code・Codex・ChatGPTの実務導入支援
- ✅ AI顧問・伴走支援(月次運用・KPI設計)
この記事の内容を社内展開する方へ: 生成AI 料金・プラン早見表 2026年10月版(無料・PDF 35ページ+Excel) をダウンロードできます。