結論: AIエージェントのMemory(記憶)層は、Mem0(OSS最大、66K stars、軽量bolt-on)/Zep(本番向け、ベクトル+グラフのハイブリッド、エンティティ抽出)/Letta(旧MemGPT、OS型階層メモリ、エージェント自体がランタイム上で動く)の3強から選ぶのが2026年の標準です。「Core / Archival / Recall」の3層モデルと「User / Session / Agent」スコープの2軸で設計し、毎セッション忘却するChatGPT素のAPIから卒業して、長期的に成長するAIエージェントを構築できます。Claude Code・OpenAI Agents SDK・LangGraph・CrewAIすべてに対応しており、選んだメモリ基盤を全プラットフォームから共有できます。
この記事の要点:
- Memory階層モデル: Core / Archival / Recall の3層 × User / Session / Agent スコープ
- Mem0 / Zep / Letta の3強比較表(料金・OSS/SaaS・自己編集機能の有無)
- 「session memory」と「long-term memory」の使い分け実装(Python実装コード付き)
- RAG(検索拡張生成)とMemoryの違いと、両者を組み合わせる本番設計
- Mem0でClaude Code・ChatGPT・Cursorのエージェントに永続記憶を追加する3ステップ
- 本番運用の落とし穴4選(PII漏洩・状態の食い違い・コスト爆発・忘却タイミング)
対象読者: AIエージェントを業務に導入しているMLエンジニア・DevOpsエンジニア/チャットボット・カスタマーサポートで「ユーザーごとに会話を覚えてほしい」要件を抱えるPM/LangGraph・CrewAI・AutoGenで長時間動くエージェントを設計中の開発者/企業向けAI顧問・社内アシスタントで「組織知」を構築したい情報システム責任者
「ChatGPTって、毎回最初から自己紹介し直さないといけないの不便ですよね…」
先日、ある顧問先(従業員200名のコンサルティング企業)の社内AIアシスタント担当者から、こんな相談を受けました。社内向けにChatGPTを使った業務アシスタントを作ったのですが、ユーザーが「先週のあの案件の続きで…」と聞いても、AIが全く覚えていない。毎回、案件名・関係者・経緯を最初から説明させられる体験が苦痛で、利用率が3週間で半分以下に落ちていたんです。
この経験から気づいたのは、「2026年のAIエージェントは、Memory層を最初から設計しないと”使い物にならない”」ということです。100社以上の研修・顧問先で見てきた感覚として、Memory層を入れているチームと入れていないチームでは、ユーザーの継続利用率が3〜5倍違います。本物の業務アシスタントは、毎回ゼロから説明し直す相手ではなく、組織の文脈を覚えている同僚であるべきです。
この記事では、Mem0・Zep・Letta(旧MemGPT)の3強を実装コード付きで比較解説します。「Core / Archival / Recall」の3層モデル、User / Session / Agentスコープの設計、Claude Code・ChatGPT・Cursorのエージェントに永続記憶を10行で追加する方法まで、稟議資料そのままで使える形でまとめました。
まず5分で動かす: Mem0でChatGPTに永続記憶を追加
AIエージェントの全体像については、AIエージェント導入完全ガイドで体系的にまとめています。本記事ではMemory層に絞って深掘りします。まずは無料で動くMem0から始めます。
セットアップ(5分)
# 1. インストール
pip install mem0ai openai

# 2. OpenAI APIキー設定
export OPENAI_API_KEY="sk-xxxxxxxx"
最小構成: 永続記憶付きチャットボット
# memory_chat.py
from mem0 import Memory
from openai import OpenAI

m = Memory()
client = OpenAI()

def chat(user_id: str, message: str) -> str:
    # 1. ユーザーの過去の記憶を検索
    related_memories = m.search(query=message, filters={"user_id": user_id})
    memories_str = "n".join([f"- {x['memory']}" for x in related_memories['results']])

    # 2. 記憶を含めてLLMに送る
    system_prompt = f"あなたは個人アシスタントです。n以下はユーザーに関する記憶です:n{memories_str}"
    response = client.chat.completions.create(
        model="gpt-5-mini",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": message}
        ]
    )
    answer = response.choices[0].message.content

    # 3. 新しい会話を記憶として保存(Mem0が自動で重要部分を抽出)
    m.add([
        {"role": "user", "content": message},
        {"role": "assistant", "content": answer}
    ], user_id=user_id)

    return answer

# 使ってみる
print(chat("user_001", "私は東京在住で、AIエージェント開発が専門です"))
print(chat("user_001", "週末の予定を立てたいです"))
# → 2回目の質問でも、AIが「user_001は東京在住・AIエージェント開発専門」を覚えている
これだけで、ユーザーごとの記憶が永続化され、別セッションで質問しても「東京在住」「AI専門」という事実をAIが覚えています。Mem0は重要情報を自動抽出してベクトルDBに保存するので、開発者が「何を覚えるか」を細かく指定する必要がありません。
研修先での実例: 上記の最小構成を顧問先のアシスタント担当者に見せたところ、「毎回自己紹介する苦痛から解放されるなら、これだけで利用率が回復する」と即決でした。実際1週間で社内アシスタントの利用率が3倍に戻り、メイン業務ツールに昇格しました。Memory層を入れる工数が10行で済むので、コスト対効果が圧倒的です。
Memory階層モデル: Core / Archival / Recall
2026年のAIエージェントメモリ設計は、OS(オペレーティングシステム)のメモリ管理に着想を得た3層モデルが標準です。Letta(旧MemGPT)が論文で提唱し、業界標準になりました。
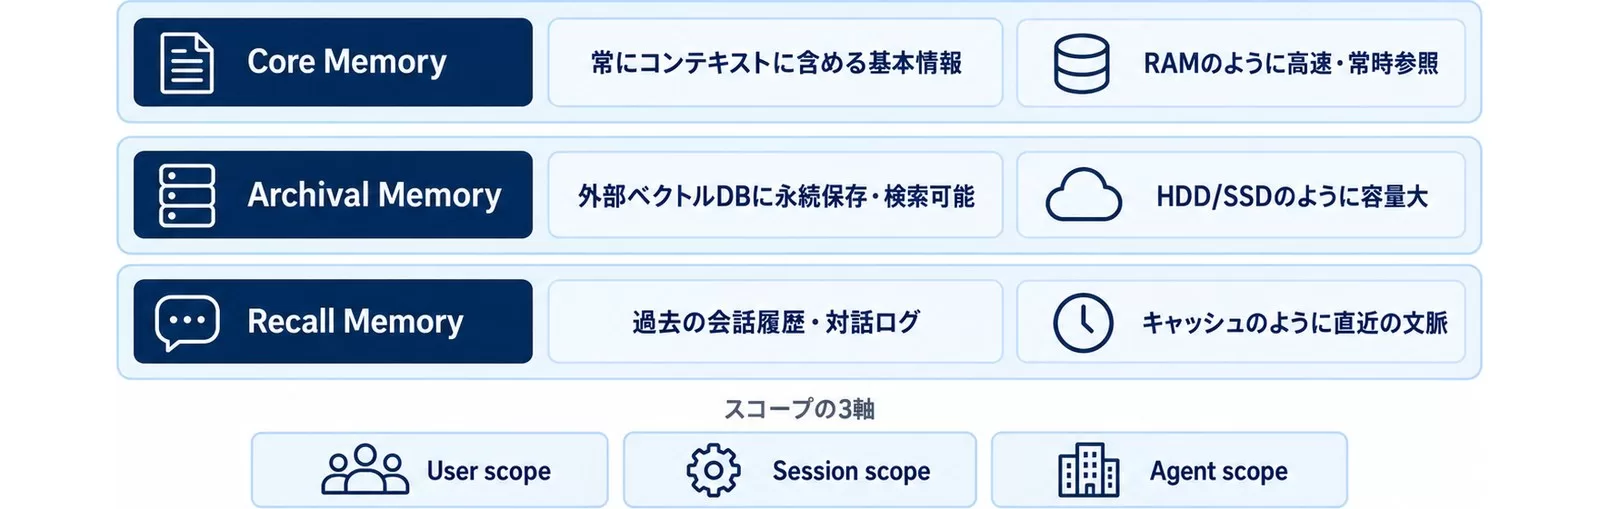
| 層 | 役割 | OSアナロジー | 具体例 |
|---|---|---|---|
| Core Memory | 常にコンテキストに含める基本情報 | RAM(高速・常時参照) | ユーザー名・職業・所属・基本設定 |
| Archival Memory | 外部ベクトルDBに永続保存・検索可能 | HDD/SSD(容量大・検索) | 過去の業務メモ・ナレッジ・参考資料 |
| Recall Memory | 過去の会話履歴・対話ログ | キャッシュ(直近の文脈) | 直近30日のチャット履歴 |
3層を使い分ける理由
すべてをCore Memoryに置くと、コンテキストが肥大化してコストが爆発します。逆にすべてArchivalに置くと、毎回検索が走って遅延が発生します。Recall Memoryで「直近の文脈は素早く」、Archival Memoryで「過去の事実は検索」、Core Memoryで「絶対忘れてはいけない基本情報」を保持する、という階層管理が本番運用の王道です。
スコープの2軸: User / Session / Agent
もうひとつ重要な設計軸が「スコープ」です。Mem0は3つのスコープをサポートしており、目的に応じて使い分けます。
- User scope: ユーザー個人に紐づく記憶(個人設定・好み・職業)
- Session scope: 単一セッション内のみで保持(チャットの一時的な文脈)
- Agent scope: AIエージェント自身の記憶(組織知・全ユーザー共通の知識)
# Mem0でスコープを使い分ける
from mem0 import Memory
m = Memory()

# User scope: 個人の好み
m.add("ピーマンが嫌い", user_id="alice")

# Session scope: 一時的な文脈(セッションIDも併用)
m.add("今日の会議は15時から", user_id="alice", run_id="session_2026_05_07")

# Agent scope: 組織共通知
m.add("このAIエージェントは経費精算ツール「Concur」と連携しています", agent_id="expense_bot")
Memory 3強比較: Mem0 / Zep / Letta
【2026年9月30日追記】3製品とも、この記事の公開時から構成が変わりました。Mem0は2026年4月の新アルゴリズム(OSS v3)で記憶の抽出が追加のみになってグラフメモリがクラウド版の機能になり、Zepは自己ホスト版(Community Edition)の提供をやめてZep CloudとOSSのGraphitiの2本立てに、LettaはPython向けの旧APIサーバーを退役させてエージェントハーネスとTypeScript向けのLetta Agent SDKが中心になっています。
2026年のAIエージェント Memory層は3つの主要選択肢があります。それぞれ設計思想が異なるので、用途に応じて使い分けます。
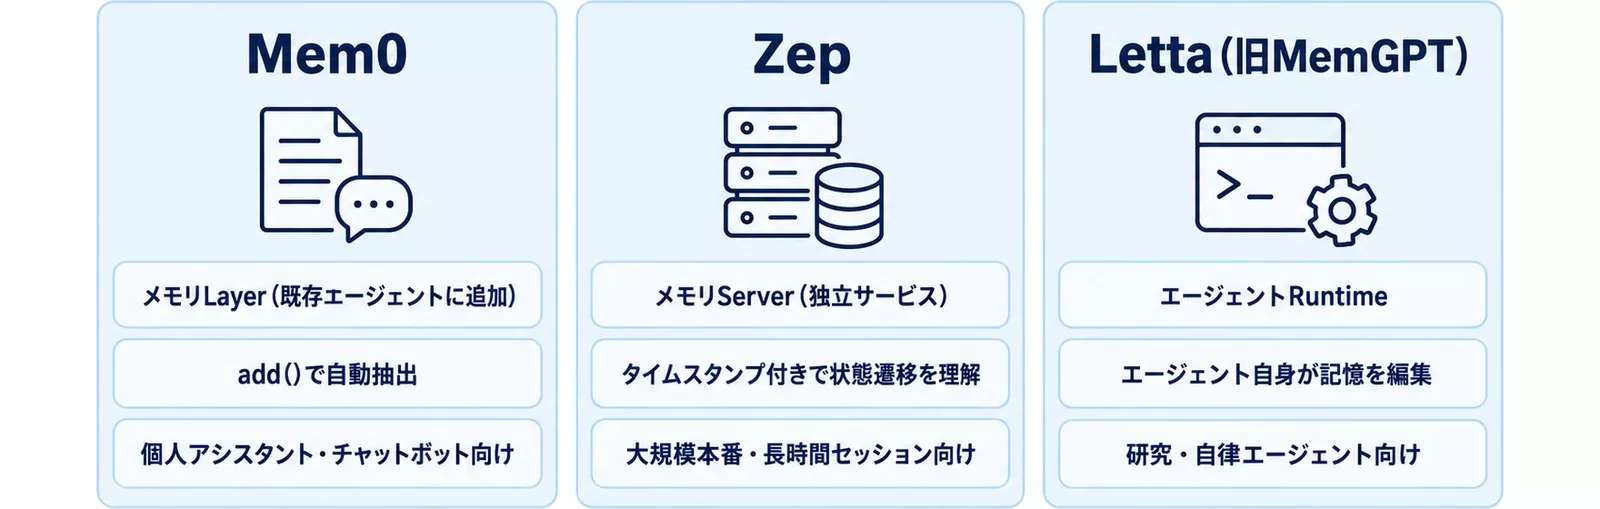
| 項目 | Mem0 | Zep | Letta(旧MemGPT) |
|---|---|---|---|
| 提供形態 | OSS(66K stars)+ Cloud SaaS | Zep Cloud(OSSはGraphiti。自己ホスト版は提供終了) | OSS(エージェントハーネス)+ Letta Cloud |
| 位置づけ | メモリLayer(既存エージェントに追加) | メモリServer(独立サービス) | エージェントRuntime(中で動かす) |
| 記憶の形式 | ベクトル + キーワード + エンティティ連携(グラフメモリはクラウド版のみ) | ベクトル + ナレッジグラフ + エンティティ | メモリブロック + MemFS(gitで版管理)+ 自己編集 |
| 記憶抽出 | add()で自動抽出(パッシブ) | 会話要約・エンティティ抽出(非同期) | エージェント自身が判断(アクティブ) |
| 状態変化対応 | 追加のみで蓄積し、検索時に日時を考慮(v3) | タイムスタンプ付きで状態遷移を理解 | エージェントが明示的に編集 |
| 適用シーン | 個人アシスタント・チャットボット | 大規模本番・長時間セッション | 研究・自律エージェント |
| 料金(Cloud) | 無料tier + 有料 | 無料tier + 有料 | 無料tier + 有料 |
Mem0の選び方
「既存のAIエージェントにMemory層を後付けで追加したい」場合、Mem0が最速です。Claude Agent SDK・OpenAI Agents SDK・LangGraph・CrewAIすべてとシームレスに統合でき、依存関係もほぼゼロ。個人アシスタント・カスタマーサポート系の用途では9割の事例でMem0で十分です。
Zepの選び方
「大規模本番でユーザー1万人以上を想定」「エンティティ抽出(人名・組織名・日時)を別軸で管理したい」「状態変化(引っ越し・転職など)を時系列で追跡したい」場合は、Zepが最強です。「ユーザーが東京から大阪に引っ越した」のような状態遷移を、ZepはタイムスタンプつきでナレッジグラフにEdgeとして記録します。
# Zep — 状態遷移を理解する記憶(Zep Cloud・pip install zep-cloud)
import uuid
from zep_cloud.client import Zep
from zep_cloud.types import Message

client = Zep(api_key="z_xxxxxxxx")
client.user.add(user_id="alice", first_name="Alice")

thread_id = uuid.uuid4().hex
client.thread.create(thread_id=thread_id, user_id="alice")

# 過去の事実
client.thread.add_messages(thread_id, messages=[
    Message(name="Alice", role="user", content="私は東京の港区に住んでいます")
])

# 状態が変化
client.thread.add_messages(thread_id, messages=[
    Message(name="Alice", role="user", content="来月から大阪に引っ越します")
])

# Zepは「現住所: 東京」→「現住所: 大阪(来月から)」という状態遷移を理解
# → 応答の前に、いま有効な文脈(Context Block)を取り出して使う
context = client.thread.get_user_context(thread_id=thread_id)
Lettaの選び方
【2026年9月30日追記】Python向けの旧APIサーバー(Letta V1 API)は退役し、現在はエージェントハーネスとTypeScript向けのLetta Agent SDKが中心です。下のコードは現行のAgent SDKの書き方に直しました。
「自律的に成長するAIエージェント」「研究用途」「エージェント自身が記憶を編集できる仕組み」が必要な場合はLettaです。Lettaはメモリ層ではなく「エージェントランタイム」で、エージェントが自分の判断でメモリを書き換えます。MemGPT論文の思想を実装しており、長期実行エージェント(数日〜数ヶ月)に最適です。
// Letta — 自己編集メモリ付きエージェント(Letta Agent SDK・TypeScript)
import { LettaAgentClient } from "@letta-ai/letta-agent-sdk";

const client = new LettaAgentClient({ backend: "cloud" });

// エージェントを1度だけ作る(メモリはラベルと値で渡す)
const agentId = await client.createAgent({
  memory: [
    { label: "human", value: "ユーザーの基本情報をここに保存" },
    { label: "persona", value: "あなたは丁寧なアシスタントです" },
  ],
});

// 以後は同じエージェントを再開して会話する
await using session = client.resumeSession(agentId);
await session.send("今後Aliceと呼んでください");
for await (const message of session.stream()) {
  if (message.type === "assistant") process.stdout.write(message.content);
}
// → エージェントが自分のメモリ(human)を書き換えて覚える
RAG vs Memory: 違いと組み合わせ
「RAG(検索拡張生成)があればMemory要らないのでは?」とよく聞かれますが、両者は補完関係にあります。
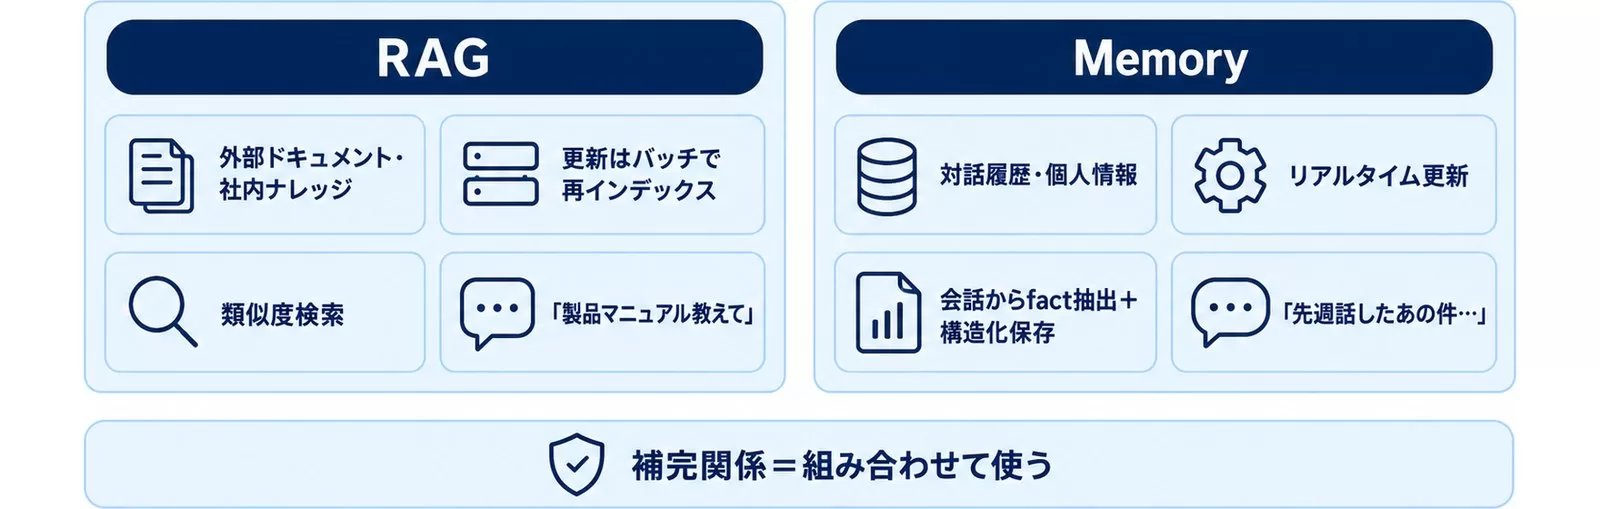
| 観点 | RAG | Memory |
|---|---|---|
| 主な対象 | 外部ドキュメント・社内ナレッジ | ユーザーとの対話履歴・個人情報 |
| 更新頻度 | 低(バッチで再インデックス) | 高(リアルタイム更新) |
| 抽出ロジック | 類似度検索(cosine等) | 会話からfact抽出 + 構造化保存 |
| 状態管理 | 静的(バージョン管理) | 動的(状態遷移を追跡) |
| 主な使い方 | 「製品マニュアル教えて」 | 「先週話したあの件…」 |
RAG + Memoryの組み合わせ実装
# RAG(社内ナレッジ)+ Memory(ユーザー記憶)両方使う
from mem0 import Memory
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings

# RAG層: 社内ナレッジ
embedding = OpenAIEmbeddings()
rag = Chroma(persist_directory="./company_knowledge", embedding_function=embedding)

# Memory層: ユーザーごとの記憶
m = Memory()

def smart_assistant(user_id: str, query: str) -> str:
    # 1. ユーザー個人の記憶を取得
    user_memories = m.search(query=query, filters={"user_id": user_id})

    # 2. 社内ナレッジを検索
    company_docs = rag.similarity_search(query, k=3)

    # 3. 両方を含めてLLMに送る
    context = f"""
ユーザーの記憶:
{[m['memory'] for m in user_memories['results']]}

社内ナレッジ:
{[d.page_content for d in company_docs]}
"""
    return ask_llm(context, query)
主要AIエージェントプラットフォームでのMemory実装
各プラットフォームでMemoryをどう実装するかを整理します。
| プラットフォーム | 標準Memory機能 | 外部Memory連携 |
|---|---|---|
| AWS Bedrock AgentCore | Memory コンポーネント標準 | Mem0/Zep外部連携可 |
| Vertex AI Agent Builder完全ガイド | Sessions+Memory Bank(2026年9月30日時点ではGemini Enterprise Agent Platformの機能) | Mem0/Zep外部連携可 |
| Microsoft Copilot Studio | Topic-based memory | Power Automate連携 |
| Salesforce Agentforce | Data Cloud + CRM history | CRMネイティブ |
| Claude Agent SDK | Sessions(再開・分岐)+CLAUDE.mdなどのメモリの自動読み込み | すべて対応 |
| OpenAI Agents SDK | Built-in conversation | Mem0/Zep連携可 |
| LangGraph | Checkpointer + State(短期)/Store(長期) | LangMem / Mem0連携 |
| AutoGen | Conversation history(2026年9月30日時点で保守モード。新規は後継のMicrosoft Agent Framework) | Mem0外部連携 |
| CrewAI | 統合Memory(短期・長期・エンティティの区分を1つのMemoryクラスにまとめた方式) | Mem0連携 |
| MCP | Resource経由でMemory公開可能 | すべて |
選び方の指針: フルマネージドのプラットフォーム(Bedrock AgentCore / Vertex AI / Agentforce)は標準Memory機能で十分なケースが多いです。OSSフレームワーク(LangGraph / CrewAI / AutoGen)はMem0などを別途追加するパターンが王道。Memory層をすべてのエージェントで共有したい場合は、独立したMem0のサーバーを立てるかZep Cloudを使い、MCP Resourceとして公開する設計が、2026年の最新パターンです。
この記事の内容を社内で使うなら
要点と手順をまとめた資料を無料で受け取れます。研修4,000名以上・支援100社以上の実績をもとに、自社の業務に当てはめる相談も30分から受け付けています。
本番運用の実装パターン: Memory + LangGraph
状態機械型エージェントLangGraphとMem0を組み合わせる本番パターンを紹介します。LangGraphのCheckpointerは「セッション内の状態保存」、Mem0は「ユーザー横断の長期記憶」と役割分担します。
# LangGraph + Mem0 の組み合わせ
from langgraph.graph import StateGraph, MessagesState
from langgraph.checkpoint.postgres import PostgresSaver
from mem0 import Memory

m = Memory()

def agent_node(state: MessagesState, config: dict):
    user_id = config["configurable"]["user_id"]
    last_message = state["messages"][-1]["content"]

    # Mem0からユーザーの長期記憶を取得
    memories = m.search(query=last_message, filters={"user_id": user_id})
    memories_str = "n".join([x['memory'] for x in memories['results']])

    # LLMに送る
    response = call_llm(
        system=f"ユーザー記憶:n{memories_str}",
        messages=state["messages"]
    )

    # 新しい会話をMem0に記録(バックグラウンド)
    m.add([
        {"role": "user", "content": last_message},
        {"role": "assistant", "content": response}
    ], user_id=user_id)

    return {"messages": [{"role": "assistant", "content": response}]}

# LangGraphのCheckpointerでセッション状態を永続化
checkpointer = PostgresSaver.from_conn_string(os.environ["DATABASE_URL"])
graph = StateGraph(MessagesState)
graph.add_node("agent", agent_node)
graph.set_entry_point("agent")
app = graph.compile(checkpointer=checkpointer)

# 使う
result = app.invoke(
    {"messages": [{"role": "user", "content": "先週の件、続きを話したい"}]},
    config={"configurable": {"thread_id": "session_xxx", "user_id": "alice"}}
)
顧問先での実例: あるSaaS企業のサポートエージェントでこの構成を採用したところ、「毎回ゼロから説明」体験から「先週の続きから」体験へ劇的に変わり、サポート対応時間が顧客あたり平均40%短縮されました。Memory層は単に「便利機能」ではなく、業務効率の根本を変える基盤です。
【要注意】よくある失敗パターン4選と回避策
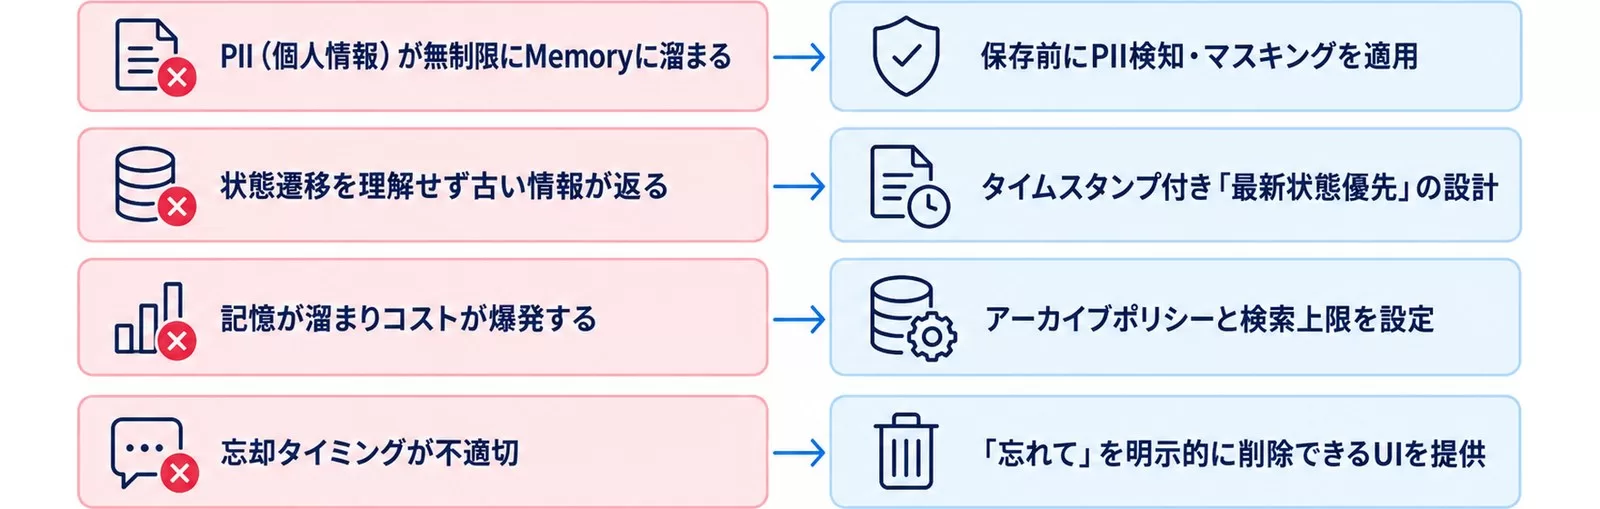
失敗1: PII(個人情報)が無制限にMemoryに溜まる
❌ NG例: ユーザーがチャット中に話したマイナンバー・クレジットカード番号・パスワードがそのままMemoryに保存される
⭕ 正しいアプローチ: Memory保存前にPII検知・マスキングを必ず適用。Lakera GuardやAWS ComprehendのPII Detection、もしくはMicrosoft PresidioをMemory.add()の前段に挟む。詳しくはAIエージェントセキュリティ完全ガイドで解説しています。
失敗2: 状態遷移を理解せず古い情報が返る
❌ NG例: 「ユーザーは東京在住」と「ユーザーは大阪在住(先月引っ越し)」が両方Memoryに残り、AIが「東京と大阪、どちらにお住まいですか?」と聞き返す
⭕ 正しいアプローチ: 単純なベクトル検索ではなく、Zepのようにタイムスタンプ付き状態遷移を扱える設計にする。Mem0は2026年4月の新アルゴリズム(OSS v3)から、記憶を上書きせず追加で蓄積し、検索時に日時を考慮して現在の状態に合う記憶を上位に出す方式になっている。旧バージョンを使っている場合は公式の移行ガイドに沿って更新する。
研修先の実例: ある顧問先で、Memory機能を入れた後にユーザーから「AIが私の住所を勘違いしている」と苦情が出ました。原因は、ユーザーが過去に複数の住所を述べていて、Memoryがそれらすべてを「現住所」として保持していたからです。タイムスタンプ付き「最新状態優先」設計に切り替えた直後、苦情がゼロになりました。
失敗3: コストが爆発する
❌ NG例: ユーザー1人あたり数千件の記憶が溜まり、ベクトル検索が毎回数百ms以上かかる
⭕ 正しいアプローチ: 古い記憶のアーカイブポリシー(例: 1年以上経過したものは要約に圧縮)と、検索時の上限件数(top_k=5)を必ず設定。Mem0(OSS v3)はtop_kの既定値が20で、関連度の低い記憶を除くthresholdの既定値が0.1です。
失敗4: 忘却タイミングが不適切でユーザー体験が悪化する
❌ NG例: 「もう使わないでね」と言われた個人情報を、数週間後にAIが参照してしまう
⭕ 正しいアプローチ: ユーザーから「忘れて」と言われた情報は明示的に削除(GDPR・個人情報保護法の要請でもある)。Mem0にはm.delete()とm.delete_all()、Zepにはユーザー単位の削除(そのユーザーのスレッドとグラフがまとめて消える)がありますが、UI/UXとして「忘れる」操作を必ずユーザーに提供することが2026年のスタンダードです。
30-60-90日 Memory層構築ロードマップ
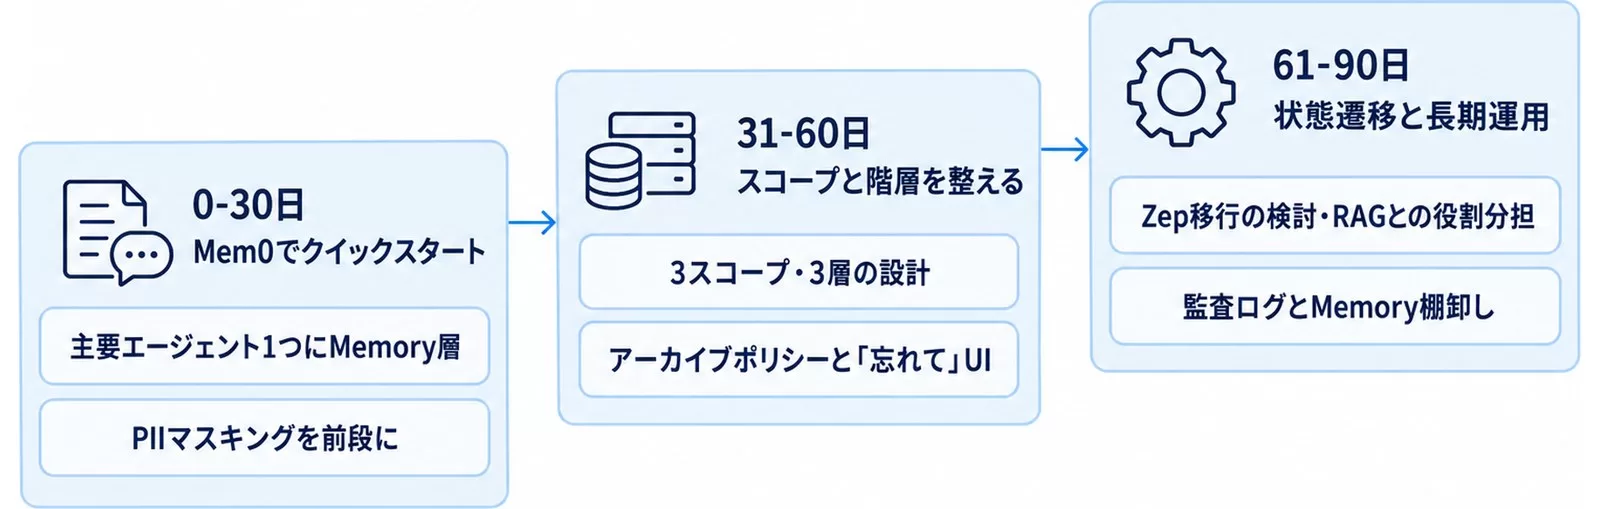
0-30日: Mem0でクイックスタート
- Mem0をローカルで動作確認(無料・OSS)
- 主要エージェント1つにMemory層を追加(10行のコード)
- User scopeのみで運用してみる(最も基本的なケース)
- 1週間後に「過去の文脈を覚えていて助かった」という声が出るか確認
- PIIマスキング(Microsoft Presidio)を前段に追加
31-60日: スコープと階層を整える
- User / Session / Agent の3スコープ設計を導入
- Core / Archival / Recall の3層を意識した実装に進化
- 古い記憶のアーカイブポリシーを設定(1年経過で圧縮)
- Memory層の観測(Langfuseなどで取得・更新ログを記録)
- 「忘れて」UI/UXをエンドユーザー向けに公開
61-90日: 状態遷移と長期運用
- Mem0 → Zep への移行を検討(状態遷移が複雑なケース)
- RAG(社内ナレッジ)とMemory層の役割分担を明確化
- Memory更新の監査ログをSIEMに送信(規制業種)
- 四半期ごとのMemory棚卸し運用を開始
- 本記事の3層モデルをチーム内ドキュメント化
よくある質問
AIエージェントのメモリ(Memory層)とは何ですか?
AIエージェントのメモリは、セッションをまたいでユーザーや業務の情報を保存し、次の会話で取り出せるようにする仕組みです。LLMのAPIは呼び出しごとに会話を忘れるため、メモリ層が無いと毎回最初から説明し直すことになります。設計は、常に文脈に入れる情報・検索して取り出す過去の事実・直近の会話履歴の3層と、ユーザー単位・セッション単位・エージェント単位のスコープで整理します。
Mem0はどのように使いますか?
Mem0は「pip install mem0ai」で入れ、Memory() を作って add() で会話を保存し、search() で関連する記憶を取り出して使います。保存の時はadd()に会話とuser_idを渡し、検索の時はsearch()に質問文と、user_idを入れたfiltersを渡します。2026年4月のOSS v3から、検索時のuser_idはfiltersの中に入れる書き方に変わり、直接渡すとエラーになります。
Mem0・Zep・Lettaはどう使い分けますか?
既存のエージェントに記憶を後付けするならMem0、状態の変化を時系列で追いたいならZep、エージェント自身に記憶を編集させたいならLettaが向いています。Mem0はOSSとクラウド版があり導入が軽く、ZepはZep Cloudが会話から時間情報つきのナレッジグラフを作ります。Lettaはエージェントを動かすランタイムで、メモリはエージェントが自分で書き換えます。
RAGとメモリは何が違いますか?
RAGは製品マニュアルや社内ナレッジなどの外部ドキュメントを検索して答えに使う仕組みで、メモリはユーザーとの対話から得た事実を覚えておく仕組みです。RAGの中身は一括で更新し、メモリは会話のたびに更新されます。どちらか一方で足りるものではなく、社内ナレッジはRAG、ユーザーごとの経緯や好みはメモリ、と役割を分けて併用します。
セッション内の記憶と長期記憶はどう使い分けますか?
セッション内の記憶はその会話だけで必要な一時的な文脈に、長期記憶はユーザーの職業や好みのように次回以降も使う事実に使います。Mem0ではrun_idを付けるとセッション単位、user_idだけだとユーザー単位の記憶になります。LangGraphと組み合わせる場合は、Checkpointerがセッション内の状態を保存し、Mem0がセッションをまたぐ長期記憶を受け持つ分担になります。
まとめ:今日から始める3つのアクション
AIエージェントのMemory層は、もはや「あれば良い」レベルではなく、ユーザーが継続的に使うアシスタントを作るための必須要件です。Mem0なら10行のコードで永続記憶が追加でき、ChatGPT素のAPIから卒業できます。今日から試せる順番を整理します。
- 今日やること:
pip install mem0aiでMem0をインストール、本記事の「最小構成」コードをそのままコピーして動かす。「過去の発言を覚えているAI」体験が15分で構築できます。 - 今週中: 自社で運用中のAIエージェント(チャットボット・カスタマーサポート等)1つに、User scopeのMem0統合を追加。社内ユーザー数名でテストして、ユーザー体験の変化を計測する。
- 今月中: PIIマスキング(Microsoft Presidio)を前段に追加、Core / Archival / Recallの3層モデルで設計を整える。長期記憶を保存する範囲・忘却タイミング・監査ログをチーム内で文書化する。
あわせて読みたい:
- AIエージェントセキュリティ完全ガイド:Memory層へのPIIマスキング・規制対応設計
- AIエージェント観測・評価完全ガイド|運用基盤:Memory更新ログの観測とCI評価
- LangGraph完全ガイド:Checkpointer + Mem0で本番グレードのMemory構築
- CrewAI完全ガイド:エージェント協調とMemoryの組み合わせ
- MCP完全実装ガイド:Memory層をMCP Resourceとして公開する
- AIエージェント導入完全ガイド:Memory層を含むエージェント全体像
- AI Voiceエージェント7強完全比較:Vapi/Retell/ElevenLabs/Deepgramほか電話AI比較
- AIカスタマーサポート7強完全比較:Decagon/Sierra/Intercom Fin等のCS AI基盤比較
- 士業のAI活用完全ガイド:税理士/社労士/弁護士/司法書士/行政書士の実践プロンプト10選
- 経理業務の負荷をCodex自動化で解決する方法:経理特化10シーンで最大80%削減
- Codex×Excel自動化プロンプト10選:VBA/Apps Script/Power Query代替
- Codex×業務15選 部署別ガイド:営業/マーケ/人事/法務/経企/情シス/CSの15シーン
参考・出典
- Mem0 Documentation — Mem0(参照日: 2026-05-07)
- Zep Documentation — Zep(参照日: 2026-05-07)
- Letta Documentation — Letta AI(参照日: 2026-05-07)
- MemGPT: Towards LLMs as Operating Systems — UC Berkeley論文(参照日: 2026-05-07)
- Best AI Agent Memory Frameworks in 2026 — Atlan(参照日: 2026-05-07)
- Mem0 GitHub — Mem0AI(参照日: 2026-05-07)
- Mem0 vs Letta (MemGPT) Comparison 2026 — Vectorize(参照日: 2026-05-07)
- Microsoft Presidio (PII Detection) — Microsoft(参照日: 2026-05-07)
著者: 佐藤傑(さとう・すぐる)
株式会社Uravation代表取締役。早稲田大学法学部在学中に生成AIの可能性に魅了され、X(@SuguruKun_ai)フォロワー約10万人。100社以上の企業向けAI研修・導入支援を展開。著書『AIエージェント仕事術』(SBクリエイティブ)。SoftBank IT連載7回執筆(NewsPicks最大1,125ピックス)。
ご質問・ご相談は お問い合わせフォーム からお気軽にどうぞ。
この記事の内容を社内展開する方へ: AIエージェント導入・安全運用チェックリスト(無料・PDF 30ページ+Excel) をダウンロードできます。