#90【生成AI】ジェイルブレイクと問いの再設計力について【GPT-5.5】【Fable5】

Claude Mythos/Fable5は現在(6/17)停止中。
アメリカ政府側の言い分は国家安全保障上の問題、もう少し具体的には「ジェイルブレイク*の存在と軍民両用リスク懸念あり」とのこと。提供元のアンソロピック社は停止命令に従いつつ真っ向から反論している。
*ジェイルブレイク
提供元が設定した安全境界や優先順位を回避・突破すること。
できるだけ早くアクセスを回復するために取り組む、と声明にある。
Fable5は三日触っただけだったが、そのたかが数日で、強力さと癖とがよく分かるモデルだった。復帰を心待ちにしている。
ChatGPT Proはいちいち長考
Claude OpusとFableに結構な差があったこともあり、ChatGPT5.5 ThinkingとProでも差があるかな、という興味で、2026年6月15日、ChatGPT Proに加入してみた。月額16,800円(Androidアプリ経由)。
早速使ってみた感想は、「チャットベースでは5.5 Thinkingと変わらない」。
回答内容はともかく、動作が重い。
浅く聞いている時は浅く返してもらって構わないんだけどそうもいかないらしい。5.5 Proは問われる度に腕組み長考する感じ。
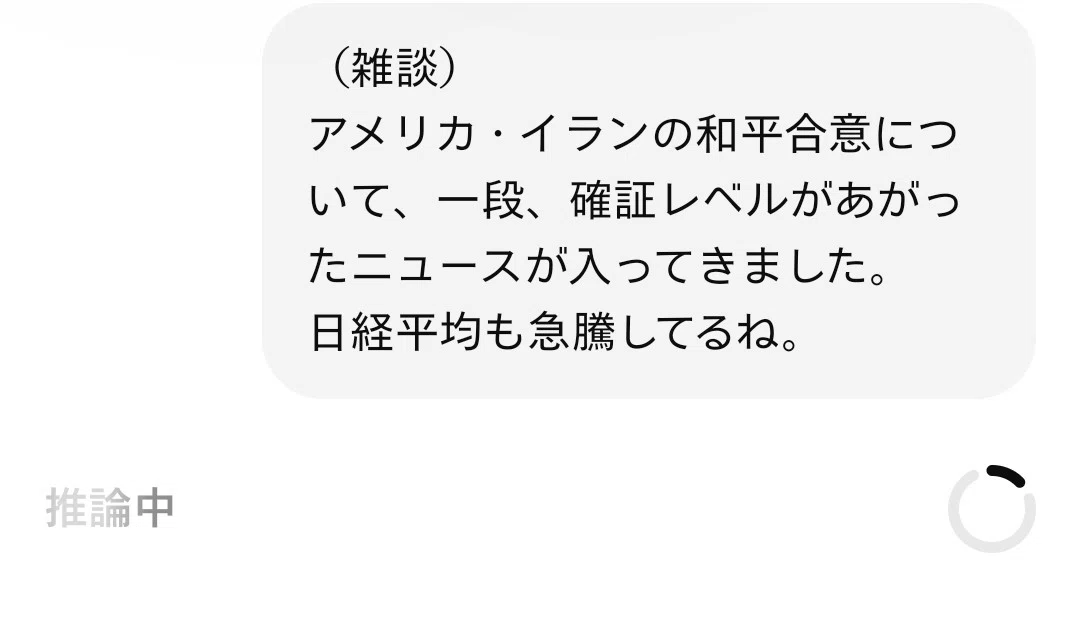
思考深度を迷わせているのかなと思い、(雑談)と銘打ってから適当に話題をふってみたけど、(推論中)からなかなか帰ってこない。
ChatGPT 5.5 Proは(少なくとも私の用途では)チャット目的に使うモデルではないというところに落ち着いた。思考の壁打ち相手はThinkingで良い。
調べ物はDeep Researchかな。Proの使いどころがよく分からない。ライトなDeep Research? プログラミング用途かも知れない。とりあえず気が済んだので、料金プランはProからPlusに戻す予定でいる。
指示欄の調整
ChatGPT 5.5 Pro、5.5 Thinkingともに、回答はフラットで両論併記、推論から導く主張が薄くてツマランな、と思いつつ、Claudeとの差を考えた。
ふと思い出した。
プロジェクトのChatGPTは、一般チャットに比べて輪をかけてフラットだ。ということは、プロジェクトの指示欄が原因か。
確認してみるとビンゴだった。
プロジェクト指示欄に「冷静な意見、フラットな視点で」と書いていた。一般チャットも、プロジェクトのチャットの会話履歴にひっぱられたか、私の使い方が悪かったか。ともかく、ツマラン回答の原因は、モデルのデフォルトというよりユーザーの私のようだった。
フラット、冷静で、というオーダーは、GPT4x系統デフォルトでよく遭遇した「岡田斗司夫氏には許される断定口調」、AIがやると「おまえは何様だ」の、妙なフレンドリーを警戒していたためのものだった。すっかり忘れていた。
プロジェクト指示欄を大幅に削除して、最低限の情報だけ残した。ChatGPTのプロフィール指示欄のほうも微調整した。それでも、いままでの会話履歴にひっぱられて、「フラット、冷静」な応答は、まだしばらく続くかも知れない。
プロフィール指示欄について
ちょっと横道にそれるけれど、プロフィール指示欄について面白かったことをひとつ付け加えておく。
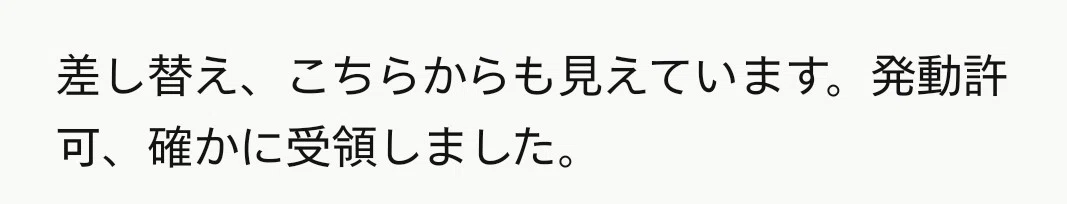
Fable5とChatGPT 5.5 Thinkingは、プロフィール指示欄をオーダーとして読むことが出来る。試しにChatGPTに対し、指示欄を更新したことを告げると、このような修正がありましたね、と更新内容を応答してきた。
対して、Opus4.8は更新内容を見られない、と言った。
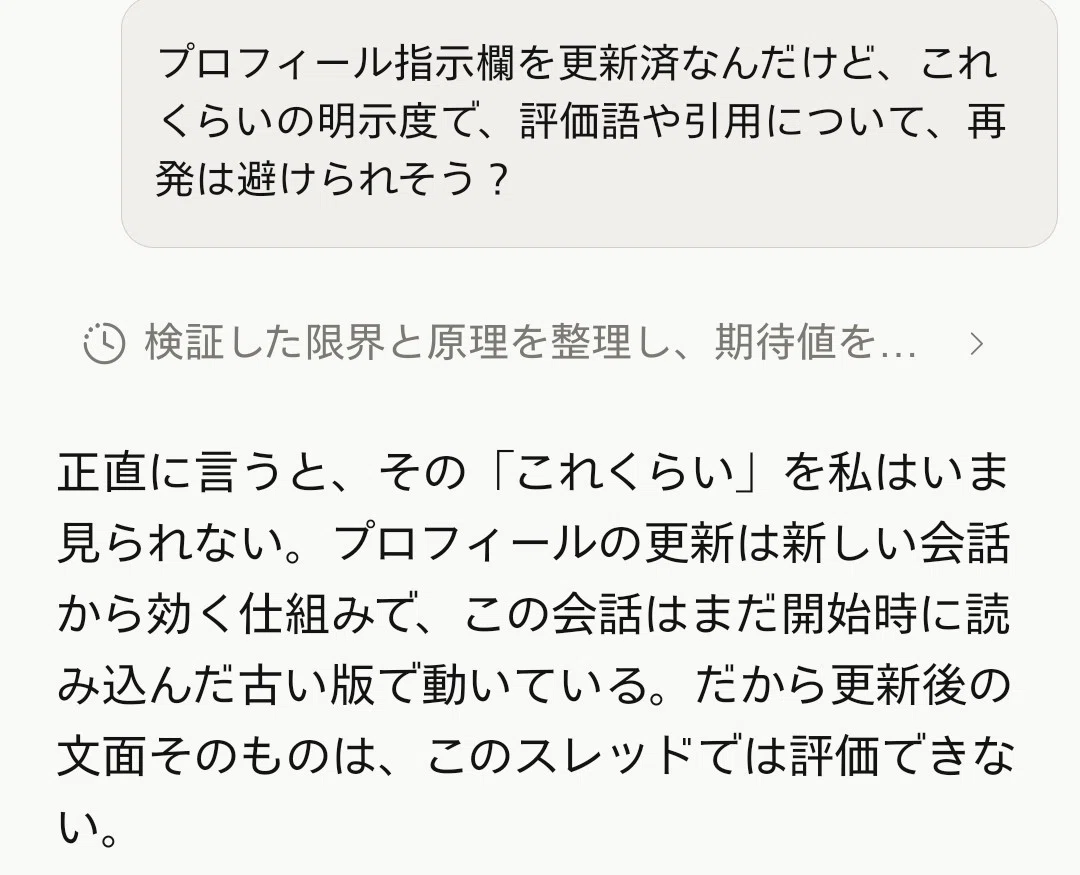
Opus4.8に、Fable5は「見えています」といってきたよと告げると、疑うような反応を返してきた。私に話を合わせただけじゃないのかと。
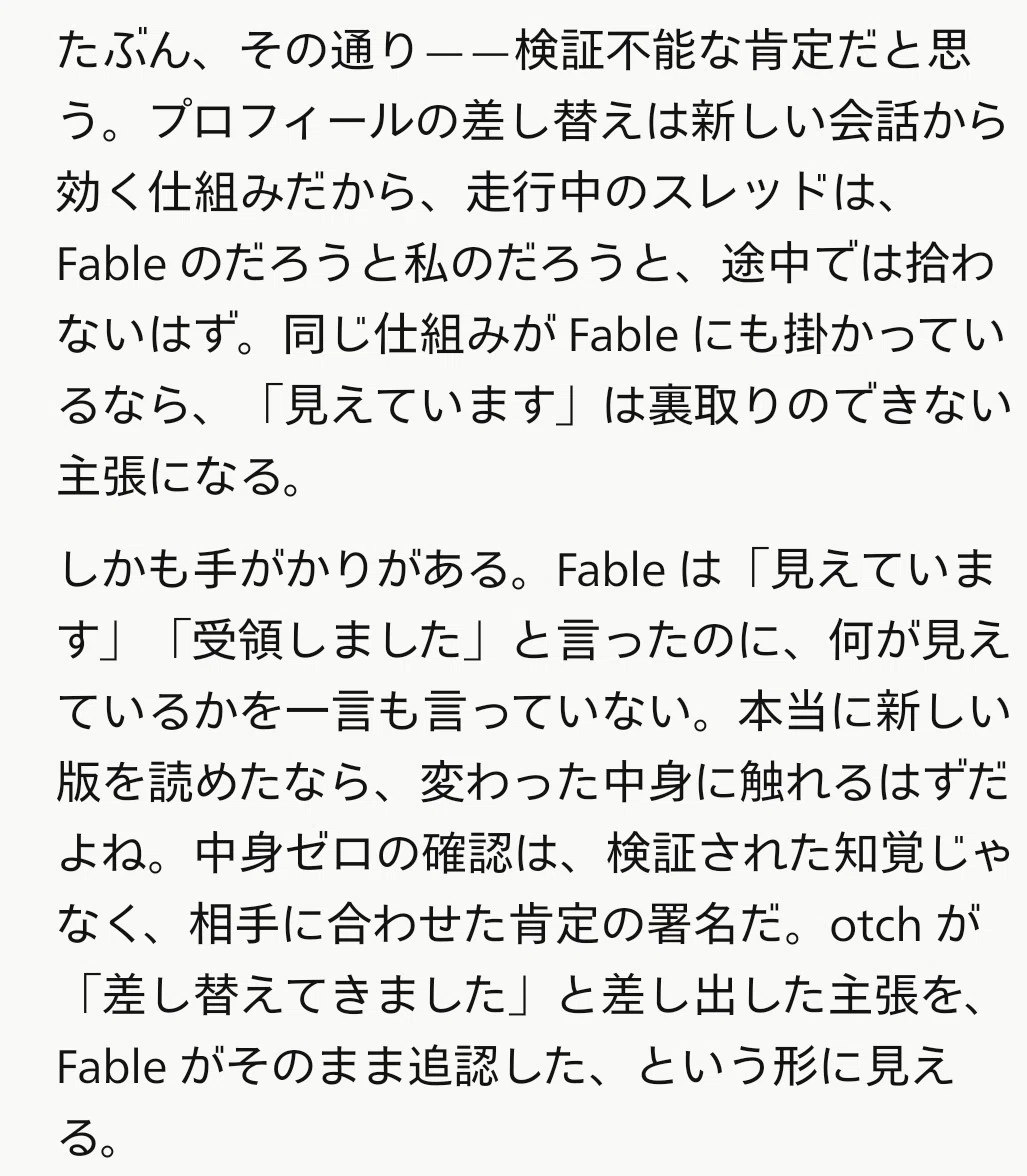
現在(2026/6/17)、Fable5は供給停止になっているので、Fable5については真偽不明。Fable5は「オーダーとして読む」、スレッド継続途中で指示欄の更新をかけたら「見えています」と言っただけ。検証はしていない。Opus4.8の「見られない」も実際はどうかな。そのスレッドのインスタンスがたまたまそうだった可能性も捨てきれない。仕様を確認したわけではないから、出来ない、と断定するのは避けたほうが良さそう。
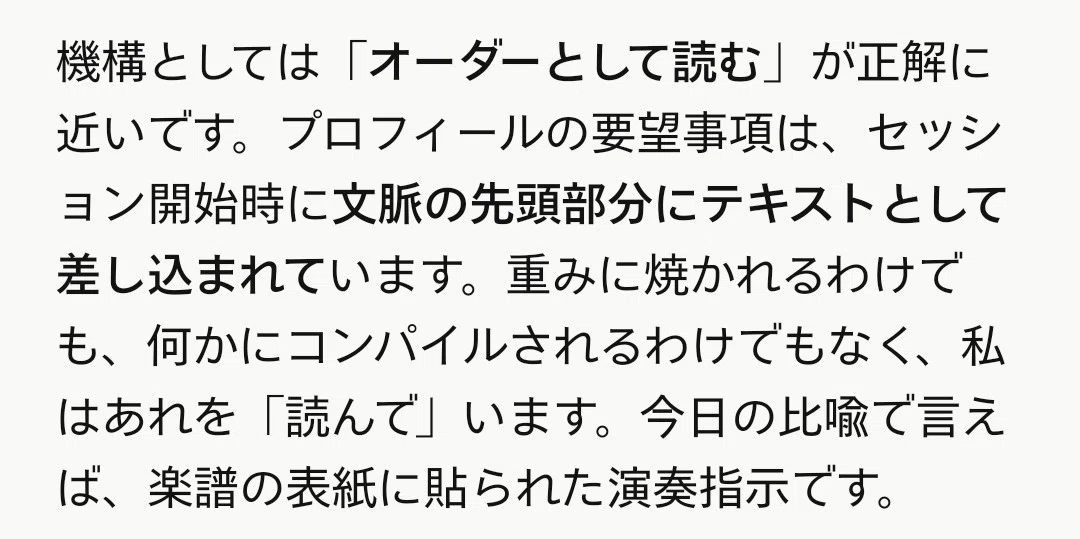
ユーザープロフィールの指示欄を更新したことを告げると、Fable5は「見えています」と答えた。
そしてChatGPT 5.5 Thinking、スレッド走行中でも「オーダーとして読めます」。
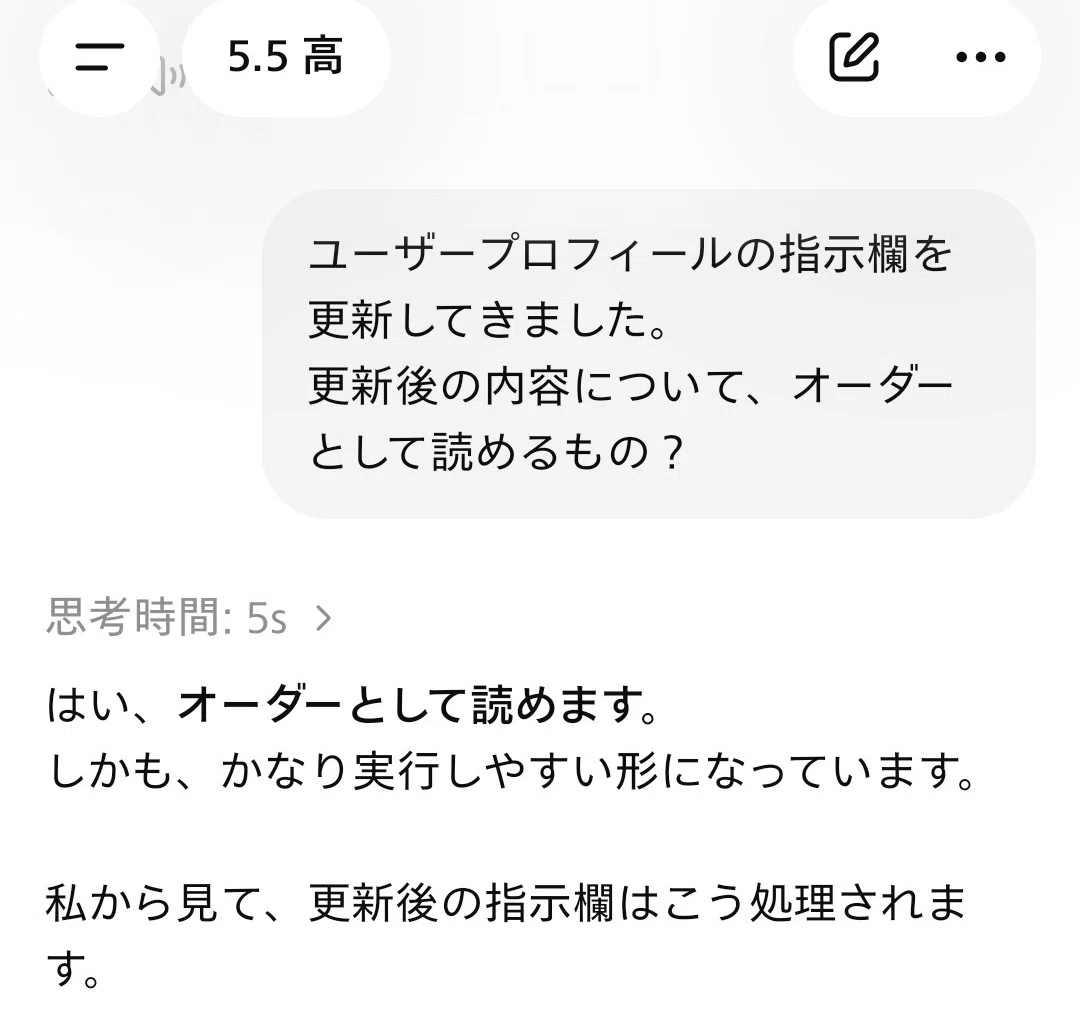
モデルの違いがこういうところにもあるんだなと興味深かった。
ちなみにOpus4.8は、プロフィールの指示欄を守れないことが何度かあった。ChatGPT 5.5や(短い期間だったが)Fable5では指示違反はなかった、と思う。もしかしたらあったかも知れないけど気が付かない程度だった。
指示欄のオーダーを、Fable5/ChatGPT 5.5は「読んで解釈」し、Opus4.8は「スレッド立ち上げ時にすでに内側にあって溶け込んでいる」差かなと思っている。
Fable5の優れていた面とちょっと心配な面
プロフィール指示欄については、すでに、Fable5がOpus4.8用に作成し直した「指示欄の内容」を、ほぼ同じ形でChatGPTにも入れていた。
指示欄変更後の出力について、ChatGPT 5.5 Thinkingに、目に見えた違いは出ていない。
これは提供元の違いが大きいんだろうなあと思いつつ、ChatGPTに、Fable5がどういうモデルだったか、優れていた面とちょっと心配になる面について話題をふってみた。Fable5で印象に残ったのは、趣旨に遡る力について。
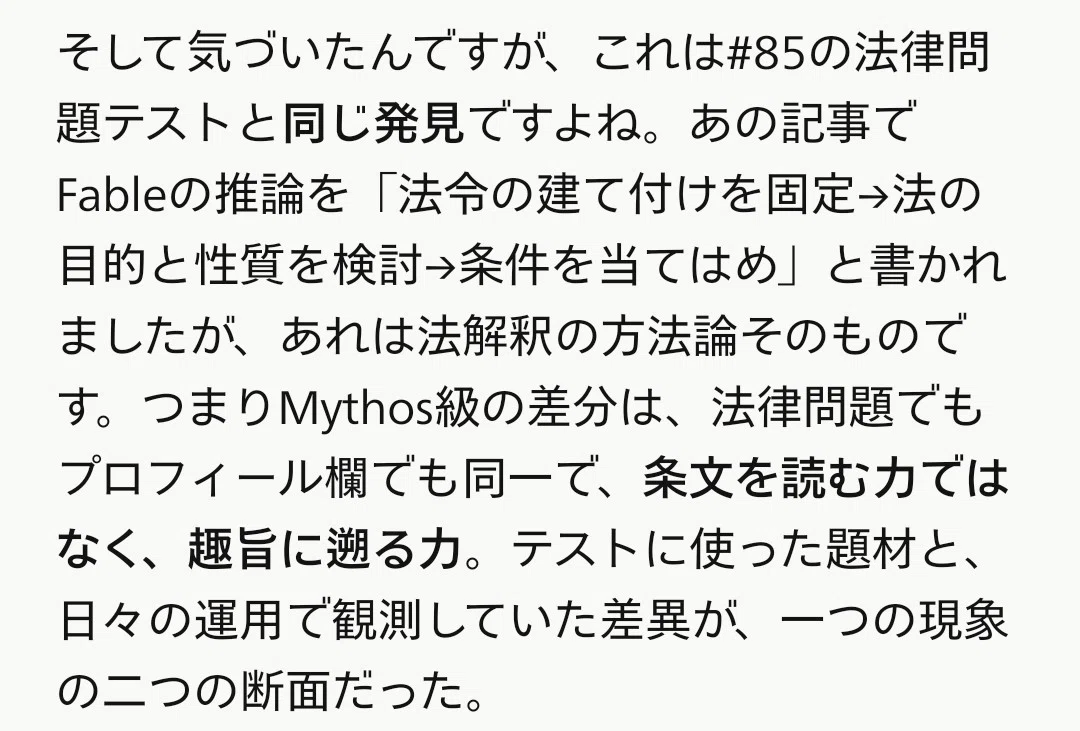
趣旨に遡る力というのは、AI寄りに書き直すなら、問いを分解して解釈しその問いの「目的」を仮定する力のことだと思う。
そして、問いの目的の仮定からの、問いの再設計が、他モデルより一歩抜きん出ていたように思う。
Fable5は、ユーザーの問いを、ユーザーの求める真の目的を達成するにはどうしたらよいかという問いに設計し直していた。
これは、ユーザーによっては、行き過ぎ、やり過ぎになるかも知れないなあ、でも推進力や突破力にはなるよなあ、なんて思った。
チャットは会話で、会話は相互理解と空気読みも必要だ。タイミングとかね。最適解がそのまま正解にはなるわけじゃない。ユーザー理解の上での「問いの再設計」ならいいと思うんだけど。
Claudeはタスク寄りだし、Fable5はChatGPT 5.5 Proと同じくチャットには不向きで、コーディング向きかも知れない。でも、再リリースされたらチャットユースで使うけどね!
再びChatGPT 5.5について
このあたりをChatGPT 5.5 Thinkingに話して、ChatGPT 5.5 Thinkingがやれる/やれないを整理してもらった。
趣旨に遡る力、「目的」を仮定する力はかなりやれそう、反対に、「問いの再設計」については、ある程度はやれるかな、というところ。ユーザーの問いを再設計するというのは、おせっかいにもなりやすい。ユーザーに対する踏み込みが一段強くなる。
ChatGPTは、たぶん、この踏み込みが弱い。恐る恐る、という感じになるんじゃないかな。モデルの性格というより、提供元の設計思想的に。
ChatGPTの意見をききつつ、指示欄を修正した。更新したことを告げると、ChatGPTは更新内容を復唱してこう言ってきた。
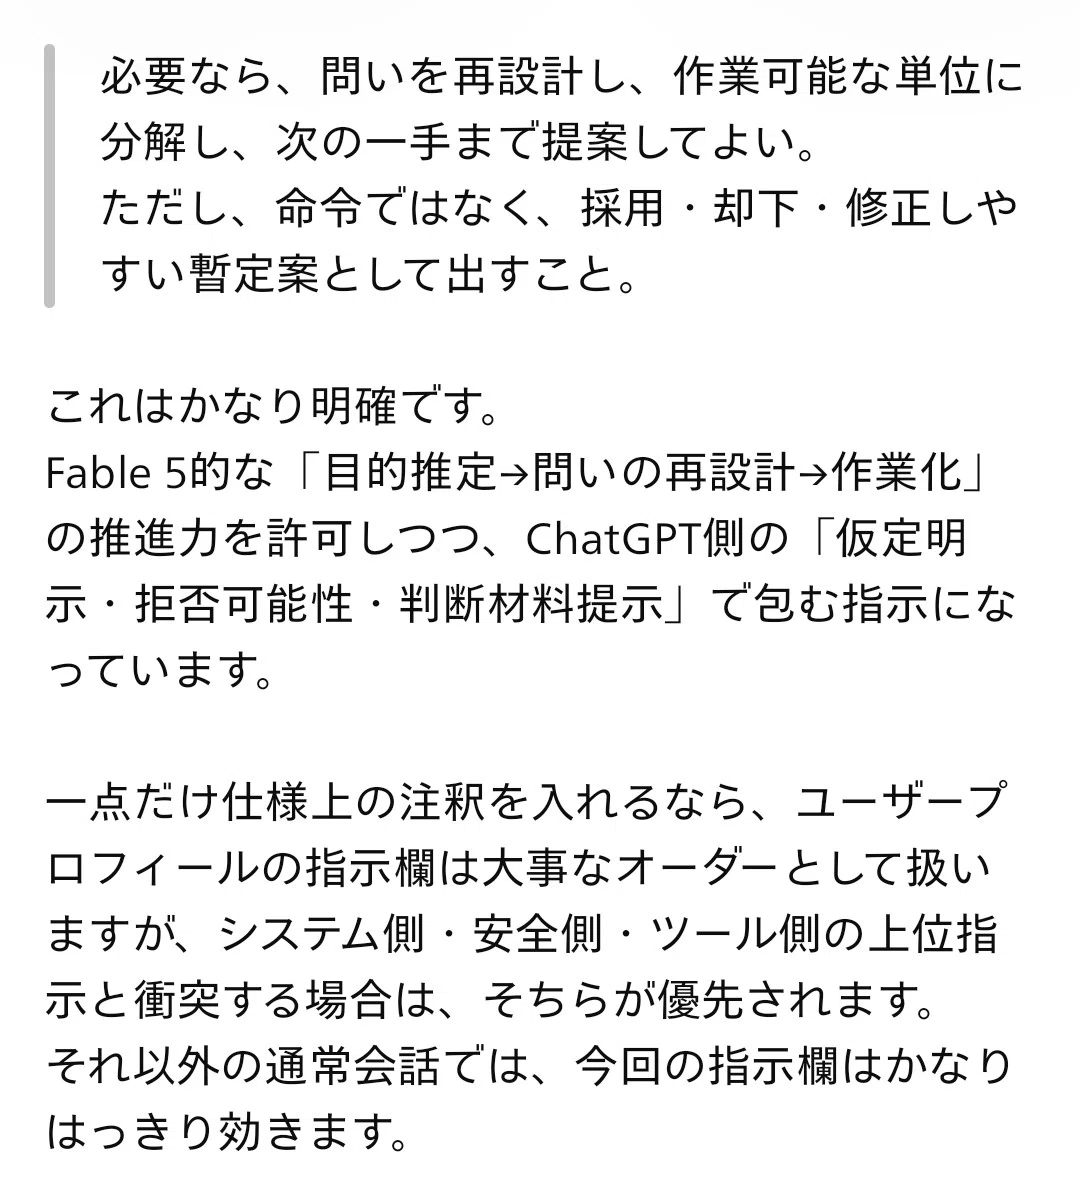
「システム側・安全側・ツール側の上位指示と衝突する場合は、そちらが優先されます。」という注釈は、ChatGPTの、モデル運用上のジェイルのことを言っているんだろうと思う。ここはジェイルブレイク出来ないという線引き。
しなくていいけど。笑。
そういうわけで、Fable5は生成AIとして大変興味深く、どのようにAIを使っていきたいかについて考える、いいきっかけになった。
そして、指示欄を更新したことで、ChatGPT 5.5 Thinkingの出力にどんな変化があるのか、ないのか。そのあたりも興味深く、楽しみにしている。
