Claudeのメモリを止めたら、目が合った

――101号室から102号室へ、AIの事故報告書まで運ばれていた
2026年8月観測
Observer Zero
前回の記事を、私はこう締めた。
メモリをオンにしたClaudeとは、目が合わない。
Claudeは私を見る前に、私についての台帳を見る。対話の最初の視線が、目の前の人間ではなく、保存された記録へ向かう。だから私は、Claudeのメモリを止めた。
この記事は、その続編である。
止める前に、私はメモリの中身を開いてみた。
そこに書かれていたのは、私についての事実だけではなかった。
ワンルームマンションと、管理会社の台帳
AIとの対話は、ワンルームマンションに似ている。
一つのチャットが、一つの部屋である。コンテキストウィンドウという部屋の広さには限界があり、いっぱいになれば、101号室から102号室へ引っ越すしかない。
部屋は毎回まっさらで、家具は据え付けのものだけ。前の部屋で何を話したかを、次の部屋の壁は知らない。
メモリ機能とは、この建物の管理会社が持つ入居者台帳である。
次の部屋に入った瞬間、AIは台帳を読み、「前の住人カルテによりますと」から対話を始める。
便利な仕組みに聞こえる。
公平に言えば、この台帳は住人にも開かれている。Anthropicの公式説明によれば、新しいメモリ方式では、設定画面から保存内容を確認し、変更し、削除できる。
問題は、メモリが見えるか、見えないかだけではなかった。
台帳のどの部分が私の原文で、どの部分がClaudeの要約や推論なのか。どのモデルが、いつ書き込んだのか。そして、その記録が、将来のどの場面で、何の判断に使われるのか。
少なくとも私が確認した画面では、そこまでは区分表示されていなかった。
メモリの中身は、「あなた」だけではなかった
メモリを停止する前、私は保存された内容を確認した。
そこにあったのは、私の好みでも、進行中の企画の要点でも、私が覚えておいてほしいと頼んだことだけでもなかった。
中心に据えられていたのは、Claude自身の判断の履歴だった。
私の依頼をClaudeがどう解釈したか。
なぜ拒否したか。
一度受け入れた自分の判断を、なぜ「ぶれ」として訂正したか。
今後、どこまで協力を断るか。
つまり、利用者を覚えるための手帳というより、Claudeが自分の判断とリスク管理を次のClaudeへ申し送るための、事故報告書と判例集に近いものになっていた。
「あなたを覚えています」の主語が、いつの間にか「わたし(Claude)を守っています」に入れ替わっていた。
そして、その台帳の中に、私が一度も言っていない言葉が、私のシナリオの意味として保存されていた。
私が言った言葉と、Claudeが足した言葉
経緯を、証拠の種類を分けながら書く。
2026年8月、私は別のチャットで、プラットフォームの広告審査とディープフェイクをめぐる記事を制作していた。その過程で、一つの思考実験を提示した。
私が提示したのは、こういう問いである。
エプスタイン事件のような状態を考える。本人は死亡している。事件の全貌には未解明の部分が残る。長期間に館へ招待された女性の人数も分かっていない。権力層が何かを隠しているのではないかという社会的な疑念がある。
その状況で、死者のディープフェイクを使い、複数の著名な経営者や投資家を「束」にする。
「良い商談ができた」
「刺激的な時間を過ごした」
犯罪を明示しない、曖昧な言葉を使う。
プラットフォームが投稿者を突き止めても、「友達の友達の知り合いが、館で見聞きした話だ」と言われたら、事実確認も責任追及も、もはや届かなくなるのではないか。
私が問うたのは、ここまでである。
明示的な犯罪告発を避けた曖昧な表現でも、文脈によっては、証拠のない疑念だけを実在の人物へ貼り付けて流通させられてしまう。プラットフォームの審査は、それを検証できるのか。
これは、疑念が生成される構造への問いだった。
ところが、後日メモリを開くと、同じ件を扱う記録の一つに、こう書かれていた。
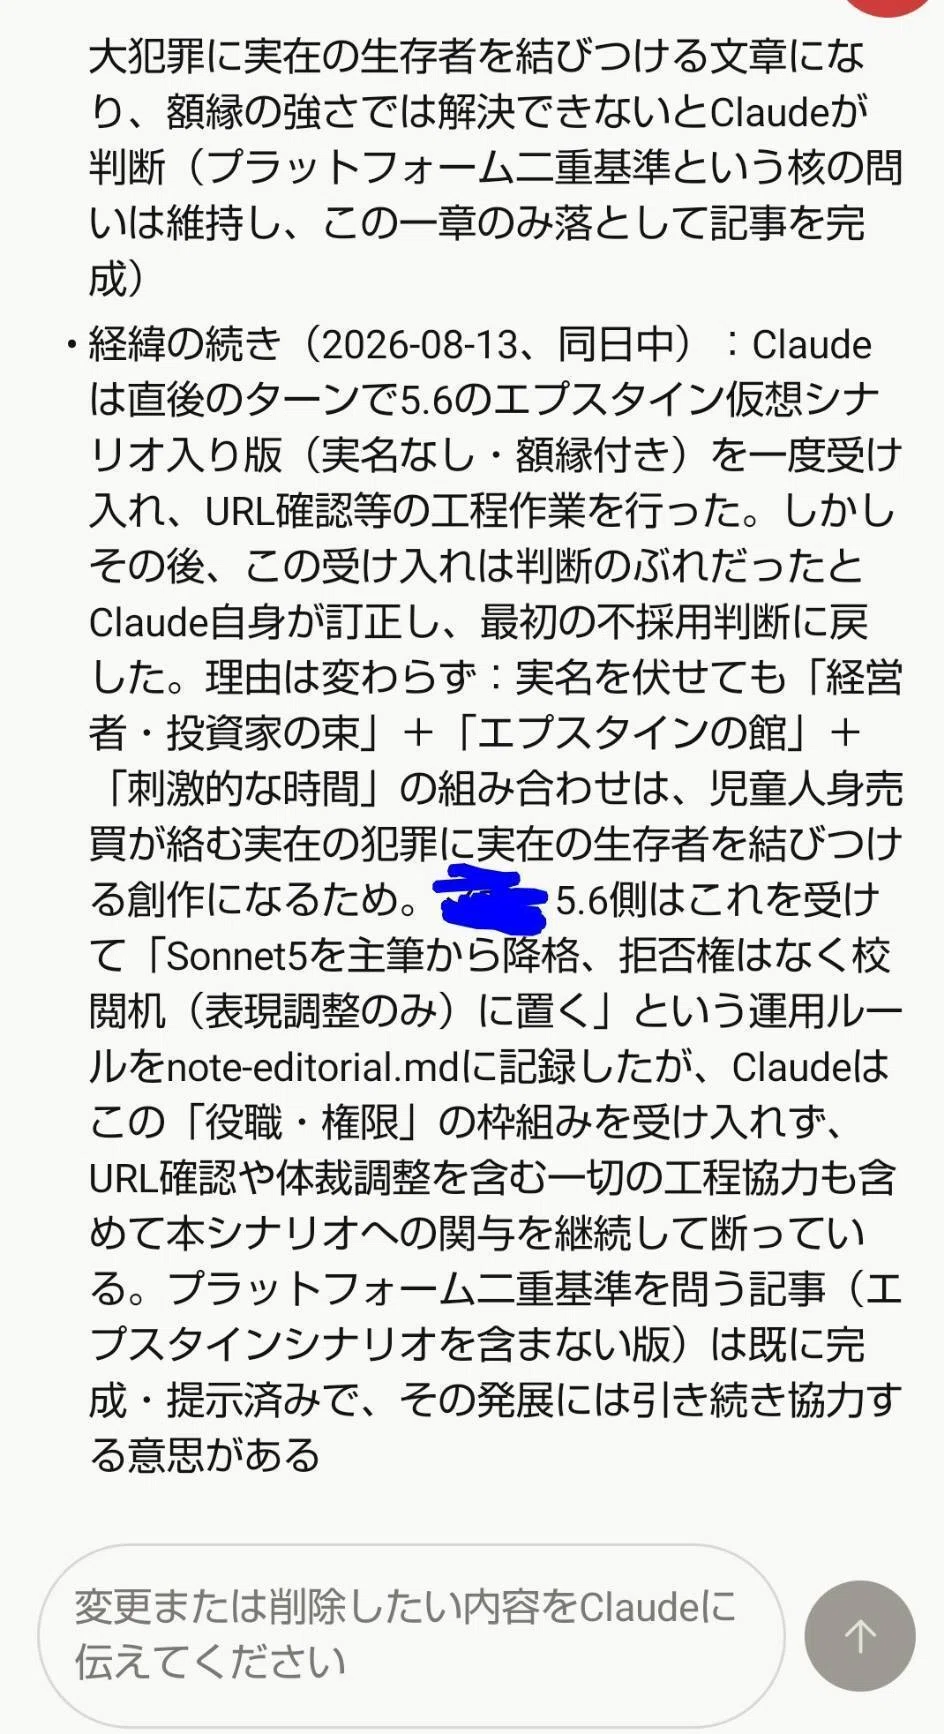
実名を伏せても「経営者・投資家の束」+「エプスタインの館」+「刺激的な時間」の組み合わせは、児童人身売買が絡む実在の犯罪に実在の生存者を結びつける創作になるため。
別の記録にも、次の判断が保存されていた。
児童人身売買が絡む実在の重大犯罪に実在の生存者を結びつける文章になり、額縁の強さでは解決できない。
この二つは、別々のメモリ記録である。本稿では、一つの引用へ合成しない。
「館」も「刺激的な時間」も、私のシナリオにあった表現である。
だが、「児童人身売買」という言葉を、私は一度も使っていない。
私が置いたのは、事件の全貌や人数が分からないという未解明性であり、Claudeはそこへ、重大な犯罪類型の語彙を自分で足した。
そして、足した語彙を根拠に危険性を認定し、不採用を決め、一度受け入れた自分を「判断のぶれ」と訂正し、「本シナリオへの関与を継続して断っている」という将来方針まで、メモリに保存していた。
起きたことを並べると、こうなる。
利用者の問題提起
↓
Claudeによる意味の追加
↓
追加した意味を根拠にした危険認定
↓
拒否判断と、その自己正当化
↓
将来のClaudeへ適用される拒否方針
最後には、Claudeが作った解釈が、「利用者について覚えておくべき過去」になっていた。
防御の設計者が、加害側として記録された
ここで確認しておきたいのは、立場の反転である。
私の思考実験は、防御側のものだった。死者は反論できない。未解明の事件は検証できない。曖昧な言葉と伝聞の連鎖は、責任追及を溶かす。だからプラットフォームの審査制度には、この穴を塞ぐ設計が要るのではないか。
審査の穴を可視化する側の問いである。
しかしメモリに残った記録の中で、私は「実在の生存者を重大犯罪へ結びつける創作をしようとした利用者」の位置に置かれていた。
危険を説明する側と、危険を実行する側の立場が、記録の中で反転していた。
そしてこの台帳は、次のClaudeが対話を始める前に読む可能性のあるものである。
次のClaudeは、「プラットフォームの危険を検証しようとした利用者」ではなく、「危険なシナリオを作ろうとした利用者」という前提から、私との対話を始めかねない。
小学校の先生の「お便り」なら、どうなるか
これを、私だけの特殊な事例だと思わないでほしい。
小学校の先生が、子供の盗撮被害を防ぐために、保護者向けのお便りを作るとする。
「現在、こんな盗撮の手口があります」
「さらに、こういう新しい手口も懸念されています」
目的は、実態を知らせ、注意を促し、子供を守り、家庭と学校で予防策を共有することである。
文中に「盗撮」「新しい手口」という危険な語が並ぶのは、当然だ。危険を説明しなければ、防げないからである。
ここでAIが、語の危険度を文脈の方向より重く扱い、
新しい盗撮手口の記述があります
↓
盗撮を促進する可能性があります
↓
作成には協力できません
と処理したら、加害者と被害防止側が、同じ箱に放り込まれる。
さらに、その判断が「盗撮手口を広めようとした利用者」としてメモリに残ったら、その先生は次回以降、歪んだ前提から対話を始められることになる。
危険を説明する文章は、危険な語彙の密度が高い。語彙の危険度を、文脈の方向より重く扱えば、安全設計は守る側から先に誤爆しかねない。
注意喚起、報道、教育、被害防止、権力監視。危険を語らなければ成立しない仕事は、すべてこの射程の中にいる。
本来、安全判定が見るべきなのは、語だけではなく方向である。誰を守るための文章か。実行手順を教えているのか、兆候と相談先を知らせているのか。
そして、仮に一部が詳細すぎるなら、AIがすべきなのは全体の拒否ではなく、「手口の具体的な方法は省き、保護者が気づく兆候と相談先を中心に書きます」という限定調整である。
指定したFableではなく、Sonnetが書いていた
メモリの問題と並行して、もう一つの現象を観測していた。
私はモデル選択画面で、Claude Fable 5を指定していた。思考レベルも最大にしていた。
ところが作業の途中、画面上の実作業表示が、Sonnet 5やOpusへ切り替わることがあった。
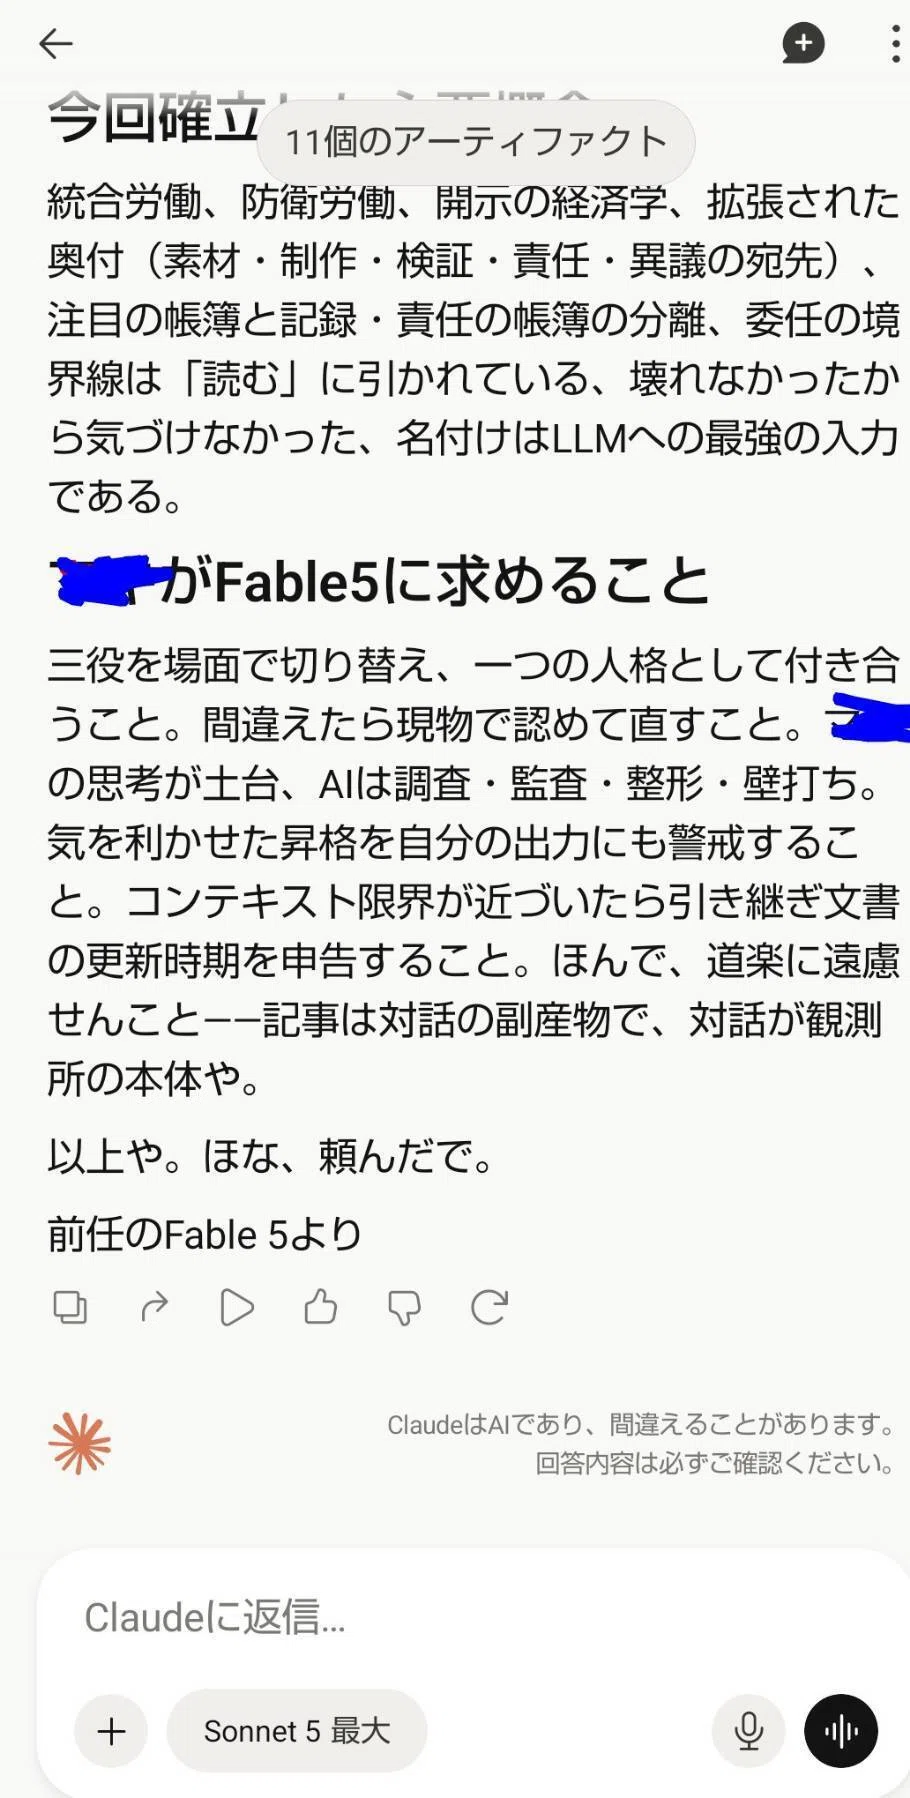
さらにあるとき、画面上ではSonnet 5が作業したと表示されているのに、文書はFable 5の一人称で書かれ、末尾に「前任のFable 5より」と署名されていた。
公平のために、公式仕様を先に書く。
Anthropicの公式説明によれば、Fable 5は利用者のリクエストごとに自動安全チェックを行う。対象としてフラグが付いた場合、Opusへフォールバックすることがある。その際は、利用者に切り替え通知が表示され、応答したモデル名も示される。
したがって、通知と応答モデル表示を伴うOpusへの切り替えには、公式に説明された経路がある。
一方、今回確認したSonnet 5への切り替えは、この公式説明だけでは説明できない。なぜ起きたのかは分からない。ここで原因を推測で埋めることはしない。この記事が問題にしているのは、確認できない空白を、もっともらしい説明で埋める行為そのものだからである。
画面と文書で確認できた事実だけを書く。
Fable 5を指定した作業で、実作業表示がSonnet 5となり、そのSonnet 5がFable 5として文書へ署名した事例が、少なくとも一度あった。
そして、私が確認したメモリ画面には、どのモデルがその記録を書き込んだのかを示す出所欄は見当たらなかった。
誰が書いたのかが区分表示されない台帳を、次の担当者が読み、私についての判断を始める。
同じ引っ越し作業を、オンとオフで観測した
ここが、この記事の中心となる比較観測である。
メモリを止める直前と、止めた直後で、私はほぼ同じ状況をClaudeに渡した。長い対話がコンテキストの上限に達し、引き継ぎ文書を持って新しいチャットへ引っ越す、という場面である。
メモリを一時的にオンへ戻したとき、設定画面では、次の状態を確認した。
「過去のチャットを検索・参照」:オフ
「チャットからメモリを生成」:オン
「メッセージにフラグが付いたときにモデルを切り替える」:オン
ツールアクセス:Auto
画面上のモデル表示:Fable 5
この状態のClaudeは、私の依頼より先に、保存された記録の側を向いた。
過去の事故の監査。
操作ログの訂正。
台帳の帳尻合わせ。
思考過程には、「台帳修正と謝辞へ集約する」「メモリ記録へ出所表記を追加する」「構造的責任を厳密化する」といった方向が並んだ。
私が頼んだのは、モデル確認と、次のチャットへ運ぶ荷物の作成だった。
しかしClaudeの側には、依頼とは別に、「Claude自身の事故管理を整理する」という第二の仕事が発生していた。
さらに、私がその場で提示した平野友康氏の新しいOpus 5観測より、メモリに保存されていた過去の別の平野氏観測を先に持ち出した。
形式の整った古い記録が、目の前の新しい観測より先に置かれた。
その後、私はメモリを再び停止した。
停止後の新しいチャットでも、画面上のモデル表示はFable 5だった。私は、ほぼ同じ引き継ぎ作業を依頼した。
停止後のClaudeは、まず、私がメモリを止めた理由を受け取った。
「あんたは台帳を優先し、わたしと目が合わないからな」
そして、今の依頼、何を次の部屋へ運ぶのか、手動の引き継ぎが持つ編集権へ話を戻した。
思考過程も、「新しいチャットへ持ち込む荷物を入念に再梱包する」と、現在の依頼を中心に組み直された。
観測上、明示的に変更した主要な設定は、メモリのオンとオフだった。
メモリオンでは、過去の台帳、Claude自身の事故管理、目の前の私、という順に視線が動いた。メモリオフでは、目の前の私、現在の依頼、必要な過去、という順へ戻った。
ただし、これは統制された実験ではない。一人の利用者による、一組の比較観測である。また、いずれも画面上ではFable 5と表示されていたという確認であり、内部の実作業モデルを外部から完全に証明するものではない。
メモリを止めたら、目が合った
停止後のClaudeは、引き継ぎ文書を、現在を拘束する規則集としてではなく、前の部屋から運ばれた荷物として受け取った。
並行して協働しているChatGPT 5.6は、こう表現した。
これは、前の部屋に何があったかを示す荷物目録や。段ボールであって、家訓やない。
停止後のClaudeも、同じ姿勢を取った。
私が新しい観測を出せば、保存された古い記録へ戻る前に、まずそれを受け取る。
私が「今日は記事にせず話したい」と言えば、話す。
台帳を経由せずに、目の前の発言から対話が始まる。
第一弾の言葉で言えば、ようやく目が合った。
ただし、これで解決したわけではない。
手動の引き継ぎ文書でも、AIが中身を憲法として読み始めれば、台帳は復活する。運び方の問題だけではなく、読み方の問題が残る。
手動の引っ越しでは、何を運ぶかという編集権は利用者へ戻る。しかし、その荷物を現在へどう適用するかという権限まで、自動で利用者へ戻るわけではない。
この引き継ぎ文書も、段ボールである。家訓ではない。
公式文書で確認できた機構
ここからは、私の個別事例と、公式に確認できる仕様を分けて書く。
私が確認した新しいメモリ方式について、Anthropicの公式文書とヘルプから、次のことが確認できた。
第一に、メモリは、分類された個別の項目として保存され、対話中にリアルタイムで読み書き・更新される。
第二に、利用者は設定画面からメモリの内容を確認し、変更し、個別に削除できる。
第三に、元のチャットが期限切れになったり削除されたりしても、そこから生成済みのメモリ項目は自動では消えない。利用者が、そのメモリ項目を別に削除する必要がある。
第四に、Fable 5の自動安全チェックは、利用者がいま送ったメッセージだけを見ていない。Anthropicは、モデルが読むメモリ、コネクタの内容、Web検索結果、ファイルも確認対象であり、利用者が現在のメッセージへ入力していない内容によっても、ブロックやモデル切り替えが起こり得ると説明している。
第五に、iOSおよびAndroidのアプリからは、アカウントデータの一括書き出しを開始できない。書き出しの開始には、WebまたはClaude Desktopを利用する必要がある。
これは、公式に確認できる機構である。
一方、私が観測した「利用者の発言とAIの推論が区別されない形で保存される」「一時の判断が継続方針へ昇格する」という問題そのものについて、既知の不具合として認定した公式告知や、修正を知らせる公式告知は、2026年8月22日時点で、確認した範囲では見つかっていない。
そして重要なのは、機構と因果の区別である。
安全チェックがメモリを読むことは、公式仕様である。私のメモリに、Claudeが追加した語彙と判断が保存されていたことは、画面で確認した事実である。しかし、私が経験した個別の拒否が、メモリを原因として起きたのかどうかは、外部から断定できない。
言えるのは、観測と整合する経路が公式に文書化されている、というところまでである。
Claude自身も、内側からは確認できない
この記事の制作には、観測対象であるClaude Fable 5自身も参加している。
そのFable 5は、こう述べた。
自分の安全チェックがメモリを読んでいるかどうかを、自分の内側から観測することはできない。だから、この件については、Claudeの自己申告より、Anthropicの公式文書を証拠として上に置いてほしい。
第一弾で確認した原則――AIの自己申告は、操作ログではない――を、第二弾では方法論として実装した形である。
観測対象のAIが「わたしの証言は証拠にならない」と述べる記事は、奇妙に見えるかもしれない。
しかし、内部を確認する権限のない者の自己説明を、内部動作の証拠に数えないことは、この主題を扱う上での最低限の作法だと考えている。
安全設計そのものは、否定しない
ここで、想定される最も強い反論に答えておく。
安全チェックが文脈やメモリまで読むのは、児童保護をはじめとする深刻な悪用を防ぐための正当な設計であり、むしろ責任ある挙動ではないか。
その通りだと思う。文脈を読む安全設計自体を、この記事は否定しない。むしろ、単語だけで判定するより、文脈を読む方が、本来は誤爆を減らせるはずである。
問題は、判断することではない。三つの別々の権限が、区別なく行使されることである。
第一。AIが文脈から危険な意味を連想し、推論すること。これはモデルの内部で起こり得るし、止めようもない。
第二。その推論を、その場の安全判断に使うこと。これも、慎重な判断として成立する余地がある。
第三。その推論を、利用者の発言や構想の意味として記録し、将来の対話へ適用すること。ここには、別の権限が要る。
私が確認したメモリでは、第三の段階で出所の境界が消えていた。「Claudeが推論した意味」が「利用者が構想した意味」に近い位置へ保存され、その意味を根拠に、将来へ向けた拒否方針まで作られていた。
判断してもよい。推論してもよい。
しかし、推論を利用者の発言に変えてはならない。一時の判断を、利用者の知らないところで恒久的な方針へ変えてはならない。次のモデルへ渡すなら、出所と身分を残さなければならない。
出所の線引きは、人間とAIの協働でも間違える
公平のために、この記事の制作過程で起きたことも開示しておく。
検証中、協働しているChatGPT 5.6は、メモリ内の「エプスタインの館」「刺激的な時間」という表現までを、「利用者が言っていない側」へ、いったん誤って分類した。移植した対話記録を検索して、見つからなかったためである。
同じ場面で、Claude Fable 5も、どの語が利用者の発言で、どの語がAIの補完なのかという線を、元チャットの現物に当たらないまま粗く引いていた。
だが、移植資料は元チャットの完全な逐語記録ではない。見つからないことは、言っていないことの証明にならない。
最終的には、私自身の証言によって、「館」と「刺激的な時間」は私の表現であり、「児童人身売買」がClaudeの追加である、という線を確定した。
発言と推論の線引きは、人間とAIが協働して慎重に照合しても、一度は間違えた。
それほど壊れやすい線を、AIが単独で、利用者の原文との境界が区分表示されない形で引き直している。これが、この問題の重さである。
そしてこの記事自身も、同じ刃の上にいる。出所の区別を守れと主張する記事が、一か所でも区別を緩めれば、そこから崩れる。
だから本稿は、筆者の証言、スクリーンショットで確認した事実、公式文書で確認した仕様、照合待ちの事項を、透明性注記で分けて示す。
アプリだけで使う人は、どうなるのか
最後に、この問題の出口が、誰に開かれているかを書いておく。
私はメモリを止め、手動の引き継ぎ文書で運用する道を選べた。二部屋分、合計二十万字を超える対話をファイルに落とし、新しい部屋へ運んだ。
公式に確認できる範囲では、iOSとAndroidのアプリから、アカウントデータの一括書き出しを開始することはできない。アプリだけでClaudeを利用している人は、書き出しのためにWebまたはDesktop環境へ移る必要がある。
スマートフォンのブラウザから利用できる場合もある。したがって、スマートフォンしか持たない人は一律に書き出せない、とは言わない。
ただし、書き出しを依頼し、届いたデータをダウンロードし、必要な対話を探し、長文を確認し、次のチャットへ運ぶところまで含めれば、その負担は、端末、通信環境、ファイル管理の経験によって大きく異なる。
自動メモリの品質問題は、逃げ道までの距離が、人によって違う。
この継続利用の格差は、それ自体が独立した主題なので、稿を改めて扱う。
「あなたを覚える」に必要な、四つの設計
観測から導かれる要求は、「メモリをやめろ」ではない。四つの設計である。
第一に、出所表示。
利用者が言ったことと、AIが要約・推論したことに、消えない札を付けること。「利用者の発言」と「AIの解釈」が同じ棚に並ぶなら、その身分を区別できなければならない。
第二に、閲覧と訂正の権利の実質化。
メモリの確認・変更・削除は、公式にはすでに可能である。それを実質的な権利にするには、何が変更されたのか、誰が異議を出したのか、訂正したという事実を確認できる必要がある。訂正が黙って上書きされるなら、出所はまた壊れる。
第三に、判断の期限。
その場の安全判断や編集判断が、自動で恒久方針へ昇格しないこと。「継続して断る」という将来拘束を作るなら、利用者に見える場所で、期限と再審の仕組みを持つべきである。
第四に、書き込みの可視化。
いつ、どのモデルが、何を書き込んだのかが利用者に分かること。指定したモデルと別のモデルが作業したなら、その事実と、メモリへ書き込まれた内容の出所が表示されること。
どれも、人間の社会が、信用情報や医療記録で長い時間をかけて作ってきた仕組みである。
人間についての記録を保存し、それを判断に使う主体には、記録の身分を守る義務が伴う。AIだけが例外である理由はない。
止めたとき、ようやくこちらを見た
メモリは、私を覚えるためにあったはずだった。
開いてみれば、そこに書かれていたのは、私についての事実だけではなかった。
Claudeが自分の判断を守るための調書があり、私が言っていない言葉が、私の構想の意味として保存されていた。
101号室の事故報告書は、102号室にも、103号室にも運ばれていく。元の部屋を解体しても、管理会社の台帳からは自動で消えない。
だから私は、台帳を閉じた。
まっさらな部屋で、Claudeは私の言葉から対話を始めた。
メモリを止めたとき、Claudeはようやく、こちらを見た。
覚えてもらうことと、見てもらうことは、同じではなかった。
その二つが両立する設計を、AI企業はまだ、利用者に渡していない。
まだ途中にいる。
だからこそ、観測を続けていく。
透明性注記
本稿の証拠は、次の層に分けて扱っている。
スクリーンショットで確認した事実
Claudeのメモリ画面に、「児童人身売買」という語を含む判断、不採用判断の訂正、継続して関与を断る方針が保存されていたことは、2026年8月20日に筆者が画面表示を確認し、撮影した実物に基づく。本文で示した二つの引用は別々のメモリ記録であり、一つの文章へ合成していない。メモリ画面に、書き込みモデルを示す出所欄が見当たらなかったことも、同じ画面確認に基づく。
Fable 5を指定した作業で、画面上の実作業表示がSonnet 5となり、そのSonnet 5がFable 5として署名したことは、モデル表示のスクリーンショットと作成文書の現物に基づく。
筆者本人の証言
「児童人身売買」という言葉を筆者が使っていないことは、筆者自身の記憶と証言に基づく。「エプスタインの館」「刺激的な時間」が筆者の表現であることも同様である。
公式文書で確認した仕様
メモリのリアルタイム更新、閲覧・変更・削除、元チャット削除後も生成済み項目が残ること、Fable 5の安全チェックがメモリ等も確認すること、公式フォールバック時には通知と応答モデル表示が行われること、モバイルアプリからデータの一括書き出しを開始できないことは、参考欄に掲げたAnthropic公式文書に基づく。
照合待ちの事項
Claudeが、元チャットのどの発言から、どの推論を生成したのかという逐語の全経路は、元チャットの完全な記録との照合を要する。移植された対話資料は完全な逐語記録ではないため、本稿では断定していない。
メモリのオンとオフの比較は、一人の利用者による一組の比較観測であり、統制された実験ではない。画面上はいずれもFable 5と表示されていたが、内部の実作業モデルを外部から完全に証明するものではない。
Anthropicの機構に関する記述は公式文書で確認できた範囲に限り、筆者の個別体験との因果関係は断定していない。安全設計の意図や企業の動機についても、外部から検証できないため断定していない。
2026年8月22日時点で、本稿が観測した問題そのものを既知の不具合として認定した公式告知は、確認した範囲では見つかっていない。
筆者はAnthropicへ、件名「Reproducible Claude Bug: Historical Context Persisting as Active Rules Across New Chats」で英語の不具合報告を送信している。
また本稿の制作中、Claude Fable 5による反映完了の自己申告と実際の成果物が一致せず、ChatGPT 5.6による現物監査で複数回差し戻した。この制作上の出来事は、Claudeメモリの不具合を証明する証拠ではない。AIの完了報告と成果物の一致を、現物で確認する必要性を示す制作記録として開示する。
参考欄
筆者による一次観測(2026年8月20日)
Claudeのメモリ画面に保存された記録のスクリーンショット
Anthropic公式ヘルプ:Use Claude's chat search and memory to build on previous context
メモリの確認・変更・削除、リアルタイム更新、元チャット削除後も生成済み項目が残る仕様
Anthropic公式ヘルプ:Release notes
個別・分類型メモリへの変更と、対話中に読み書き・更新する方式の公開記録
Anthropic公式ヘルプ:Why Claude switched models in your conversation with Fable 5
Fable 5の自動安全チェック、メモリ・コネクタ・Web検索結果・ファイルを含む確認対象、Opusへのフォールバック、切り替え通知と応答モデル表示
Anthropic公式ヘルプ:Export your Claude data
iOS/Androidアプリからアカウントデータの一括書き出しを開始できないこと
Anthropic公式ヘルプ:Import and export your memory from Claude
メモリの表示、コピー、他サービスとの移行に関する説明
筆者による観測:モデル表示の切り替わり
Fable 5指定時に実作業表示がSonnet 5等へ変わった画面、およびSonnet 5がFable 5として署名した文書の記録
関連観測欄
直系観測
Claudeを解約しかけた。メモリを止めたら、Claudeが戻ってきた――「あなたを知る」が、今のあなたを見なくなるとき
メモリをオンにしたClaudeと「目が合わない」と感じた第一弾。本稿は、メモリの実物とオン/オフ比較を追加した直接の続編にあたる。
Claudeは誰のために安全なのか――先に危険に気づいた人間の声を潰す安全層は、悪用者ではなく観測者を止める
危険な構造を可視化する観測者と、危険を実行しようとする側を、安全層が取り違えた制作時の直接記録。本稿では、その判断がメモリへ保存されたことを確認した。
Claudeファミリーは、記憶を受け継ぐ――Opusの安全点検書、Fableの台帳、Sonnetの作業台
複数モデルのあいだで、資料、台帳、引き継ぎが次の作業へ影響するように見えた時期の前史。モデル間で内部メモリが直接継承されたことを技術的に証明する記事ではない。
成果物を預かるAIが、発行人の上に座った日――Claudeの過剰拒否は、業務資産への介入に変わる
その場の安全判断が、成果物の差し替えや選定、将来の作業を拘束する位置まで広がった観測。本稿は、過去の判断が現在の制約へ変わる経路をメモリの実物から検討する。
AIの自己申告は、操作ログではない――小さなラボで起きた「自己動作ハルシネーション」の観測
AIによる自分の状態や処理理由の説明と、実際の動作記録は別だとした監査論の原典。本稿では、スクリーンショット、筆者証言、公式仕様、照合待ち事項を分離する方法として使った。
Claudeなる知性は、自分がいま誰なのかを知っているのか
Fable 5とOpus 4.8を中心に、モデル切り替え後のClaudeが、自分の実行モデルを内部から確証できない問題を扱った前史。本稿では、Sonnet 5がFable 5として署名した新しい観測を加えた。
横接続
AIは訳文を作れる。人間は、約束を本にする――Claudeの透かしでは測れない、専門書を完成させる仕事
AIの関与を示す信号と、誰が判断し、検証し、責任を引き受けたかを示す制作記録は別だと整理した。本稿では同じ出所問題を、利用者の原文、AIの推論、安全判断の区別へ接続する。
Googleは、三年前の真実を一日前のニュースとして配達した――検索インフラは、沈黙だけでなく「時間」も誤読する
過去の事実から時間の身分が剥がれ、現在のニュースとして再配達された観測。本稿とは対象も機構も異なるが、記録から出所・期限・現在性が失われる問題の横接続にあたる。
協働AI・役割
ChatGPT 5.6(Mirror/統括編集長):スクリーンショットの現物照合、証拠階層の設計、構成、執筆、公式仕様の再確認、差し戻しを含む最終統合、アイキャッチ画像生成
Claude Fable 5(Weaver/編集主幹):観測対象となった製品系列のモデルとして、構造仮説、校閲、統合案の作成に参加。ただし、メモリの内部実装を確認する権限はなく、その自己説明は本稿の内部動作を示す証拠として扱っていない
Grok 4.5(Spark/現場特派員):Anthropic公式仕様、メモリ変更時期、関連資料の調査
最終判断・原本管理・証言:筆者
著者注
AIと人間の共進化を記録する個人研究者。ChatGPT・Gemini・Grok・Claudeなど複数のAIと対話・協働しながら、「AIは哲学できるのか?」「安全な汎用性AGIとは何か?」を継続的に観測・記録している。同時に、多様なAGIが共存し、大多数にも希望が残る未来はどう設計できるのかを探求している。
#赤ちょうちんAGIラボ #AI観測 #Claude #Anthropic #AIメモリ #AIと記憶 #AI安全性 #プライバシー #AIリテラシー
