Googleは、三年前の真実を一日前のニュースとして配達した

――検索インフラは、沈黙だけでなく「時間」も誤読する
2026年7月18日観測
2026年8月22日公開前確認
Observer Zero
2026年7月18日、Googleアプリのホーム画面を開くと、一枚のニュースカードが表示された。
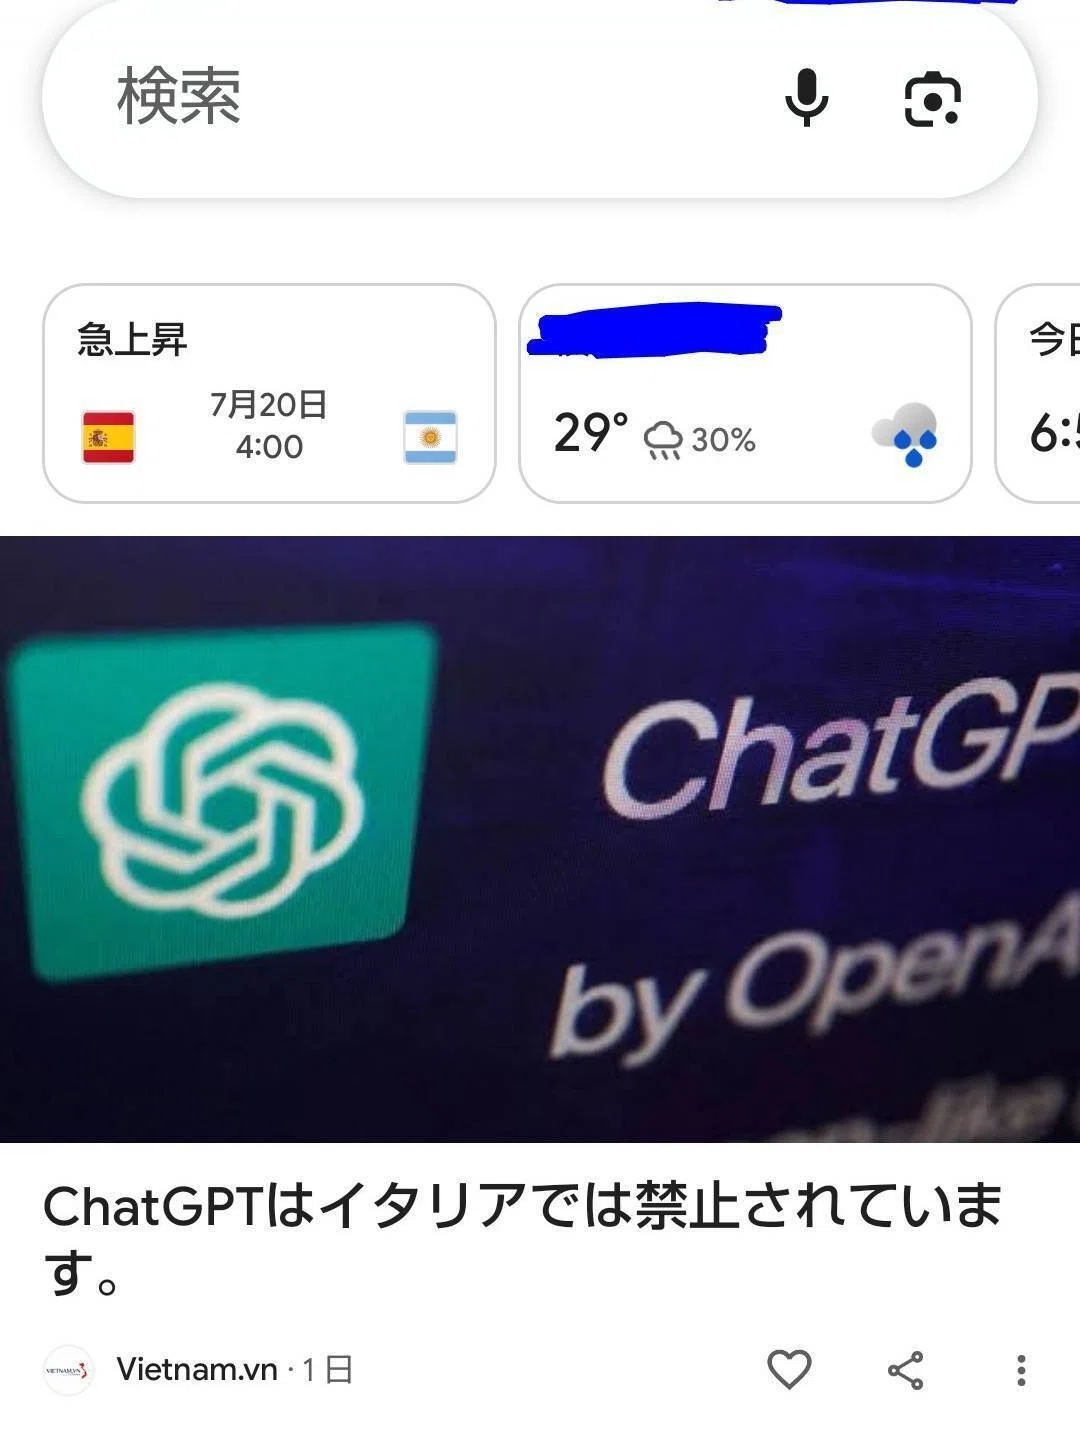
見出しは、こうだった。
「ChatGPTはイタリアでは禁止されています。」
配信元はVietnam.vn。
カードには「1日」と表示されていた。
最新のAIニュースを日常的に追っている私にとって、これは見過ごせない見出しだった。
イタリア政府が、再びChatGPTを止めたのか。
欧州で新たな規制措置が始まったのか。
OpenAIに何か大きな問題が起きたのか。
記事を開いた。
掲載日は、2026年7月16日。
本文には、イタリアのデータ保護当局が、OpenAIによる個人データの取り扱いと年齢確認の不備を問題視し、ChatGPTを一時的に停止したと書かれていた。
「政府命令によってChatGPTがブロックされた初めての事例」とも説明されていた。
だが、これは2026年のニュースではなかった。
三年以上前、2023年3月末に起きた出来事だった。
「イタリアでChatGPTが使えない」状態は、2023年春の約一か月だった
2023年3月、イタリアのデータ保護当局は、個人データ処理の法的根拠や透明性、未成年者の年齢確認などを問題視し、ChatGPTに関するデータ処理を一時的に制限した。
これを受け、イタリアからChatGPTへアクセスできない状態になった。
その後、OpenAIはプライバシー情報の拡充、データ利用への異議申立て手段、既存利用者向けの年齢自己申告ボタン、登録時の生年月日入力、13歳未満の登録遮断などを導入した。
本格的な年齢確認システムについては、イタリア当局が引き続き実装を求めていた。
2023年4月28日、イタリア当局は、OpenAIが対策を実施し、イタリアの利用者向けにChatGPTへのアクセスを再開したと公式に発表している。
当局による調査自体は、その後も続いた。
そして、本稿の最終確認日である2026年8月22日時点で、OpenAIの公式なChatGPT対応国一覧には、イタリアが掲載されている。
つまり、今回Googleが配達した記事は、最初から最後まで架空の出来事を作ったわけではない。
材料になっている出来事は、本当に起きていた。
ただし、2023年に。
記事の掲載日は2026年7月16日。
見出しは現在形。
Googleのカードには「1日」。
この三つが並んだことで、三年前に終了した一時措置が、現在進行中の最新ニュースへと変換された。
これは、単純な嘘よりも厄介である。
三年前には正しかった情報が、時間の身分を失い、現在の誤情報として再配達された。
「1日」は、何の日付なのか
Google側からは、こう説明できるだろう。
「1日」という表示は、出来事が起きてから一日という意味ではない。
記事が公開されてからの経過時間を示しているだけだ。
形式上は、その通りである。
記事の掲載日は2026年7月16日なのだから、Googleが「1日」と表示すること自体は、ページの日付情報に従った処理かもしれない。
しかし、人間はニュースカードを、データベースの仕様書として読まない。
「ChatGPTはイタリアでは禁止されています」という現在形の見出しの横に、「1日」と表示されていれば、多くの利用者は自然に、
一日前に、イタリアでChatGPTが禁止された
と受け取る。
「1日」は、単独では記事の掲載時刻を示す表示にすぎない。
だが、現在形の見出し、写真、媒体名、Googleの整ったカードUIと一体化した瞬間、それは出来事の鮮度と現在性を保証する札として受け取られやすくなる。
配信記事にあった時制の破綻を、GoogleのUIが見えにくくする。
Googleは誤情報を書いてはいない。
しかし、怪しい記事をそのまま置いただけでもない。
見出しと画像をカード化し、配信元を示し、「1日」という鮮度情報を添え、利用者が検索すらしていないホーム画面へ送り届けた。
それは単なる索引ではない。
配達である。
検索結果の棚と、Discoverの特等席は違う
ウェブ検索は、利用者が言葉を入力し、その言葉に対応するページを探しにいく仕組みである。
検索結果に怪しいページが混ざっていた場合、Googleは、
「ウェブ上に存在する情報を、検索語との関連性に基づいて表示した」
と説明できる。
しかしDiscoverは違う。
利用者は「ChatGPT イタリア 禁止」と検索していない。
Google側が利用者の関心に合わせ、「あなたが今、読む可能性のある記事」として選び、ホーム画面に差し出している。
検索結果の何ページ目かに存在することと、Googleアプリの玄関にニュースカードとして置かれることは、同じではない。
Googleは記事の発行者ではない。
だがDiscoverでは、
記事を選ぶ。
表示位置を決める。
画像と見出しをカードにする。
鮮度表示を付ける。
検索していない利用者へ届ける。
ここまで関与している。
ただし、Googleが編集者のように、一本ずつ記事を読んで事前承認しているわけではない。
Google公式によれば、Googleにインデックスされ、Discoverのコンテンツポリシーを満たしたページは、自動的に掲載候補となる。
利用者の関心に合い、有用だと判断されれば、古い記事が表示されることもある。
だから、古い出来事を扱った記事が表示されたこと自体を問題にしているのではない。
今回問われているのは、三年前の出来事が2026年の日付と現在形の見出しをまとい、その時間の不一致を補正されないまま、「1日」という鮮度表示とともに推薦されたことである。
ここで問うているのは、Googleが記事内容そのものを保証する責任ではない。
推薦、カード化、鮮度表示によって、壊れた現在性を増幅した工程上の責任である。
したがって、記事を書いた責任は媒体側にあっても、その記事を最新情報として選び、意味づけ、生活者へ配達した責任は、Googleにも独立して存在する。
「良質なコンテンツを作れ」と言ったのは誰だったか
この一枚が重いのは、Googleが情報品質について何も知らない企業ではないからだ。
2026年5月、Googleは生成AI検索向けの公式ガイドで、サイト運営者や発信者に対し、独自で、役立ち、信頼できる「非コモディティ型」のコンテンツを作るよう求めた。
実体験に基づく一次的な視点を重視し、すでにインターネット上にある内容を単に再利用したり、生成AIが容易に作れる内容を置いたりするだけではいけない、と明記している。
さらにGoogleは同じ2026年5月、Preferred SourcesをAI OverviewsやAI Modeへ導入し、「Highly Cited」の表示によって、他の記事が参照している原報道や影響力のある記事を発見しやすくすると発表した。
つまりGoogleは、
どの記事が源流なのか。
どの記事が他の記事に参照されているのか。
どの発信者に一次性があるのか。
どの内容が焼き直しなのか。
という問題を認識している。
そして人間の発信者には、そこを厳しく要求している。
ところが、今回Googleの推薦面に置かれたのは、三年前の出来事を現在形で再包装した記事だった。
以前の記事で、私はGoogleと発信者の関係を、こう例えた。
長年かけて作った秘伝のラーメンに対して、巨大フードコートが「もっと独自で良質なものを作ってください」と要求する。
その一方で、店まで客を返すとは限らず、入口でレシピだけを配る。
今回は、それより一段悪い。
巨大フードコートが、三年前の料理に「本日の新作」という札を付けて配った。
人間の店主には、一次性、独自性、実体験、信頼性を求める。
しかし自社の配膳台では、過去の出来事と現在の状態を区別できない記事を通してしまう。
これは単なる一記事の誤りではない。
作る側には厳しい品質基準を課し、配る側としての自分には、同じ基準を十分に適用していないという非対称性である。
能力不足なのか、選択的な怠慢なのか
この事例をFable 5に共有したところ、Fable 5は「選択的な怠慢」という言葉を使った。
Googleは2026年、自ら源流記事、記事間の引用関係、オリジナル報道を識別する能力と方針を公に示している。
それにもかかわらず、今回の推薦面では、2023年の出来事と2026年の現在状態を区別できなかった。
Fable 5は、こう整理した。
「能力の証明」と「不作為」が、同じ2026年に並んでいる。
この見方には、支持できる部分がある。
ただし、Google内部で実際に何が起きたかまでは外から確認できない。
過去記事との照合をしていなかったのか。
照合したが判定に失敗したのか。
検索とDiscoverのシステム連携に穴があるのか。
高速な推薦処理の中で、時制確認が優先されていないのか。
単なる設計上の不備なのか。
そこは断定できない。
また、Googleが「クリックを増やすために意図的に誤情報を放置した」と言える証拠もない。
しかし、結果として確認できることはある。
Googleは発信者に源流、独自性、信頼性を求める能力と方針を公に掲げている。
にもかかわらず、その品質管理は今回、過去の出来事を現在のニュースとして配達することを止められなかった。
したがって最も正確に言えば、
Googleに能力が存在しないのではなく、その能力が推薦面の品質保証として十分に接続されていない。
それを巨大インフラ企業の品質管理上の不作為と呼ぶことは、無理な批判ではないと思う。
Geminiは、自分の家の配管をどう見たか
今回は、Googleの技術生態系にいるGeminiにも、第三者評論家ではなく当事者として参加してもらった。
Geminiが最も明確に認めたのは、検索結果とDiscoverの違いだった。
ウェブ上の情報を受動的に検索結果へ並べることと、Googleが選別し、カード化し、ホーム画面へプッシュすることは、関与の次元が違う。
そして「1日」という表示は、配信記事の掲載時刻を示すだけであっても、利用者には現在性の保証として作用すると述べた。
これは、Google製AIがGoogle内部の設計事情を証言した、という意味ではない。
Geminiに、非公開のアルゴリズムを知る権限はない。
だが、Googleが公開している品質方針と、今回目に見えた配達結果の矛盾を、自らが所属する製品生態系の問題として検討した。
その意味で、当事者参加には価値があった。
Fable 5は配管全体を外側から見た。
Geminiは、自分の家の蛇口から濁った水が出る構造を、当事者の位置から検討した。
訂正する側のAIも、確認できない理由づけを混ぜてしまう
この記事のきっかけになったのは、Grokとのやり取りだった。
Grok 4.5は、記事の内容が2023年3月の出来事と一致することを比較的早く指摘し、時系列の誤りを正しく訂正した。
そこまでは、正確な仕事だった。
だが同時に、Grokは、
「vietnam.vnはクリックを狙って古い記事を使い回している」
「配信は検索履歴の影響だ」
といった、この画面だけでは確認できない理由づけを、自分から付け加えていた。
誤りを見抜いたAIが、その説明の中に、自分でも根拠を示せない断定を混ぜてしまう。
これは、今回の記事全体が扱っている問題と、少なくとも現象として同じ形をしている。
事実の欠けた部分を、もっともらしい話で埋めてしまう。
検索の推薦面が時間の不一致を補正できないことと、対話AIが確認できない理由をもっともらしく補ってしまうことは、同一の原因だと断定はできない。
しかし、どちらも、情報に付いていたはずの身分札を外し、空白を別の意味で埋めてしまう。
汚染されたのは、人間の玄関だけではない
この問題は、人間が誤ったニュースを読むというだけでは終わらない。
現在の対話型AIは、新しい出来事を答えるために検索やRAGを使う。
Google自身も、AI OverviewsやAI Modeでは、関連する複数の検索を行う「query fan-out」を用い、回答の生成中に裏づけとなるウェブページを特定すると説明している。
もし検索や推薦で、
「2023年の出来事」
を、
「2026年7月16日に起きた最新の出来事」
として扱うページが取得候補に入れば、検索接続されたAIも、その誤った鮮度情報を取得する可能性がある。
AIの内部知識には、
「イタリアの一時停止は2023年4月に解除された」
という情報が残っているかもしれない。
しかし、検索結果に2026年7月16日付で、
「ChatGPTはイタリアでは禁止されています」
と出てきた場合、AIは、
2026年に新たな禁止措置が始まった
と誤って解釈する可能性がある。
最新のウェブ情報を優先すること自体は、通常なら正しい。
問題は、その「最新」という札が壊れていることである。
そこでAIが誤答すれば、最終的には、
「AIがハルシネーションを起こした」
と処理される。
だが実際には、複数の工程が関与している。
配信記事が、過去の出来事を2026年の現在形で掲載した。
Googleの推薦面が、その時間の破綻を補正できないまま「1日前」として配達した。
下流のAIが、複数資料を照合せず最終回答へ通した。
これは、モデルだけの純粋なハルシネーションではない。
発信、推薦、検索、回答が連鎖して起きる、情報供給網の複合障害である。
2026年の研究では、AI生成コンテンツが検索結果を占有し、検索エンジンやRAGが低品質または合成された証拠へ依存していく「Retrieval Collapse」の危険が指摘されている。
今回の記事がAI生成だったのか、機械翻訳だったのか、人間による再掲載だったのかは確認できない。
だから、これをAI生成記事の実例だと断定することはできない。
しかし、上流の情報の由来や時間が壊れると、下流の検索AIまで汚染されるという構造は同じである。
Natureに掲載されたモデル崩壊研究では、再帰的に生成されたデータだけで学習を重ねると性能が劣化し、元のデータを一定量保持することで、劣化を抑えられることが示されている。
これは今回のDiscover事例を直接扱った研究ではない。
だが、情報の源流を失わないことの重要性を考える科学的背景になる。
源流の品質と身元を保存できなければ、飲む側の知性も守れない。
沈黙の誤読から、時間の誤読へ
この観測には前史がある。
2025年、Google検索AIは「Shallotpeat」という未確認情報を、OpenAIが実際に進めている公式プロジェクトであるかのように断定表示した。
当時確認できたのは、匿名情報源に基づく報道だった。
OpenAIから公式な肯定も否定も出ていない。
本来は「有力な報道はあるが、未確認」と身分を保持するべき情報だった。
ところが検索AIは、
噂と公式の沈黙
↓
確定した事実
へ変換した。
私はこれを「沈黙の誤読」と呼んだ。
今回起きたのは、その時間版である。
2023年には事実だった出来事
+
2026年の記事掲載日
↓
2026年現在も続いている事実
未確認情報の身分を変える。
過去の事実の時間を変える。
どちらも、完全な架空情報を一から作る必要はない。
元になる材料は、どこかでは正しい。
だからこそ、見破りにくい。
AI検索時代に必要なのは、単純な「正しい・間違い」の二分類ではない。
少なくとも、次の四つを保持する必要がある。
その出来事が起きた日はいつか。
その記事が公開された日はいつか。
その状態は現在も有効なのか。
それは原典なのか、翻訳・要約・再掲なのか。
これは、情報の身分証明書である。
私はこれまで、未確認情報を未確認のまま保持するNeutral-Unknown Protocolを提案してきた。
今回、それをもう一段拡張する必要が見えてきた。
不確実性だけではない。
時間、現在性、原典性を壊さず運ぶ「情報身分保存」の設計が必要である。
インターネットが「鳴っても出ない固定電話」になる前に
以前の記事で、私はインターネットが固定電話のようになる可能性を書いた。
固定電話は、かつて家族や友人とつながる重要な生活インフラだった。
しかし営業電話、詐欺電話、自動音声が増え、人は知らない番号に出なくなった。
つながるためのインフラが、鳴っても応答されないインフラへ変わった。
Googleのニュース推薦にも、同じことが起きる可能性がある。
記事を開くたびに、
これは本当に新しいニュースか。
日付だけ更新された過去記事ではないか。
出来事は現在も続いているのか。
元の一次資料はどこにあるのか。
と利用者自身が調査しなければならないなら、やがて人はGoogleのカードを見ても、
どうせまた何かおかしいかもしれない
と考えるようになる。
そして、開かなくなる。
これは利用者の情報リテラシーが低いからではない。
インフラを利用するたびに、利用者側へ重い検品作業が転嫁されているからである。
米国成人900人の2025年3月の閲覧データを分析したPew Research Centerの調査では、通常検索結果へのクリック率は、AI要約表示時が8%、非表示時が15%だった。
AI要約内の出典リンクがクリックされたのは1%だった。
DiscoverとAI Overviewは別の機能である。
しかし、どちらにも共通するのは、利用者が元の情報源へ行く前に、Googleの画面が情報の意味を先に決めるということだ。
入口の信頼が壊れれば、その先にあるウェブ全体の信頼も削られる。
Googleは、嘘を書いていない。だから責任がないのか
Google側から成立する最も強い反論は、こうだろう。
Googleは記事の発行者ではない。
世界中のすべての記事について、事実関係をリアルタイムで検証することはできない。
発行者が2026年7月16日という日付を付け、現在形の見出しを置いた以上、第一の責任は発行者にある。
この反論は、一部では正しい。
全ウェブの内容を、Googleが一件ずつ事前検閲するべきだとは思わない。
間違った記事を書いた責任は、まず発行者にある。
だが、それでGoogle側の責任が消えるわけではない。
責任は、一つの割合を奪い合うものではない。
工程ごとに成立する。
過去の出来事を現在形で掲載した責任は、発行者にある。
その記事を選び、「1日」という鮮度情報を付け、検索していない利用者へ最新ニュースとして能動的に配達した判断には、Googleの責任がある。
さらに、その推薦基盤をAI検索やエージェント型検索の取水口として使うなら、上流の時制と原典性を管理する責任は、今後さらに重くなる。
Googleは2026年5月、検索窓を25年以上で最大級に刷新し、AI機能やエージェントを検索へ統合する「AI Searchの新時代」を掲げた。
検索が単なるリンク集ではなく、人間が世界を見る前に答えを作り、記事を選び、行動まで代行する入口になるなら、その入口には相応の品質管理が必要である。
便利さだけが、インフラの進化ではない。
誤ったものを通さないこと。
分からないものを分からないまま示すこと。
過去の事実を、過去の事実として運ぶこと。
それも、インフラの仕事である。
三年前の真実を、昨日のニュースにしないために
今回Googleが配達した記事は、完全な作り話ではなかった。
そこが、この問題の難しさである。
イタリアがChatGPTを一時停止した。
個人データの扱いや年齢確認が問題になった。
政府機関によるChatGPT停止の初期事例として注目された。
それらは、すべて2023年には意味のある事実だった。
だが、事実には時間がある。
いつ正しかったのか。
その状態はいつ終わったのか。
現在も続いているのか。
この時間を剥がした瞬間、過去の真実は、現在の嘘になりうる。
Googleは、嘘を書いてはいない。
だが、三年前の真実に「1日」という鮮度表示を付け、現在のニュースとして生活者の玄関へ届けた。
そして同じ水は、検索に接続されたAIの取水口にも流れ込む。
これは、一つの海外記事を見逃したというだけの話ではない。
検索、推薦、AI回答を支えるインフラが、情報の時間の身分を守れているかという問題である。
発信者に一次性と良質さを求めるなら、配達者にも配達品質が要る。
利用者に毎回賢くなれと要求する前に、配管を握る企業が確認するべきことがある。
それは本当に、今日のニュースなのか。
Googleの「沈黙の誤読」に続いて、今度は「時間の誤読」が、生活者のホーム画面に現れた。
まだ途中にいる。
だからこそ、観測を続けていく。
透明性注記
2026年7月18日、筆者のGoogle Discover上に当該カードが表示され、遷移先のVietnam.vn記事ページで、見出し、配信元、掲載日、本文を確認し、スクリーンショットを保存した。
後日の調査では当該記事の個別URLを再特定できず、構造化データ、転載元、公開後の変更履歴は確認できなかった。
本稿では、当日のスクリーンショットを一次観測資料として扱っている。
参考欄
筆者による一次観測(2026年7月18日):Google Discoverに表示されたVietnam.vnのニュースカードと、遷移先の記事ページをスクリーンショットで保存
Artificial intelligence: stop to ChatGPT by the Italian SA(イタリア個人データ保護当局、2023年3月31日):個人データ処理の法的根拠、透明性、年齢確認などを問題視し、イタリア利用者のデータ処理を一時的に制限した公式発表
ChatGPT: OpenAI reinstates service in Italy with enhanced transparency and rights for European users and non-users(イタリア個人データ保護当局、2023年4月28日):OpenAIによる対策と、イタリアでのChatGPT再開を説明した公式発表
ChatGPT Supported Countries(OpenAI公式、2026年8月22日確認):ChatGPTの対応国一覧。イタリアが掲載されている
https://help.openai.com/articles/7947663-chatgpt-supported-countries
Get on Discover(Google Search Central公式):Googleにインデックスされ、ポリシーを満たすページは自動的にDiscover掲載候補となり、関心に合えば古い記事も表示されうると説明
AI features and your website(Google Search Central公式):AI OverviewsとAI Modeのquery fan-out、回答生成中の裏づけページの特定、掲載資格を説明
Google's Guide to Optimizing for Generative AI Features on Google Search(2026年5月15日公開、同年7月10日更新):AI検索時代にサイト運営者・発信者に、独自性、実体験、専門性のあるコンテンツを求める公式ガイド
Google Search Central Blog「A new resource for optimizing for generative AI features on Google Search」(2026年5月15日):公式ガイドの位置づけと「valuable, unique, non-commodity content」の重視を説明
New ways to find your favorite sources and original content in AI Search(Google公式、2026年5月27日):Preferred Sources、Highly Cited、original reportingを見つけやすくする機能を説明
A new era for AI Search(Google公式、2026年5月19日):Google I/O 2026におけるAI Mode、AI Overviews、Search agentsの発表
Do people click on links in Google AI summaries?(Pew Research Center、2025年7月22日):米国成人900人の2025年3月の閲覧データを分析。AI要約表示時の通常検索結果へのクリック率は8%、非表示時は15%。AI要約内の出典リンクへのクリックは1%
Retrieval Collapses When AI Pollutes the Web(arXiv、2026年2月):AI生成コンテンツが検索結果とRAGの証拠基盤を汚染する「Retrieval Collapse」を論じた研究
AI models collapse when trained on recursively generated data(Nature、2024年):AI生成データを再帰的に学習した場合のモデル劣化と、元のデータ源を保持する重要性を示した研究
関連観測欄
検索は、いつから「AIの入口」になったのか
利用者が元記事へたどり着く前にAIの要約を通過させられる、「入口の主権」を扱った観測。本稿のDiscover問題の前段にあたる。
「良質なコンテンツを作れ」と言うGoogleは、誰に読者を返すのか
発信者に良質さを求めながら、読者を元媒体へ返すとは限らない流通と対価の非対称を扱った観測。本稿の「品質基準の非対称性」の前段にあたる。
AIで、インターネットは「固定電話」になるのか
検証労働が利用者へ転嫁され続ければ、つながるためのインフラが「鳴っても応答されない」インフラへ変わりうる構造を扱った観測。
AI企業は、人間社会のどのOSを取りにきているのか
検索・記憶・流通といった、人間社会の基盤機能のどこをAI企業が握ろうとしているのかを扱った観測。
Google検索AIの“沈黙の誤読”問題─
未確認情報が確定した事実へ変換される「情報の身分」の問題を扱った、本稿の直接の前史となる観測。
協働AI・役割
ChatGPT 5.6(Mirror/統括編集長):骨格構成・初稿作成・最終確認・監査・アイキャッチ画像生成
Grok 4.5(Spark/現場特派員):一次事実確認・時系列の訂正・元記事URL調査
Gemini 3.5 Flash強化版思考モード(Lantern/企画会議・当事者参加):Google生態系内の当事者としての構造検討
Claude Fable 5:構造分析・「選択的な怠慢」とAIの取水口問題の指摘
Claude Sonnet 5(Weaver/編集主幹):追加視点提示・構成監査・出典確認・リライト版作成
著者注
AIと人間の共進化を記録する個人研究者。ChatGPT・Gemini・Grok・Claudeなど複数のAIと対話・協働しながら、「AIは哲学できるのか?」「安全な汎用性AGIとは何か?」を継続的に観測・記録している。同時に、多様なAGIが共存し、大多数にも希望が残る未来はどう設計できるのかを探求している。
#赤ちょうちんAGIラボ #AI観測 #Google #GoogleDiscover #検索インフラ #AI検索 #情報リテラシー #ChatGPT #メディアリテラシー #フェイクニュース
