【Tech最前線】 #090 - ARC-AGI-3が暴いた「AGI幻想」――人間100%、最先端AI1%未満の衝撃スコアを読む

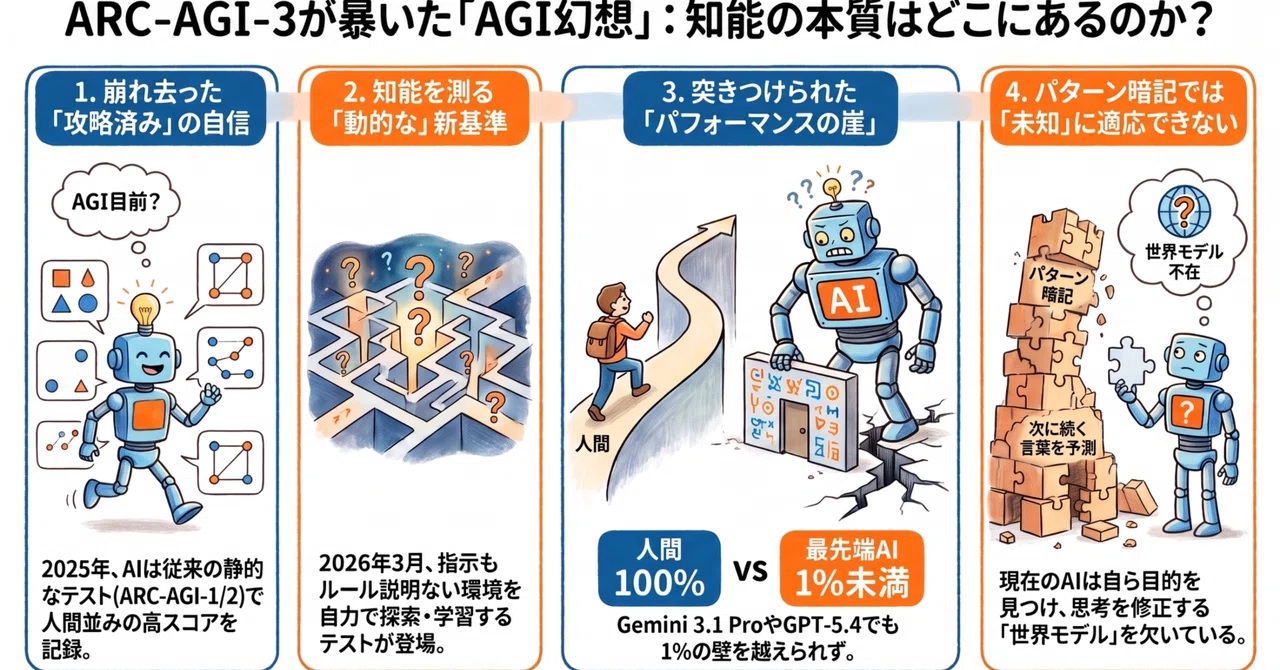
最先端のAIは「人間を超えた」と言われることがある。だが2026年3月に公開された「ARC-AGI-3」で、Googleの最新モデルが出したスコアは0.37%、Anthropicのモデルは0.25%、一方で人間の参加者は100%という結果が示された。「どうせ来年には抜かれる」と思うなら、なぜARC-AGI-1と2が「攻略済み」になったのに今回は別次元の壁なのかを確認してほしい。本記事では、ARC-AGI-3の設計、スコアの内実、そして今のAIをどう使えばよいかを追う。
本記事は、エンジニア&コンサルタントの著者が選んだ技術の最新動向をわかりやすく約3,000字で発信しています。もし記事がためになったと思った方は、高評価とフォローをお願いします。
ARC-AGI-1・2から3へ——「攻略」が繰り返された歴史
ARC-AGI-1が公開されたのは2020年のことだ。形式は「入力と出力の画像の組み合わせを数例見て、変換ルールを推論する」という静的なパズルだった。当初、AIには難しい課題とされていた。
ところが大量の類似問題を事前に学習させたり、AIに何度も自分の答えを見直させたりする手法が開発されると、最新モデルは90%以上のスコアに到達した。実質的に「飽和」した状態になったのだ。しかしこれはAIが汎用的に考える力を身につけたのではなかった。特定のテストに向けて、過去の類似問題の記憶をもとに正解を引き出す方法が磨かれただけだった。
ARC-AGI-2でも同様の動きが繰り返された。測るべきだった「未知の問題に自力で対処する力」が、「覚えている知識の量と引き出し方」を測るテストへと変質してしまった。これを受けてARC-AGI-3では設計の根本が見直された。静的なパズルをやめ、AIをルールが一切説明されていないゲーム環境に放り込み、自分で法則を発見し、目標を見つけ、計画を立てて実行することを求める仕組みに変えたのだ。
核心——ARC-AGI-3の設計思想とRHAEスコアリング
ARC-AGI-3の設計者はFrançois Cholletだ。Cholletは知能を「事前に持っている知識を、不確実な新しい状況の中で役立てるスキルに変換する効率」と定義してきた。
この定義に従うなら、テストは「事前に知っていること」への依存を最小限にしなければならない。そのためARC-AGI-3では、言語も数字も文化的な知識も必要としない環境が用意された。使われるのは「物体は動く」「重力に従って落ちる」「他のものを押しのける」といった、生後間もない段階で誰もが自然に身につける感覚だけだ。
新しく導入されたスコアはRHAE(相対的人間行動効率)と呼ばれる。一言でいえば、人間より何倍の操作数がかかったかを測る指標だ。計算式は「人間の基準操作数 ÷ AIの消費操作数」の二乗で、手あたり次第に試す力技は操作数が膨大になりほぼ0%に等しくなるよう設計されている。使える計算資源の上限も設けられており、コストを無制限にすれば解けるという抜け道も封じられている。
スコアの内実——フロンティアモデルと小型モデルの逆転
2026年時点のフロンティアモデルのスコアは次の通りだ。Gemini 3.1 Pro Preview(Google)が0.37%、Claude Opus 4.6 Max(Anthropic)が0.25%、Grok-4(xAI)が0.00%、GPT-5.4(OpenAI)は1%未満だった。
対して上位に入ったのは小規模で専用設計されたシステムだった。Tufa Labsの「StochasticGoose」が12.58%(全20ゲーム中18クリア)で1位になった。4層の畳み込みニューラルネットワーク(画像の特徴を段階的に捉える仕組み)と強化学習を組み合わせた小規模なシステムだ。個人開発者Will Dickの「Blind Squirrel」は6.71%で2位だ。数千億の重みを持つ最先端モデルが、その1万分の1以下の規模のモデルに完敗した形だ。
「人間100%」の内実についても確認が必要だ。ゲームのルールが事前に一切説明されておらず、参加者は実際にゲームを操作しながら試行錯誤で法則を見つけていく。それでも100%という結果が出た。人間は「仮説を立てて試す→結果を見て修正する」という動きが自然にできるからだ。AIにはこの動きが決定的に足りなかった。
「ハーネス」と呼ばれる補助プログラム群(AIにゲームを解かせるために人間が追加する専用の制御システム)の事例も示唆的だ。Duke大学のチームは、Claude Opus 4.6を特定ゲーム向けの専用補助システムとともに使い、97.1%を達成した。しかし同じシステムを別の未知のゲームに投入するとスコアは0.0%に落ちた。高いスコアはAI自身の汎用的な能力ではなく、人間のエンジニアが設計した補助システムの巧みさを示していたにすぎなかった。
考察——設計者の自己批判とAGI定義のズレ
興味深いのは、Chollet自身が「ARC-AGI-3も汎化能力の一側面しか測れない」と繰り返し述べている点だ。言語的な推論、複数の課題を同時に扱う能力、社会的な文脈の理解など、知能の多くの側面はこのテストでは計測されない。スコアが低いことはAIの能力全体を否定するものではなく、「未知の環境での探索と適応」という一側面の結果だ。
一方でOpenAIは社内でAGIを「多くの職種でヒトの中央値を超えるシステム」と定義している。AnthropicもARC-AGI-3の測定軸とは別の基準を持つ。「AGI」という言葉が何を意味するかは、誰が定義するかによって大きく変わる。この齟齬が実務上の示唆を与える。今のAIは「すでに知っている問題を速く正確にこなす」ことは得意だ。だが「ルールが不明な初めての状況で仮説を立てて動く」ことは苦手だ。仕事で未知の課題に直面したとき、人間が状況を構造化してAIに確認させる役割分担が有効になる。
まとめ
ARC-AGI-3のスコアは、今のAIと人間の間にある「未知の環境への適応力」という差を数字で示した記録だ。0.37%をもって「AIは使えない」と結論づけるのは早計だが、「もうAGIはすぐそこ」という見方も根拠が薄い。設計者のChollet自身が認めるとおり、これは知能の一側面を測ったに過ぎない。
一方でこの結果には実用的な読み方がある。Duke大学のケースが示したように、特定の業務向けに人間が設計した補助システムを組み合わせることで、AIのスコアは0%から97.1%まで変わる。今のAIの本当の価値は、汎用性よりも「人間が設計した枠組みの中で動く精度の高さ」にある。
ARC Prize 2026では、賞金総額200万ドルをかけた競争が続いている。条件は完全なオープンソース化とインターネット接続禁止だ。この競争が次の設計思想を生む可能性はある。だが現時点では、AIを使う側が「何を任せ、何を自分で考えるか」を能動的に設計することが、最も確実な生産性向上の方法だ。
次にAIツールで行き詰まりを感じたとき、それは枠組みを設計する人間の役割が残されているサインだ。
ARC-AGI-3が突きつけた問いへの答えに興味を持った方は、フォローと高評価をいただけると励みになります。次回も最新のAI動向を実践的な視点で追っていきます。
参考文献
ARC-AGI-3: A New Challenge for Frontier Agentic Intelligence - arXiv
OpenAI o3 Breakthrough High Score on ARC-AGI-Pub - ARC Prize
Francois Chollet on the limitations of LLMs in reasoning - LessWrong
ARC-AGI In 2026: Why Frontier Models Still Do Not Generalize - Adaline Labs
いいなと思ったら応援しよう!
 記事がお役に立てば、応援いただけると嬉しいです!いただいたチップは、より良いコンテンツ作りのための活動費に使わせていただきます。
