模式识别与机器学习(二):常用的概率分布(共轭分布等)

统计学之常见的分布介绍 请注意,在实际应用中,需要根据具体的问题和数据类型选择适当的检验方法和参数设置,并根据需要进行进一步的数据处理和解释。2. 二项分布(Binomial Distribution):描述了重复进行一系列独立的二元试验,例如抛硬币或进行有限次数的成功与失败的实验。指数分布的特点是描述了时间或空间上连续事件的间隔时间。6. 伽马分布(Gamma Distribution):是指数分布的推广,适用于描述连续时间事件的等候时间。这只是一些统计学中常见的分布,实际上还有很多其他的分布,每个分布都有不同的应用和特点。 阅读详情
第二章主要介绍几个重要的概率分布及其特性。


1. 二值变量的概率分布


       假设一个二元随机变量,用参数表示的概率为:。

(1)伯努利分布(Bernoulli distribution)
       概率分布函数:
       期望:
       方差:
       log似然函数为:

       其中,表示变量x的观测值。得到的最大似然估计值为:


(2)二项分布(Binomial distribution)
       概率分布函数:
,
       期望:
       方差:

       注:对于小的数据集,如果对二项分布采用极大似然估计,会得到过拟合(over-fitting)的估计结果。可以采用贝叶斯方法,引入共轭先验分布(conjugate prior distribution)来解决这个问题。共轭先验是指,选取一个与似然函数共轭的先验分布,使得后验分布与先验分布有同样的函数形式。其中,二项分布的共轭先验是Beta分布。

(3)Beta分布
       概率分布函数:

       期望:
       方差:

       采用贝叶斯方法,将Beta先验乘以二项分布似然函数,得到后验分布如下:


2. 多项式变量的概率分布


       多项式变量可以取多种结果中的一种,而二值变量只能取两种结果中的一种。假设变量x可以取K=6种结果,若x的某一次观测值为第三种结果(),则可以将x表示为。另外,用参数表示的概率:


(1)多项式分布(Multinomial distribution)
       概率函数为:

       (其中,表示数据集中出现第k种结果的次数;)

(2)狄利克雷分布(Dirichlet distribution)
       狄利克雷分布是多项式分布的共轭先验分布。概率分布函数如下:

       采用贝叶斯方法,得到后验分布如下:


3. 高斯分布


       一元概率分布函数:

       多元概率分布函数:


3.1 条件高斯分布(Conditional Gaussian distribution)
       假设x是一个服从高斯分布的D维向量,为了讨论条件高斯分布,将x分成两个独立的子集:
       这两个子集对应的期望为:
       对应的方差为:
       经推导,条件概率分布的期望和方差分别为:


3.2 边缘概率分布(Marginal Gaussian distribution)
       以为例,其期望和方差分别为:


3.3 高斯变量的贝叶斯理论
       本节的主要内容是:已知高斯边缘概率和高斯条件概率(其均值是变量x的线性函数,且其方差与x无关),如何求得边缘概率和条件概率。
       求解方法是,首先求解联合概率分布的函数形式,再利用3.1节和3.2节中边缘概率分布和条件概率分布的期望和方差公式求得结果。

       假设已知:
       令,则:

       经推导得,期望和方差分别为:


       根据3.2节,得到边缘概率分布的期望和方差分别为:

       根据3.1节,得到条件概率分布的期望和方差为:


3.4高斯最大似然估计

       给定数据集,假定这些观测值都是独立地从高斯分布中产生。为了估计高斯分布函数中的参数,可以采用最大似然估计。其中,log似然函数为:

       得到的期望和方差的估计值为:


       其中,方差的无偏估计为:


3.5 顺序估计(Sequential estimation)
       顺序估计适用于在线应用,可以一次只处理一个数据,根据当前数据估计参数值。假设需要被顺序估计的参数为,采用极大似然估计得到:

       为了进行顺序估计,可以采用Robbins-Monro算法:

       该算法的特点在于估计值会收敛到根,根满足。

3.6 高斯分布的贝叶斯推理
       本节的重点是,如果用贝叶斯理论估计高斯分布的均值或方差,需要选择哪些分布作为共轭先验。

3.6.1 单变量高斯分布
(1)方差已知,估计均值:
       似然函数是:
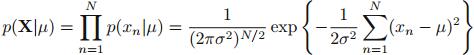
       共轭先验是:
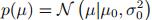
       后验分布是:
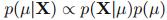
       即:
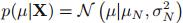
       其中:
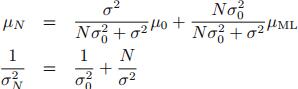

(2)均值已知,估计方差:
       似然函数是:
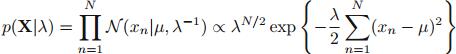
       共轭先验是Gamma分布:
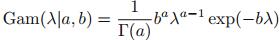
       后验分布是:
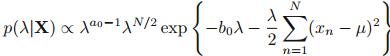
(3)均值和期望未知:
       共轭分布为高斯伽马分布(Gaussian-gamma distribution):
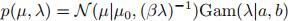

3.6.2 多变量高斯分布
(1)方差已知,估计均值,采用的共轭先验还是高斯分布;
(2)均值已知,方差未知,采用Wishart分布:
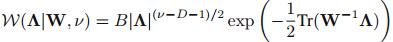
(3)均值和方差都未知,采用Gaussian-Wishart分布:
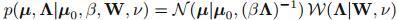
3.7 学生t分布(Student's t-distribution)
       Student's t-distribution可以通过叠加无限个均值相同而方差不同的高斯分布获得。与高斯分布相比,t分布对离群点更不敏感,因此鲁棒性(robustness)更高。

3.8 周期变量(Periodic variables)
       高斯分布不适合作为一些连续变量(例如:周期变量)的密度分布函数。对于周期变量,可以采用对高斯分布进行周期泛化后的von Mises分布:

       von Mises分布的局限性在于,该分布是单峰的,不能表示多峰分布。

3.9 高斯混合(Mixtures of Gaussians)
       概率密度函数为:,其中,表示混合系数。


4. 指数分布族


       本章节提到的很多分布函数(除了高斯混合分布)属于同一类分布——指数分布族,其分布函数形式如下:


(1)伯努利分布
       推导出指数分布族形式:

       得到:
       所以:
       该函数称为logistic/sigmoid函数。其他对应部分为:

(2)多项式分布
       推导出指数分布族形式:
       其中,。其他对应部分为:


       不过这里有一个限制条件:
       在某些情况下,去除这个条件更方便时会用。方法是用前M-1项来表示第M项,则多项式分布推导为:

       其中:
       所以:
       该函数称为softmax函数(也叫标准化指数)。其他对应部分为:


(3)单变量高斯分布
       推导出指数分布族形式:

       对应部分为:


4.1 最大似然与充分统计量
       对指数分布族的参数进行最大似然估计,得到:
       由于包含了最大似然估计器需要从数据中获取的全部信息,所以它被称为充分统计量。

4.2 共轭先验
       指数分布族选择的共轭先验符合以下形式:

       对应的后验分布为:


4.3 无信息先验
       当我们对未知的分布形式的先验知识不了解时,我们希望选择一种尽可能不影响后验分布的先验,称之为无信息先验。目的是为了让后验分布只取决于数据集本身。一般情况下,满足位置不变性或尺度不变性的分布可以作为无信息先验分布。


5 非参数方法


       在本节之前讨论的都是参数估计方法。该方法采用具有特定函数形式和参数的概率分布,且这些参数值是由数据集决定的。参数方法的不足在于,如果选择的分布不符合数据本身所表示的概率分布,那么得到的预测结果会比较差。而非参数方法则不需要选择概率分布,避免了选错概率分布的问题。本节介绍三种非参数方法。

(1)条形图密度估计(Histogram density models)
       主要方法是,指定条形图宽度(即把[0, 1]分割成多个区间),然后统计数据集中落入每个区间的数据量。特点是每个被统计完的数据都可以被丢弃,因而该方法可以顺序处理数据(例如在线数据)。但这个方法有两个问题,第一个是密度估计是不连续的,相邻的条形图之间有密度的断层;第二个是不适用于高维数据。不过接下来的两个方法可以解决该问题。

(2)核密度估计(Kernel density estimation)
       主要方法是,指定一个单位空间大小(即指定核函数,例如高斯核函数),然后在数据集中按照该单位空间下包含的数据个数来决定相应的概率密度。
       由于单位空间大小是固定的,该方法存在两个问题:第一,若单位空间过大,将导致某个高密度区域对应的密度曲线过于平滑,而不能反映真实的密度变化情况;第二,若单位空间过小,则会使密度曲线中存在很多噪音,曲线不平滑。

(3)近邻方法(Nearest-neighbour methods)
       主要方法是,指定数据个数K,以某个数据为中心,查找距离该数据最近的数据点,当数据个数达到K时,则估计该区域的密度。
       该方法可以解决核密度估计造成的第一个问题。同时,若K的值太小,会造成较大的噪音;若K的值太大,则密度曲线过于平滑,不能反映密度变化情况。所以需要选择一个大小适中的K值。


Python实现12种概率分布(附代码) 今天给大家带来的这篇文章是关于机器学习的,机器学习有其独特的数学基础,我们用微积分来处理变化无限小的函数,并计算 它们的变化;我们使用线性代数来处理计算过程;我们还用概率论与统计学建模不确定性。 在这其中,概率论有其独特的地位,模型的预测结果、学习过程、学习目标都可以通过概率的角度来理解。 与此同时,从更细的角度来说,随机变量的概率分布也是我们必须理解的内容。在这篇文章中,项目作者介绍了所有你需要了解 的统计分布,他还提供了每一种分布的实现代码。 项目地址:https://github.com/grayk 阅读详情

相关推荐

<<模式识别与机器学习 (Pattern Recognization and Maching Learning)>>(PRML) 总结

\quadBishop 的大作《模式识别与机器学习》(Pattern Recognization and Maching Learning),简称为PRML,这本书被认为是贝叶斯方法的扛鼎之作,我有幸忙里偷闲地把这本书通读了一遍并且也把各个章节的习题几乎完成了一遍,可以见我的博客,作为看完这本书最后一个环节,我想为我看完这本书做一个总结。总结分为如下几个部分,分别是阅读此书可以采取的方法,本书主要内

weishenmetlc的博客 8624

贝叶斯推断 3. 离散随机变量的先验和建模

Beta分布 贝塔分布(Beta Distribution) 是一个作为伯努利分布和二项式分布的共轭先验分布的密度函数,在机器学习和数理统计学中有重要应用。 贝塔分布中的参数可以理解为伪计数,伯努利分布的似然函数可以表示为,表示一次事件发生的概率,它为贝塔有相同的形式,因此可以用贝塔分布作为其先验分布。—–百度百科 概率密度函数0<x<10<x<1 f(x;α,β)=xα−1(

浅梦的学习笔记 1943

腾讯混元3D世界模型2.0实战:从AI生成到Unity/UE引擎集成全指南

生成式AI正在重塑3D内容创作流程,其核心原理是通过大语言模型理解自然语言描述,并驱动多阶段生成流水线自动创建3D资产与场景。这项技术为游戏开发、虚拟仿真和数字孪生领域带来了革命性的效率提升,能够将传统需要数周的美术协作流程压缩至几分钟。在实际应用中,开发者需要掌握本地环境部署、模型推理优化以及生成资产与主流游戏引擎的集成工作流。本文以腾讯开源的混元3D世界模型为例,详细解析如何将AI生成的场景通过插件高效导入Unity和Unreal Engine,并针对光照烘焙、材质调整、性能优化等工程实践问题提供解决方

cnracht8153的博客 765

概率统计笔记:共轭分布

1 共轭的定义 在概率统计笔记:贝叶斯推断 Bayesian Inference_UQI-LIUWJ的博客-CSDN博客中,我们有: 如果某个随机变量Θ的后验概率 p(θ|x)和先验概率p(θ)属于同一个分布簇的(有相同的形式),那么称p(θ|x)和p(θ)为共轭分布,同时,也称p(θ)为似然函数p(x|θ)的共轭先验。 换句话说: 概率统计笔记:分布的核_UQI-LIUWJ的博客-CSDN博客 我们以高斯分布为例,如果p(x|θ)...

qq_40206371的博客 4329

Beta分布&二项分布, 狄利克雷分布&多项式分布

共轭分布   由贝叶斯定理,我们知道 p(θ∣x)∝p(x∣θ)p(θ)p(\theta|x)\varpropto p(x|\theta)p(\theta)p(θ∣x)∝p(x∣θ)p(θ) 如果Θ\ThetaΘ的先验分布p(θ)p(\theta)p(θ)和后验分布p(θ∣x)p(\theta|x)p(θ∣x)属于同一分布族,那么就称先验分布p(θ)p(\theta)p(θ)和后验分布p(θ∣x)...

Explore 2298

Java电商秒杀系统性能优化(一)——电商秒杀系统框架回顾

电商秒杀系统框架回顾项目简介外部依赖框架回顾项目要点项目中存在的问题小结 课程是免费的,课程地址如下:SpringBoot搭建电商秒杀项目,课程真的很棒,作者的思路很清晰,建议各位读者可以跟着视频练习一下这个项目; 项目简介 通过SpringBoot快速搭建的前后端分离的电商基础秒杀项目。项目通过应用领域驱动型的分层模型设计方式去完成:用户otp注册、登陆、查看、商品列表、进入商品详情以及倒计时秒...

ghw15221836342的博客 2939

正态随机过程和多变量正态分布

正态随机过程和多变量正态分布 高斯分布 高斯分布又称正态分布,被广泛用于连续变量分布的模型。对于单变量x,高斯分布的形式 2.3高斯分布" name="image_operate_32041331183295048" alt="模式识别和机器学习--- 2.3高斯分布" src="http://s5.sinaimg.cn/middle/

Cloud-Datacenter-Renewable Energy-Big Data-Model 1万+

基于Sentinel-2(哨兵2)遥感卫星的植被覆盖度提取

基于Sentinel-2(哨兵2)遥感卫星的植被覆盖度提取 一、Sentinel-2简单介绍 哨兵-2系列卫星的主要载荷多光谱成像仪拥有13个谱段,从可见光到近红外再到短波红外,空间分辨率从10m到60m,能实现全所未有的陆地海洋监测水平。其幅宽高达290KM,且A、B双星组合,覆盖能力比美国Landsat8卫星强很多。目前哨兵-2A和哨兵-2B已经实现了5天的重访时间,即使在之前仅有单颗卫星时,...

weixin_44143671的博客 2万+

必知必会 | 机器学习 12种概率分布

点击上方“机器学习与生成对抗网络”,关注星标获取有趣、好玩的前沿干货!作者:graykode 编辑:机器之心机器学习开发者需要了解的 12 种概率分布,这些你都了解吗?机器学习有其独特的数...

idol24的博客 1074

【机器学习基础】概率分布之变量

本系列为《模式识别与机器学习》的读书笔记。 1,二元变量 考虑⼀个⼆元随机变量 x∈{0,1}x \in \{0, 1\}x∈{0,1}。 例如,xxx 可能描述了扔硬币的结果,x=1x = 1x=1 表 ⽰“正⾯”,x=0x = 0x=0 表⽰反⾯。我们可以假设有⼀个损坏的硬币,这枚硬币正⾯朝上的概率未必等 于反⾯朝上的概率。x=1x = 1x=1 的概率被记作参数 μ\muμ,因此有公式(...

天堂的鸽子 550

Xilinx SDK工程编译、链接、调试注意事项

1、添加工程 启动SDK时选取workspace,如下图所示: 对应的workpace文件夹中会生成如下几个文件: 如果当前workspace是首次加载工程,SDK会进入启动界面 点击Import Project,导入已有工程 点击Browse,添加工程路径,一个完整的工程包含一个bsp文件夹,一个HW文件夹,和一个src文件夹(添加C功能函数) 点击Fini...

Autumn_He的博客 1万+

机器学习领域必知必会的12种概率分布(附Python代码实现)

机器学习有其独特的数学基础,我们用微积分来处理变化无限小的函数,并计算它们的变化;我们使用线性代数来处理计算过程;我们还用概率论与统计学建模不确定性。在这其中,概率论有其独特的地位,模型的预测结果、学习过程、学习目标都可以通过概率的角度来理解。 与此同时,从更细的角度来说,随机变量的概率分布也是我们必须理解的内容。在这篇文章中,项目作者介绍了所有你需要了解的统计分布,他还提供了每一种分布的实现代码。 项目地址:https://github.com/graykode/distribution-is

xian0710830114的专栏 926

PHP服务端 苹果支付(IAP)处理

公司做的app需要做IAP订阅支付,开始觉得和微信的支付流程差不多,做起来还是有点麻烦,主要是网上的文章很少,不能拿来主义。自己做完总结一下,希望对小伙伴们有帮助我就很欣慰了。代码写的不好 不要喷我。。。 首先讲一下我的业务逻辑,也就是php服务端需要做什么事情。 先上图: 下面我详细的讲一下每...

山水的博客 9597

模式识别和机器学习 笔记 第二章 概率分布

这章主要介绍概率分布及其特性。这些基本的分布可以像堆积木一样形成更复杂的模型。讨论了一些统计学的关键概念,比如 Bayesian inference。概率分布的一个角色是:给定一个随机变量x有限集合的观察值x1,x2….xn,对概率分布p(x)进行建模,即概率密度估计。首先介绍离散型贝努力分布、二项式分布和多项式分布和连续型的Gaussian分布。一个特殊 的问题就是参数化估计问题,根...

fuliang 338

均匀分布 卡方分布_机器学习者应会的12种概率分布

选自github作者:graykode编辑:机器之心机器学习开发者需要了解的 12 种概率分布,这些你都了解吗?机器学习有其独特的数学基础,我们用微积分来处理变化无限小的函数,并计算它们的变化;我们使用线性代数来处理计算过程;我们还用概率论与统计学建模不确定性。在这其中,概率论有其独特的地位,模型的预测结果、学习过程、学习目标都可以通过概率的角度来理解。与此同时,从更细的角度来说,随机变...

weixin_39932762的博客 612

hive sql每个用户的累积访问次数

我们有如下的用户访问数据 userId visitDate visitCount u01 2017/1/21 5 u02 2017/1/23 6 u03 2017/1/22 8 u04 2017/1/20 3 u01 2017/1/23 6 u01 2017/2/21 8 U02 2017/1/23 6 U01 2017/2/22 4 要求使用SQL...

weixin_39150719的博客 2956
上一篇: 模式识别与机器学习(一):概率论、决策论、信息论
下一篇: 反向传播算法(过程及公式推导)
__鸿
博客等级 码龄13年 290粉丝 26原创
评论 7
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值