


深度学习梯度下降法的理解
批量梯度下降法(Batch gradient descent)
假设目标函数为F(θ),那每次迭代的公式为: θ = θ − η ⋅ ∇ θ F(θ ) 。此时,θ为所有数据同时更新梯度。在代码上,如下:
for i in range(nb_epochs):
  params_grad = evaluate_gradient(loss_function, data, params)
  params = params - learning_rate * params_grad
对于每一次迭代,都必须以整个数据作为输入,在计算目标函数在当前位置的下降的梯度方向及大小。批量梯度下降法的数学解释,η为步长,又称学习率,⋅∇θF(θ)为目标函数在当前输入数据的位置上的梯度方向,而我们需要沿着梯度下降的方向去更新数据,所以取的是梯度的反方向即 -∇θF(θ)
随机梯度下降法(Stochastic gradient descent)
随机梯度下降法(SGD):θ
=θ
−
η
⋅
∇
θ
J(θ
;x(i);y(i))
批量梯度下降的缺点:对大型数据集执行冗余计算,因为它会在每个参数更新之前重新计算相似输入数据集的梯度。 随机梯度下降法通过一次执行一次更新来消除这种冗余。 因此,它通常要快得多,也可以用于在线学习。
随机梯度下降法的缺点:频繁执行更新,且变化很大,这导致目标函数如图所示剧烈波动。
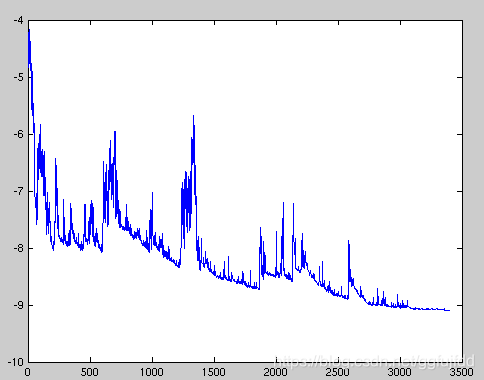
批次梯度下降法可以收敛到全局的最小值,但随机梯度下降法的随机波动可以避免陷入局部的最小值,并可以逐渐的收敛到全局的最优值。在梯度下降的过程中,逐渐降低学习率,随机梯度下降法是可以收敛到和批量梯度下降法同样的位置。
for i in range(nb_epochs):
  np.random.shuffle(data)
  for example in data:
    params_grad = evaluate_gradient(loss_function, example, params)
    params = params - learning_rate * params_grad
小批量梯度下降法(Mini-batch gradient descent)
小批量梯度下降法可以避免以上两种方法的缺点,
θ
=θ
−
η
⋅
∇
θ
J(θ
;x(i:i+n);y(i:i+n))
小批量梯度下降法的优点:减小参数更新的差异,避免剧烈的抖动,并实现更稳定的收敛结果。常见的小批量梯度下降法的batch_size一般在50到256之间,会因为应用的作用不同而不同。
for i in range(nb_epochs):
  np.random.shuffle(data)
  for batch in get_batches(data, batch_size=50):
    params_grad = evaluate_gradient(loss_function, batch, params)
    params = params - learning_rate * params_grad
深度学习中常见的问题
1.选择一个合适的学习率是比较困难的。学习率过小会导致收敛过慢,而学习率过大也会导致在最优值附近剧烈的振动而收敛不到最优值,更有甚者,可能会发散。
2.对于非凸函数,最小化损失函数的过程中要避免陷入局部的最优值。特别是鞍点,这些鞍点的周围通常很平稳,梯度很小,随机梯度下降法很难跳出这样的局部最优值,去收敛到全局的最优值。
梯度下降的优化算法
动量Momentum
Nesterov accelerated gradient
reference: https://ruder.io/optimizing-gradient-descent/
https://arxiv.org/pdf/1609.04747.pdf


 扫一扫


 2008

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


