


深度学习之梯度下降法
深度学习的过程中经常需要求函数的最小值,而求最小值的最常用的方法之一就是梯度下降法。
什么是梯度下降法?
我们由一个简单的例子出发。已知
z
=
f
(
x
,
y
)
z=f(x,y)
z=f(x,y),如何求该函数的最小值?根据偏导数的含义,当
z
z
z取最小值的必要条件如下:
∂
f
(
x
,
y
)
∂
x
=
0
∂
f
(
x
,
y
)
∂
y
=
0
\frac{\partial f(x,y)}{\partial x}=0 \qquad \frac{\partial f(x,y)}{\partial y}=0
∂x∂f(x,y)=0∂y∂f(x,y)=0
但通常情况下,函数会很复杂,求偏导也会十分复杂。
想象一下兵乓球在斜坡上会如何下降。在斜坡上释放兵乓球时,兵乓球会沿着最陡的方向下降,下降一段后,将兵乓球暂停再释放,兵乓球还是会沿着最陡的坡度下降,以此方式最终到达最低点。其下降的过程要点在于“释放一段路程,暂停,再释放”。每次释放兵乓球都会重新寻找最陡的坡度下降,我们将这种方法称为“梯度下降法”。在数学层面,由于上述下降的路径也是最短的路径,也被称为“最短路径法”。
联系近似公式(关于近似公式可参考这篇多变量近似公式)、向量的性质,有如下式子:
Δ
z
=
f
(
x
+
Δ
x
,
y
+
Δ
y
)
−
f
(
x
,
y
)
=
∂
f
∂
x
⋅
Δ
x
+
∂
f
∂
y
⋅
Δ
y
\Delta z=f(x+\Delta x,y+\Delta y)-f(x,y)=\frac{\partial f}{\partial x} ·\Delta x+\frac{\partial f}{\partial y} ·\Delta y
Δz=f(x+Δx,y+Δy)−f(x,y)=∂x∂f⋅Δx+∂y∂f⋅Δy
表达成内积的形式为
Δ
z
=
(
∂
f
∂
x
,
∂
f
∂
y
)
.
(
Δ
x
,
Δ
y
)
\Delta z=(\frac{\partial f}{\partial x} ,\frac{\partial f}{\partial y} ).(\Delta x,\Delta y)
Δz=(∂x∂f,∂y∂f).(Δx,Δy)
其中的
Δ
z
\Delta z
Δz就是“每次兵乓球下降的距离”,也就是每次更新的大小。因此,根据向量的性质,当
Δ
z
\Delta z
Δz下降(减少)得最快时,向量
(
∂
f
∂
x
,
∂
f
∂
y
)
(\frac{\partial f}{\partial x} ,\frac{\partial f}{\partial y} )
(∂x∂f,∂y∂f)与
(
Δ
x
,
Δ
y
)
(\Delta x,\Delta y)
(Δx,Δy)须满足以下关系:
(
Δ
x
,
Δ
y
)
=
−
η
⋅
(
∂
f
∂
x
,
∂
f
∂
y
)
η
为
正
的
微
小
常
数
(\Delta x,\Delta y)=- \eta ·(\frac{\partial f}{\partial x} ,\frac{\partial f}{\partial y} )\qquad \eta为正的微小常数
(Δx,Δy)=−η⋅(∂x∂f,∂y∂f)η为正的微小常数
同时也称
(
∂
f
∂
x
,
∂
f
∂
y
)
(\frac{\partial f}{\partial x} ,\frac{\partial f}{\partial y} )
(∂x∂f,∂y∂f)为梯度
推广到多变量:
(
Δ
x
1
,
Δ
x
2
,
⋯
,
Δ
x
n
)
=
−
η
⋅
(
∂
f
∂
x
1
,
∂
f
∂
x
2
,
⋯
,
∂
f
∂
x
n
)
(
1
)
( \Delta x_1,\Delta x_2,\cdots,\Delta x_n)=-\eta·(\frac{\partial f}{\partial x_1} ,\frac{\partial f}{\partial x_2},\cdots, \frac{\partial f}{\partial x_n})\qquad (1)
(Δx1,Δx2,⋯,Δxn)=−η⋅(∂x1∂f,∂x2∂f,⋯,∂xn∂f)(1)
为了使表达式更简洁
- 哈密顿算子的定义如下
∇
f
=
(
∂
f
∂
x
1
,
∂
f
∂
x
2
,
⋯
,
∂
f
∂
x
n
)
(
函
数
对
所
有
变
量
的
微
分
)
\nabla f=(\frac{\partial f}{\partial x_1} ,\frac{\partial f}{\partial x_2},\cdots, \frac{\partial f}{\partial x_n})\qquad(函数对所有变量的微分)
∇f=(∂x1∂f,∂x2∂f,⋯,∂xn∂f)(函数对所有变量的微分)
2. 引入位移向量
Δ
x
=
(
Δ
x
1
,
Δ
x
2
,
⋯
,
Δ
x
n
)
\Delta x=( \Delta x_1,\Delta x_2,\cdots,\Delta x_n)
Δx=(Δx1,Δx2,⋯,Δxn)
(1)式可化简为
Δ
x
=
−
η
∇
f
η
为
正
的
微
小
常
数
\Delta x=- \eta \nabla f \qquad \eta为正的微小常数
Δx=−η∇fη为正的微小常数
η
\eta
η称为学习率,若设置过大则可能跳过最小值,若设置国小则可能在极小值(“小山谷”)中出不来,只能通过反复试验来寻找恰当的值。
用excel体验梯度下降法
求 z = x 2 + y 2 的 z=x^2+y^2 的 z=x2+y2的最小值
-
初始设定
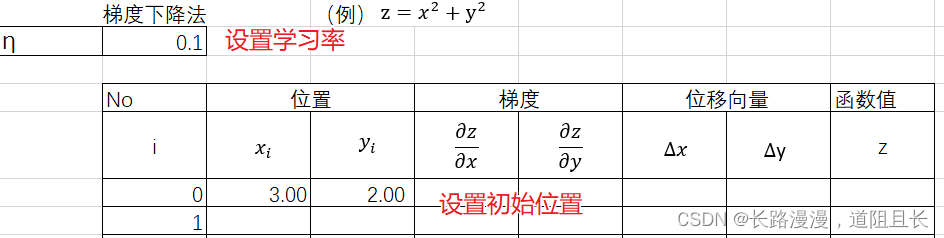
-
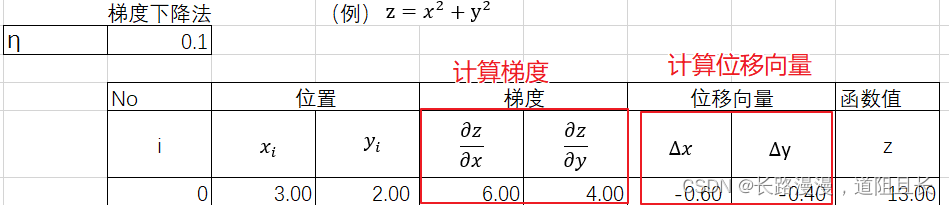
计算位移向量
由 z = x 2 + y 2 z=x^2+y^2 z=x2+y2计算 z z z对 x x x和 y y y的偏导,可得 ∂ f ∂ x = 2 x ∂ f ∂ y = 2 y ( 2 ) \frac{\partial f}{\partial x}=2x \quad \frac{\partial f}{\partial y}=2y \qquad (2) ∂x∂f=2x∂y∂f=2y(2)
Δ x = − η ∇ f η 为 正 的 微 小 常 数 ( 3 ) \Delta x=- \eta \nabla f \qquad \eta为正的微小常数 \qquad(3) Δx=−η∇fη为正的微小常数(3)
根据学习率和初始位置( x x x和 y y y的值)计算梯度[式2]以及位移向量[式3],并最终得到函数值。
-
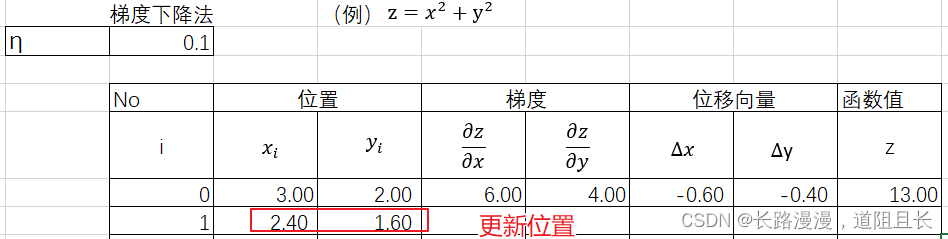
更新位置
根据梯度下降法,由上一次的位置 ( x i , y i ) (x_i,y_i) (xi,yi)和位移向量 ( Δ x , Δ y ) (\Delta x,\Delta y) (Δx,Δy)计算得到目前最新的位置 ( x i + 1 , y i + 1 ) (x_{i+1},y_{i+1}) (xi+1,yi+1)
( x i + 1 , y i + 1 ) = ( x i , y i ) + ( Δ x , Δ y ) (x_{i+1},y_{i+1})=(x_i,y_i)+(\Delta x,\Delta y) (xi+1,yi+1)=(xi,yi)+(Δx,Δy)
-
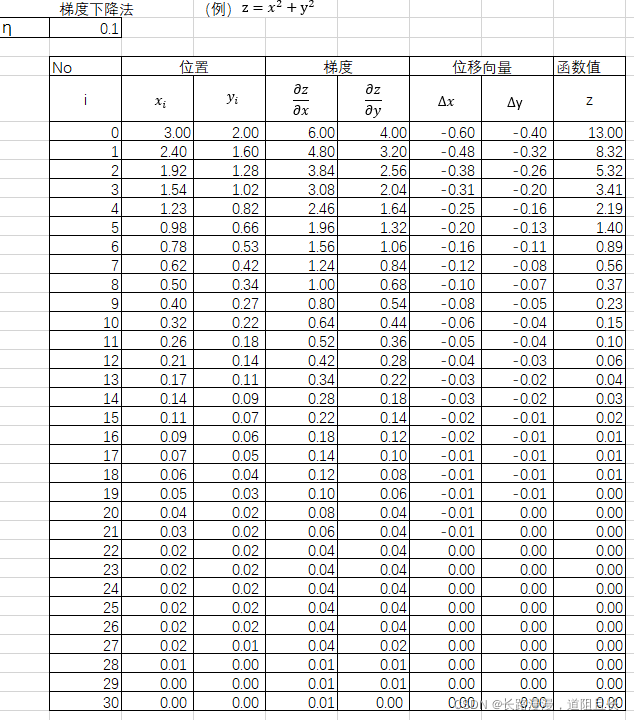
反复执行2-3的操作
反复执行2-3的操作,到30次之后可以看到求得的函数值为0, x x x和 y y y的值也为0。


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


