深度学习之反向传播算法

直观理解反向传播

反向传播算法是用来求那个复杂到爆的梯度的。

上一集中提到一点,13000维的梯度向量是难以想象的。换个思路,梯度向量每一项的大小,是在说代价函数对每个参数有多敏感。
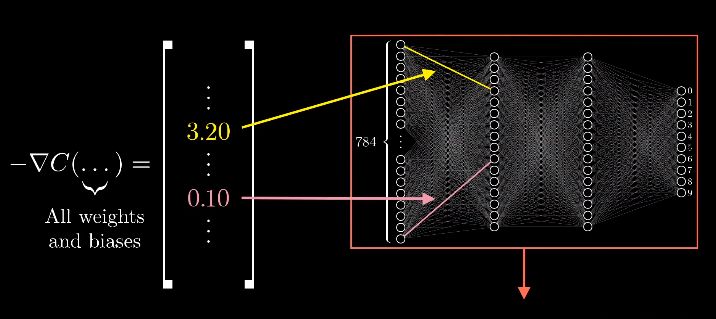
如上图,我们可以这样里理解,第一个权重对代价函数的影响是是第二个的32倍。


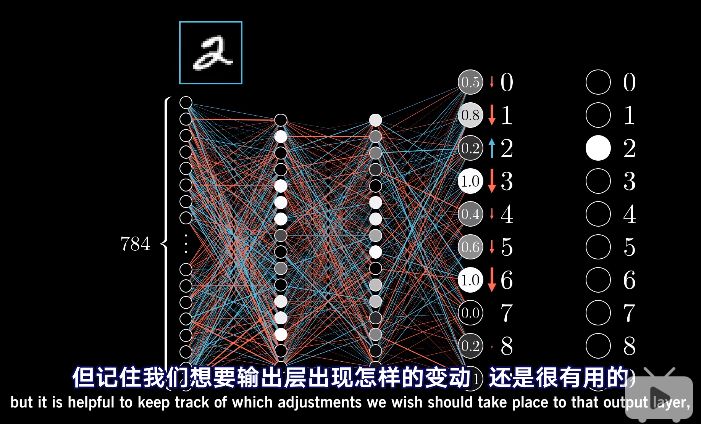
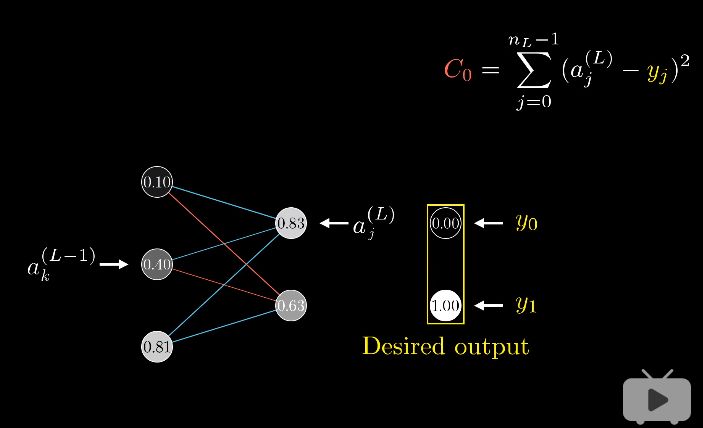
我们来考虑一个还没有被训练好的网络。我们并不能直接改动这些激活值,只能改变权重和偏置值。但记住,我们想要输出层出现怎样的变动,还是有用的。
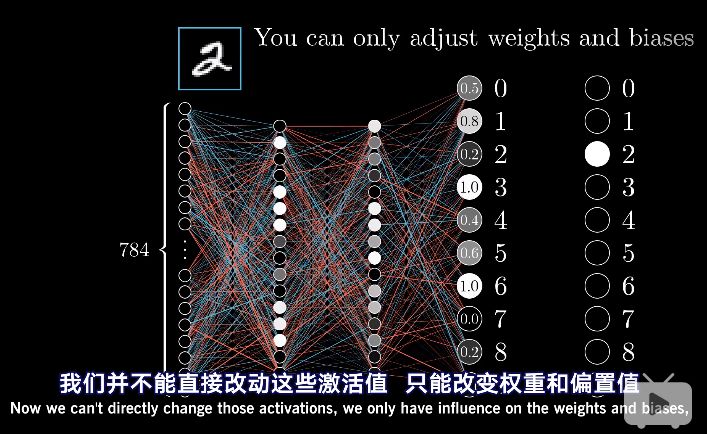

我们希望图像的最后分类结果是2,我们期望第3个输出值变大,其余输出值变小,并且变动的大小应该与现在值和目标值之间的差成正比。举个例子,增大数字2神经元的激活值,就应该‘比减少数字8神经元的激活值来得重要,因为后者已经很接近它的目标了。


进一步,就来关注数字2这个神经元,想让它的激活值变大,而这个激活值是把前一层所有激活值的加权和加上偏置值。
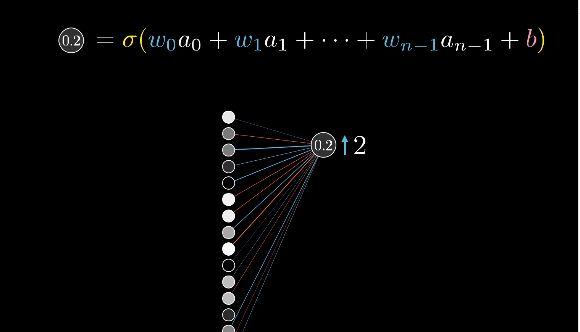
所以要增加激活值,我们有3条路可以走,一增加偏置,二增加权重,或者三改变上一层的激活值。

先来看如何调整权重,各个权重它们的影响力各不相同,连接前一层最亮的神经元的权重,影响力也最大,因为这些权重与大的激活值相乘。增大这几个权重,对最终代价函数造成的影响,就比增大连接黯淡神经元的权重所造成的影响,要大上好多倍。

请记住,说到梯度下降的时候,我们并不只看每个参数是增大还是变小,我们还看改变哪个参数的性价比最大。

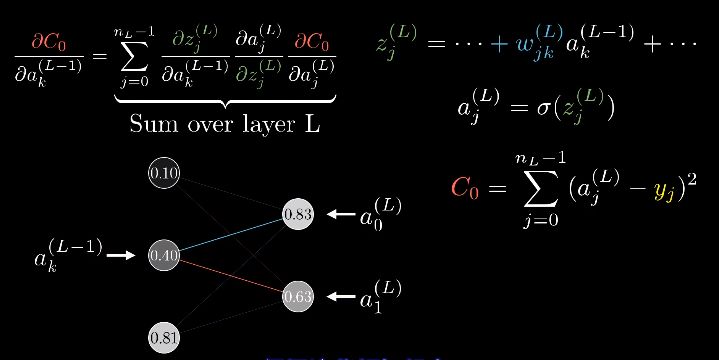
不过别忘了,从全局上看,只只不过是数字2的神经元所期待的变化,我们还需要最后一层其余的每个输出神经元,对于如何改变倒数第二层都有各自的想法。
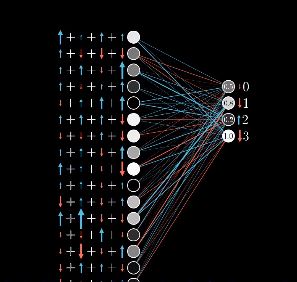
我们会把数字2神经元的期待,和别的输出神经元的期待全部加起来,作为如何改变倒数第二层的指示。这些期待变化不仅是对应的权重的倍数,也是每个神经元激活值改变量的倍数。


我们对其他的训练样本,同样的过一遍反向传播,记录下每个样本想怎样修改权重和偏置,最后再去一个平均值。
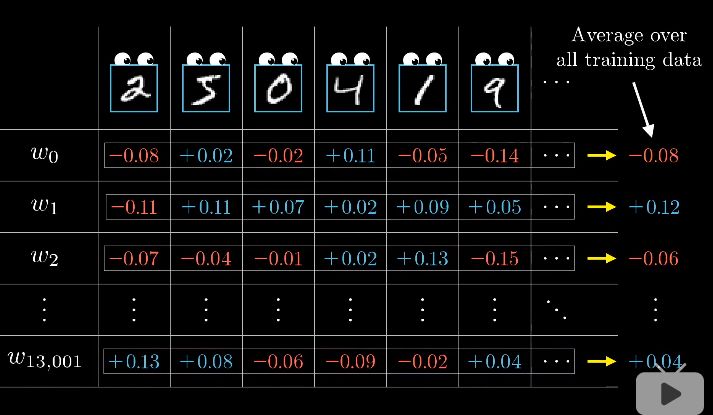
这里一系列的权重偏置的平均微调大小,不严格地说,就是代价函数的负梯度,至少是其标量的倍数。
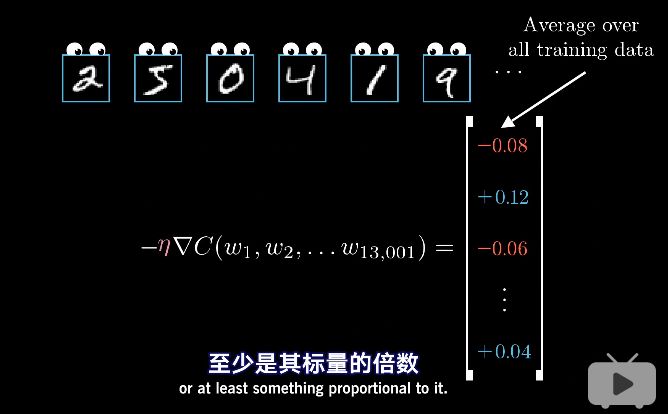
 

实际操作中,我们经常使用随机梯度下降法。

首先把训练样本打乱,然后分成很多组minibatch,每个minibatch就当包含了100个训练样本好了。然后你算出这个minibatch下降的一步,这不是代价函数真正的梯度,然而每个minibatch会给一个不错的近似,计算量会减轻不少。

反向传播的微积分原理

我们从一个最简单的网络讲起,每层只有一个神经元,图上这个网络就是由三个权重和三个偏置决定的,我们的目标是理解代价函数对这些变量有多敏感。这样我们就知道怎么调整这些变量,才能使代价函数下降的最快。

我们先来关注最后两个神经元,我们给最后一个神经元一个上标L,表示它处在第L层。
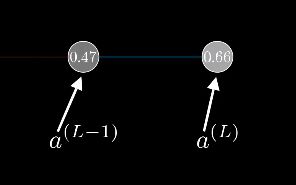
给定一个训练样本,我们把这个最终层激活值要接近的目标叫做y,y的值为0/1。那么这个简易网络对于单个训练样本的代价就等于$(a^{(L)}-y)^2$。对于这个样本,我们把这个代价值标记为$C_0$。

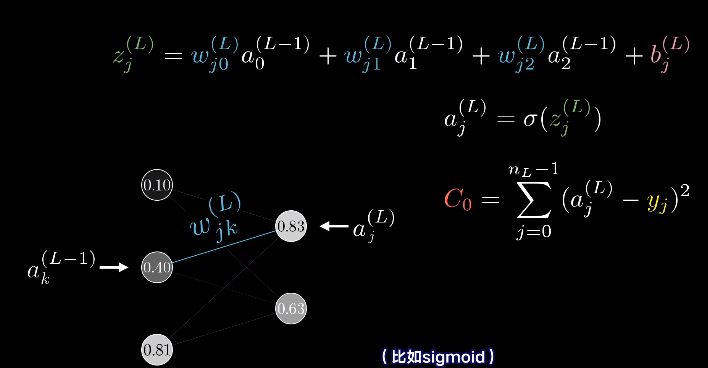
之前讲过,最终层的激活值公式:$a^{(L)} = \sigma (w^{(L)}a^{(L-1)}+b^{(L)})$

换个标记方法:

$$z^{(L)} = (w^{(L)}a^{(L-1)}+b^{(L)})$$

$$a^{(L)} = \sigma (z^{(L)})$$

整个流程就是这样的:
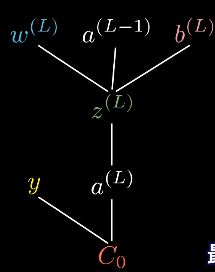
当然了,$a^{(L-1)}$还可以再向上推一层,不过这不重要。

这些东西都是数字,我们可以想象,每个数字都对应数轴上的一个位置。我们第一个目标是来理解代价函数对权重$w^{(L)}$的微小变化有多敏感。换句话说,求$C_0$对$w^{(L)}$的导数。
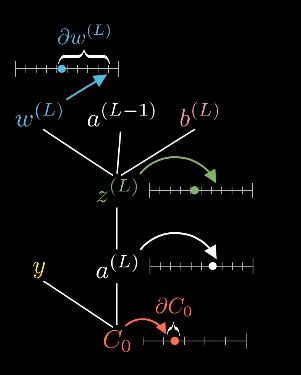
根据链式法则:

$$\frac{\partial C_0}{\partial w^{(L)}} = \frac{\partial z^{(L)}}{\partial w^{(L)}}\frac{\partial a^{(L)}}{\partial z^{(L)}}\frac{\partial C_0}{\partial a^{(L)}}\\\frac{\partial C_0}{\partial a^{(L)}}=2(a^{(L)}-y)\\\frac{\partial a^{(L)}}{\partial z^{(L)}}={\sigma }' (z^{(L)})\\\frac{\partial z^{(L)}}{\partial w^{(L)}}=a^{(L-1)}\\$$

所以

$$\frac{\partial z^{(L)}}{\partial w^{(L)}}\frac{\partial a^{(L)}}{\partial z^{(L)}}\frac{\partial C_0}{\partial a^{(L)}}=a^{(L-1)}{\sigma }' (z^{(L)})2(a^{(L)}-y)\\$$

$$\frac{\partial C}{\partial w^{(L)}} = \frac{1}{n}\sum _{k=0}^{n-1}\frac{\partial C_k}{\partial w^{(L)}}$$

当然了,对偏置求导数也是同样的步骤。

$$\frac{\partial C_0}{\partial b^{(L)}} = \frac{\partial z^{(L)}}{\partial b^{(L)}}\frac{\partial a^{(L)}}{\partial z^{(L)}}\frac{\partial C_0}{\partial a^{(L)}}=1{\sigma }' (z^{(L)})2(a^{(L)}-y)\\$$

到这里,我们可以看每层不止一个神经元的情况了。


参考链接:


转载于:https://www.cnblogs.com/lfri/p/10336199.html

反向传播算法(backpropagation) 算法简介 百度百科: BP算法(即反向传播算法)适合于多层神经元网络的一种学习算法,它建立在梯度下降法的基础上。BP网络的输入输出关系实质上是一种映射关系:一个n输入m输出的BP神经网络所完成的功能是从n维欧氏空间向m维欧氏空间中一有限域的连续映射,这一映射具有高度非线性。它的信息处理能力来源于简单非线性函数的多次复合,因此具有很强的函数复现能力。这是BP算法得以应用的基础。 ... 阅读详情

相关推荐

反向传播算法(过程及公式推导)

反向传播算法(Backpropagation)是目前用来训练人工神经网络(Artificial Neural Network,ANN)的最常用且最有效的算法。

Arthur-Chen的专栏 20万+

前向传播算法(Forward propagation)与反向传播算法(Back propagation)

虽然学深度学习有一段时间了,但是对于一些算法的具体实现还是模糊不清,用了很久也不是很了解。因此特意先对深度学习中的相关基础概念做一下总结。先看看前向传播算法(Forward propagation)与反向传播算法(Back propagation)。1.前向传播如图所示,这里讲得已经很清楚了,前向传播的思想比较简单。 举个例子,假设上一层结点i,j,k,…等一些结点与本层的结点w有连接,那么结点

bitcarmanlee的博客 14万+

深度学习中的反向传播算法实战指南

反向传播(Backpropagation)是一种在人工神经网络中广泛使用的高效算法,它通过计算损失函数关于网络参数的梯度来更新网络权重,从而达到优化模型的目的。在机器学习领域,反向传播的重要性不容忽视,它是实现深度学习中梯度下降优化策略的核心机制,使得网络能够通过不断迭代来学习数据中的复杂模式。损失函数有许多类型,但在大多数情况下,可以根据问题的性质选择合适的损失函数。以下是一些常见的损失函数:均方误差(MSE):最常用的回归损失函数,计算预测值和真实值差的平方的平均值。

weixin_29301059的博客 1110

“反向传播算法”过程及公式推导(超直观好懂的Backpropagation)

自己学习机器学习,深度学习也有好长一段时间了,一直以来都想写点有价值的技术博客,以达到技术分享及记录自己成长的目的,奈何之前一直拖着,近来算是醒悟,打算以后不定时写一写博客,也算是作为自己不断学习,不断进步的记录。既然是写博客,希望自己的博客以后要做到“准确、生动、简洁、易懂”的水平,做到对自己、对读者负责,希望大家多交流,共同进步! 言归正传,想起当时自己刚入门深度学习的时候,当时对神经网络的“...

aift的专栏 24万+

深度学习:反向传播算法

反向传播(Backpropagation, BP)算法作为深度学习的核心算法,运用链式法则高效计算神经网络中各参数的梯度,为模型优化指明方向。本文将详细讲解该算法的原理、实现及优化技巧,并附上完整的代码实例。算法优点缺点适用场景批量GD稳定收敛计算开销大,内存要求高小数据集随机GD计算快,可在线学习收敛不稳定大数据集,在线学习小批量GD平衡计算效率和稳定性需要调batch size大多数场景Momentum加速收敛,减少震荡需要调动量参数深网络,高维参数。

wyy202206174248的博客 1905

分布式存储系统关于GDPR条例中的数据清除原则

文章目录前言HDFS存储系统数据的完全删除基于加解密的输入输出流的数据保护方案 前言 关于GDPR是什么,可能许多同学之前并不太了解,至少笔者在之前也是不清楚的。GDPR全称为通用数据保护条例,General Data Protection Regulation。它是一项来自欧盟的关于计算机数据保护相关的条约,旨在规范系统如何收集,管控用户私人数据的种种行为。但是当前的一些存储系统并没有完全符合...

走在前往架构师的路上 2792

dl算法需要大量的_深度学习之反向传播算法(1)——结合一维网络的定量分析与理解...

0 序言最近几年,深度学习(Deep Learning, DL)技术由于其良好的性能席卷了科技界,并在信号处理(语音、音频、图像、视频)、自然语言处理、数据挖掘、推荐系统等领域全面开花,应用落地到互联网、金融、医疗、教育、智慧城市、交通、安防、多媒体、娱乐、艺术等众多垂直行业.本文目的在于阐释DL理论中最为重要的基础——反向传播算法(Back Propagation, BP)的原理,给出便于理解的...

weixin_39956110的博客 530

Excel VBA--按某一列拆分数据到多个文件

首先,将需要拆分的sheet命名为“明细”,接下来运行此代码,按提示操作即可。 在这里插入代码片 Sub chaifen() '定义变量类型 Dim sht, sh1, sh2 As Worksheet Dim k, i, j As Integer Dim irow As Integer Dim col As Integer Dim str As String '程序开始是要求输入按哪一列拆分数...

weixin_43650026的博客 5291

Neural Networks and Deep Learning习题解答--反向传播算法

神经网络与深度学习习题解答 反向传播算法 最近在看Michael Nielsen的Neural Networks and Deep Learning,这本书是以网页的形式放在网上,非常合适入门,附上传送地址:http://neuralnetworksanddeeplearning.com/chap1.html#learning_with_gradient_descent 国内哈工大社会计算...

剑启郁兰的博客 1264

深度学习基础之反向传播算法

反向传播算法是深度学习的基础之一,它通过计算误差的梯度并利用这些信息更新网络参数,从而实现模型的优化和性能提升。其主要优势在于能够自动地根据网络输出与目标值的误差动态调整参数,使得网络输出逐渐接近目标值。

🌟【AI炼丹师 | 你的数字技术搭子】 大二解锁3200+道友同行👾 2595

PowerBuilder 9 遗留系统逆向实战:3款反编译工具对比与关键DLL破解

本文深入探讨了PowerBuilder 9遗留系统的逆向工程实战,对比分析了PBKiller、PB DeCompiler和Shudepb三款反编译工具的核心功能与适用场景,并详细解析了关键DLL破解技术。通过IDA和OllyDbg等工具的应用,提供了从静态解构到动态追踪的完整逆向方法论,帮助开发者有效维护老旧PB系统。

cucanqi9387的博客 725

深度学习-反向传播算法

反向传播算法通过计算损失函数对网络参数的梯度,逐层更新网络的权重和偏置。它是深度学习中最基础且关键的算法之一,确保了神经网络能够有效地学习并优化性能。

1321

core_analyzer分析c++程序内存占用

环境:centos; 进程:单进程多线程c++程序; 问题:1. 分析系统内存占用; 2. 分析ptmalloc内存空洞(bins上的空闲chunk的大小); 包括:1. 占用了很大内存的c++进程; 2. gcore(在进程不core dump的情况下生成core文件); 3. core_analyzer(分析gcor...

weixin_41644391的博客 4025

【深度学习之核】反向传播算法精讲

反向传播(Backpropagation)是深度学习中用于计算损失函数对模型参数梯度的核心算法。它通过链式法则从输出层向输入层逐层计算梯度,并利用梯度下降法更新模型参数。以下是一个详细的反向传播案例讲解,结合数学公式和代码实现。

m0_69378371的博客 1000

深度学习:反向传播算法简介

反向传播算法(Back-Propagation, 简称BP算法)是深度学习中最为关键的优化技术之一。其主要功能是高效地计算神经网络中所有参数的梯度。这一过程是机器学习模型学习从输入到输出的映射关系的基础,特别是在复杂的深度神经网络中。

m0_73640344的博客 1302

IC/FPGA笔试/面试题分析(七)建立时间和保持时间类型考题汇总分析

自从召集2020届校招同行加入新建立的“IC/FPGA校招笔试面试交流群“,见识到了很多关于建立时间和保持时间分析的题目,在为别人解答疑惑,以及别人为自己解答疑惑的同时,自己对于知识的理解更加深刻了。 对于建立时间而言,从单独的对触发器的建立时间和保持时间的分析到了对电路(系统)的建立时间到保持时间的分析,前者是核心,后者是扩展,后者建立在前者的基础之上进行推到得到,同时也是芯片内部实际遵循的时...

Reborn Lee 1万+

【DL】反向传播算法

梯度下降算法

qq_30340349的博客 246

【matlab】使用alexnet进行特征提取

1.下载alexnet工具箱 在命令栏输入alexnet,若不报错说明已经安装,若出现错误按照提示去下载工具箱; 下载地址:https://ww2.mathworks.cn/matlabcentral/fileexchange/59133-deep-learning-toolbox-model-for-alexnet-network (1)需要先注册(十分简单),登陆,下载; (2)下载完成之后,...

jingjingliang1995的博客 5260

深度学习的算法:从反向传播到Dropout

1.背景介绍 深度学习是一种人工智能技术,它通过模拟人类大脑中的神经网络学习从大量数据中抽取知识。深度学习算法的核心是利用多层感知器(MLP)来模拟人类大脑的神经网络。这些算法可以用于图像识别、自然语言处理、语音识别等多种应用。 在这篇文章中,我们将从反向传播(backpropagation)到Dropout的深度学习算法进行详细讲解。我们将讨论以下主题: 背景介绍 核心概念与联系 核心算...

AI天才研究院 687

深度学习的基础:反向传播算法(一)之反向传播入门

一、反向传播算法   近年来,深度学习的快速发展带来了一系列喜人的成果,不管是在图像领域还是在NLP领域,深度学习都显示了其极其强大的能力。而深度学习之所以可以进行大规模的参数运算,反向传播算法功不可没,可以说,没有反向传播算法,深度学习就不可能得以快速发展,因此在此之前,有必要了解一下反向传播算法的具体原理和公式推导。请注意:这里的所有推导过程都只是针对当前设置的参数信息,并不具有一般性,但是所...

DaVinciL的博客 1545

DAVIS前言:事件相机资料调研

Event-Camera 资料集锦 1. 官网资料 假设了你买了事件相机,就可以在以下几个链接了解相关的参数和gui界面安装,如果不喜欢gui界面安装,可以第2节,安装相关的源码驱动。 DVS/DAVIS产品说明 等相关产品的软硬件介绍。 iniVation DV教程文档 给出在不同平台下的dvs-gui界面,可按照其说明进行相应的操作。 另外,Neuromorphic vision com...

Ian的博客 4152

梯度反向传播:深度学习中的核心算法

1.背景介绍 深度学习是人工智能领域的一个重要分支,它主要通过模拟人类大脑中的神经网络来实现智能化的计算和决策。深度学习的核心技术之一就是梯度反向传播(Gradient Descent Backpropagation,简称Backpropagation)算法,它是一种优化算法,用于最小化神经网络中损失函数的值。 在深度学习中,我们通过训练神经网络来学习模型参数,以便在实际应用中更好地进行预测和...

AI天才研究院 1491

VS中的C#项目怎样引入另一个项目

场景 在C#项目A中需要引用项目B。 实现 将项目B手动复制到A所在的项目目录下的同一个解决方案中,即与项目A同级的目录下。 在VS中打开项目B,打开解决方案资源管理器--右击解决方案--添加--现有项目 然后找到项目B的.csproj文件打开。 然后看到资源管理器中已经将B添加进来了 点击项目A的引用-右键-添加 将项目下的解决方...

BADAO_LIUMANG_QIZHI的博客 8833
上一篇: 深度学习之梯度下降法
下一篇: KMP算法介绍
dianshu1593
博客等级 码龄10年 56粉丝 103原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值