


Hugging Face 是一个提供先进自然语言处理( NLP )工具的平台,支持 Transformer 模型的开发和应用。它拥有庞大的模型库和社区资源,能够满足从研究到工业应用的各种需求。
一、注册
官方网址: https://huggingface.co/
注册好后,点击头像Access Token,创建token 。
二、功能介绍
hugging face的核心组件 主要是 Transformers 和Datasets 。
1、Transformers
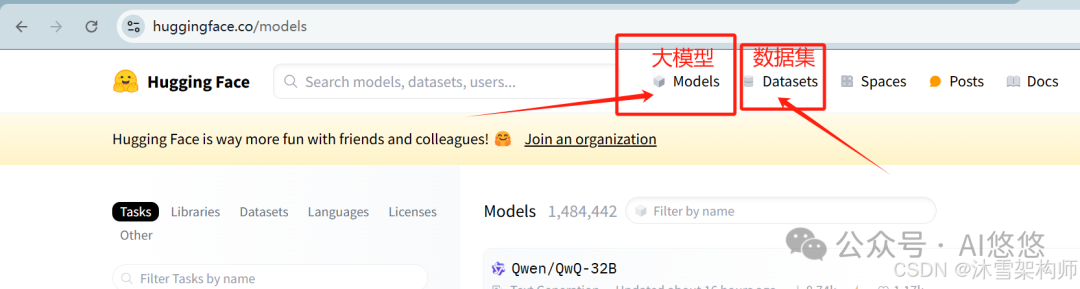
也就是 Models大模型,平台上有世界上最全的大模型。中国的魔塔社区与此类似,不过没有它全。 我们自己也可以上传大模型到hugging face平台。
2、Datasets
就是数据集,大模型训练用的数据。
3、大模型分类
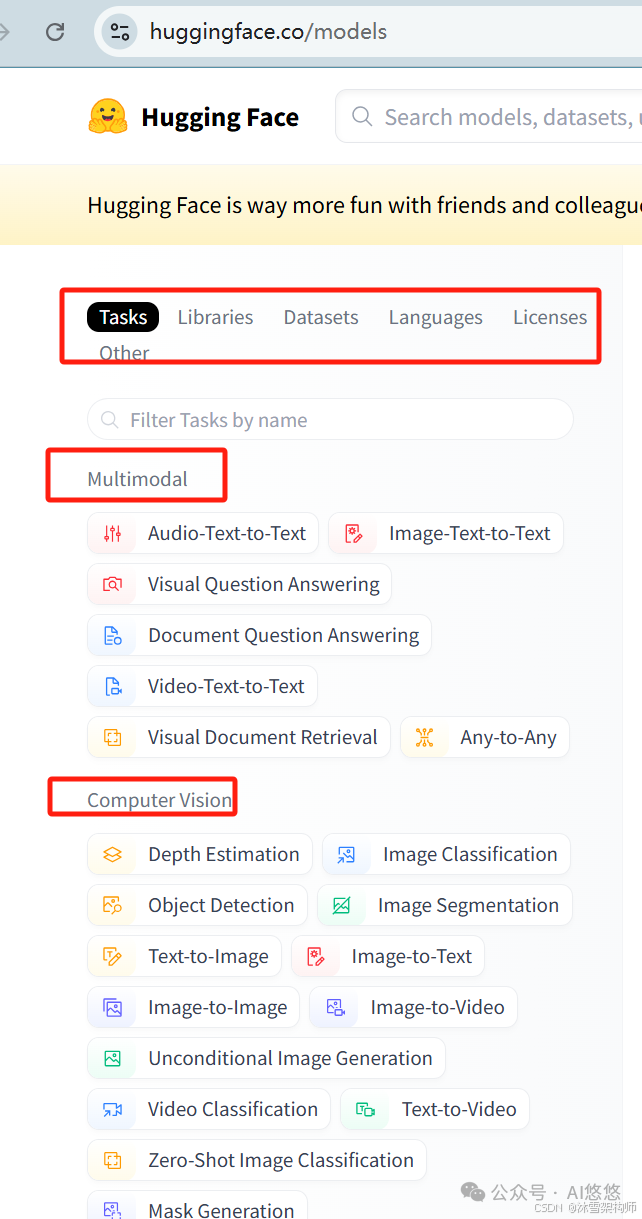
点击“Models”,左侧有分类。主导航有根据“任务Tasks”,“库Libraries”,"数据集DataSets","语言Languages","开源协议Licenses"等。
4、大模型文件
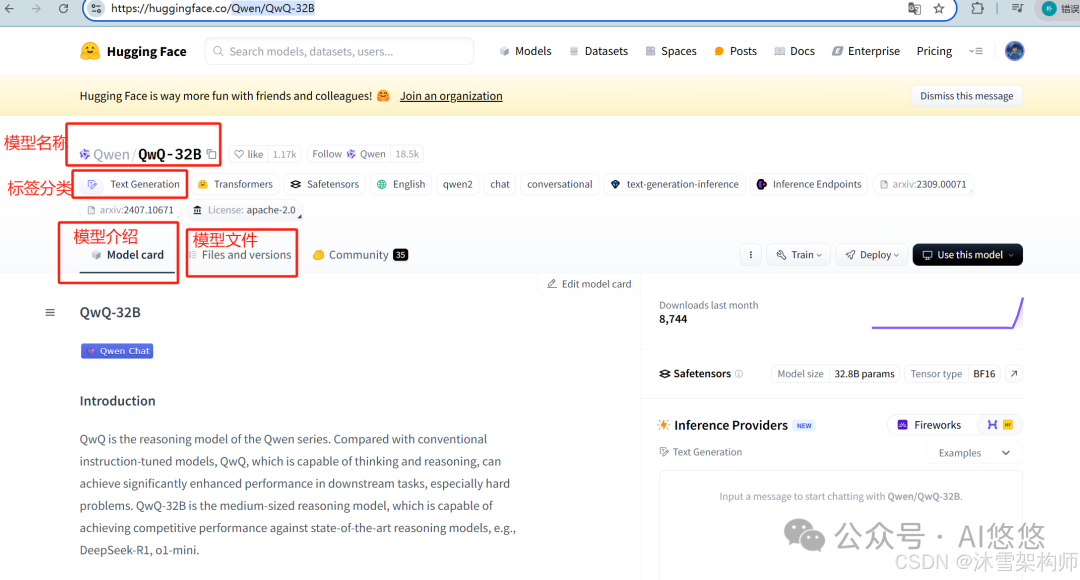
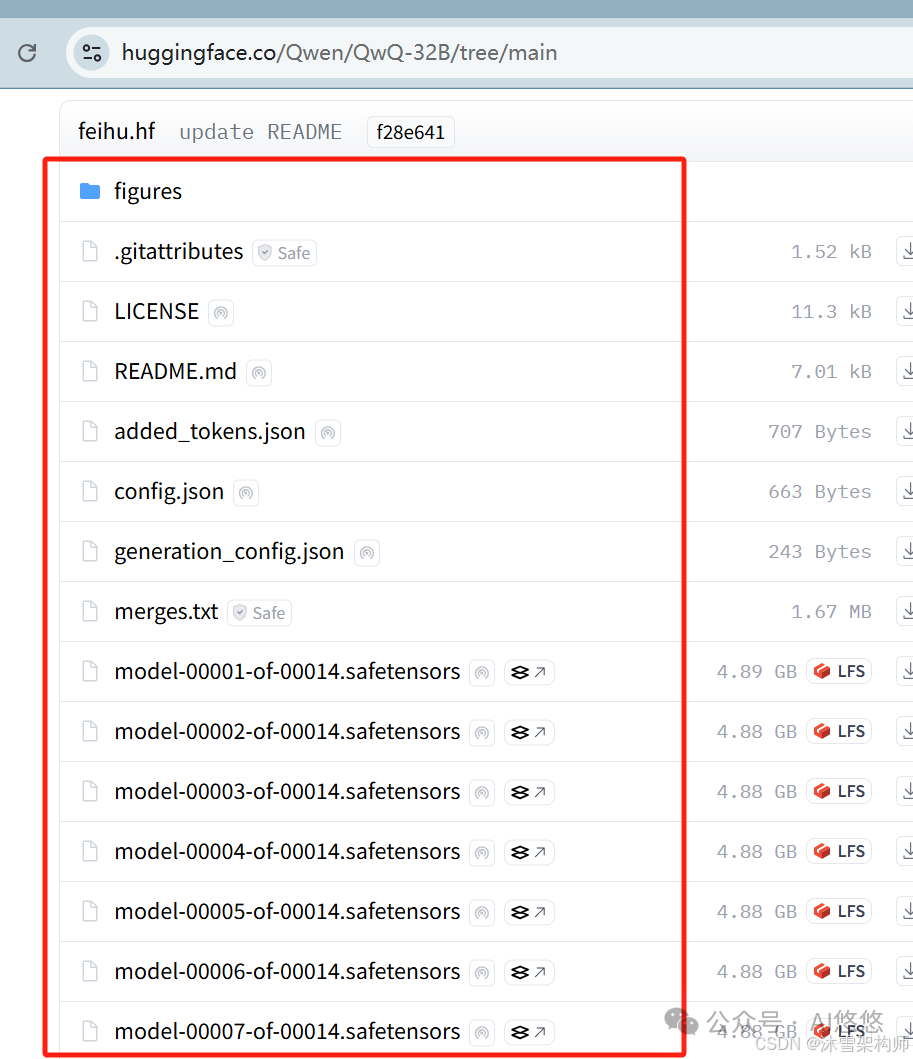
打开千问最新版本 Qwen/QwQ-32B,在"Files and Versions"模型文件页面下,可以看到很多类似”model-00001-of-00014.safetensors“ ,后缀 safetensors就是模型文件的名称。
5、Inference Providers
hugging face平台上有很多大模型提供接口试用,列表有黄色闪电标记,详情的右侧有Inference Providers。
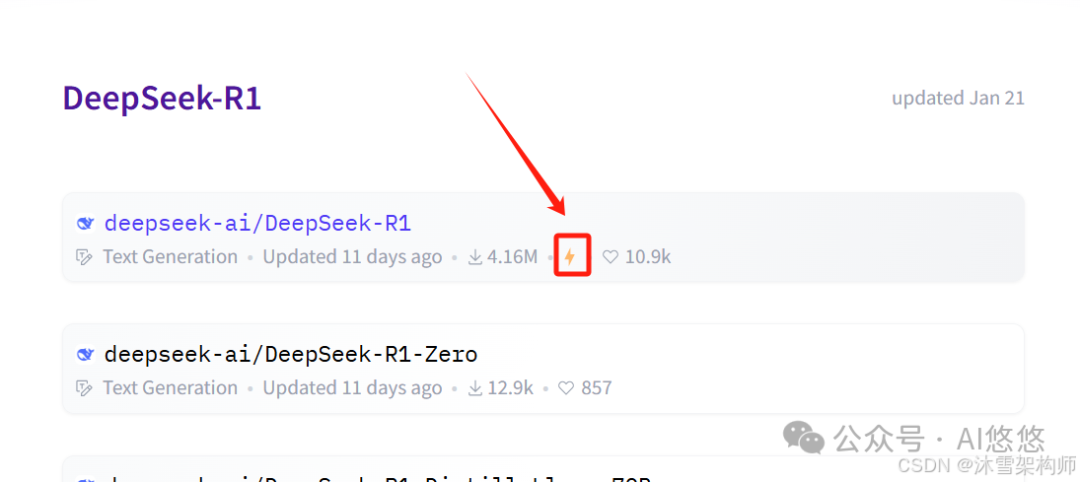
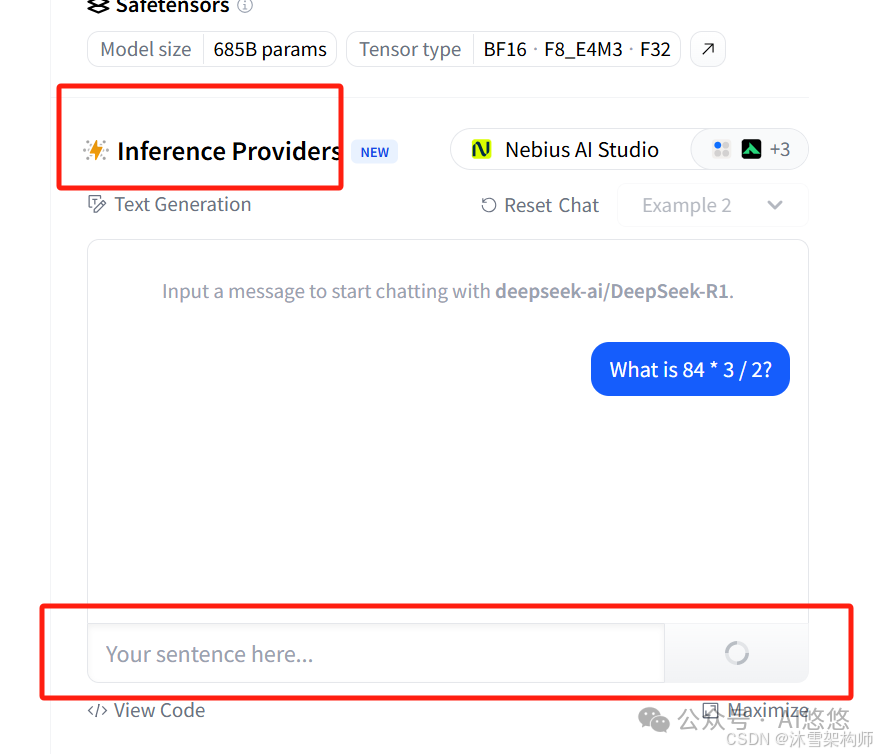
不过接口调用不是很稳定,时长不通。
6、下载大模型文件
下载大模型文件到本地,官方提供了多种方式。
(1)git clone方式
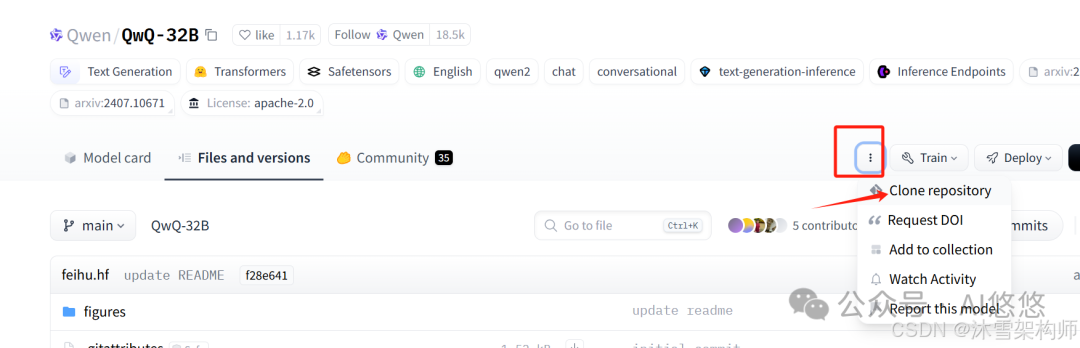
git clone https://huggingface.co/Qwen/QwQ-32B
(2)使用hugging face提供的transformers库下载
下一节重点讲解。
三、使用 Transformers 库
Hugging Face 提供了 transformers 库,用于加载和使用模型 。你可以使用以下命令来安装它:(电 脑须安装基础环境:Anaconda,CUDA,cuDNN,pytorch )
pip install transformers
如果你还需要安装其他依赖库,如 datasets 和 tokenizers ,可以使用以下命令:
pip install transformers datasets tokenizers
1、下载模型
使用代码下载模型到本地,代码演示使用depeek-r1-1.5b,小一点。等待大概几分钟就下载完成了,主要看网速。
from transformers import AutoTokenizer,AutoModelForCausalLMmodel_name="deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B"cache_dir="model3/deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B"#下载模型AutoModelForCausalLM.from_pretrained(model_name,cache_dir=cache_dir)#下载分词工具AutoTokenizer.from_pretrained(model_name,cache_dir=cache_dir)print(f"模型和分词器已下载到:{cache_dir}")
AutoModelForCausalLM 是 Hugging Face 的 Transformers 库中的一个类,主要用于处理因果语言模型(Causal Language Model)任务。大部分的text-generation类型的大模型都可以使用这个类。
模型和分词器一般都是成对下载。
代码中model_name的名称一定要是 hugging face上模型的完整名称。cache_dir是本地文件目录,可以使用绝对路径,pycharm开发时,可使用相对路径。
2、模型文件介绍
下载好后的目录如下
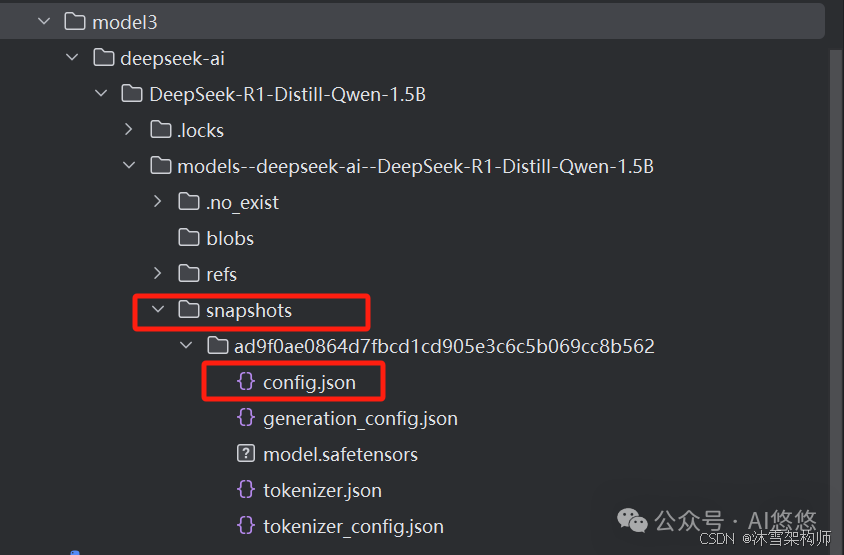
模型的核心内容主要是看 snapshots-config.json所在的目录,也是模型的默认目录地址。model.safetensors就是模型的源文件,
(1)config.json文件
{"architectures": ["Qwen2ForCausalLM"],"attention_dropout": 0.0,"bos_token_id": 151643,"eos_token_id": 151643,"hidden_act": "silu","hidden_size": 1536,"initializer_range": 0.02,"intermediate_size": 8960,"max_position_embeddings": 131072,"max_window_layers": 21,"model_type": "qwen2","num_attention_heads": 12,"num_hidden_layers": 28,"num_key_value_heads": 2,"rms_norm_eps": 1e-06,"rope_theta": 10000,"sliding_window": 4096,"tie_word_embeddings": false,"torch_dtype": "bfloat16","transformers_version": "4.44.0","use_cache": true,"use_mrope": false,"use_sliding_window": false,"vocab_size": 151936}
vocab_size是模型可以识别的字符个数。有些模型文件vocab.txt文件,就是可以识别字符列表。若输入的字符不在这个范围内,分词器会根据配置的special_tokens里的值来赋值。比如下面的:
BertTokenizer(name_or_path='D:\Test\LLMTrain\day02\model\bert-base-chinese\models--bert-base-chinese\snapshots\c30a6ed22ab4564dc1e3b2ecbf6e766b0611a33f', vocab_size=21128, model_max_length=512, is_fast=False, padding_side='right', truncation_side='right', special_tokens={'unk_token': '[UNK]', 'sep_token': '[SEP]', 'pad_token': '[PAD]', 'cls_token': '[CLS]', 'mask_token': '[MASK]'}, clean_up_tokenization_spaces=True, added_tokens_decoder={
3、Pipelines运行本地模型
大模型下载到本地,就可以使用了,transformers库中的pipelines是一个非常实用的高级工具,它为自然语言处理(NLP)任务提供了一种简单、便捷且统一的接口,使得用户无需深入了解模型的具体细节就能轻松完成各种常见的 NLP 任务。pipelines的主要特点如下:
(1) 简化模型使用流程
在传统的使用方式中,若要使用一个预训练模型完成特定任务,需要手动完成加载模型、分词、编码、推理、解码等一系列复杂的步骤。而pipelines将这些步骤进行了封装,用户只需提供任务类型和必要的输入,就能直接得到任务的处理结果。
例如,使用pipelines进行文本分类:
from transformers import BertTokenizer,BertForSequenceClassification,pipeline#设置具体包含config.json的目录,只支持绝对路径model_dir = r"model\bert-base-chinese"#加载模型和分词器model = BertForSequenceClassification.from_pretrained("bert-base-chinese",cache_dir=model_dir)tokenizer = BertTokenizer.from_pretrained("bert-base-chinese",cache_dir=model_dir)#创建分类pipleineclassifier = pipeline("text-classification",model=model,tokenizer=tokenizer,device="cpu")#进行文本分类result = classifier("你好,我是一款语言模型")print(result)print(model)
上述代码中,用户只需创建一个text - classification类型的管道,然后传入文本,就能直接得到文本的分类结果,无需关心模型加载、分词等底层操作。
(2)支持多种常见 NLP 任务
pipelines支持多种常见的自然语言处理任务,以下是一些常见任务及其示例:
文本分类:判断文本所属的类别,如情感分析(积极、消极)、主题分类等。
classifier = pipeline('text-classification')result = classifier("This is a great product!")
问答系统:根据给定的上下文和问题,找出问题的答案。
qa = pipeline('question-answering')context = "Albert Einstein was a German-born theoretical physicist. He developed the theory of relativity."question = "Who developed the theory of relativity?"result = qa(question=question, context=context)
文本生成:根据输入的文本生成相关的文本内容,如故事续写、摘要生成等。
generator = pipeline('text-generation')input_text = "Once upon a time"result = generator(input_text, max_length=100)
命名实体识别(NER):识别文本中的命名实体,如人名、地名、组织机构名等。
ner = pipeline('ner')text = "Apple is looking at buying U.K. startup for $1 billion"result = ner(text)
(3)自动选择合适的模型
pipelines会根据指定的任务类型自动选择合适的预训练模型。例如,当你创建一个text - classification管道时,它会默认选择一个在文本分类任务上表现良好的预训练模型。当然,你也可以手动指定使用的模型,只需在创建管道时传入model参数即可。
# 使用指定的模型创建文本分类管道classifier = pipeline('text-classification', model='distilbert-base-uncased-finetuned-sst-2-english')
注意,这里需要能联网,并且能科学上网。可以使用本地的大模型调用。
#本地离线调用deepseek-r1from transformers import AutoModelForCausalLM,AutoTokenizer,pipeline#设置具体包含config.json的目录,只支持绝对路径model_dir = r"D:\trsanformers_test\model3\deepseek-ai\DeepSeek-R1-Distill-Qwen-1.5B\models--deepseek-ai--DeepSeek-R1-Distill-Qwen-1.5B\snapshots\ad9f0ae0864d7fbcd1cd905e3c6c5b069cc8b562"#加载模型和分词器model = AutoModelForCausalLM.from_pretrained(model_dir)tokenizer = AutoTokenizer.from_pretrained(model_dir)# 模拟多轮对话,设置角色信息messages = [{"role": "user", "content": "请使用java写一个冒泡排序。"}]# 构建输入文本,按照 DeepSeek - R1 的格式input_text = ""for message in messages:if message["role"] == "user":input_text += f"<|UserBegin|>{message['content']}<|UserEnd|>"elif message["role"] == "assistant":input_text += f"{message['content']}"#使用加载的模型和分词器创建生成文本的pipelinegenerator = pipeline("text-generation",model=model,tokenizer=tokenizer,device="cpu")#生成文本# output = generator("你好,我是一款语言模型,",max_length=50,num_return_sequences=1)output = generator(input_text,#生成文本的输入种子文本(prompt)。模型会根据这个初始文本,生成后续的文本max_length=1500,#指定生成文本的最大长度。这里的 50 表示生成的文本最多包含 50 个标记(tokens)num_return_sequences=1,#参数指定返回多少个独立生成的文本序列。值为 1 表示只生成并返回一段文本。truncation=True,#该参数决定是否截断输入文本以适应模型的最大输入长度。如果 True,超出模型最大输入长度的部分将被截断;如果 False,模型可能无法处理过长的输入,可能会报错。temperature=0.7,#该参数控制生成文本的随机性。值越低,生成的文本越保守(倾向于选择概率较高的词);值越高,生成的文本越多样(倾向于选择更多不同的词)。0.7 是一个较为常见的设置,既保留了部分随机性,又不至于太混乱。top_k=50,#该参数限制模型在每一步生成时仅从概率最高的 k 个词中选择下一个词。这里 top_k=50 表示模型在生成每个词时只考虑概率最高的前 50 个候选词,从而减少生成不太可能的词的概率。top_p=0.9,#该参数(又称为核采样)进一步限制模型生成时的词汇选择范围。它会选择一组累积概率达到 p 的词汇,模型只会从这个概率集合中采样。top_p=0.9 意味着模型会在可能性最强的 90% 的词中选择下一个词,进一步增加生成的质量。clean_up_tokenization_spaces=True#该参数控制生成的文本中是否清理分词时引入的空格。如果设置为 True,生成的文本会清除多余的空格;如果为 False,则保留原样。默认值即将改变为 False,因为它能更好地保留原始文本的格式。)print(output)
如何系统的去学习大模型LLM ?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑……
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!
在这个版本当中:
第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

五、AI产品经理大模型教程

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


