


Hugging face 起初是一家总部位于纽约的聊天机器人初创服务商,他们本来打算创业做聊天机器人,然后在github上开源了一个Transformers库,虽然聊天机器人业务没搞起来,但是他们的这个库在机器学习社区迅速大火起来。目前已经共享了超100,000个预训练模型,10,000个数据集,变成了机器学习界的github。
其之所以能够获得如此巨大的成功,一方面是让我们这些甲方企业的小白,尤其是入门者也能快速用得上科研大牛们训练出的超牛模型。另一方面是,这种特别开放的文化和态度,以及利他利己的精神特别吸引人。huggingface上面很多业界大牛也在使用和提交新模型,这样我们就是站在大牛们的肩膀上工作,而不是从头开始,当然我们也没有大牛那么多的计算资源和数据集。
在国内huggingface也是应用非常广泛,一些开源框架本质上就是调用transfomer上的模型进行微调(当然也有很多大牛在默默提供模型和数据集)。很多nlp工程师招聘的条目上也明摆着要求熟悉huggingface transformer库的使用。简单介绍了他们多么牛逼之后,我们看看huggingface怎么玩吧。因为他既提供了数据集,又提供了模型让你随便调用下载,因此入门非常简单。你甚至不需要知道什么是GPT,BERT就可以用他的模型了(当然看看我写的BERT简介还是十分有必要的)。下面初步介绍下huggingface里面都有什么,以及怎么调用BERT模型做个简单的任务。
1.我们能从huggingface获得什么
内容
huggingface的官方网站:http://www.huggingface.co. 在这里主要有以下大家需要的资源。
Datasets:数据集,以及数据集的下载地址
Models:各个预训练模型
course:免费的nlp课程,可惜都是英文的
docs:文档
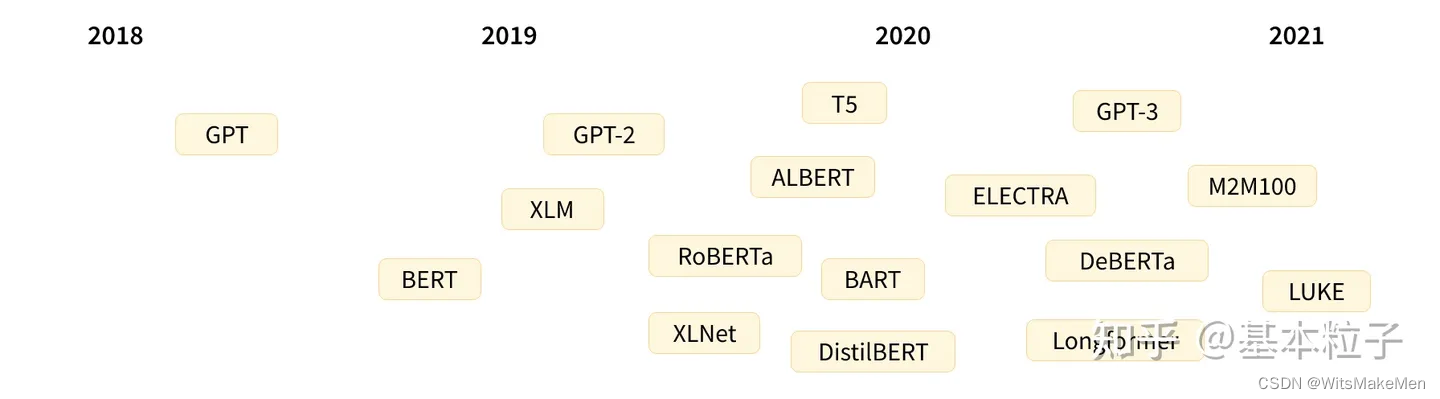
下图是一张来自于官网的Transformers发展谱系图,短短3,4年就发展出了庞大家族。如果你不是学术界的代表,你无需详细搞懂他们的原理,就可以直接使用这些科研界最先进的模型,下一章我们来介绍如何简单的拿这些模型进行nlp任务。
一个有趣的现象
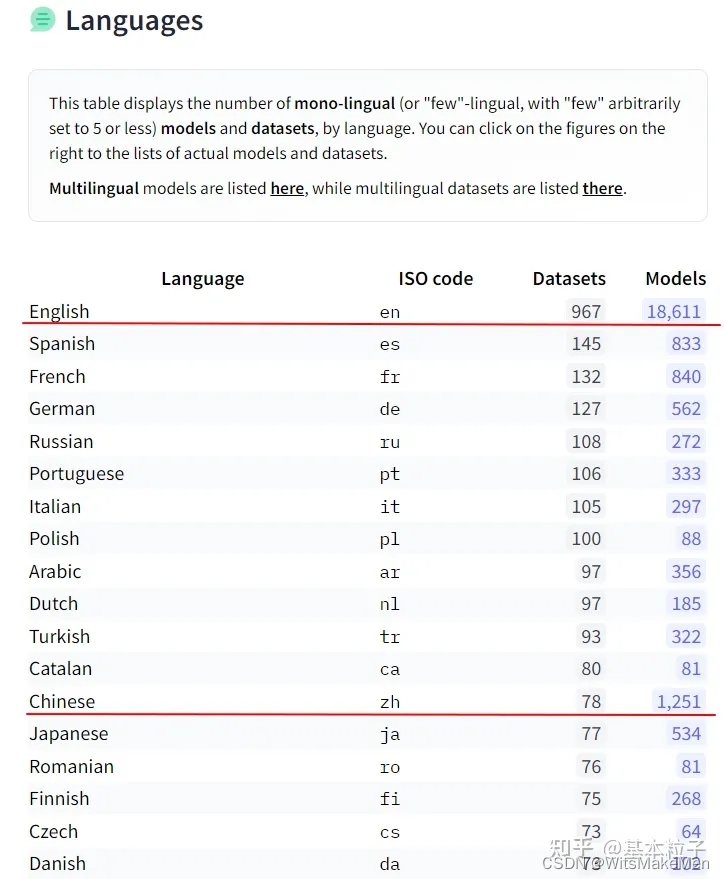
在NLP领域,在hugging face上面数据集和预训练模型的数量以英语为最为众多,远超其他国家的总和(见下图)。就预训练模型来说,排名第二的是汉语。就数据集来说,汉语远远少于英语,也少于法,德,西班牙等语言,甚至少于阿拉伯语和波兰语。这严重跟我想象中的AI超级大国及其不匹配。我想一方面因为数据集的积累都需要很多年,中文常用的(PKU,MSRA)数据集都是十几年前留下的,而我们AI和经济的崛起也不过是最近十年的事情。另一方面,数据集都是大价钱整理出来的,而且可以不断的利用他产生新的模型,这样的大杀器怎可随意公布。发布预训练模型可以带来论文,数据集可啥也带不来,基本上中日韩等的数据集明显偏少。
2.小试牛刀
接下来的内容参考了下面的内容,初步带你入门huggingface,简单了解如何调用BERT模型:
dxzmpk写的教程 https://www.cnblogs.com/dongxiong/p/12763923.html
huggingface官方教程:https://huggingface.co/docs/transformers/model_doc/bert
有必要阅读的论文:
https://arxiv.org/abs/1706.03762
https://arxiv.org/abs/1706.03762
如果看英文论文太费劲,可以参考我写的学习笔记:
attention与sef-attention介绍
transformer模型结构介绍
Bert简单介绍
安装
transformers库github地址在:https://github.com/huggingface/transformers
安装方法,在命令行执行(conda的话在anaconda propmt):
pip install transformers # 安装最新的版本
pip install transformers == 4.0 # 安装指定版本
#如果你是conda的话
conda install -c huggingface transformers  # 4.0以后的版本才会有
测试下安装是否成功
from transformers import pipeline  # 引入一个pipeline试试看,如果不报错说明安装成功、
# 因为NLP通常是多个任务顺序而成,所以通常使用pipeline,流水线工作
模型的组成
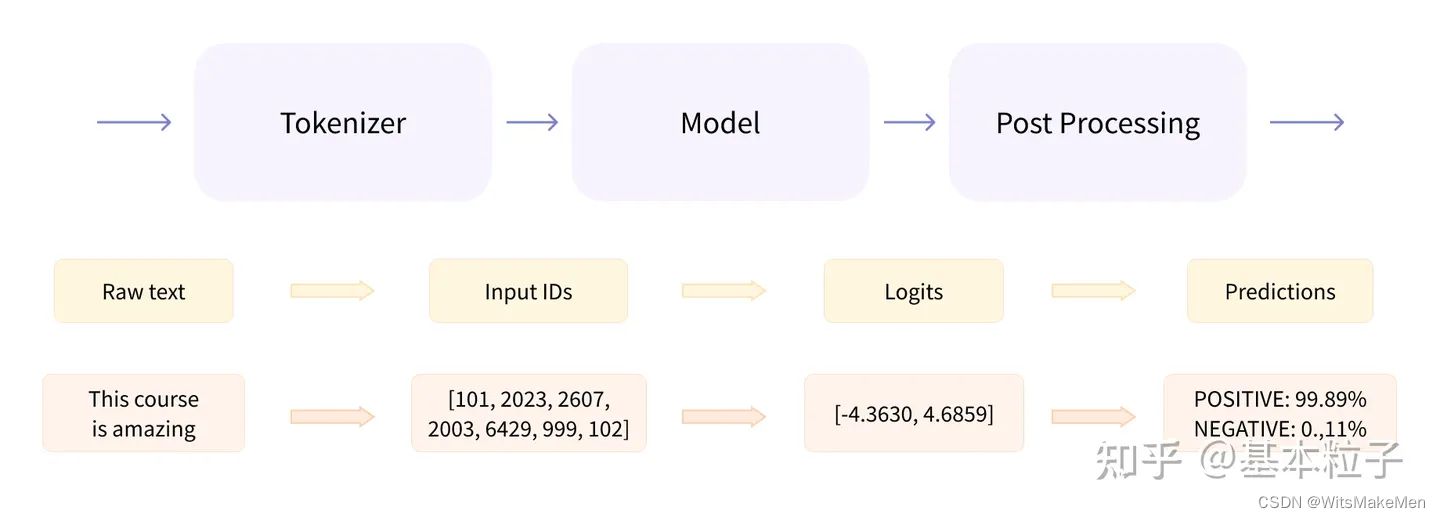
一般transformer模型有三个部分组成:1.tokennizer,2.Model,3.Post processing。如下图所示,图中第二层和第三层是每个部件的输入/输出以及具体的案例。我们可以看到三个部分的具体作用:Tokenizer就是把输入的文本做切分,然后变成向量,Model负责根据输入的变量提取语义信息,输出logits;最后Post Processing根据模型输出的语义信息,执行具体的nlp任务,比如情感分析,文本自动打标签等;可见Model是其中的核心部分,Model又可以分为三种模型,针对不同的NLP任务,需要选取不同的模型类型:Encoder模型(如Bert,常用于句子分类、命名实体识别(以及更普遍的单词分类)和抽取式问答。),Decoder模型(如GPT,GPT2,常用于文本生成),以及sequence2sequence模型(如BART,常用于摘要,翻译,生成性问答等)
说了很多理论的内容,我们可以在huggingface的官网,随便找一个预训练模型具体看看包含哪些文件。在这里我举了一个中文的例子”Bert-base-Chinese“(中文还有其他很优秀的预训练模型,比如哈工大和科大讯飞提供的:roberta-wwm-ext,百度提供的:ernie)。这个模型据说是根据中文维基百科内容训练的,因此语义内容可能不是足够丰富,毕竟其他大佬们提供的数据更多。
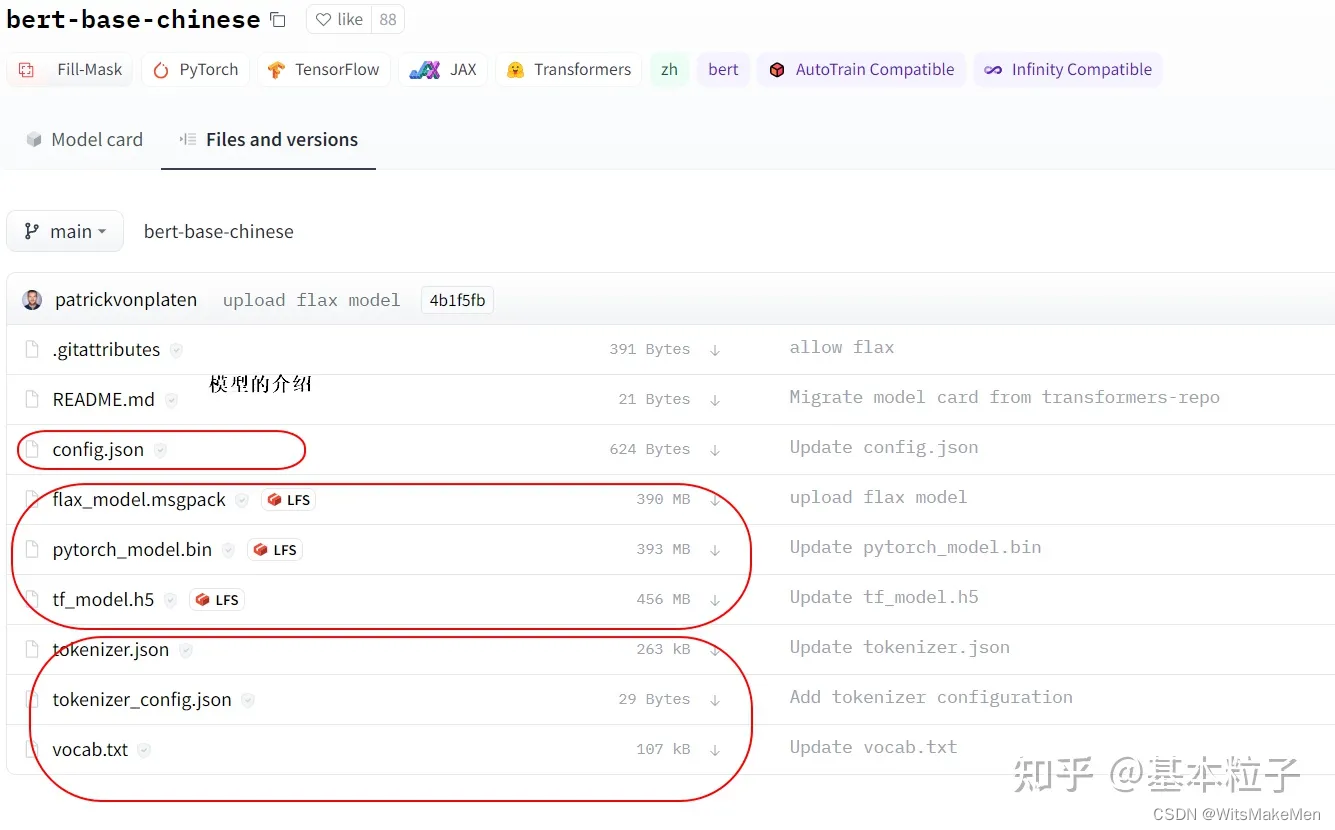
readme一般是模型的介绍,包括使用方法都会放到里面,不介绍了。其他最重要的组成部分,大概分为三类:
1. config
控制模型的名称、最终输出的样式、隐藏层宽度和深度、激活函数的类别等。这些参数我补齐了说明,对于初学者来说,大家一般不需要调整。这些参数都可以通过configuration类更改。
{


  "architectures": [
    "BertForMaskedLM"                           # 模型的名称
  ],
  "attention_probs_dropout_prob": 0.1,          # 注意力机制的 dropout,默认为0.1
  "directionality": "bidi",                     # 文字编码方向采用bidi算法
  "hidden_act": "gelu",                         # 编码器内激活函数,默认"gelu",还可为"relu"、"swish"或 "gelu_new"
  "hidden_dropout_prob": 0.1,                   # 词嵌入层或编码器的 dropout,默认为0.1
  "hidden_size": 768,                           # 编码器内隐藏层神经元数量,默认768
  "initializer_range": 0.02,                    # 神经元权重的标准差,默认为0.02
  "intermediate_size": 3072,                    # 编码器内全连接层的输入维度,默认3072
  "layer_norm_eps": 1e-12,                      # layer normalization 的 epsilon 值,默认为 1e-12
  "max_position_embeddings": 512,               # 模型使用的最大序列长度,默认为512
  "model_type": "bert",                         # 模型类型是bert
  "num_attention_heads": 12,                    # 编码器内注意力头数,默认12
  "num_hidden_layers": 12,                      # 编码器内隐藏层层数,默认12
  "pad_token_id": 0,                            # pad_token_id 未找到相关解释
  "pooler_fc_size": 768,                        # 下面应该是pooler层的参数,本质是个全连接层,作为分类器解决序列级的NLP任务
  "pooler_num_attention_heads": 12,             # pooler层注意力头,默认12
  "pooler_num_fc_layers": 3,                    # pooler 连接层数,默认3
  "pooler_size_per_head": 128,                  # 每个注意力头的size
  "pooler_type": "first_token_transform",       # pooler层类型,网上介绍很少
  "type_vocab_size": 2,                         # 词汇表类别,默认为2
  "vocab_size": 21128                           # 词汇数,bert默认30522,这是因为bert以中文字为单位进入输入
}
2. tokenizer(包含三个文件)
这些文件是tokenizer类生成的,或者处理的,只是处理文本,不涉及任何向量操作。
vocab.txt是词典文件(打开就是单个字符,我这里用的是bert-base-chinsese,可以看到里面都是保留符号和单个汉字索引,字符)
tokenizer.json和config是分词的配置文件,根据vocab信息和你的设置更新,里面把vocab都按顺序做了索引,将来可以根据编码生成one-hot向量,然后跟embeding训练的矩阵相乘,就可以得到该字符的向量。下图是tokenizer.json内容。
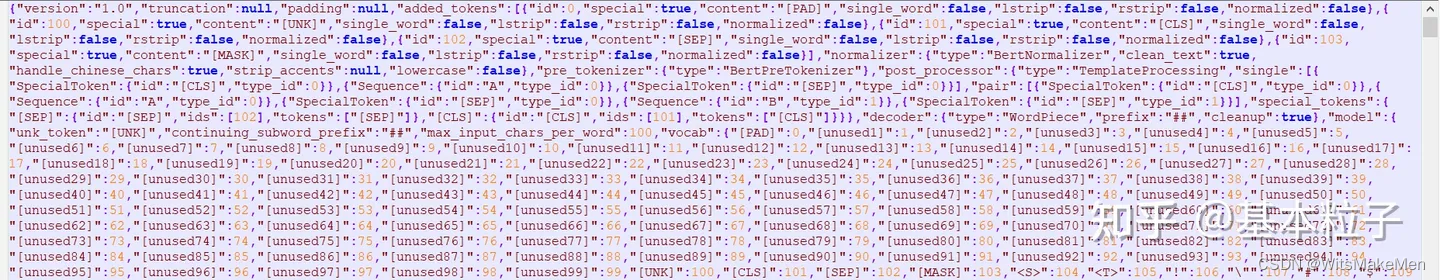
模型文件一般是tensor flow(上图中的h5文件)和py-torch(上图中的bin文件)的都有,因为作者只是单纯的在学习torch,所以以后的文章都只介绍torch。
3. BERT模型的使用
介绍完了模型库都有哪些内容,下面我们可以导入模型试一试怎么使用啦。
3.1 导入模型
利用官方的hub导入模型;下面导入了一个BertModel;在官方的教程中推进使用pipeline导入模型的方法;
import torch
from transformers import BertModel, BertTokenizer, BertConfig
# 首先要import进来
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')
config = BertConfig.from_pretrained('bert-base-chinese')
config.update({

   'output_hidden_states':True}) # 这里直接更改模型配置
model = BertModel.from_pretrained("bert-base-chinese",config=config)
利用pipeline的方式也是一样的可以导入模型哈,方式如下:
from transformers import AutoModel
checkpoint = "bert-base-chinese"
model = AutoModel.from_pretrained(checkpoint)
因为huggingface官网在国外,自动下载可能比较费劲,笔者在公司下载速度还是非常快的。
默认下载地址在这里:
1)使用 Windows 模型保存的路径在 C:\Users[用户名].cache\torch\transformers
目录下,根据模型的不同下载的东西也不相同 2)使用 Linux 模型保存的路径在 ~/.cache/torch/transformers/
目录下
如果自动下载总是中断的话,可以考虑用国内的源,或者手工下载之后指定位置。(huggingface官网,选择models菜单,然后搜索自己想要的模型,然后把里面的文件下载下来,其中体积较大的有tf的有torch的,根据自己需要下载)。
import transformers
MODEL_PATH = r"D:\\test\\bert-base-chinese"
# 导入模型
tokeniz

 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


