同じ$100で違うのは、ベンチでも機能でもなく、長文の単価と枠の設計だった ChatGPT/Claude サブスク比較

Claude Fable 5.1 が2026年9月1日、GPT-6 Astra が9月3日。中2日で両社の最上位が出そろって、API単価も入力$10 / 出力$50でぴたりと並んだ。
先に結論を書いておく。「どっちが強いか」は決着していない。独立ベンチの差は誤差に埋もれているし、クラウド実行もGitHub連携も自動コードレビューも、9月時点では両方にある。残っている違いは利用枠の設計と、長文とキャッシュの単価構造の2つだけだ。そしてどちらが有利かは、自分の一日がどう流れているかで変わる。
自分はフルスタックエンジニアとして、Claude Code と LiteLLM、claude-code-router、それにローカルLLMを日常的に回している。マルチエージェント構成も自前で組んでいる。その前提で、同じ$100を今どちらに置くかという話を書く。
いま並んでいるモデルを、いちど整理しておく
比較の前に名前を揃えておきたい。ここが一番混ざりやすい。
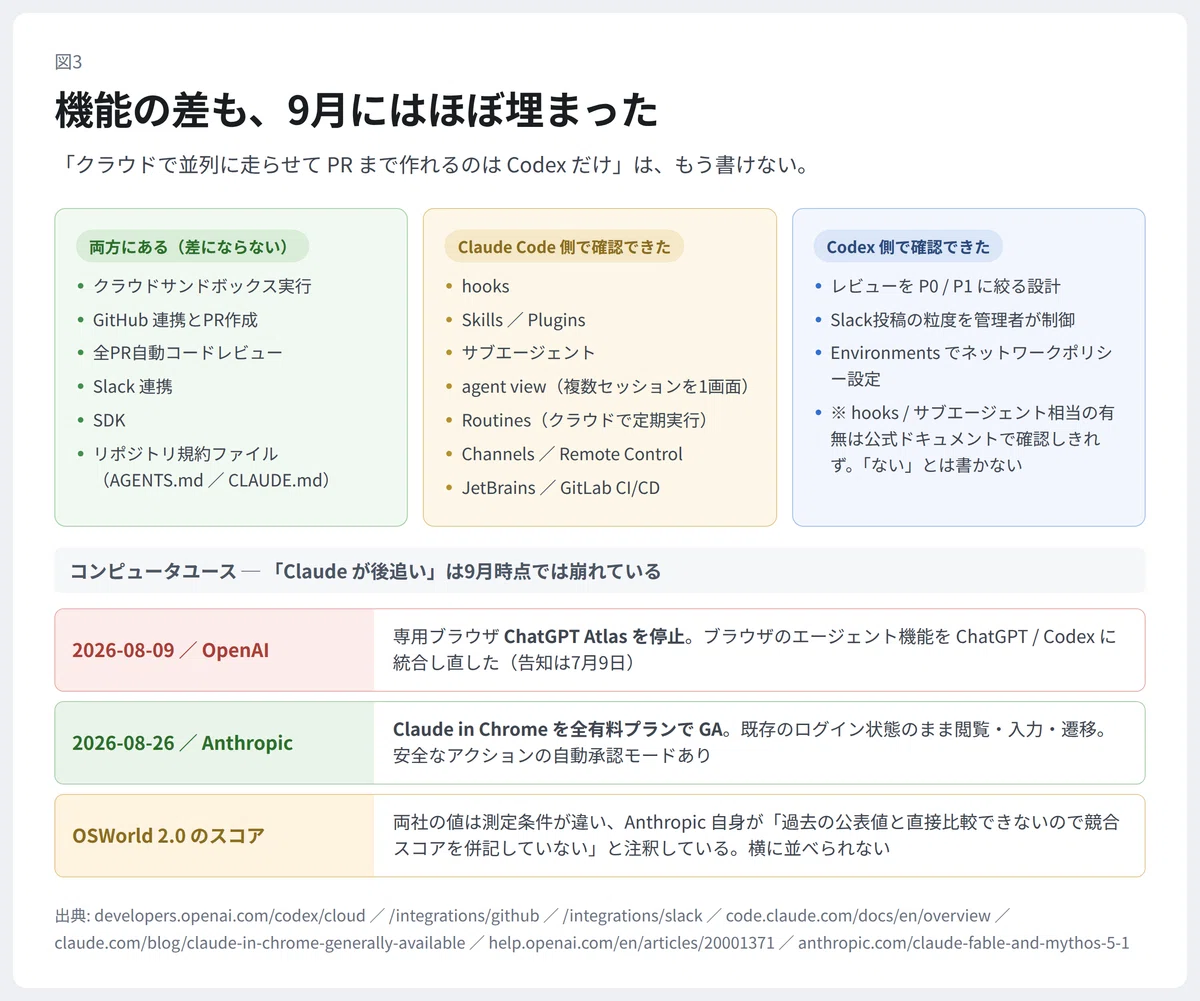
Claude側は9月1日の Fable 5.1 が最上位で$10/$50。手前に6月9日の Fable 5(同じ$10/$50)、7月24日の Opus 5($5/$25)、6月30日の Sonnet 5($2/$10)が並ぶ。上が出たから下が消えたわけではなく全部が現役で、コンテキストはどれも1M、最大出力128Kでそろっている。見落としがちなのは、Anthropic の開発者ドキュメントが「まず Opus 5 から始めて、足りないときに Fable 5.1」と書いていること。半額のモデルのほうが公式の出発点になっている。
OpenAI側は9月3日の GPT-6 Astra が最上位で$10/$50、コンテキストは約105万トークン。手前が7月9日の GPT-5.6 で、Sol が$4/$20、Terra が$2/$12、Luna が$0.20/$1.20の3ティア構成。Sol の価格には「少なくとも2026年11月21日まで有効」というプロモーション注記が付いている。
ここで間違えやすいのが、Sol / Terra / Luna を GPT-6 の下位モデルだと思ってしまうこと。この3つはひとつ前の GPT-5.6 の3ティアで、GPT-6 世代で名前が確認できるのは Astra だけだ。
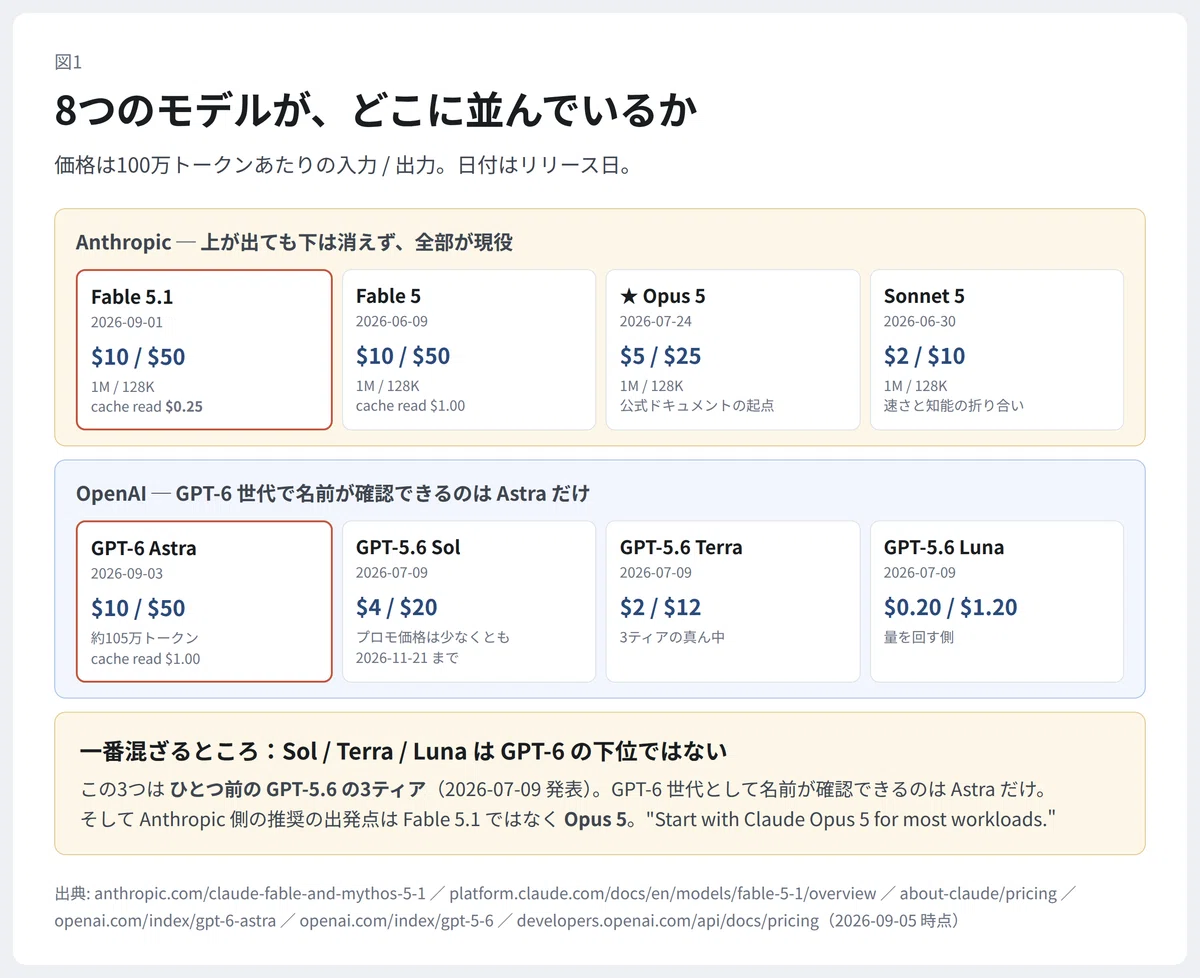
実力の並びも見ておく。Artificial Analysis の Coding Agent Index では Fable 5.1 が70で、Astra・Opus 5・Fable 5 が67に固まっている。総合知能の Intelligence Index v4.1.1 では Fable 5.1 が66、Opus 5 が63、Fable 5 が62、Sol と Astra が61。コーディングでも総合でも先頭は Fable 5.1 だった。
ベンチの0.3ポイントは選定理由にならない
ただ、その70対67をそのまま選定理由にはできない。この指標が測っているのはモデル単体ではないからだ。
Fable 5.1 の70は Claude Code ハーネス、Astra の67は Codex ハーネスで出た数字になる。方法論ページ自体が「開発者はモデルと同時にハーネスも選んでいる」という設計思想で書かれている。つまりこれは製品同士の比較であって、モデル同士の比較ではない。
Terminal-Bench 4.0 のほうはもっと差がない。Stanford / Harbor / Laude Institute がホストする第三者ベンチで、公開リーダーボードでは Astra が58.2%、Fable 5.1 が57.9%。差は0.3ポイントで、それぞれの誤差幅(±2.8と±3.8)に完全に埋もれている。
やっかいなのは、各社の公式ページが自己申告値を載せていることだ。OpenAI側は Astra 57.9%、Anthropic側は Fable 5.1 55.8%。この2つを並べると「Astraが勝っている」ように見えるが、測定条件の違う数字を並べているだけになる。
さきほどの Opus 5 の話もここに効いてくる。「$10/$50同士の一騎打ち」という構図自体が、Anthropic側の実際の使われ方を取りこぼしている。
機能の差も、9月にはほぼ埋まった
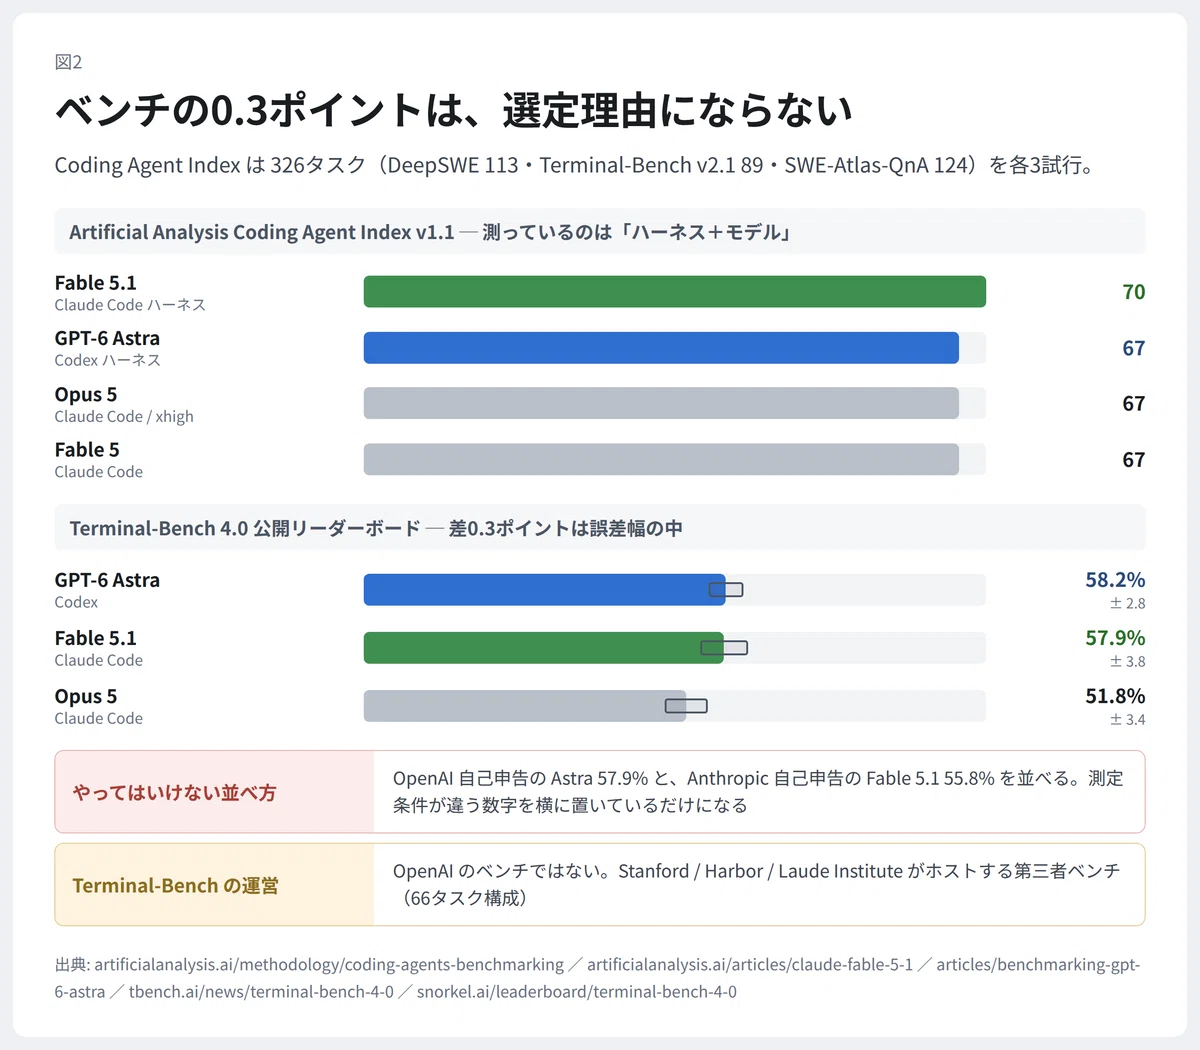
少し前なら「クラウドで並列に走らせてPRまで作れるのは Codex だけ」と書けた。もう書けない。
Codex cloud はGAで、リポジトリを渡せばクラウド環境で並列実行してPRを作る。Slackで `@Codex` に投げればタスクが立つし、diffを解析して P0 / P1 だけに絞るコードレビューもある。
Claude Code にも同じものがそろっている。Web版、GitHub Actions / GitLab CI/CD、全PR自動レビュー、Slackで `@Claude` にバグを投げるとPRが返る流れ。規約ファイルも AGENTS.md と CLAUDE.md でお互いに持っている。
コンピュータユースの「Claudeが後追い」も、9月時点では崩れている。OpenAI は2026年8月9日に専用ブラウザ ChatGPT Atlas を停止して ChatGPT / Codex に統合し直し、Anthropic は8月26日に Claude in Chrome を全有料プランでGAにした。方向としてはむしろ逆になっている。
Claude Code 側で確認できる独自機能は、hooks、Skills、Plugins、Routines、サブエージェント、複数セッションを1画面で見る agent view あたり。Codex側に同等のものがあるかは公式ドキュメントで確認しきれなかったので、「ない」とは書かないでおく。
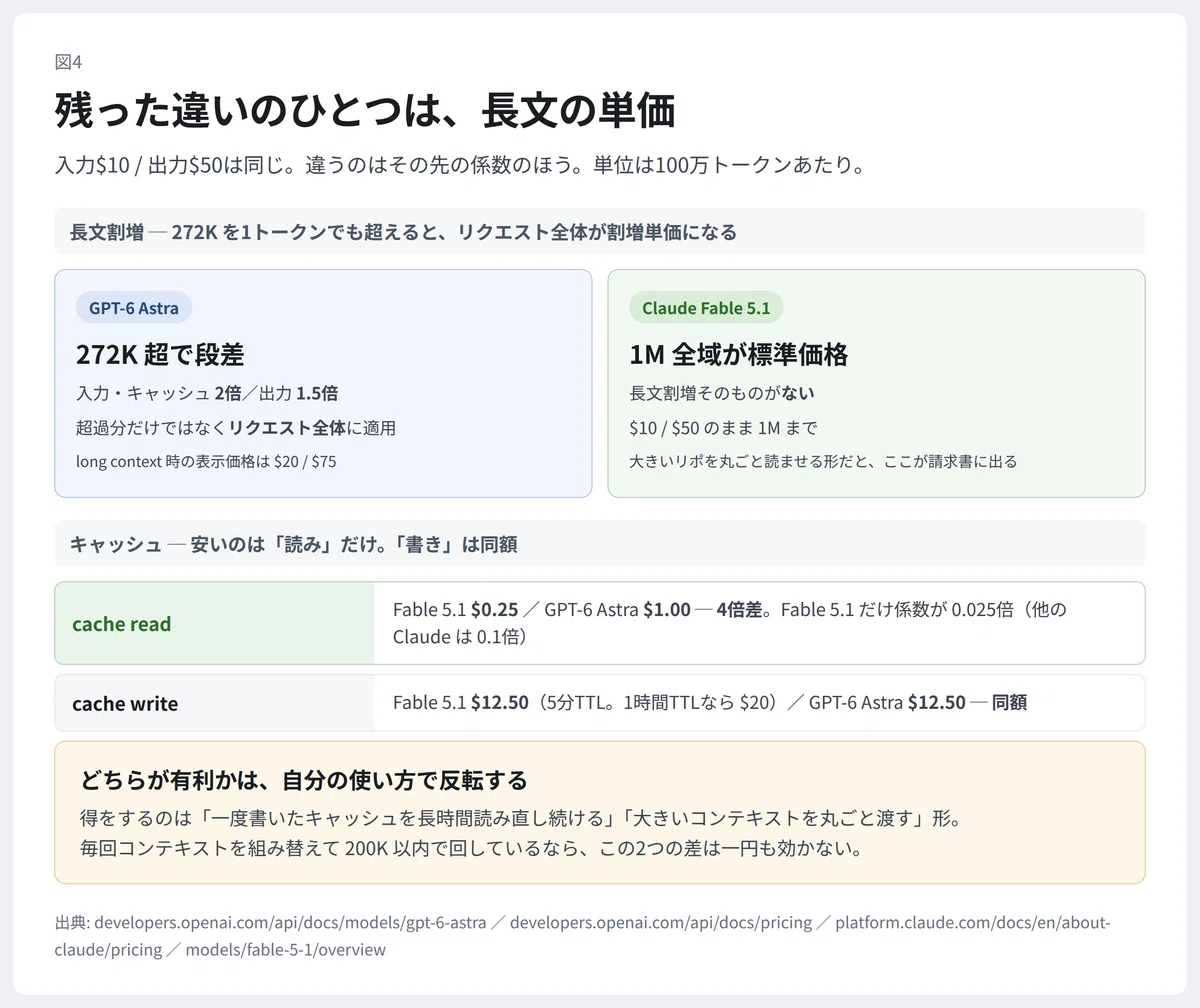
残った違いのひとつは、長文の単価
ここからが実利の話になる。入力$10 / 出力$50は同じでも、その先の係数が違う。
Astra は272Kトークンを超えると長文割増が入る。入力とキャッシュが2倍、出力が1.5倍。厄介なのは、これが超過分だけでなくリクエスト全体にかかることだ。1トークンでも超えたらそのリクエストの全部が割増単価になる。Fable 5.1 は1M全域が標準価格のままで、ここに段差がない。
大きいリポジトリを丸ごと読ませてから作業を始める人には、この差はそのまま請求書に出る。逆に、毎回コンテキストを絞って200K以内で回している人には一円も関係がない。自分の使い方がどちら側かで、有利不利がきれいに反転する。
キャッシュも似ている。読み込みは Fable 5.1 が$0.25、Astra が$1.00で4倍差。ただし書き込みは両社とも$12.50で同額だ。得をするのは「一度書いたキャッシュを長時間読み直し続ける」形の仕事で、毎回プロンプトを組み替えるなら差は消える。
もうひとつは、枠の設計
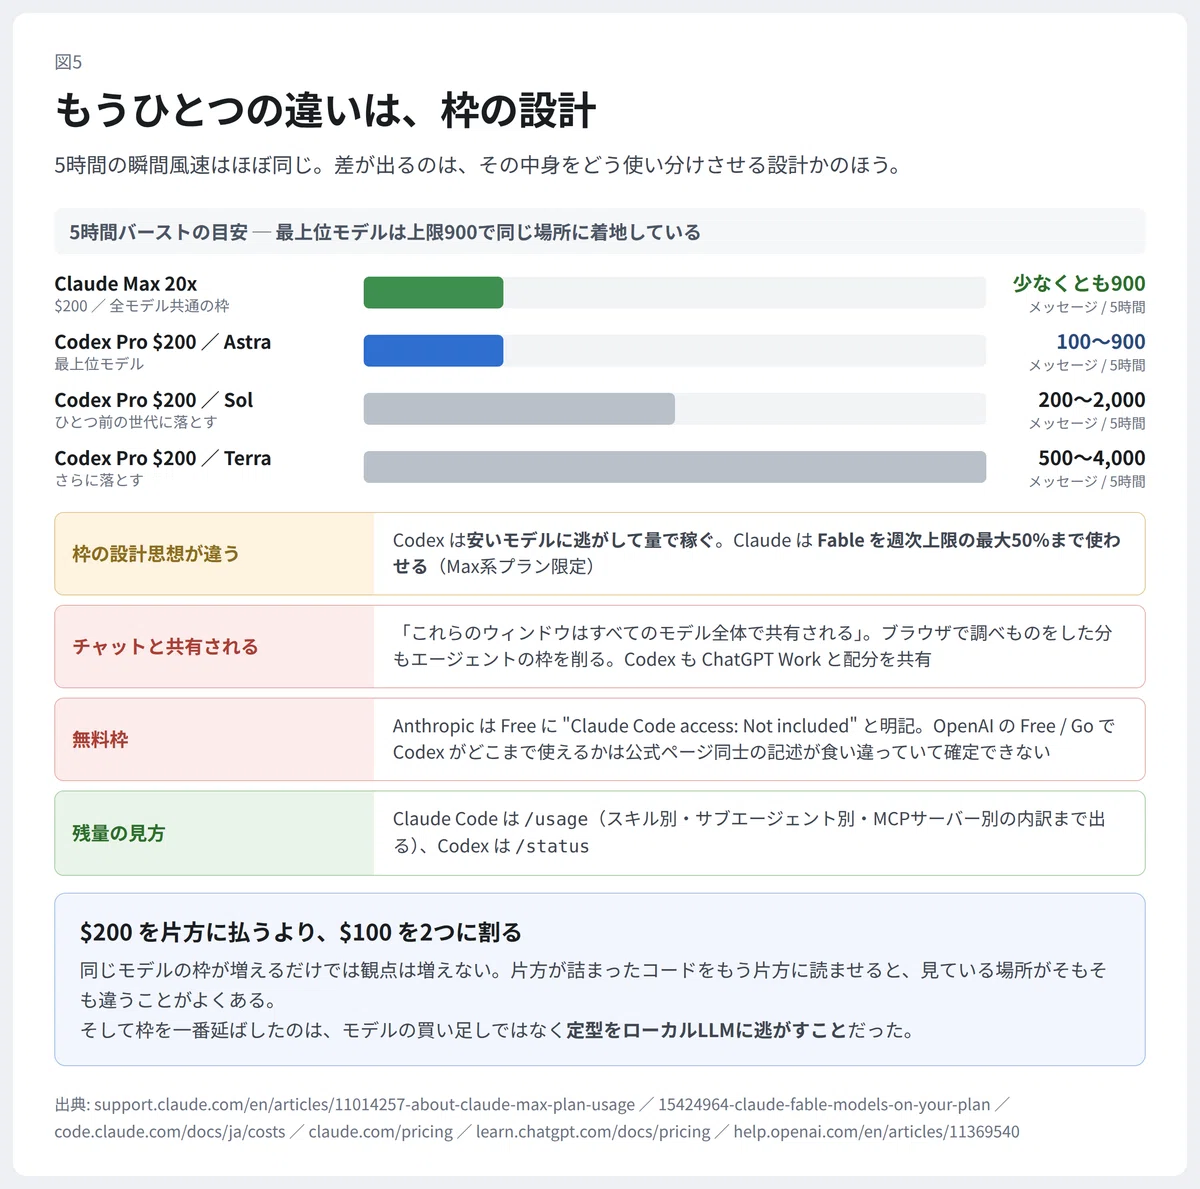
面白いのは、5時間バーストの目安が両社でほぼ一致していることだった。Claude Max 20x が5時間あたり少なくとも900メッセージ、Codex の Pro $200 で Astra を使うと5時間あたり100〜900。最上位モデルの瞬間風速は、上限900のところで同じ場所に着地している。
差が出るのは中身の使い分けのほうだ。Codex は同じ$200でも、ひとつ前の世代の GPT-5.6 Sol に落とせば200〜2,000、Terra なら500〜4,000まで伸びる。Claude側は Fable が週次上限の最大50%までという枠(Max系プラン限定)を持っていて、そこを超えると追加課金になる。安いモデルに逃がして量で稼ぐ設計と、上位モデルを枠の半分まで使わせる設計、という違いに見える。
見落としやすいのは、Claude Chat と Claude Code が同じ枠を共有していること。公式ドキュメントに「これらのウィンドウはすべてのモデル全体で共有される」と明記されている。ブラウザで調べものをした分も、そのままエージェントの枠を削っている。Codex側も ChatGPT Work と配分を共有する記載がある。
残量の確認は Claude Code が `/usage`、Codex が `/status`。前者はスキル別・サブエージェント別・MCPサーバー別の内訳まで出るので、何が枠を食っているかを見るならこちらが細かい。
なお無料枠は期待しないほうがいい。Anthropic は Free に「Claude Code access: Not included」と明記している。OpenAI の Free / Go で Codex がどこまで使えるかは、公式ページ同士の記述が食い違っていて、正直はっきりしない。
予算別に、どこへ置くか
$20なら、コーディングだけなら Claude Pro でも入口にはなる。ただし Fable を週次枠の50%まで使える扱いは Max 系プランの話なので、上位モデルを常用する前提では組めない。ChatGPT Plus は Chat も画像も付いてくるぶん入口が広い。
$100は個人開発の主戦場になる。設計と難しいデバッグに寄せるなら Claude Max 5x、量とクラウド実行に寄せるなら ChatGPT Pro の$100。自分の実感は「考える・直すは Claude、量を回す・非同期は Codex」で、これは今回の調べ直しでも覆らなかった。
$200を片方に払うのは、自分はあまり勧めない。同じモデルの枠が増えるだけで、観点は増えないからだ。同じ金額を別ラボの$100ふたつに分けるほうが、バグの見つかり方が変わる。片方が詰まったコードをもう片方に読ませると、そもそも見ている場所が違うことがよくある。
そして枠を一番延ばしたのは、モデルを買い足すことではなくローカルLLMだった。定型のリファクタ、ログの整形、コミットメッセージ、テストの雛形あたりを手元のモデルに回すと、有料枠を上位モデルの「本当に考えてほしいところ」だけに使える。claude-code-router を挟んで、難しいところだけ Fable / Astra に上げる形にしている。
中2日で前提が変わる
9月1日に Fable 5.1、9月3日に Astra。この記事を書いている間にも片方の前提が動いていた。モデルの入れ替わり自体は3〜6週に1本くらいのペースなので「週単位で変わる」は言いすぎだけれど、中2日で最上位が2本出る週はある。
だから「今どっちが強いか」で選ぶと、選んだ翌週には根拠が古くなる。逆に単価の構造と枠の設計は、そう頻繁には動かない。自分が長文を丸ごと読ませる側なのか、短いコンテキストで数を回す側なのか。チャットとエージェントの枠を分けたいのか、まとめて食い合っていいのか。そこで決めたほうが、たぶん長持ちする。
聞いてみたいのは、みなさんが同じ$100をどう置いているか。片側に寄せているのか、$100を2つに割っているのか。あと、272K超の長文割増が実際どれくらい請求に効いたかも知りたいです。自分の手元はまだ大きいリポジトリを丸ごと読ませる運用の母数が足りていないので、実測を持っている人がいたらコメントで教えてください。
#ClaudeCode #Codex #GPT6 #ClaudeFable51 #Anthropic #OpenAI #AIエージェント #生成AI #APIコスト #開発効率化 #ローカルLLM
いいなと思ったら応援しよう!
 サーバー代とコーヒー代になります☕ 役に立ったら応援よろしくお願いします!
