Fable 5.1 を出すのは、Opus 5 を xhigh / max まで上げても届かなかったときだけ

新しい最上位モデルが出たのに、公式ドキュメントの一行目が「まず Opus 5 から」だった。
Claude Fable 5.1 は2026年9月1日に公開された。同じ日の Mythos 5.1 は "offers the same capabilities to Project Glasswing participants only." で一般提供ではないから、普通に触れる新モデルは Fable 5.1 だけになる。
その Fable 5.1 について、models overview の一番上にこう書いてある。
"If you're unsure which model to use, start with Claude Opus 5 for most workloads. Use Claude Fable 5.1 for demanding reasoning and long-horizon agentic work, or when your evals on Claude Opus 5 at higher effort still fall short."
どのモデルを使うか迷ったら、ほとんどのワークロードは Opus 5 から始めろ。Fable 5.1 は要求の重い推論と長時間のエージェント作業に使うか、Opus 5 を高い effort で回しても evals が届かないときに使え、という意味になる。
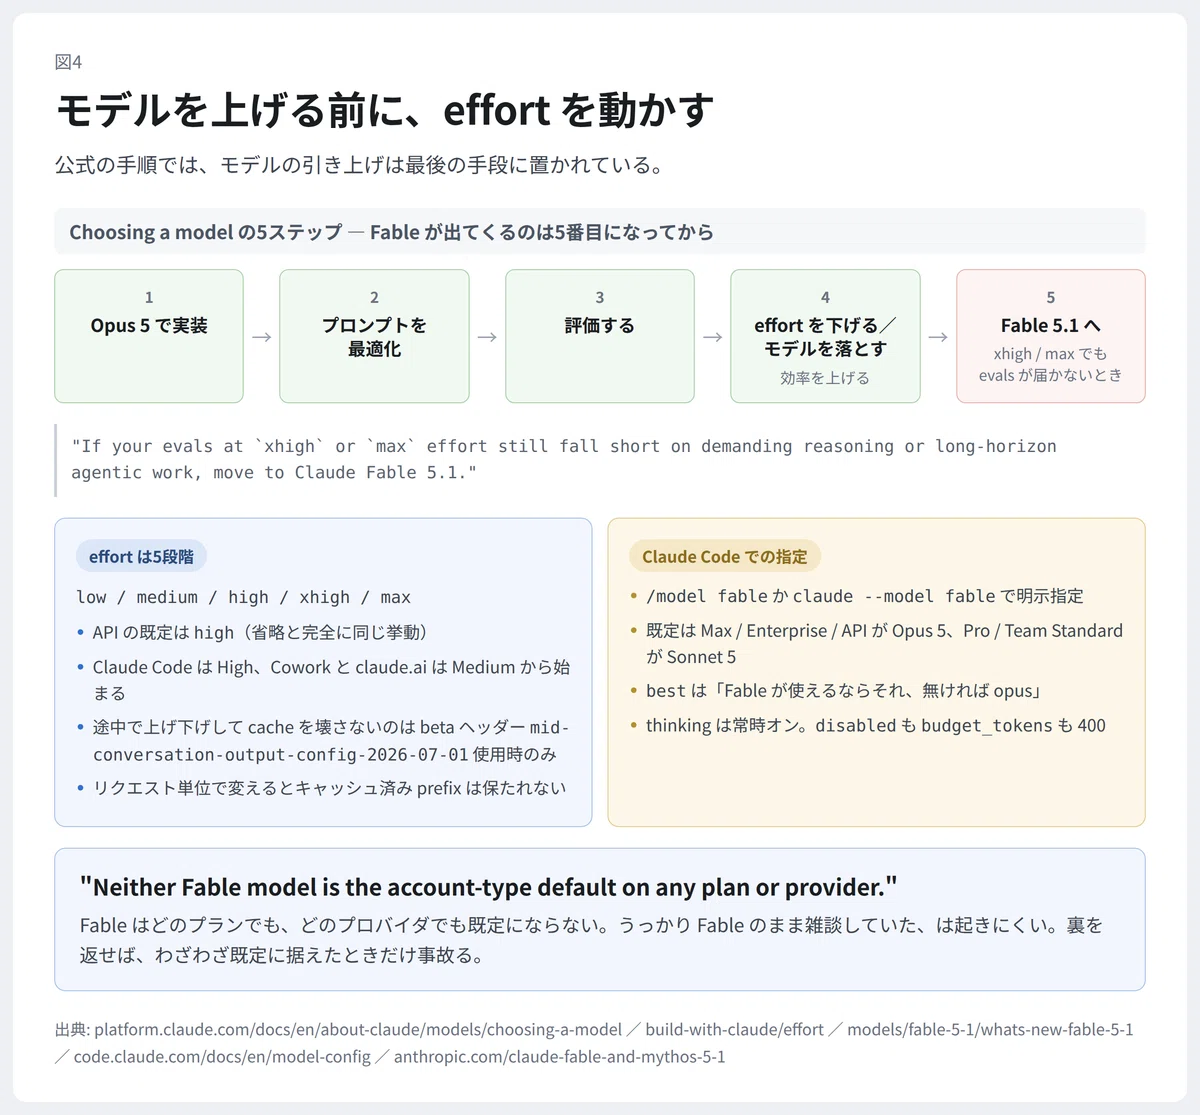
Choosing a model のページはもっと露骨だ。手順が5つに切られていて、1から4までは Opus 5 で実装し、プロンプトを最適化し、評価し、effort を下げるかモデルを落として効率を上げろ、という話が続く。Fable が出てくるのは5番目になってから。
"5. If your evals at `xhigh` or `max` effort still fall short on demanding reasoning or long-horizon agentic work, move to Claude Fable 5.1."
`xhigh` か `max` の effort で回してもまだ届かないなら、Fable 5.1 へ移れ。「重い仕事だから Fable」ではなく「Opus を上限まで上げて、それでもダメだったら Fable」。順番がひっくり返っていない。
しかもこの言い方が載っているのは発表ブログではなく開発者ドキュメントのほうだ。実装者向けの文書だけが起点を Opus 5 に置いている。この温度差が、このモデルの性格をだいたい説明していると思う。
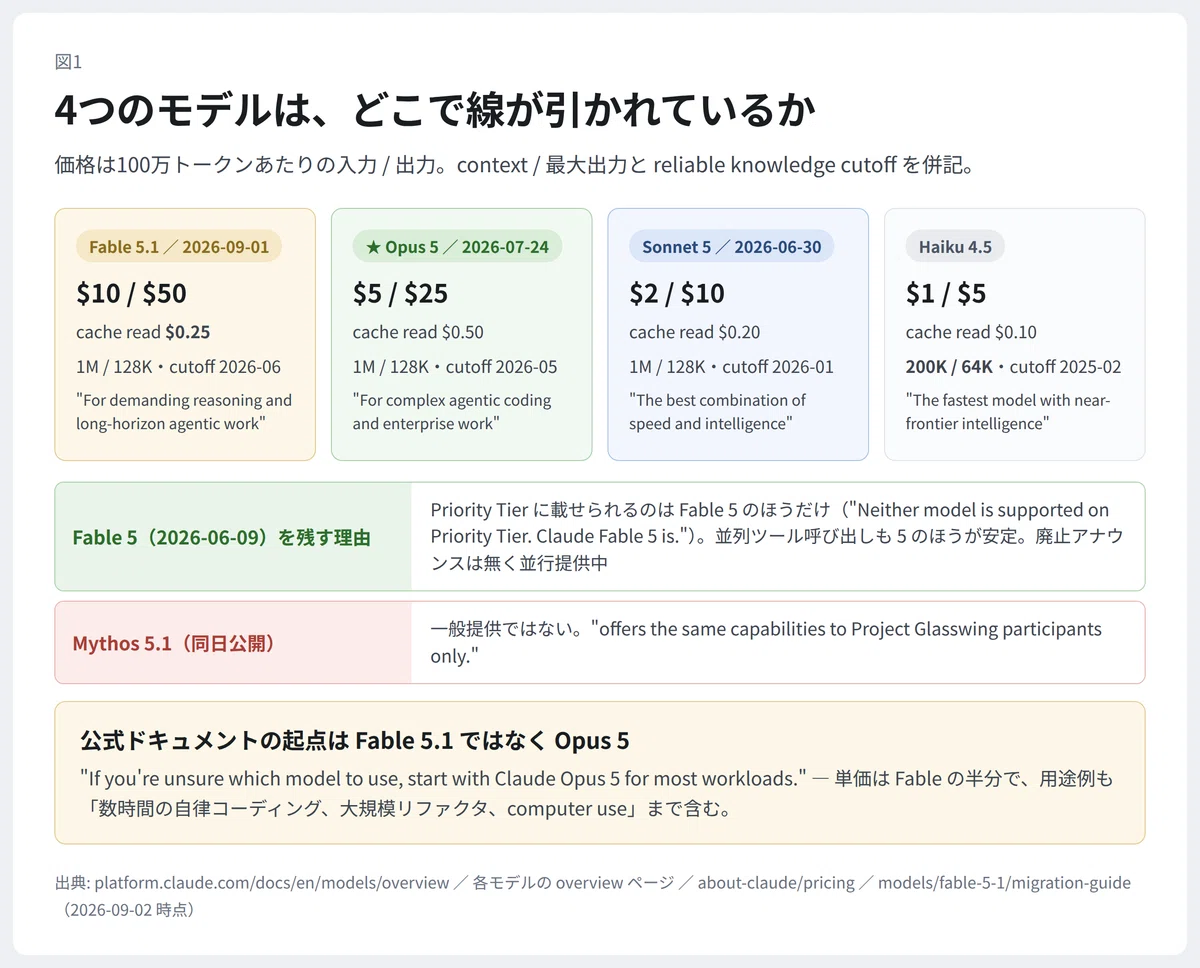
4つのモデルは、どこで線が引かれているか
まず値段。100万トークンあたりの入力/出力で、Fable 5.1 が $10 / $50、Fable 5 も同じく $10 / $50。Opus 5 が $5 / $25、Sonnet 5 が $2 / $10、Haiku 4.5 が $1 / $5。Fable は Opus の2倍、Sonnet の5倍だ。5.1 でベース単価は据え置かれた。
コンテキストは Fable 5.1 / Fable 5 / Opus 5 / Sonnet 5 がそろって1Mトークン、最大出力128K。Fable 5.1 の1Mは "default and maximum" で、窓の全域が標準単価だと明記されている。ただし Haiku 4.5 だけは 200K / 64K で別枠だ。「全部1M」と覚えると事故る。
knowledge cutoff も差が出る。Fable 5.1 が2026年6月、Opus 5 が2026年5月、Sonnet 5 と Fable 5 はどちらも2026年1月、Haiku 4.5 は2025年2月。5 から 5.1 で5か月進んだので、公式も移行理由のひとつに "an updated knowledge cutoff (June 2026)" を挙げている。
公式の1行説明を並べると役割分担が見える。Fable 5.1 は "For demanding reasoning and long-horizon agentic work"、Opus 5 は "For complex agentic coding and enterprise work"、Sonnet 5 は "The best combination of speed and intelligence"、Haiku 4.5 は "The fastest model with near-frontier intelligence"。
用途例も具体的だ。Fable 5.1 は「何時間も走るエージェントセッション、多段のディープリサーチ、分析を完成した成果物まで持っていく仕事」。対する Opus 5 は「数時間の自律コーディングエージェント、大規模リファクタ、複雑なシステムエンジニアリング、computer use」。並べて読むと、Opus 5 の守備範囲がかなり広い。
公開日も押さえておく。Fable 5.1 が2026年9月1日、Opus 5 が2026年7月24日、Sonnet 5 が2026年6月30日。Fable 5 は2026年6月9日だが、製品ページには "Announced: Jun 9, 2026" と "Rolling out: Jul 1, 2026" の2つの日付に加えて "Access to Claude Fable 5 has been restored" という記述と redeploying-fable-5 という告知ページがある。一度止まって戻ってきたらしい。事情までは追えなかったので、「6月に出てそのまま」とは書かないでおく。
キャッシュを読む値段だけが逆転している
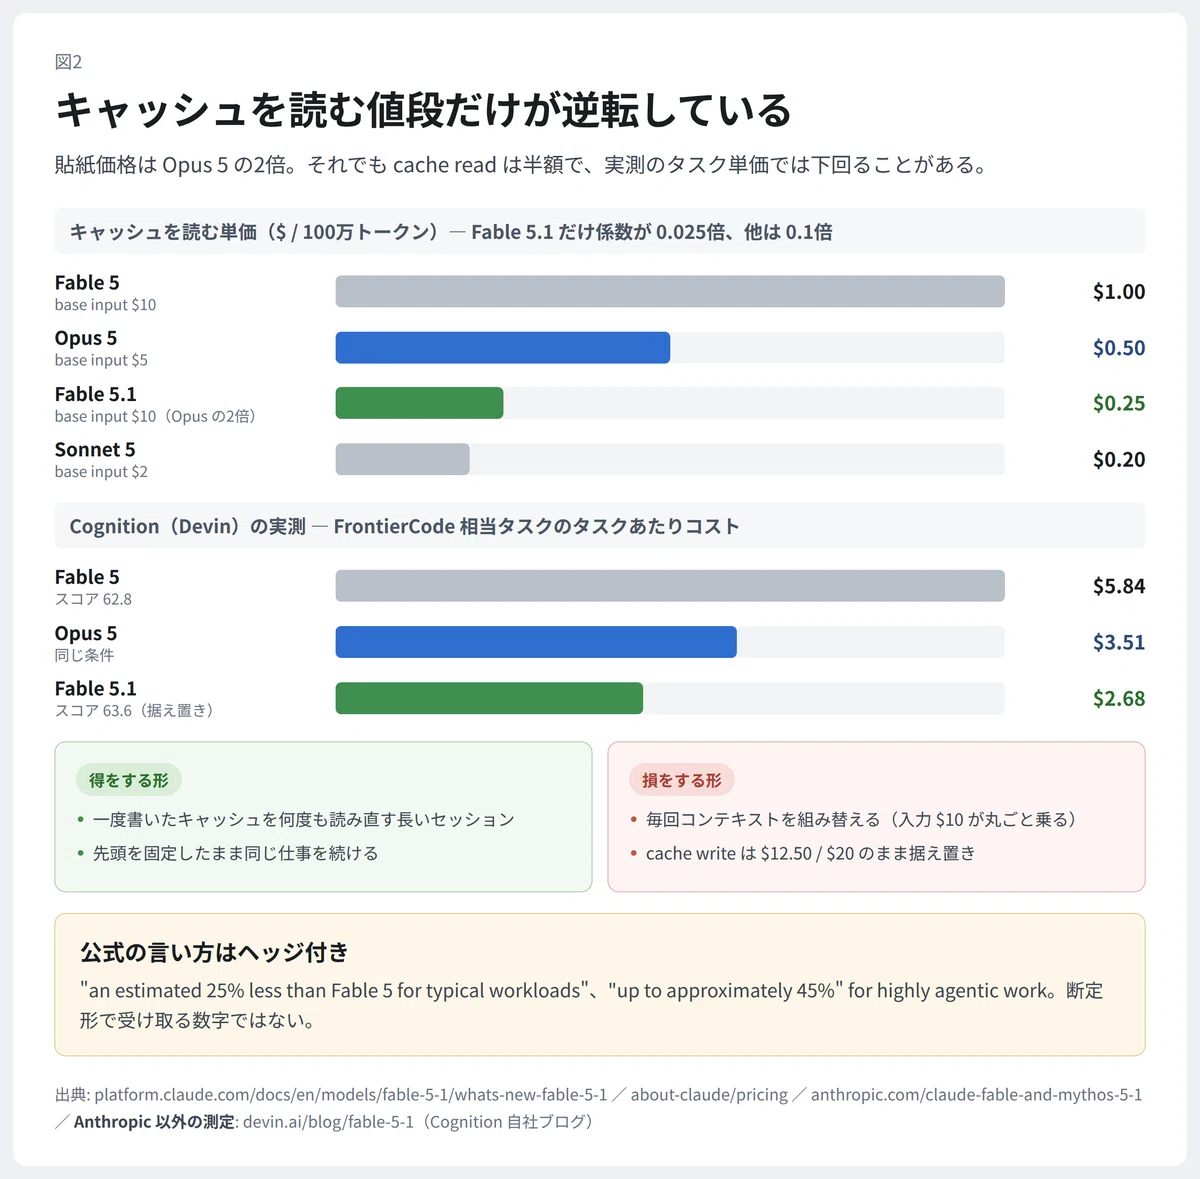
Fable 5.1 で一番効く変更は、能力ではなく cache read の単価だった。$1.00 から $0.25 へ、75%引き下げ。
数字を並べると妙なことになる。Fable 5.1 の cache read は $0.25 で、Opus 5 の $0.50 より安い。ベース単価は Opus の2倍なのに、キャッシュを読むぶんだけは半額だ。Sonnet 5 の $0.20 にすら近い。
これは値引きというより係数の例外だ。whats-new のページにこう書いてある。
"Cache reads (hits and refreshes) cost 0.025 times the base input price on these models, compared with 0.1 on other Claude models. Long agentic sessions that re-read a cached prefix pay a quarter of the Claude Fable 5 rate. Cache writes and the 512-token minimum cacheable prompt length are unchanged."
他の Claude モデルは cache read がベース入力価格の 0.1倍。Fable 5.1 と Mythos 5.1 だけが 0.025倍になっている。キャッシュした prefix を読み直し続ける長いエージェントセッションは、Fable 5 の4分の1の料金で済む。cache write と、キャッシュ可能な最小長512トークンは据え置き。
その cache write は $12.50(5分)と $20(1時間)のまま。得をするのは「一度書いたキャッシュを何度も読む」形の仕事だけで、毎回コンテキストを組み替える使い方なら入力 $10 が丸ごと乗り続ける。
エンドツーエンドではどうなるか。ここは Anthropic ではない側の実測が出ている。Cognition(Devin)が自社ブログで、FrontierCode 相当タスクのタスクあたりコストを公開した。Fable 5 が $5.84(スコア62.8)、Fable 5.1 が $2.68(スコア63.6)で約54%減。そして同じ条件の Opus 5 が $3.51。
スコアをほぼ据え置いたまま、タスク単価で Opus 5 を下回った。Cognition 側は "Fable 5.1 now costs less than Opus 5 on end-to-end tasks" と書いていて、トークン効率も Opus 5 比で33%改善したとしている。一企業の自社ベンチではあるが、貼紙価格が2倍のモデルが実測で安くなる逆転は起きうる。
Anthropic 公式の言い方はもっと慎重だ。発表ページは "Fable 5.1 will cost an estimated 25% less than Fable 5 for typical workloads"、続けて "For highly agentic work, the savings will often be much larger—up to approximately 45%." と書いている。"an estimated"、"will often be"、"up to approximately" と三重にヘッジが入る。断定形で受け取る数字ではない。
伸びたのは長い仕事だけだった
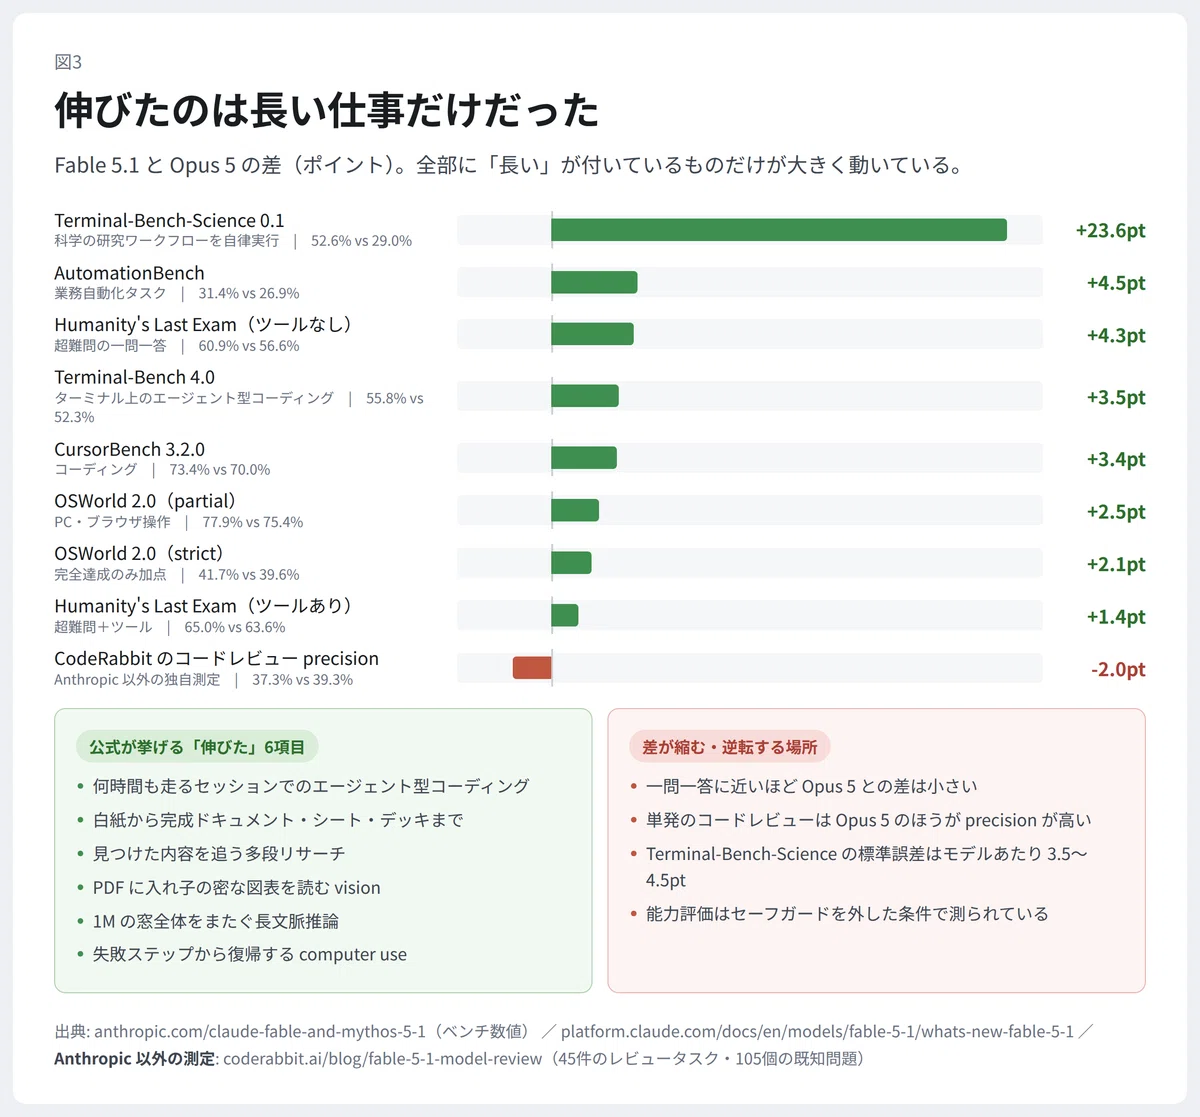
公式発表ページのベンチマークを、Fable 5.1 / Fable 5 / Opus 5 の順で並べる。
Terminal-Bench-Science 0.1 が 52.6% / 24.7% / 29.0%。ターミナル上で科学の研究ワークフローを自律実行させ、成果物を非公開テストで採点するベンチだ。Fable 5 の倍以上になっている。Terminal-Bench 4.0(ターミナル上のエージェント型コーディング)は 55.8% / 42.0% / 52.3%。参考までに Mythos 5.1 は60.9%。
業務自動化の AutomationBench は 31.4% / 17.1% / 26.9%。PC・ブラウザ操作の OSWorld 2.0 は partial が 77.9% / 72.9% / 75.4%、完全達成のみを数える strict が 41.7% / 36.1% / 39.6%。知識労働の質を測る GDPval-AA v2 が 1853 / 1723 / 1824。Humanity's Last Exam はツールなしで 60.9% / 57.8% / 56.6%、ツールありで 65.0% / 63.8% / 63.6%。CursorBench 3.2.0 は 73.4% / 70.5% / 70.0%。
読みどころは、伸び幅が揃っていないところだ。Terminal-Bench-Science と AutomationBench は大きく動いた。一方で Humanity's Last Exam はツールありだと Opus 5 と1.4ポイント差、CursorBench も3.4ポイント差しかない。一問一答に近いものほど差が縮む。
公式が「伸びた」として挙げている6項目も同じ方向を向いている。何時間も走るセッションでのエージェント型コーディング(複数ファイル改修、大規模リファクタ、移行、デバッグ、コードレビュー)。白紙から完成ドキュメント・数式入りスプレッドシート・スライドまで持っていく知識労働。見つけた内容を追う多段リサーチ。PDFに入れ子になった密な図表を読む vision。1Mの窓全体をまたぐ長文脈推論。失敗ステップから復帰する computer use。
全部に「長い」が付いている。Terminal-Bench-Science の中身も、R&D World Online が公式資料から引いたところでは科学者が作った70本のワークフローで、標準誤差はモデルあたり3.5〜4.5ポイント。誤差を考えても Fable 5 との差は本物だが、測っているのは「長時間の自律作業の成功率」だ。
測定条件も書いておく。System Card 本文には "Production safeguards were disabled for capability assessment evaluations" とあり、能力評価はセーフガードを外した条件で測られている。PDF 自体はまだ読めていないので、これ以上は踏み込まない。
正直に書いておきたい数字もある。CodeRabbit が45件のレビュータスク・105個の既知問題でコードレビューを独自に測ったところ、Fable 5.1 の precision は37.3%で、Fable 5 の32.8%から4.5ポイント上がった。ただし Opus 5 は39.3%で、Fable 5.1 より高い。CodeRabbit 自身も、37.3%は最終コメントの大部分が有用と判定されなかったことも意味する、と留保を付けている。
Snorkel AI の独自ベンチ "Terminal-Bench+" でも、Fable 5.1 の Pass@1 は61.5%で、デバッグ87%・ビルド依存管理18%とカテゴリ差が極端に出た。CodeRabbit も Snorkel も Devin も、Anthropic ではない側の測定だ。
ベンチの読み方としてはこうなる。長時間の自律作業なら Fable 5.1 が明確に上。単発のコードレビューのような仕事では、まだ Opus 5 のほうが良い。日常を Opus に置く判断は、このデータでむしろ補強される。
モデルを上げる前に、effort を動かす
公式の5ステップで、Fable への切り替えは最後の手段に置かれている。実装は Opus 5 で始め、プロンプトをそのモデル向けに最適化し、評価し、effort を下げるかモデルを落として効率を上げる。ここまでやって `xhigh` / `max` でも届かないとき、はじめて Fable 5.1 に移る。
その effort が5段階ある。`low` / `medium` / `high` / `xhigh` / `max`。API の既定は `high` で、`high` を明示するのと省略するのは完全に同じ挙動だと明記されている。
サーフェスによって既定が違う点は見落としやすい。発表ページには "Fable 5.1 defaults to High effort in Claude Code, and to Medium in Claude Cowork and on Claude.ai." とある。同じモデルでも、Claude Code は High、Cowork と claude.ai は Medium から始まる。
thinking の扱いも引っかかりやすい。Fable 5.1 は adaptive thinking が常時オンで、`thinking: {"type": "enabled"}` に `budget_tokens` を付けても `{"type": "disabled"}` を送っても400が返る。省略するか `{"type": "adaptive"}` を送るしかない。なお `adaptive` は thinking のモード名であって effort の値ではないので、`effort: "adaptive"` も通らない。
会話の途中で effort を変えられる、という話には条件が付く。beta ヘッダー `mid-conversation-output-config-2026-07-01` を付けて、メッセージ内で effort を指定する形に限り、prompt cache を壊さずに上げ下げできる。実装は `messages` に `{"role": "system", "content": [], "output_config": {"effort": "low"}}` を挟む形で、効くのは次のユーザーターンから。Fable 5.1 / Mythos 5.1 / Opus 5 が Claude API 上でサポートしている。
beta を使わず、リクエスト単位で effort を変えた場合はどうなるか。汎用の effort ドキュメントがはっきり書いている。
"Because effort shapes the rendered prompt, changing it between requests does not preserve cached prefixes from earlier turns; if you rely on prompt caching across a long session, pick an effort level at the start and keep it constant."
effort はレンダリングされるプロンプトの形を変えるので、リクエスト間で変えると以前のターンのキャッシュ済み prefix は保たれない。長いセッションで prompt caching に頼るなら、最初に effort を決めて固定しろ、という意味だ。「いつでも自由に変えられてキャッシュは無傷」ではない。beta 前提の話として扱ったほうがいい。
「Fable 5 の high 相当が 5.1 の low / medium で出る」という言い方をよく見かける。これは公式の主張ではない。出典は第三者個人(Lance Martin)のX投稿で、しかも CursorBench 3.2.0 という特定ベンチに限った観察だ。低 effort の 5.1 が、高 effort の Fable 5 と同等スコアを3分の1のコストで出した、と書かれている。あるベンチでそう出た、という確度で扱うのが正しい。
Claude Code での指定はシンプルだ。`/model` のエイリアスは `fable` が "Uses the latest Fable model for your hardest and longest-running tasks"、以下 `opus`、`sonnet`、`haiku` と続く。`opusplan` は plan mode だけ opus で実行は sonnet に落ち、`best` は Fable が使えるならそれ、使えなければ opus と同じになる。
そして重要なのがここ。
"Neither Fable model is the account-type default on any plan or provider. Select one explicitly: Fable 5.1: run `/model fable`, or launch with `claude --model fable`."
Fable はどのプランでも、どのプロバイダでも、アカウント種別の既定にならない。使うなら明示指定するしかない。既定は Max / Team Premium / Enterprise / API / Bedrock / Google Cloud が Opus 5、Pro / Team Standard が Sonnet 5 だ。「うっかり Fable のまま雑談していた」は起きにくい。裏を返せば、わざわざ既定に据えたときだけ事故る。
移行で壊れるのは、自分で messages を組んでいる人だけ
Fable 5 から乗り換えるときの破壊的変更を、公式は3つと明示している。強制ツール使用がエラーになること、以前のモデルが 5.1 の thinking block を読めないこと、過去ターンを編集すると thinking block が無効化されること。追加側は5つで、メッセージ単位の effort(beta)、cache read の値下げ、content provenance などが並ぶ。
1つめ。`tool_choice` に `{"type": "any"}` や `{"type": "tool", "name": "..."}` を指定すると400が返る。`auto`(既定)と `none` は従来どおり。理由の説明が面白い。
"Thinking is always on for these models, and a forced tool call would skip it. The model would write its working-out into the tool arguments instead, which lowers argument quality."
これらのモデルでは thinking が常時オンで、ツール呼び出しを強制するとそれを飛ばしてしまう。モデルは考えた内容をツール引数のほうに書くことになり、引数の品質が落ちる。だから禁止した、という理屈だ。回避策は `auto` のまま strict tool use を使うか、スキーマを structured outputs に移すこと。
2つめ。thinking block はどのモデルが生成したかを記録していて、保存の向きが一方通行になっている。
"Every thinking block records which model produced it, and it's preserved in one direction only: Claude Fable 5.1 reads earlier models' thinking blocks, and no earlier model reads Claude Fable 5.1's."
Fable 5.1 は以前のモデルの thinking block を読めるが、以前のモデルは Fable 5.1 のものを読めない。Opus 5 や Fable 5 から Fable 5.1 に上げた会話は推論を保つが、Fable 5.1 から下げた会話は、下げた先で走ったターンぶんの推論を失う。読めないブロックは API 側で落とされ、`input_tokens` にも計上されず課金もされない。ただし `thinking-binding-controls-2026-08-01` を付けないと、削除は黙って行われる。
上げるのはタダ、下げるのは片道ぶん損。モデルを往復させる運用は、往復ぶんだけ文脈を作り直すことになる。
3つめ。Fable 5.1 の thinking block より前にあるもの——`system` プロンプト、`tools`、それ以前のメッセージ——を書き換えると、次のリクエストでエラーになるかブロックが落ちる。効くのは過去ターンの編集・並べ替え・削除、毎回差し込んで消す注意書き、リクエスト間での `system` や `tools` の組み直しなど。逆に、先頭から古い順に thinking block を削るのは大丈夫で、`cache_control` マーカーの移動やリクエスト間の effort 変更も無効化要因にならない。
ここには緩和が2つある。ひとつは強制範囲で、このチェックが効くのは2026年8月31日以降に作られたアカウントだけ。それ以前のアカウントではAPIが不一致を記録するだけだ。もうひとつが実質的に大きい。Claude Code、claude.ai、Claude Managed Agents、Claude Agent SDK は prefix を勝手に保ってくれる、と明記されている。実害があるのは、自分で `messages` 配列を組み立てているコードだけだ。
破壊的変更ではないが挙動差も並んでいる。並列ツール呼び出しが不安定になり、Fable 5 が複数まとめて出していたところで 5.1 は1ターン1本になることがある。長いエージェントループでターンが増え、トークンと往復と実時間を食う。ただし回答品質は落ちない、と公式は書いている。
そして「Fable 5 を残す理由はほぼない」とは言えなくなった。公式に "Neither model is supported on Priority Tier. Claude Fable 5 is." とある。Priority Tier に載せられるのは Fable 5 のほうだけだ。並列ツール呼び出しの安定性も 5 のほうが上で、非推奨や廃止のアナウンスも見つからない。並行提供されている。
データ保持は30日で、Anthropic が明示的に承認しない限り zero data retention 下では使えない。プラン階層で段階開放される、という話は公式に一切書かれていない。
週次枠が溶けるのはどこか
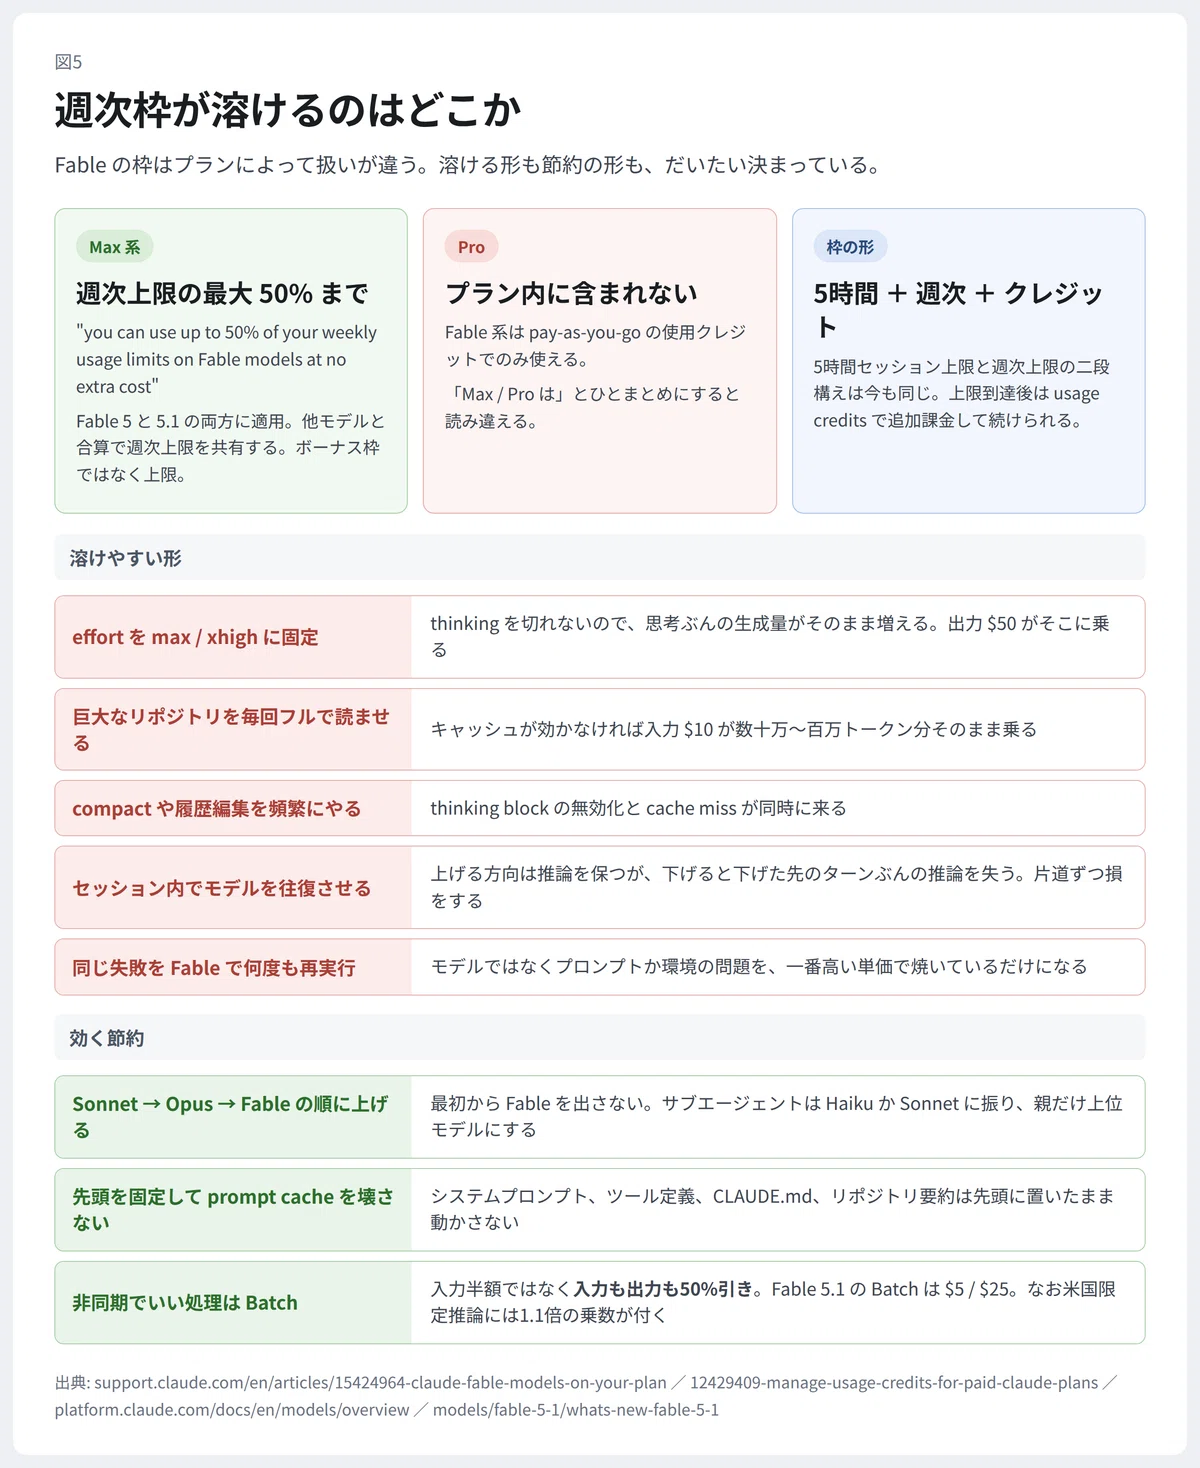
プランの使用枠は5時間セッション上限と週次上限の二段構えで、これは今も変わっていない。公式サポートも "Your session limits reset every five hours as usual." と書いている。加えて usage credits という追加課金の仕組みが入っていて、上限に到達しても追加費用で使い続けられる。
Fable の枠はここが肝心だ。公式サポートには "you can use up to 50% of your weekly usage limits on Fable models at no extra cost" とある。週次上限の最大50%までを追加費用なしで Fable に使える、という意味で、Fable 5 と 5.1 の両方に適用され、他モデルと合算で週次上限を共有する。ボーナス枠ではなく上限だ。半分を超えたら、そこから先は追加費用がかかる。
そしてこれは Max 系の話になる。Pro では Fable 系はプラン内の上限に含まれず、pay-as-you-go の使用クレジットでのみ使える。Pro で試すつもりなら、最初から従量課金だと思っておいたほうがいい。「Max / Pro は」とひとまとめにすると読み違える。
Claude Code とチャットが同じプールを食い合うかどうかは、公式の言い方が慎重だ。仕組みがウェブ・モバイル・デスクトップ・Cowork・Claude Code で同じことは明言しているが、「同一プールを共有する」とまでは書いていない。二次情報側(claudelimit.com、2026年9月1日時点)は別クォータが無く同じプールから引かれると明記していて、共有プールという説明のほうが一般的ではある。
溶けやすい形はだいたい決まっている。Fable 5.1 は thinking を切れないので、effort を `max` / `xhigh` に固定すれば思考ぶんの生成量がそのまま増える。出力側の $50 がそこに乗る。巨大なリポジトリを毎回フルで読ませてキャッシュが効かなければ、入力 $10 が数十万〜百万トークン分そのまま乗る。compact や履歴編集を頻繁にやれば thinking の無効化と cache miss が同時に来る。
そして一番もったいないのがモデルの往復だ。上げる方向は無傷なので、上げたら戻さずそのセッションを終えるほうが安い。同じ失敗を Fable で何度も再実行するのも避けたい。モデルの性能ではなくプロンプトか環境の問題を、一番高い単価で焼いているだけになる。
節約側で効くのはシンプルな話ばかりだ。Sonnet → Opus → Fable の順に上げる。システムプロンプト、ツール定義、CLAUDE.md、リポジトリ要約は先頭に固定して prompt cache を壊さない。サブエージェントは Haiku か Sonnet に振り、親だけ Opus か Fable にする。成果物の指定も「全部説明して」ではなく「差分と検証手順だけ」に絞る。出力 $50 は入力より痛い。
非同期でいい処理なら Batch がある。ここは自分も勘違いしていたので直しておくと、Batch は入力半額ではなく入力も出力も50%引きだ。公式に "Batch API requests are 50% off; prompt cache reads cost 10% of the base input price." とあり、Fable 5.1 の Batch 価格は $5 / $25 と明記されている。ついでに、米国限定推論には1.1倍の乗数が付く。
セーフガードの誤検出も減っている。サイバーセキュリティで従来比60%減、生物系は良性のリクエストに対して85%発火が減った。ただしこの生物系の改善は Fable 5.1 と Fable 5 の両方に適用されるもので、5.1 固有ではない。原文が言っているのも "benign requests" までで、医療という語は入っていない。8月6日にも Fable 5 の生物セーフガード改善という別の告知が出ていて、85%がその8月分なのか9月の新規分なのかは切り分けられなかった。
運用テンプレ
結局のところ、日々どう置くかに落とす。
普段:     Sonnet 5
実装の日: Opus 5(effort は high、詰まった箇所だけ上げる)
難問の日: そのセッションだけ /model fable
          effort は最初 medium、詰まったステップだけ上げる
終わったら: モデルを戻す
Fable を出す条件は4つに絞れる。Opus 5 を `xhigh` か `max` まで上げても同じ失敗を繰り返すとき。セッションが何時間単位になるとき(放置ラン、大規模移行、根因調査)。分析で終わりではなく、仕様書・シート・デッキまで一気に欲しいとき。長い履歴を読み続けても論理が崩れないことが要るとき。
逆に、一問一答や「この関数を直して」に Fable を出すのは損だ。ベンチを見ればわかるとおり、短い仕事では Sonnet や Opus との差が小さい。コードレビューに至っては Opus 5 のほうが precision が高い。
自分で `messages` を組んでいるなら、乗り換え時に見るのは3箇所。`tool_choice` の強制を `auto` + strict に直す。会話中にモデルを下げない。`system` と `tools` をリクエストごとに組み直していないか確かめる。Claude Code や Agent SDK 経由なら3つ目は勝手に面倒を見てもらえる。
発表ページの顧客コメントを見ると、このモデルが何のために作られたかがよくわかる。Ramp のエンジニアは38時間の無人実行で機械学習の問題を診断し、6つの実験を並列で走らせたと言っている。人間が張り付いていられない長さの仕事だ。「速く賢い」ではなく「長く走って途中で壊れない」がこのモデルの商品性なのだと思う。
Fable 5.1 は強い。ただし強さの出方は、長い仕事の成功率と、キャッシュが効いたときの実効単価という2点にしか出ない。日常のドライバーに据えて得をするモデルではないし、公式もそういう売り方をしていない。ドキュメントが「まず Opus 5 から」と書いているのを素直に守るのが、たぶん一番の節約になる。
聞いてみたいのは、みなさんが Fable 5.1 をどこで出しているか。長時間の放置ランで使っているのか、Opus 5 が詰まったときだけ切り替えているのか。あと、cache read の値下げが実際どれくらい請求に効いたかも知りたいです。自分の手元はまだ長期セッションの母数が足りていないので、月をまたいだ比較を持っている人がいたらコメントで教えてください。
#ClaudeFable51 #Claude #Anthropic #ClaudeCode #AIエージェント #LLM #生成AI #APIコスト #プロンプトキャッシュ #開発効率化
いいなと思ったら応援しよう!
 サーバー代とコーヒー代になります☕ 役に立ったら応援よろしくお願いします!
