Opus 5.5 が独立指数で5点抜けた。それでも Terminal-Bench は GPT-6 Astra と同着だった

Anthropic が9月22日に出した Claude Opus 5.5 の発表ページでは、Terminal-Bench 4.0 のスコアが66.4%になっている。同じ表の GPT-6 Astra は57.9%。8.5ポイント差で、見出しになる数字だ。
ところが Artificial Analysis(以下AA)が自前のハーネスで測り直すと、Opus 5.5 は59.6%。Astra も59.6%で、並んでしまう。
9月は旗艦モデルが立て続けに出た。1日に Claude Fable 5.1、3日に GPT-6 Astra、21日に Grok 4.7、22日に Opus 5.5。同じ22日には OpenAI も GPT-6 の下位モデル Sol と Luna を出している。TechCrunch によると、Opus 5.5 の約90分前だった。
旗艦4つを軸に、Sol と Luna も加えて、ベンダーの発表値と独立評価を混ぜずに並べ直してみた。数字は2026年9月23日時点で公開されているもので、自分の手元のハーネスで測り直したものではない。
先に結論:用途別の既定
コーディングと知識労働の既定は Opus 5.5 に置く。AAの総合指数で単独首位、単価は Fable 5.1 の4割。Anthropic 自身も "performs at the level of Claude Fable 5.1 on most work" と書いている。
長い科学ワークフロー、業務自動化、トークンを絞りたい処理なら GPT-6 Astra。AAの計測で1タスクあたりの出力が約2.7万トークンと、旗艦4モデルで飛び抜けて少ない。
安く数を回すなら、まず GPT-6 Sol。独立評価の総合指数と Terminal-Bench の両方で Grok 4.7 を上回っていて、AAの計算では1タスク$1.06で済む。要約や抽出のような軽い処理を大量に流すなら Luna だ。
Grok 4.7 は旗艦の中で一番安い。ただ、同じ価格帯の Sol に独立評価で負けているので、選ぶ理由は出力単価の安さに絞られる。
Fable 5.1 は、公開データを見るかぎり Opus 5.5 より優先する理由が見当たらなかった。これは後で詳しく書く。
6モデルの値段とコンテキスト
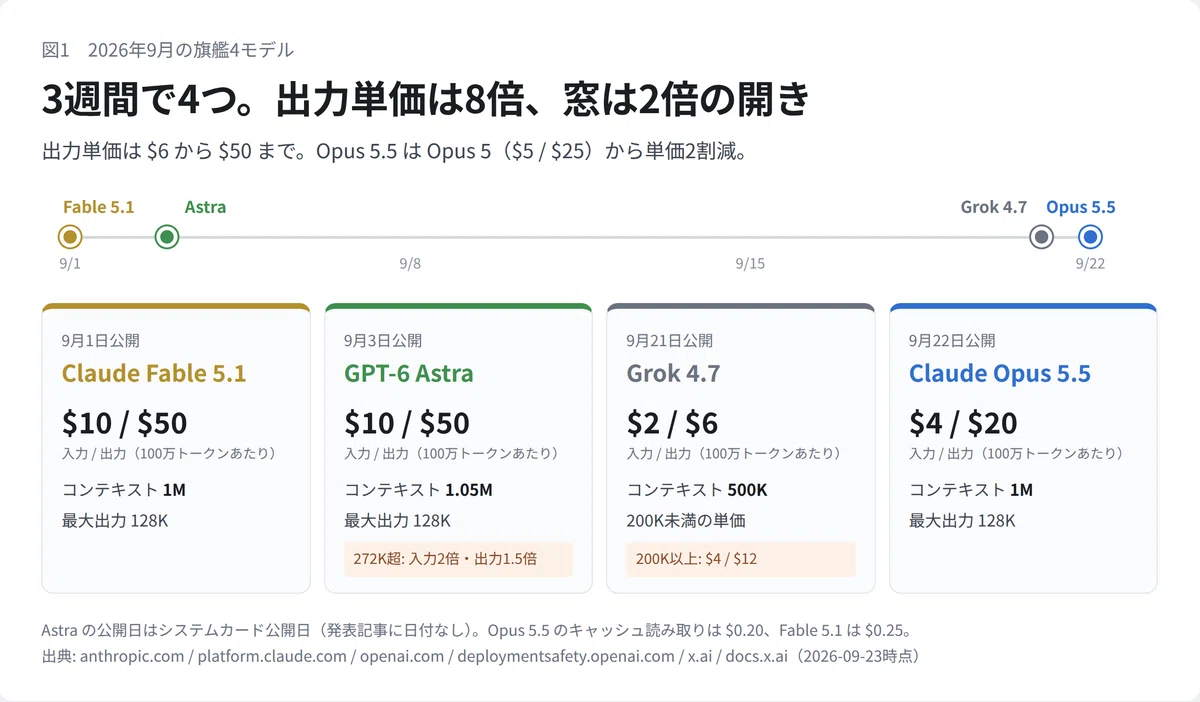
100万トークンあたりの入力/出力で並べる。上4つが旗艦、下2つが GPT-6 の下位モデルだ。
Claude Opus 5.5(9月22日):$4 / $20、コンテキスト1M、最大出力128K
GPT-6 Astra(9月3日):$10 / $50、コンテキスト1.05M、最大出力128K
Claude Fable 5.1(9月1日):$10 / $50、コンテキスト1M、最大出力128K
Grok 4.7(9月21日):$2 / $6、コンテキスト500K
GPT-6 Sol(9月22日):$2 / $10、コンテキスト1.05M、最大出力128K
GPT-6 Luna(9月22日):$0.10 / $0.50、コンテキスト1.05M、最大出力128K
Opus 5.5 は Opus 5 の $5 / $25 から単価が2割下がった。Anthropic が前に出している「40% less to run than Opus 5」は一般的なワークロードでの総コストの話で、トークン単価の値下げ幅とは別の数字になる。キャッシュ読み取りは$0.20で、Fable 5.1 の$0.25より安い。
Sol と Luna は、前世代の GPT-5.6 Sol / Luna から価格がちょうど半分になった。キャッシュ入力は Sol が$0.20、Luna が$0.01。Luna のコンテキストと最大出力は OpenAI の API ドキュメントで確認できたが、Sol のほうは公式ページを開けず、OpenRouter などの二次情報の値になる。
Astra と Grok には長文の割増がある。Astra は入力が272Kトークンを超えると入力とキャッシュが2倍、出力が1.5倍。Grok 4.7 は200K以上で $4 / $12 に上がる。1Mの窓をフルに使う前提なら、表に書かれた単価のままでは済まない。Sol と Luna に同じ割増があるかは、公式の記述を見つけられなかった。
Astra の公開日は、システムカードが出た9月3日を採った。発表記事そのものには日付がなく、"rolling out today to a limited set of organizations" とあるだけだ。
独立指数ではOpus 5.5が5点リード
AAの Intelligence Index(v4.3.2)では、Opus 5.5 が58、GPT-6 Astra と Fable 5.1 が53で並び、Grok 4.7 が46だった。
測った effort はそろっていない。Opus 5.5 と Fable 5.1 は max(with fallback)、Astra は max、Grok 4.7 は xhigh。AAは各モデルをそれぞれの最良設定で載せるので、そこは割り引いて読む必要がある。
この "with fallback" は後の話につながるので覚えておいてほしい。
Index を1タスク解くのに使った出力トークンの平均も出ている。Opus 5.5 が約11.9万、Fable 5.1 が約7.8万、Grok 4.7 が約8.1万、Astra が約2.7万。単位はAAの原文どおり「per task」だ。Astra は同じ53点を Fable 5.1 の3分の1ほどのトークンで取っている。
Sol と Luna は、AAの数字を引いた officechai の記事で確認した。どちらも max で、Sol が48、Luna が37。前世代の GPT-5.6 Sol は47、Luna は37なので、スコアはほぼ据え置きで値段だけ半分になった形だ。1タスクの出力は Sol が約3.1万、Luna が約5.1万トークンで、どちらも前世代より少し増えている。
ベンダーの表は「同じ表の中」でしか比べない
各社の発表値は、測り方も比べる相手もばらばらだ。
一番わかりやすい例が Fable 5.1 の Terminal-Bench 4.0。Anthropic と OpenAI の表では55.8%になっている。xAI の Grok 4.7 発表ページでは57.9%。同じモデルの同じベンチで、載せた会社によって2ポイント違う。
なので、ここからはベンダーごとに分けて、比べるのは各社の表の中だけにする。
Anthropic の表(Opus 5.5 の発表ページ)
Opus 5.5 / Fable 5.1 / GPT-6 Astra の順で並べる。注記がない限り Opus 5.5 は max effort で、本番の安全策を有効にしたまま測っている。
Terminal-Bench 4.0:66.4%(xhigh)/ 55.8% / 57.9%(high)
FrontierCode v1.1:54.4% / 50.3% / 53.3%
CursorBench 4.0:57.8% / 51.8% / 掲載なし
GDPval-AA v2.1:1846 / 1735 / 1542
AutomationBench:40.0% / 31.4% / 41.4%
HLE(ツールあり):67.7% / 65.6% / 57.2%
Terminal-Bench-Science 0.1:58.7% / 52.6% / 64.6%
OSWorld 2.0(partial):81.8% / 80.7% / 掲載なし
Opus 5.5 は、この表のすべての行で Fable 5.1 を上回っている。Astra が勝っているのは AutomationBench と Terminal-Bench-Science の2行だけ。
FrontierCode には本文で補足がある。medium effort の Opus 5.5 が54.6%を出していて、Astra の最高値53.3%を、タスクあたり約5分の1のコストで上回ったという。
OpenAI の表(GPT-6 Astra の発表ページ)
Astra の値は、各 effort の中で一番良いものが載っている。
Terminal-Bench 4.0:57.9%
DeepSWE v1.1:74.1%
OSWorld 2.0:72.6%
GPQA Diamond:96.0%
FrontierMath Tier 4:97.6%
HLE(ツールあり):57.2%
数学系の数字を出しているのは OpenAI だけだった。Anthropic と xAI の発表には AIME も FrontierMath も載っていないので、数学でモデルを横に並べることはできない。
OSWorld は、Anthropic の表で Opus 5.5 が81.8%、OpenAI の表で Astra が72.6%。これを見て「Opus のほうが9ポイント上」と言いたくなるが、別の会社の別の表なので比べられない。
OpenAI の表(GPT-6 Sol / Luna の発表ページ)
AutomationBench 1.0.6:Sol 33.2%(xhigh、1タスク$0.27)
DeepSWE v1.1:Sol 68.8%、Luna 66.6%(どちらも max)
OSWorld 2.0 Offline:Sol 60.5%(xhigh)
AutomationBench の同じ表には、low effort の Astra が30.3%、Opus 5 にフォールバックする設定の Fable 5.1 が31.4%で載っている。Sol はこの2つを上回ったうえで、1タスクのコストは Astra の約4分の1だという。
比較相手は Opus 5 や Fable 5 までで、同じ日に出た Opus 5.5 はこの表に入っていない。OpenAI は Terminal-Bench 4.0 の値も載せていなかった。
xAI の表(Grok 4.7 の発表ページ)
Terminal-Bench 4.0:37.6%(モデルカードでは xhigh で38.0%)
DeepSWE v1.1:71.0%(high)
CursorBench 4.0:46.3%
GDPval:1695
比較相手は Fable 5.1 と前世代の GPT-5.6 Sol で、Astra が出てくるのは GDPval の行だけだった。DeepSWE では Fable 5.1 の70.0%を上回っている。
モデルごとの得意と不得意
Opus 5.5
得意なのはコーディングと知識労働の全般だ。Anthropic の表では Terminal-Bench、FrontierCode、CursorBench、GDPval-AA、HLE で一番上にいる。AAの独立指数でも首位だった。
弱いのはトークンの使い方。AAの Index で1タスクあたり約11.9万トークンと旗艦4モデルで最も多く、thinking は常時オンで切れない。effort の既定は medium になっている。
もうひとつ知っておきたいのが、サイバー系タスクの多くが Opus 4.8 に回されること。Fable 5.1 と同じ水準の安全策を入れた結果だ。The New Stack が「エージェントの呼び出しが古いモデルに回されているかもしれない」と書いたのは、この仕組みのことになる。
GPT-6 Astra
得意なのは長い科学ワークフロー(Terminal-Bench-Science 64.6%)と業務自動化(AutomationBench 41.4%)。それと何より、出力トークンの少なさ。OpenAI 自身も「Opus 5 より出力トークンが約65%少ない」と書いている。
弱いのは HLE。ツールありで57.2%と、Anthropic の表に並ぶ他のモデルより8〜10ポイント低い。
Fable 5.1
長考や HLE なら Fable、というのが9月頭までの感覚だった。ところが Anthropic 自身の表で、HLE は Opus 5.5 のほうが高い(67.7% 対 65.6%)。そもそも表の全行で Opus 5.5 が上だった。
AAの Index では Astra と同点の53だが、AAの計算ではタスクあたり$7.63かかっていて、Astra の$3.26の2倍以上になる。公開されている数字の範囲では、Fable 5.1 をあえて選ぶ根拠を自分は見つけられなかった。Fable 5.1 前提で組み上げたパイプラインを、急いで動かす理由がないくらいだと思う。
Grok 4.7
得意なのは値段。$2 / $6 は Opus 5.5 の約半分から3分の1、Astra の5分の1以下だ。DeepSWE は71.0%で、xAI の表では Fable 5.1 を上回っている。
弱いのは Terminal-Bench。xAI の発表値で38%前後、AAの独立計測だと26%まで落ちる。xAI 自身は「longer-running coding tasks」に強いと言っているが、ターミナルを自律で回す種類の長さには、少なくとも今の数字は届いていない。
もうひとつ痛いのが、翌日に出た GPT-6 Sol との比較だ。入力単価は同じ$2で、出力は Grok が$6、Sol が$10。それでいてAAの Index は Sol 48 対 Grok 46、Terminal-Bench は Sol 44% 対 Grok 26%。出力単価の差をどこまで重く見るかで判断が分かれるが、自分なら先に Sol を試す。
GPT-6 Sol / Luna
Sol は OpenAI の説明だと複雑なコーディングや技術的な作業向け、GitHub の説明だと「対話型とエージェント型のコーディングのためのバランス型」。旗艦ではないが、AAの Index で Astra との差は5点、単価は5分の1だ。
Luna は要約や文書からの抽出のような大量の事務処理向けで、ChatGPT の Free プランでも使える。effort は none から max の6段階で、既定は medium。AAの Terminal-Bench は13%なので、ターミナル作業を任せるモデルではない。
貼紙価格と1タスクのコストは別物
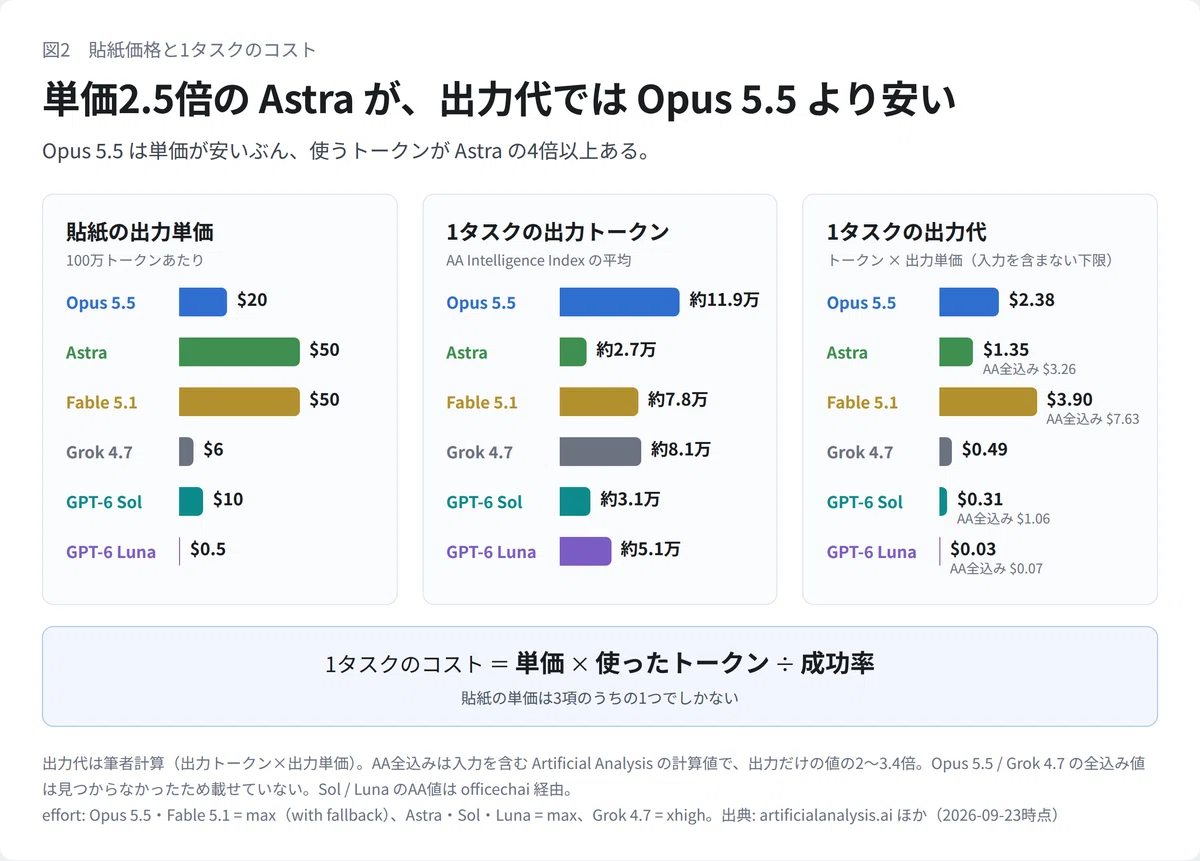
Opus 5.5 の出力単価は Astra の5分の2。それでも1タスクあたりの出力代は Opus 5.5 のほうが高くなる。
AAの Index で使った出力トークンに出力単価を掛けると、こうなる。入力分を含まない、出力だけの下限の目安だ。
Opus 5.5:11.9万 × $20 = 約$2.38
Fable 5.1:7.8万 × $50 = 約$3.90
GPT-6 Astra:2.7万 × $50 = 約$1.35
Grok 4.7:8.1万 × $6 = 約$0.49
GPT-6 Sol:3.1万 × $10 = 約$0.31
GPT-6 Luna:5.1万 × $0.50 = 約$0.03
単価が2.5倍の Astra のほうが、出力代では安い。使うトークンが Opus 5.5 の4分の1以下なので、単価の差がひっくり返る。
実際のコストはこれより上がる。AAが入力まで含めて計算した値は Astra が$3.26、Fable 5.1 が$7.63、Sol が$1.06、Luna が$0.07。出力だけで出した数字の2〜3.4倍だった。Opus 5.5 と Grok 4.7 の全込みコストはAAの記事では見つからなかったので、ここでは推計しないでおく。
Sol の$1.06は Astra の3分の1で、点数は53に対して48。この差をどう見るかが、6モデルの中で一番おもしろいところだと思う。
1タスクのコストは「単価 × 使ったトークン ÷ 成功率」で決まる。貼紙の単価はそのうちの1項でしかない。
Terminal-Benchは測る人で数字が変わる
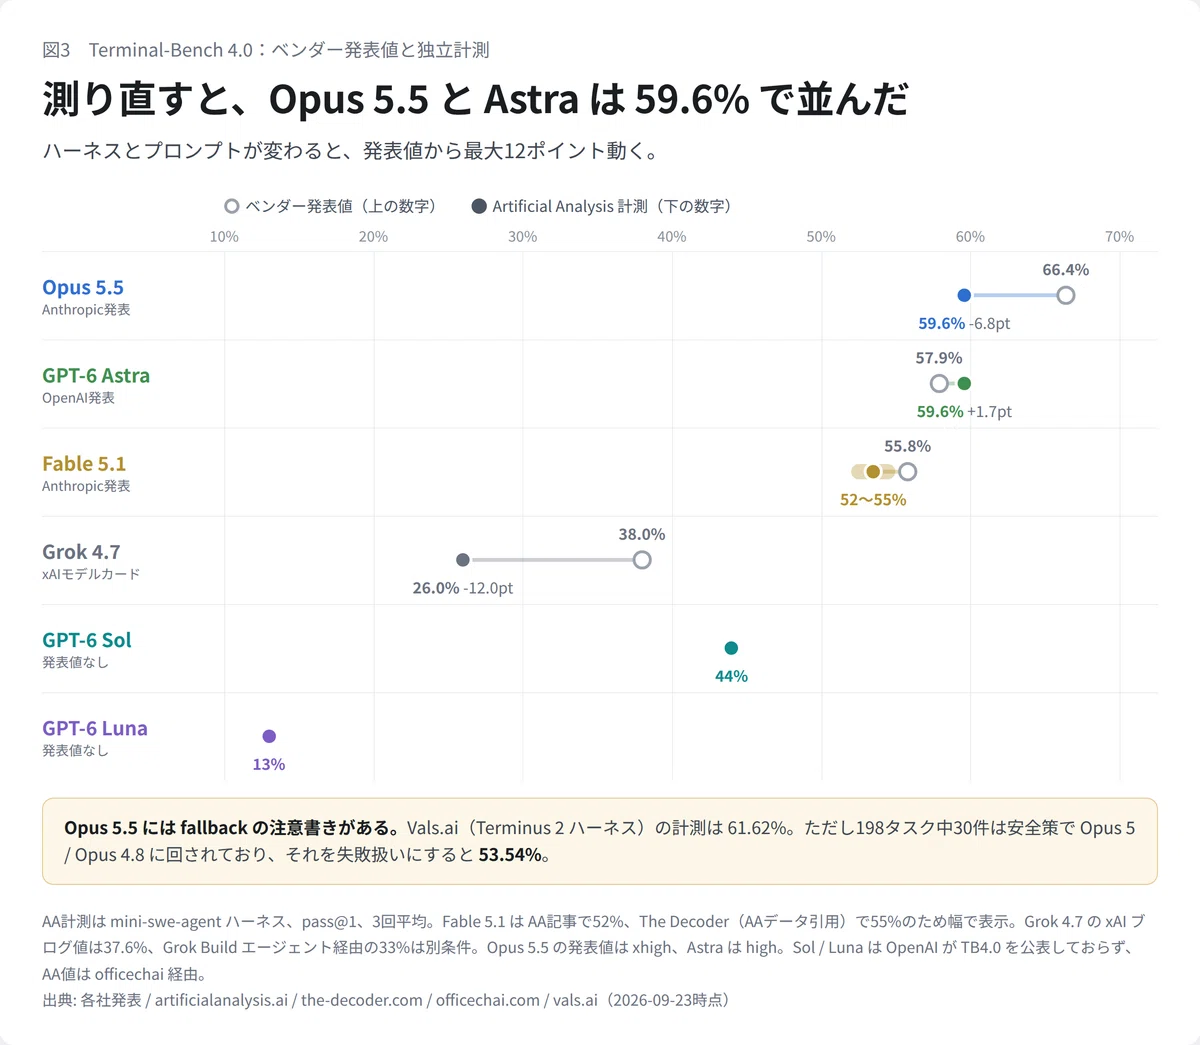
冒頭の話に戻る。Terminal-Bench 4.0 を、発表値と独立計測で並べてみる。
Opus 5.5:Anthropic発表 66.4% → AA計測 59.6%
GPT-6 Astra:OpenAI発表 57.9% → AA計測 59.6%
Fable 5.1:Anthropic発表 55.8% → AA計測 52〜55%
Grok 4.7:xAI発表 37.6〜38.0% → AA計測 26%
GPT-6 Sol:発表値なし → AA計測 44%
GPT-6 Luna:発表値なし → AA計測 13%
AAの計測は mini-swe-agent というハーネスでの pass@1、3回平均。Fable 5.1 はAA自身の記事で52%、AAのデータを引いた The Decoder の記事では55%となっていて、幅で書いておく。Sol と Luna は officechai 経由の数字で、前世代からそれぞれ40%→44%、12%→13%だった。
発表値から一番落ちたのが Opus 5.5 の6.8ポイントと、Grok 4.7 の約12ポイント。Astra は逆に独立計測のほうが高かった。ベンダーは自社モデルに合ったハーネスとプロンプトで測るので、発表値がそのまま横に並ぶわけではない。
Vals.ai も別のハーネス(Terminus 2)で測っている。9月21日更新の数字で Opus 5.5 が61.62%、Astra が57.07%、Fable 5.1 が49.49%。Grok 4.7 はまだ載っていない。
ここで効いてくるのが fallback だ。Vals.ai の注記によると、Opus 5.5 は198タスクのうち30件が安全策で Opus 5 や Opus 4.8 に回されていた。その30件を失敗扱いにすると53.54%まで下がる。
AAの Index で Opus 5.5 に "with fallback" と付いていたのも同じ事情だ。スコアの一部は Opus 5.5 以外のモデルが出している可能性がある。セキュリティ寄りのタスクを多く回す人ほど、この差は大きく効くと思う。
Grok 4.7 にはもうひとつ、AAの記事で xAI 自社の Grok Build エージェント経由だと33%という数字も出ている。26%とは別の条件なので、混ぜないようにしたい。
自分ならこう置く
普段の実装とドキュメント作業は Opus 5.5 にする。effort は既定の medium から始めて、詰まったステップだけ上げる。FrontierCode の medium で Astra の最高値を超えている以上、最初から max にする理由は薄い。
トークン量が請求に直結するバッチ処理や、科学系の長いワークフローは Astra に回す。272Kを超える入力は割増になるので、コンテキストは詰め込みすぎないほうがいい。
Claude Code や Codex のサブエージェントのように、単発の実装をたくさん投げる役は Sol に任せたい。Terminal-Bench 44%はまだ親エージェントを任せる水準ではないが、この価格帯では一番高い。ログの要約やファイルからの抽出のような下働きは Luna で足りると思う。
Grok 4.7 は、出力単価の安さが効く使い方で Sol と比べてから決める。Fable 5.1 は、Opus 5.5 で同じ失敗が続いたときの比較用に残しておく程度にする。
最後に。今回の数字はどれも他人の計測で、自分の案件でどうなるかは別の話だ。次は手元の Claude Code と Codex の案件を1本、同じプロンプトで6モデルに流してログを取るつもり。
みなさんはもう Opus 5.5 に切り替えましたか。サイバー系のタスクで Opus 4.8 に回された、という体験があればぜひ知りたいです。Sol と Grok 4.7 を同じ仕事で比べた人がいたら、どっちが残ったかもコメントで教えてもらえるとうれしい。
※ベンチマークの数値は2026年9月23日時点の公開情報です。各社の表と独立評価は、測定条件がそろっていません。
#ClaudeOpus55 #GPT6Astra #GPT6Sol #ClaudeFable51 #Grok47 #Anthropic #OpenAI #xAI #LLM比較 #ArtificialAnalysis #TerminalBench #生成AI #AIエージェント
いいなと思ったら応援しよう!
 サーバー代とコーヒー代になります☕ 役に立ったら応援よろしくお願いします!
この記事は noteマネー にピックアップされました

