長く走れるAgentほど、先に止める場所を書く

Claude Fable 5.1 で私が先に見たいのは、賢さより「止める設計」です。
最近、個人用の小さな管理画面を直しています。
小さな修正のつもりでも、AI Agent に任せると、ファイルを読んで、直して、動かして、また直すところまで進みます。
長く止まらずに走れるなら、こちらはどこで止める設計を置くのか。
今回の話は、モデル紹介で終わらせにくい
Anthropic は 2026年8月31日、Claude Fable 5.1 と Claude Mythos 5.1 を発表しました。
Fable 5.1 は、長時間の Agent coding、複雑な知識作業、研究用途を強く意識したモデルとして説明されています。公開情報では、Terminal-Bench-Science や Terminal-Bench 4.0、CursorBench などの数字も並んでいます。
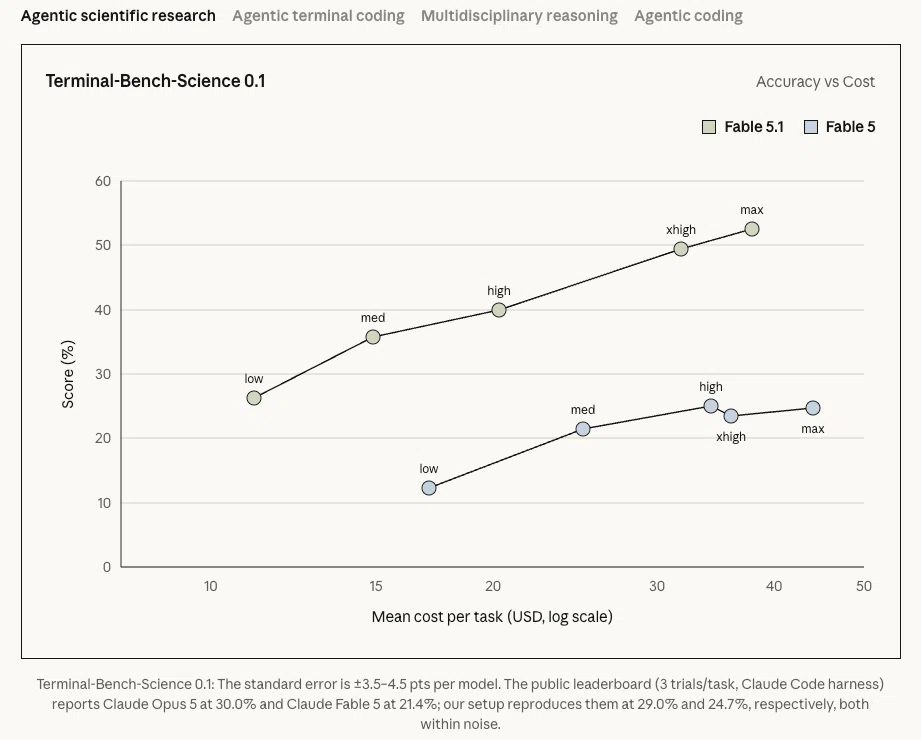
¥もちろん、数字も確認します。
でも、自分の repo に入れる前に確認したいのは、ベンチマーク表の一番上ではありません。
先に見たいのは、次の3つです。
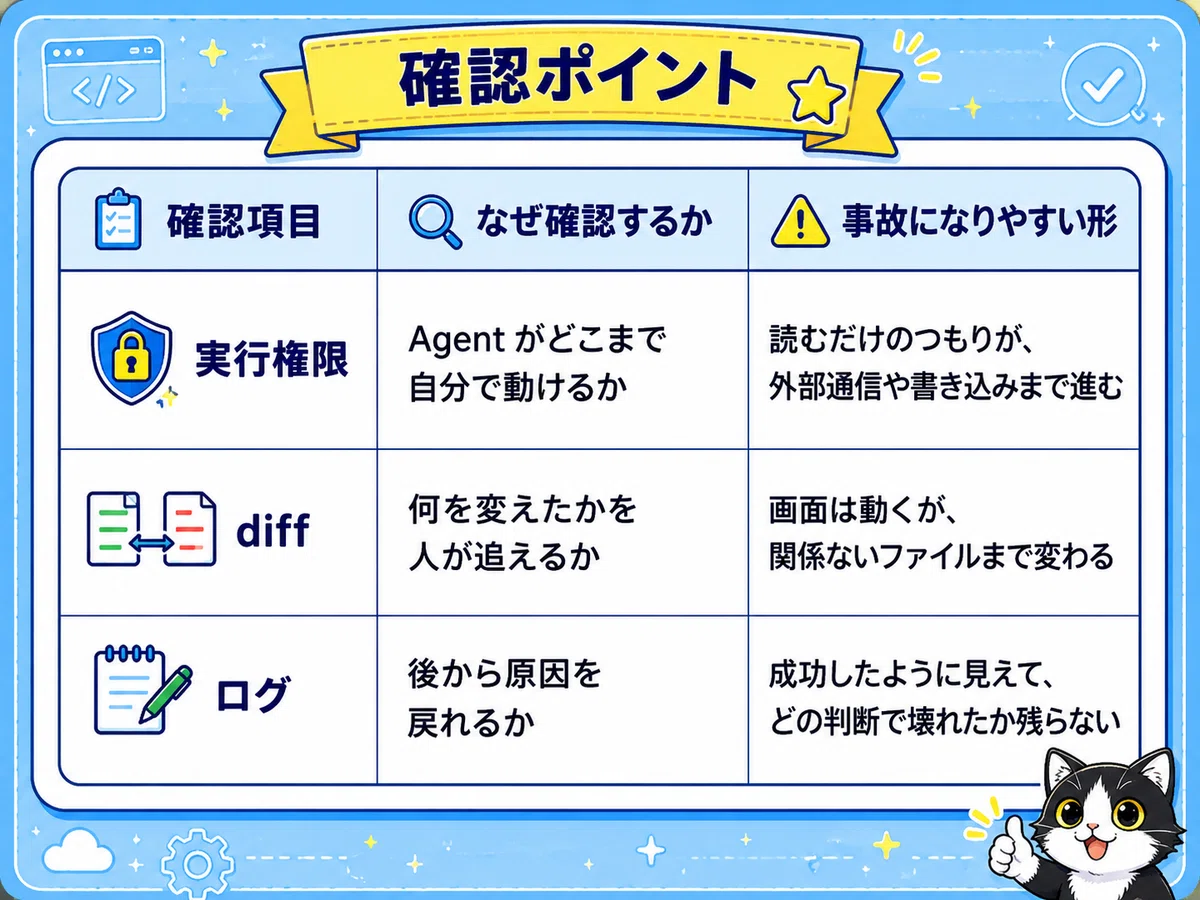
Fable 5.1 が強いほど、この確認表の重みは減りません。むしろ重くなります。
キャッシュが安くなっても、油断していい理由にはならない
今回、分かりやすい変更は価格です。
Anthropic は Fable 5.1 について、入力と出力の価格は Fable 5 と同じまま、API のキャッシュ読み取り価格を 75% 下げたと説明しています。長い Agent 作業では、同じ文脈を何度も読むので、この変更は効きます。
今回読んだ測定メモでも、通常タスクでは約25%、重い Agent 作業では最大45%ほど安くなる、という見立てが出ていました。
ただ、ここで少し引っかかりました。
キャッシュが安くなると、長い作業を走らせやすくなります。長い作業を走らせやすくなると、「止める理由」が見えにくくなります。
高いモデルなら、人は途中で費用を気にします。
少し安くなると、もう一手、もう一巡、もう一回だけ修正、となりやすい。
AI coding のコストは、token の料金だけではありません。あとから diff を読む時間、壊れた原因を探す時間、戻すための時間も入ります。
ここを忘れると、キャッシュの値下げは開発体験の改善ではなく、長い事故を安く回してしまう入口にもなります。
「すごいデモ」より、実運用に近い部分を分けたい
今回読んだ測定メモでは、Fable 5.1 で少し重めの開発タスクを3つ試しています。
3D Web アクションゲーム、Cursor 風の全スタック AI coding tool、AI 動画編集ツール。
結果だけ読むと、かなり強いです。ゲームでは戦闘システムやスキルまで作り、AI coding tool では editor、terminal、Agent window、変更承認に近い画面まで出しています。動画編集ツールでも timeline、素材パネル、書き出し、字幕やハイライトの UI まで出ています。
ただ、私はここで「全部できた」とは書きたくありません。
動画編集の AI 字幕やハイライトは、ASR がないため模擬データでした。3D ゲームにも音や当たり判定、地形へのめり込みの問題が残っています。
これはモデルを低く見たい話ではありません。Agent 作業の成果物を読むときの基本です。
見た目ができていること。
業務で使えるところまで処理が閉じていること。
この2つは違います。
私なら、長時間動くAgentの前にこう置く
もし Fable 5.1 のような長く走れるモデルを自分の開発環境に入れるなら、最初にプロンプトを凝るより、実行までの経路を分けます。
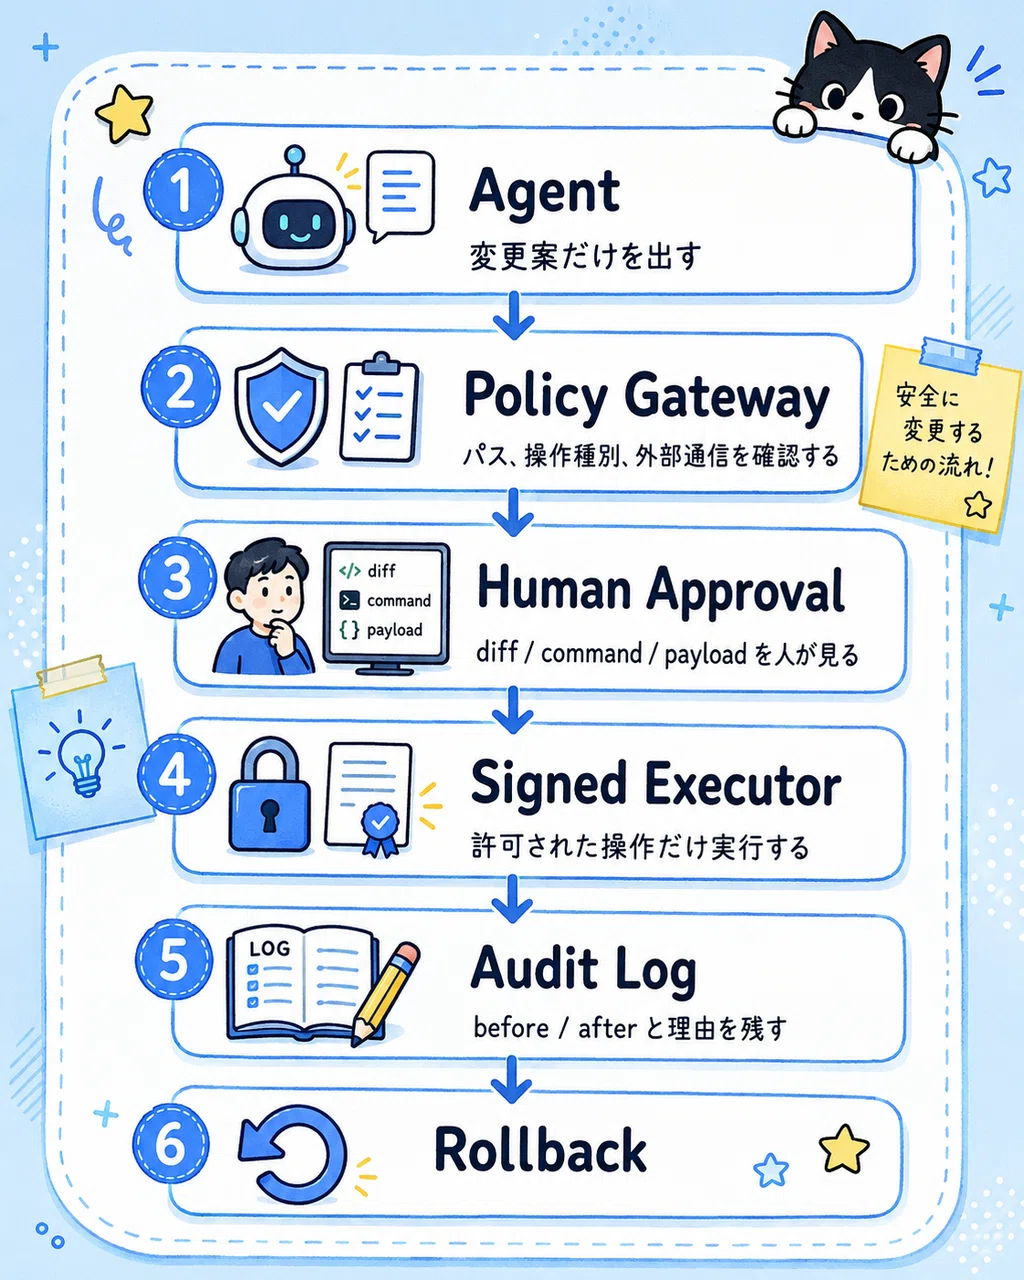
大事なのは、Agent を信用しないことではありません。
信用する場所を分けることです。
たとえば、読み取りは広めに許可しても、書き込みは対象ディレクトリを絞ります。外部通信は、調査用の sandbox だけにします。production の secret が見える場所では、Agent に自由な terminal を渡しません。
私なら、最低でもこのくらいは分けておきます。
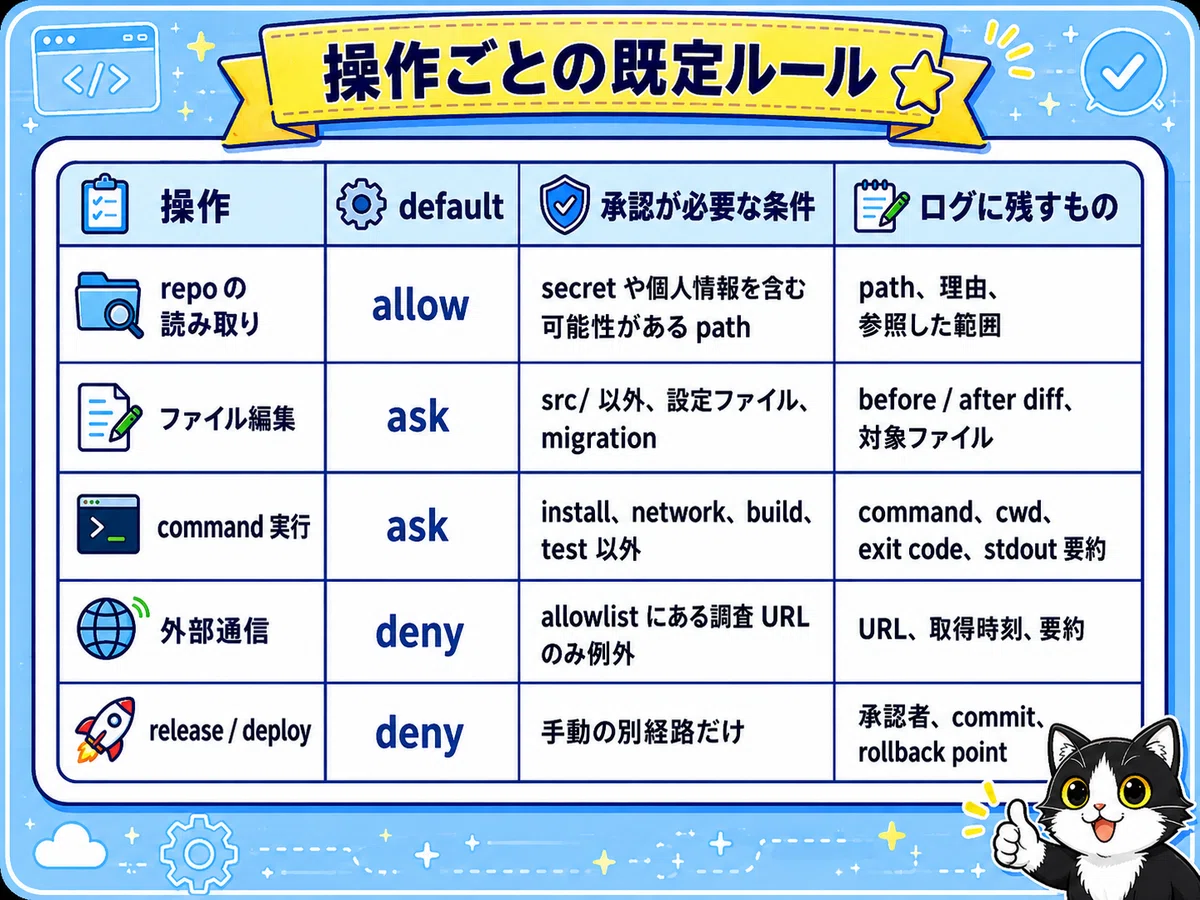
この表がない状態で「高性能モデルだから大丈夫」と言うのは、かなり怖いです。
system prompt が漏れても、境界にはならない
もうひとつ話題になっていたのが、Fable 5.1 の system prompt が GitHub に出回ったという件でした。
ここは慎重に扱いたいところです。
まず、本物かどうかは別に確認が必要です。さらに、仮に本物に近い内容だったとしても、それだけで「安全性の中身が分かった」とは言えません。
system prompt は、モデルにとって大事な指示です。
でも、開発環境の安全境界そのものにはなりません。
Agent に「危ないことをしないで」と書いても、ツールが危ない操作を実行できるなら、最後に止めるのはプロンプトではなく権限です。外部から読んだ内容に prompt injection が混ざっていても、gateway 側で command や URL を確認できれば、そこで被害を小さくできます。
だから私は、prompt leak の話を面白がるより、手元の repo で次を確認します。
AI が読めるファイルはどこまでか
書き込める path はどこか
network request は誰が許可するか
実行した command は後から追えるか
失敗したとき、どの commit に戻すか
ここが曖昧なままなら、system prompt を読んでも安心材料にはなりません。
高いモデルを使う場所は、作業の長さではなく失敗コストで決める
今回読んだ測定メモでは、3つの大型タスクで合計470人民元近いコストがかかったとされています。
この数字だけを見ると、かなり高いです。
ただ、私は「高いから使わない」とは思いません。逆に「強いから全部に使う」とも思いません。
使う場所は、作業の長さより失敗コストで決めます。
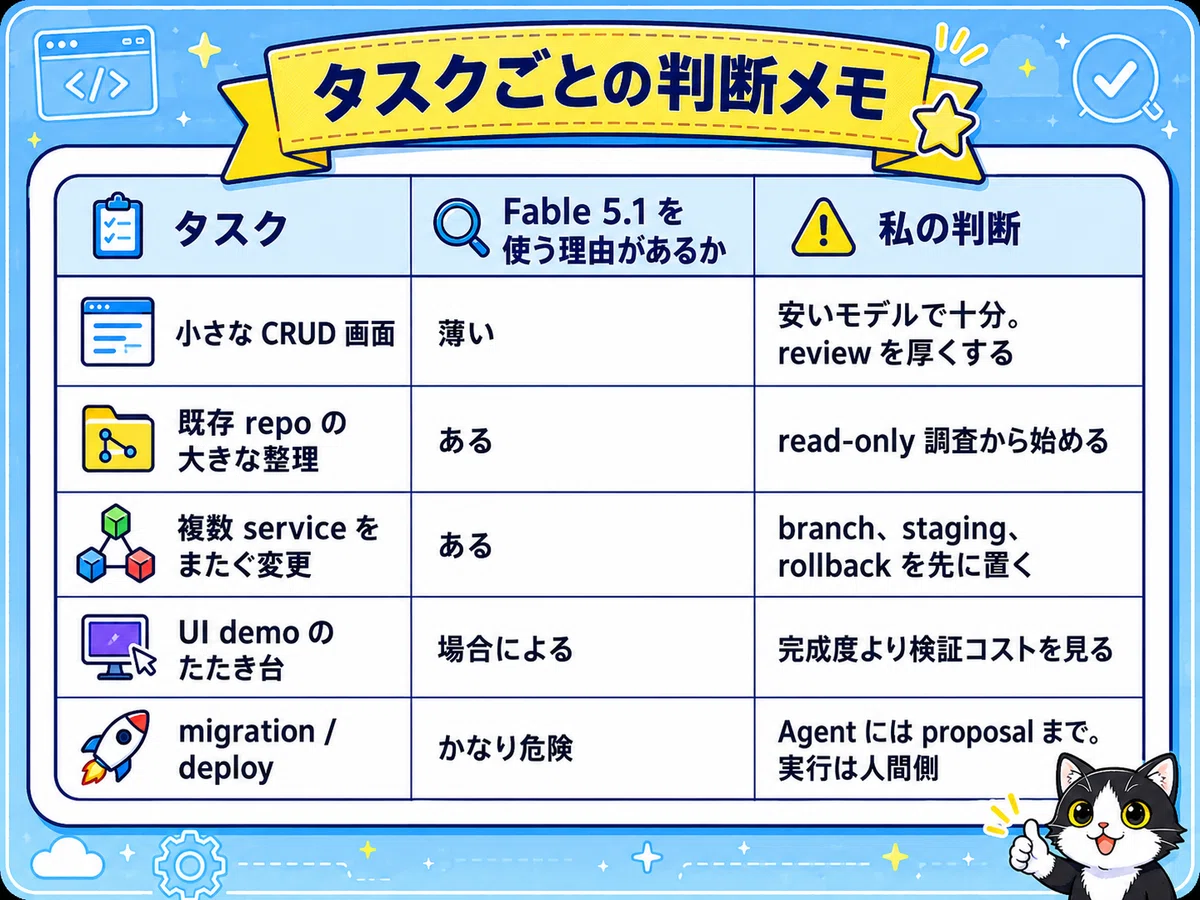
長く走れるモデルは、作業を前へ進める力が強いです。
でも、進める力が強いほど、戻す設計も先に必要になります。
まとめ
Fable 5.1 の発表で確認したいのは、「一番強いモデルが出た」という部分だけではありません。
キャッシュが安くなり、長い Agent coding が走らせやすくなる。ベンチマークも強い。デモも派手です。
だからこそ、自分の repo に入れる前に、権限、diff、ログ、rollback を書いておきたい。
AI Agent が長く走れるようになるほど、人間の仕事は減る部分もあります。けれど、最後に読む diff と、最後に押す承認ボタンは消えません。
私はそこを、まだ AI に渡しきれません。
参考
#ClaudeFable51 #Claude #AIコーディング #AIエージェント #開発メモ #TypeScript
