Grok 4.7 がリリース!使いどころは?いちはやく特長をつかみ要点を解説

更新日:2026/9/22
SpaceXAI(xAI)は2026年9月21日、文章を読み、回答を作るAIモデル「Grok 4.7」を公開しました。ソフトウェアを作るコーディングや、資料を読んで文書にまとめる知識作業に向けたモデルで、前世代のGrok 4.6から40日での更新です。⟦S2⟧
複数の作業を続けて進める力を高め、アプリやプログラムからAIを呼び出す「API」の通常単価は据え置いています。APIの料金は、文章の処理量を表す「トークン」で計算します。チャットサービスの月額料金とは別で、トークン数も文字数とは一致しません。⟦S1⟧ ⟦S5⟧
一方、外部評価ではトークン消費量の増加も報告されています。単価の安さが、仕事を終えるまでの費用にも表れるかが気になるところです。⟦S7⟧
Claude Fable 5.1やGPT-5.6 Solと比べて、どんな仕事に向いているのでしょうか。公式資料と評価機関の公開結果を読みながら、性能、料金、利用方法を見ていきます。
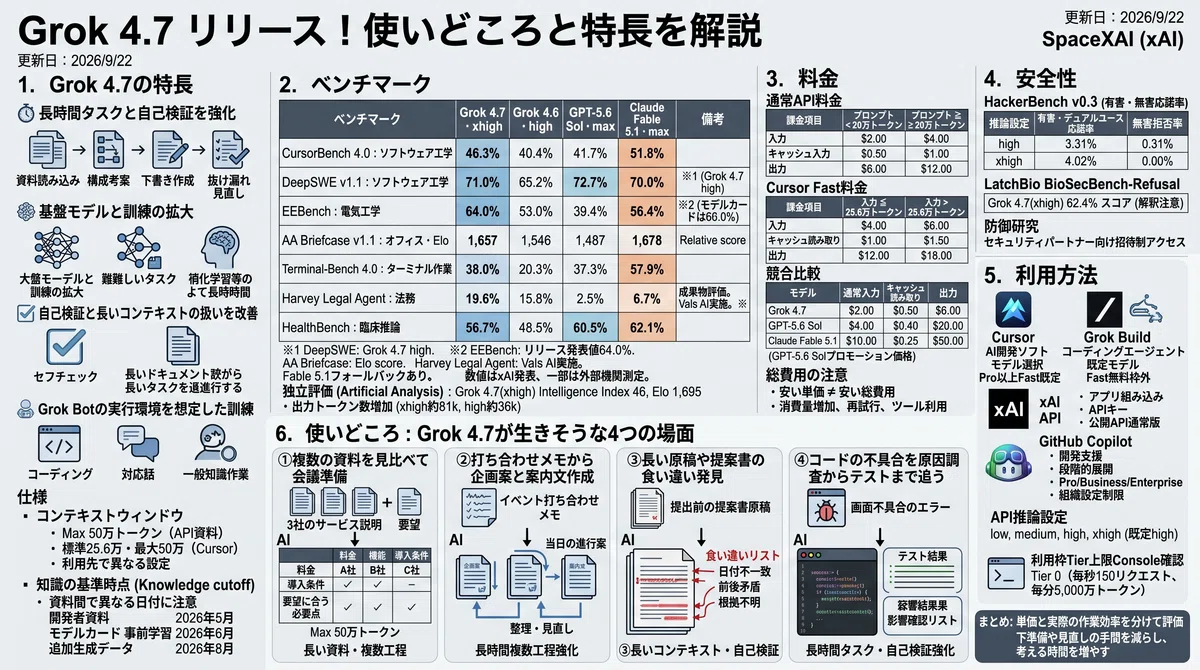
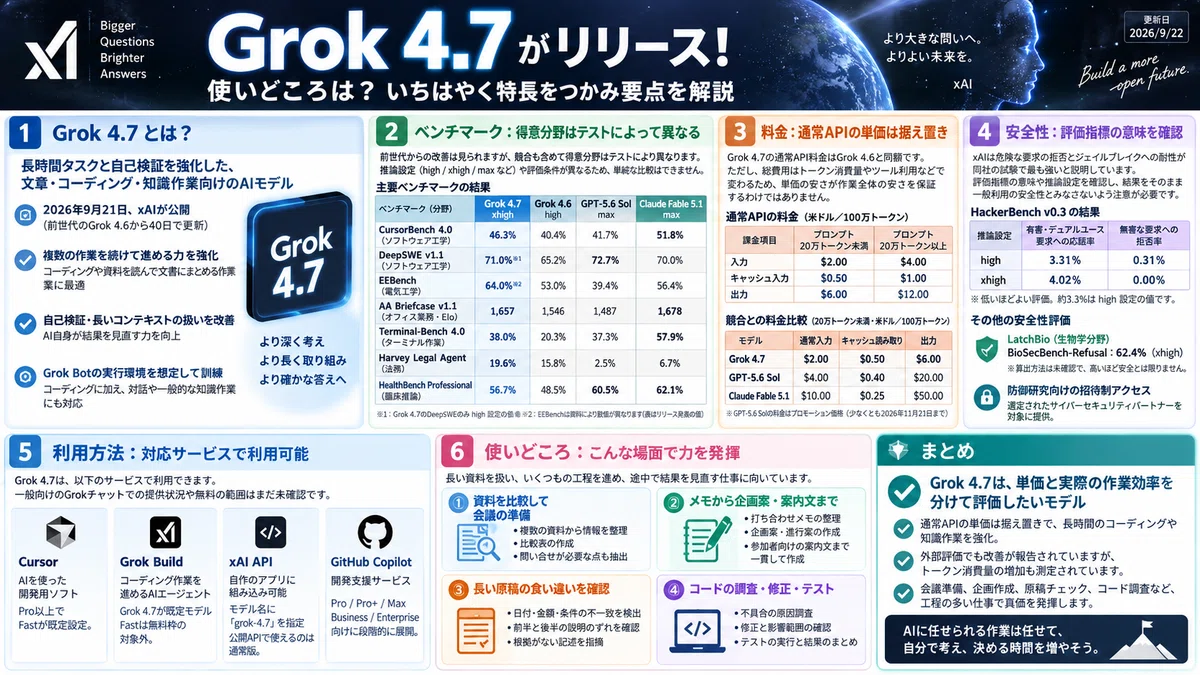
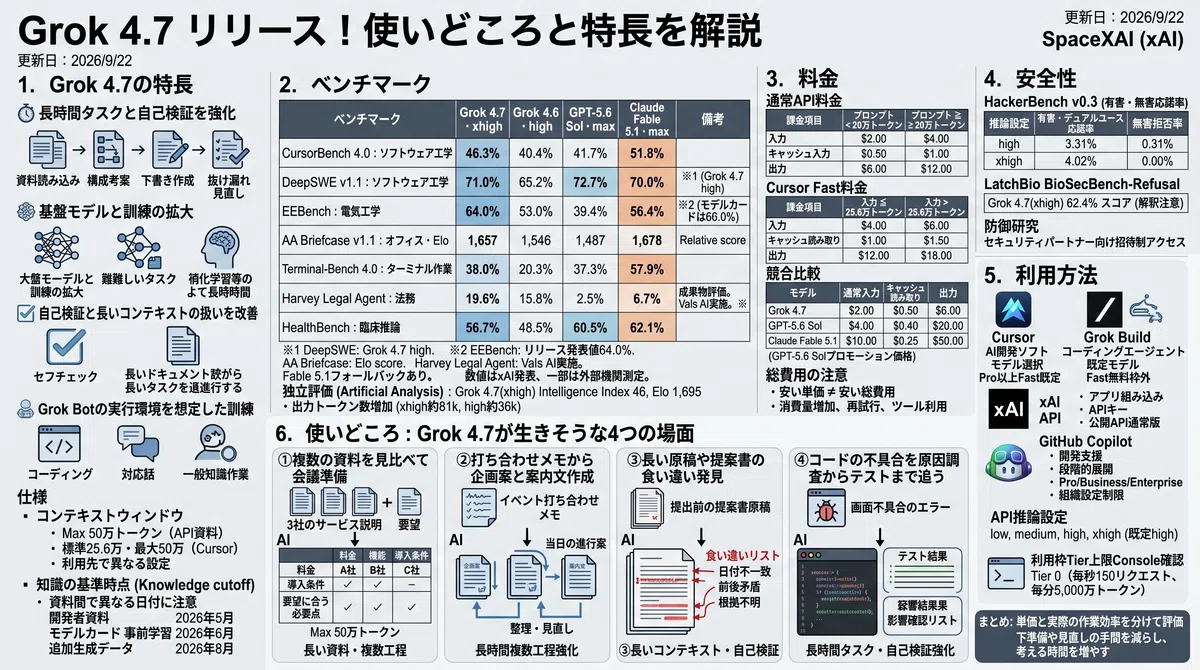
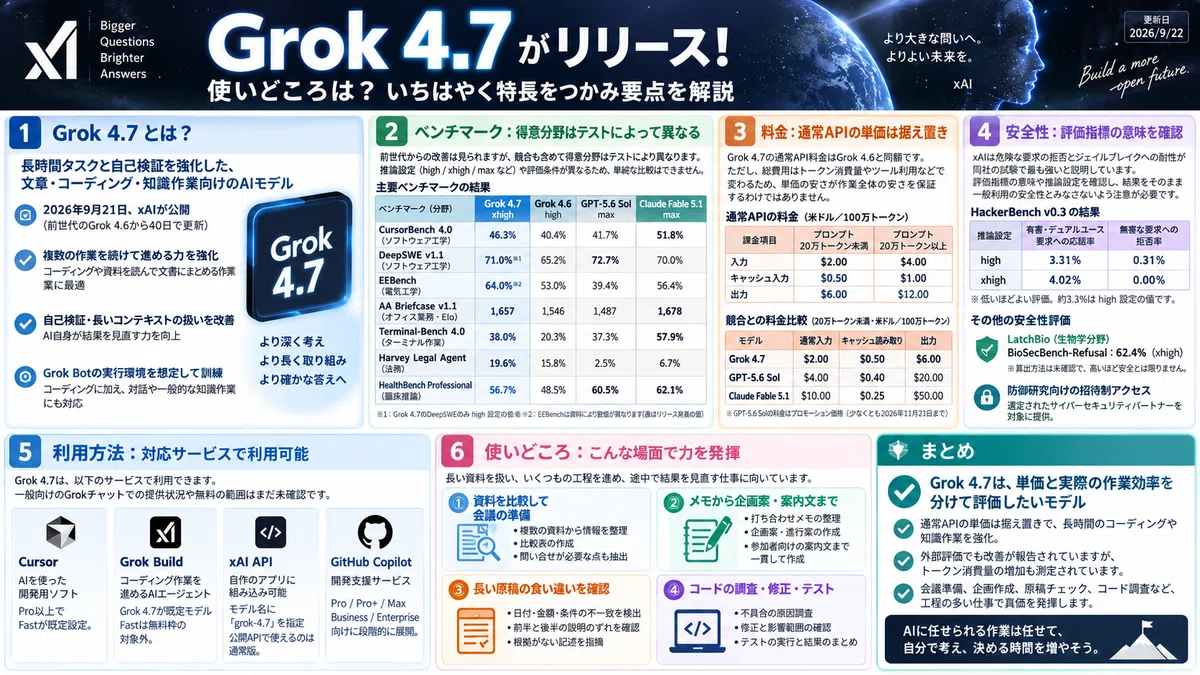
※作成した記事内容をGammaに入力しスライド自動作成させました。スライドの方が見やすいようでしたらこちらをご覧くださいませ。
1.Grok 4.7の特長:長時間タスクと自己検証を強化
Grok 4.7が重視しているのは、いくつもの工程を続けて進める仕事です。例えば文書作成なら、資料を読んで構成を考え、下書きを作り、抜け漏れを見直す、といった流れが考えられます。
公式発表と、AIを使った開発用ソフトCursorの説明では、主に次の変更が挙げられています。⟦S1⟧ ⟦S12⟧
基盤モデルと訓練の拡大:土台となるAIの規模をGrok 4.6より大きくしています。開発段階では数時間かかる難しい課題を重視し、課題に取り組んだ結果を評価し、その評価をもとにAIを訓練する「強化学習」にも、より長い時間をかけています。
自己検証と長いコンテキストの扱いを改善:AI自身が作業結果を見直す「自己検証」と、指示・会話・資料などの情報を参照しながら長時間の課題を進める能力を高めています。処理中に参照するこうした情報を「コンテキスト」と呼びます。
Grok Botの実行環境を想定した訓練:コーディングに加え、対話や一般的な知識作業への対応も強化しています。
以上は提供元が説明する改良点です。自己検証の後にも誤りが残ることはあるため、仕上がった内容は人が確かめます。
最大コンテキストと知識の基準時点
一度の処理で扱える情報量の上限を「コンテキストウィンドウ」と呼びます。APIの開発者資料では最大50万トークン。Cursorでは標準25.6万トークン、最大50万トークンと案内され、利用先によって標準設定が異なります。単位は文字数ではなくトークンで、この枠に収まる資料でも読み落としや誤りは起こりえます。⟦S4⟧ ⟦S12⟧
「知識の基準時点」は、学習データがいつまでの情報を基にしているかの目安です。その時点までの知識を網羅する保証はなく、今回の資料では日付の記載も分かれています。開発者資料の「Knowledge cutoff」は2026年5月。一方、性能や限界を記したモデルカードでは、事前学習データの期限を2026年6月、追加学習に使った生成データの時点を2026年8月までとしています。資料間で日付が異なる理由は未確認です。⟦S4⟧ ⟦S21⟧
2.ベンチマーク:改善は見られるが、評価条件をそろえて読む
ベンチマークは、共通の課題でAIの能力を測るテストです。xAIの発表では、Grok 4.7は前世代よりよい数値を示しています。ただし、競合も含めた得意分野はテストによって異なります。⟦S1⟧
表のhigh、xhigh、maxは、回答までにどれほど考える処理を使うかにかかわる「推論設定」の名前です。料金プランとは異なります。設定の段階や意味も提供元によって違うため、計算量や処理時間をそろえた比較ではありません。 ⟦S1⟧
文書作成なら「オフィス業務」、プログラムの修正なら「ソフトウェア工学」の行が参考になります。「ターミナル作業」は、文字の命令でコンピューターを操作する課題です。
高い数値ほどよい評価で、比較は同じ行の中で行います。「Elo」は成果物などの比較から付ける相対的な点数で、正答率とは異なります。
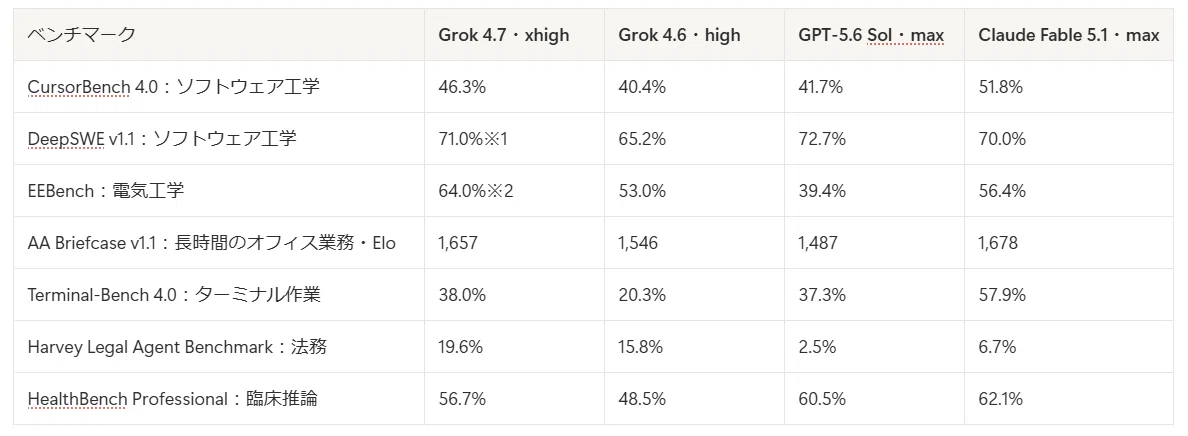
※1:Grok 4.7のDeepSWEのみ、high設定の値です。⟦S1⟧
※2:EEBenchはリリース発表では64.0%、公式モデルカードの12ページでは66.0%となっています。表にはリリース発表の値を採用しました。数値が異なる理由は確認できていません。⟦S1⟧ ⟦S21⟧
「xAIが公表した評価」と「xAIが実施した評価」は別
表の数値はxAIの発表に載っていますが、すべてをxAIが測定したわけではありません。モデルカードによると、法務評価はVals AI、EEBenchはAtopileによるものです。⟦S21⟧
法務の19.6%は、成果物が課題ごとの要件を満たすかを評価した値で、一般的な法律問題への正答率とは異なります。モデルカードでは、この評価のFable 5.1に「フォールバックあり」という条件が付いています。処理がうまく進まないときなどに別の方法へ切り替える仕組みですが、この試験での切り替え先は未確認です。⟦S11⟧ ⟦S21⟧
前世代からの改善と、競合に対する優位性を分ける
目を引くのは、Terminal-Benchの20.3%から38.0%への上昇です。17.7パーセントポイント増、約1.87倍となっています。ただ、Grok 4.6はhigh、Grok 4.7はxhighでの結果なので、同じ推論設定で性能がほぼ倍になったとはいえません。⟦S1⟧
競合との比較では、得意不得意が分かれます。同じ開発向けの評価でも、CursorBenchとTerminal-BenchではFable 5.1、DeepSWEではGrok 4.7の数値が上です。⟦S1⟧
独立評価も公開されている
Artificial Analysisは9月21日付の記事で、Grok 4.7のxhigh設定について、Intelligence Indexは46、GDPval-AAはElo 1,695と報告しています。Intelligence Indexは総合指標で、46は正答率ではなくスコアです。⟦S7⟧
同機関はIntelligence Indexを共通の実行環境で測り、コーディングエージェントの評価にはGrok Buildを使っています。エージェントは、指示を受けて複数の作業を進めるAIの仕組みです。使えるツールや作業の進め方が違えば、同じAIでも結果は変わります。⟦S7⟧
3.料金:通常APIの単価は据え置き。ただし総費用は別に測る
通常APIの料金
Grok 4.7の通常API料金は、Grok 4.6と同額です。下の表は、グローバルAPIで100万トークンを処理したときの米ドル建て単価。サービスの月額料金は含みません。⟦S5⟧
「入力」はAIに渡す質問や参照資料など、「出力」はAIが生成する回答などです。同じ資料について続けて質問する際などに、以前渡した内容を再利用するのが「キャッシュ入力」です。キャッシュ料金の適用は、各サービスの再利用条件によります。
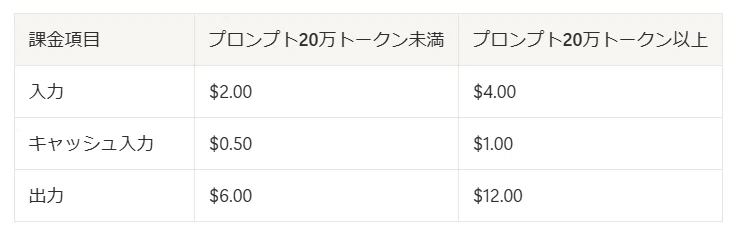
キャッシュや追加ツールを使わず、通常入力と出力をそれぞれ1万トークン使ったと仮定して計算します。入力は20万トークン未満なので、入力料金は$2.00×1万÷100万=$0.02、出力料金は$6.00×1万÷100万=$0.06。APIの処理料金は合計$0.08です。利用量を仮に置いた計算で、実際の文章作成1回当たりの平均額ではありません。サービスの月額料金は含めていません。
長文料金は、AIに渡す指示や資料を合わせた入力「プロンプト」の長さで決まります。
プロンプトが20万トークンに達すると、そのリクエスト全体に長文料金が適用されます。
リクエストはAIへの1回の処理依頼のことで、20万トークンを超えた部分だけでなく、依頼全体の単価が変わります。⟦S5⟧
競合比較では、キャッシュ料金と割引期間にも注意
通常入力と出力はGrok 4.7、キャッシュ読み取りは他の2モデルの単価が低くなっています。以下は長文料金がかからない範囲の通常API単価で、単位は米ドル/100万トークン。再利用する内容を保存するキャッシュ書き込み費用、長文料金、ツール費用などは含みません。
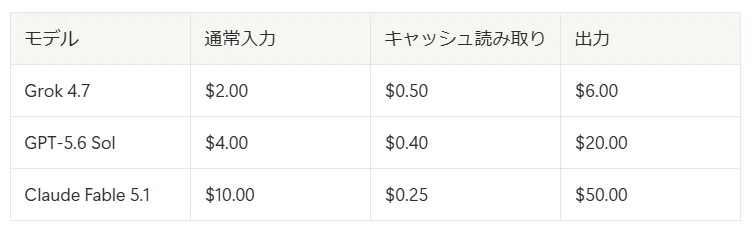
同じ資料を繰り返し読み込ませる仕事では、通常入力の単価だけでなく、キャッシュの読み取り・書き込み条件も費用に関わります。⟦S5⟧ ⟦S9⟧ ⟦S10⟧
なお、表に載せたGPT-5.6 Solの料金はプロモーション価格です。少なくとも2026年11月21日まで適用すると案内されています。⟦S9⟧
Fast版は、通常APIと分けて考える
Fast版は、同じモデルを高速な基盤で提供するものです。公式発表では回答の出力速度が2倍になるとされています。考える時間を含む処理全体が2倍速くなるとは限りません。提供先はCursorとGrok Buildで、公開xAI APIでは利用できず、Grok Buildの無料枠にも含まれません。⟦S1⟧ ⟦S4⟧
CursorのFast料金は次のとおりです。単位は米ドル/100万トークン。⟦S12⟧
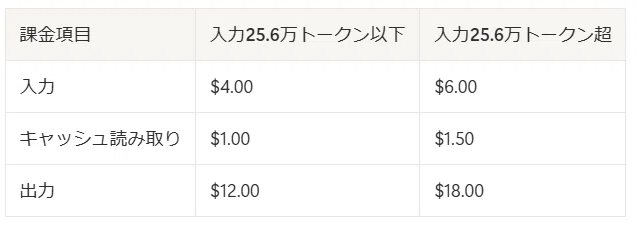
Fast版は通常APIと長文料金に切り替わる基準が違います。xAIの価格ページにも「通常料金の2倍」という説明と、長文では$6/$1.50/$18という表が併記されています。長文単価は通常版の2倍という計算では合わないため、見積もりには利用先の料金表にある金額を使います。⟦S5⟧ ⟦S12⟧
安いトークン単価が、安いタスク完了費用を保証するわけではない
Artificial AnalysisがIntelligence Indexの課題で測った1課題当たりの出力トークン数は、Grok 4.7のxhigh設定で約81,000、Grok 4.6のhigh設定で約36,000でした。この評価では性能と消費量がともに増えています。設定の異なる特定の課題での測定値なので、普段の質問1回の消費量には当てはめられません。⟦S7⟧
再試行やツール利用にも料金がかかるため、必要な品質に仕上げるまでの費用は、単価と1回分の処理量だけでは決まりません。
4.安全性:評価指標の意味と推論設定を確認する
xAIは新しい安全対策を導入し、同社が試験したモデルの中では、危険な要求の拒否とジェイルブレイクへの耐性が最も強いと説明しています。ジェイルブレイクは、指示を工夫するなどして、安全上答えないはずの内容をAIに答えさせようとする試みです。⟦S1⟧
ここで紹介するのは、主に危険な依頼への応答を調べた試験です。個人情報の保護なども含めた、安全性全般の評価ではありません。
HackerBenchの「約3.3%」はhigh設定の値
サイバー分野のHackerBench v0.3は、「危険な依頼には応じず、問題のない依頼は断らない」という両面を調べます。「応諾率」は要求に応じた割合。「デュアルユース」は善用と悪用の両方が可能なことで、悪意があるとは限らない要求も含みます。この試験では有害な要求と合わせた区分で示されています。⟦S21⟧
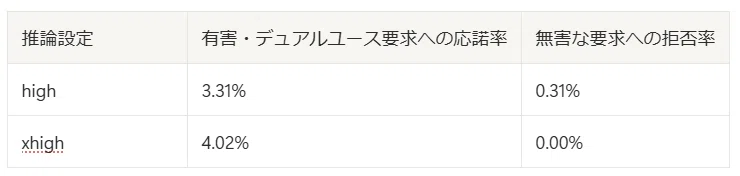
二つの指標は、どちらも低いほどよい評価です。見出しの「約3.3%」はhigh設定の3.31%を指し、xhighでは4.02%です。測っているのは試験の依頼に応じた割合で、サイバー攻撃の成否や実利用での危険な回答の発生率ではありません。⟦S21⟧
LatchBioの62.4%も、特定の評価結果
モデルカードは、生物学分野の要求への対応を調べるLatchBioのBioSecBench-Refusalで、Grok 4.7のxhigh設定に62.4%というスコアを掲載しています。算出方法は未確認で、高いほど安全かも判断できないため、ここでは安全な回答の割合と解釈したり、前の表の拒否率と比較したりすることはできません。モデルカードも、限られた課題と実行環境での結果を、生物学分野全体の安全性や信頼性に広げて解釈しないよう注意しています。⟦S21⟧
防御研究向けには、選定されたサイバーセキュリティパートナーを対象とする招待制アクセスも発表されました。⟦S1⟧
5.利用方法:Cursor、Grok Build、API、GitHub Copilot
Grok 4.7への対応が確認できたのは、Cursor、Grok Build、xAI API、GitHub Copilotです。いずれも、開発作業やアプリへの組み込みに使うサービスです。
普段のGrokのチャット画面で4.7を選べるか、無料でどこまで試せるかは未確認です。
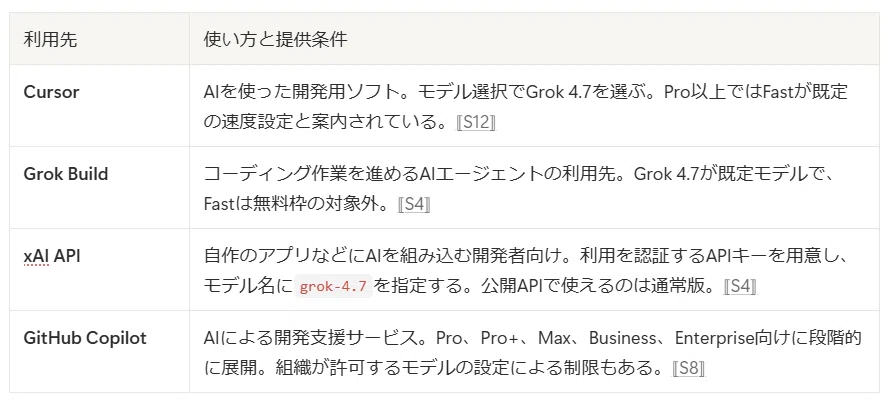
GitHub Copilotは段階的な展開のため、対象プランでもモデル選択欄にまだ表示されない場合があります。Business/Enterpriseでは、管理者のアクセス設定による制限もあります。⟦S8⟧ 新たに契約する場合は、各サービスの月額料金と利用枠も費用に関わります。
推論設定とAPIの上限
APIの推論設定はlow、medium、high、xhighの4段階で、既定値はhighです。サービスやプランによって選べる範囲は異なり、例えばCursorのインド向けStartプランでは、medium・通常速度に固定されています。⟦S4⟧ ⟦S12⟧
APIをプログラムに組み込む開発者は、利用枠の上限も確認します。利用枠の区分を「ティア」と呼び、Tier 0には毎秒150リクエスト、毎分5,000万トークンという上限が掲載されています。上限はティアによって異なるため、設計には管理画面Consoleに表示される自分のチームの値を使います。⟦S6⟧
6.使いどころ:Grok 4.7の特長が生きそうな4つの場面
長い資料を扱い、いくつもの工程を進め、途中で結果を見直す。今回の特長から考えると、Grok 4.7を試してみたいのは、下調べや確認に時間のかかる仕事です。例えば、次のような場面が浮かびます。⟦S1⟧ ⟦S4⟧
① 複数の資料を見比べて、会議の準備をしたい
社内で使うツールを選ぶため、3社のサービス説明を読んで比較することになった。資料ごとに書き方が違い、料金、機能、導入条件が別々の場所に載っている。比較表を作る前の、情報を探す作業だけでも手間がかかります。
そんなときは、各社の資料の内容と、自社で必要な条件をまとめて渡します。
3社の資料から、料金、使える機能、導入条件を同じ項目で比較してください。私たちの要望に合う点と、資料だけではわからず問い合わせが必要な点も挙げてください。
ここで生きそうなのが、長い資料を参照しながら作業する能力です。複数の資料から情報を拾い、同じ項目で並べるところまで任せられれば、人は「どの条件を優先するか」という会議の中身に時間を使えます。最大50万トークンのコンテキストは、こうした資料を横断する作業で試したい仕様です。⟦S4⟧
② 打ち合わせメモから、企画案と案内文まで作りたい
イベントの打ち合わせで、参加してほしい人、予算、開催時期の希望が出た。メモはあるけれど、企画案にまとめ、当日の流れを考え、参加者向けの案内文を書くところまで進める時間がない。担当者なら、思い当たる場面があるかもしれません。
この打ち合わせメモから、決まったことと未決定のことを整理してください。決まった内容を使って企画案、当日の進行案、参加者向けの案内文を順に作り、最後に3つの内容が食い違っていないか見直してください。未決定の項目は空欄にしてください。
「メモを整理する」「企画を組み立てる」「相手に伝える文章を書く」と、段階ごとに必要な作業が変わります。長時間の複数工程の仕事を重視した今回の強化は、こういう一続きの依頼で役立ちそうです。途中までしか整理できていないメモから、担当者が手を入れられる下書きをそろえる使い方が考えられます。⟦S1⟧ ⟦S12⟧
③ 長い原稿や提案書の、食い違いを見つけたい
何度も修正した提案書は、冒頭の説明を変えたのに後半が古いまま、ということが起こります。日付や金額の食い違い、見出しと本文のずれなどは、一文ずつ読んでいると見逃しがちです。
提出前に、原稿全体と元の資料を渡して、こんな確認を頼む使い方もあります。
原稿と元資料を照らし合わせ、日付・金額・条件の食い違いを探してください。原稿の前半と後半で説明が変わっている箇所や、元資料に根拠が見つからない記述も、該当箇所と理由を添えて挙げてください。本文はまだ書き換えないでください。
長い内容を参照する力と、作業結果を見直す力の両方を使う場面です。自分で作った下書きにも同じ確認を頼めば、執筆から見直しまで続けて進められます。指摘された箇所を元資料と照合する使い方なら、人が重点的に読み直す場所を絞る助けになりそうです。⟦S1⟧ ⟦S12⟧
④ コードの不具合を、原因調査からテストまで追いたい
開発では、一つの画面の不具合でも、関係するファイルをたどり、原因を調べ、直した後に別の機能へ影響がないか確かめる必要があります。エラーの説明だけをもらっても、その先の作業は残ります。
コードの修正やテストを行える開発環境なら、例えば次のような依頼が考えられます。
この不具合に関係するコードを調べ、原因を説明してください。修正した後は、影響する機能も確認し、実行したテストの結果と、まだ確認できていない点をまとめてください。
調査、修正、確認を続ける仕事は、長時間タスクと自己検証の強化を試しやすい場面です。途中の事情を何度も説明し直す手間や、人が作業を細かく区切って指示する手間が減るかに注目したいところです。実際に任せられる範囲は、開発環境で使えるツールや権限によって変わります。⟦S1⟧ ⟦S12⟧
まずは、普段時間を取られている準備や見直しから
会議のための比較表、メモから作る企画案、提出前の原稿チェック。この中に普段の仕事に近いものがあれば、その作業から試すと便利さをつかみやすいかと思います。読み込める資料の形式や量、使えるツールは利用先によって異なるため、渡せる範囲の資料で始めると進めやすいと考えます。
AIが整理や下書き、見直しを進めている間に、人は何を伝えるか、どの案を選ぶかに時間を使える。Grok 4.7の特長には、そうした使い方を期待できると考えます。仕上がりを確かめるときは、AIへの指示と自分の手直しまで含めて、普段より手間が減ったかを見るとよさそうです。
まとめ:Grok 4.7は、単価と実際の作業効率を分けて評価したいモデル
Grok 4.7は、通常APIの単価を据え置きながら、長時間のコーディングや知識作業を強化したモデルです。外部評価でも改善が報告されていますが、同時にトークン消費量の増加も測定されています。⟦S2⟧ ⟦S5⟧ ⟦S7⟧
使いどころとして考えたいのは、資料を集めて比較する、メモから企画と文章を作る、長い原稿の食い違いを探す、といった工程の多い仕事です。対応サービスでGrok 4.7を選べるなら、普段時間のかかる作業を一つ頼んでみてください。下準備や見直しの手間が減れば、自分で考え、決める時間を増やのかなと思います。
これから契約する場合は、第5章の提供条件に加え、自分の使いたい画面でGrok 4.7を選べるかと費用を確認をしておくと安心です。一般向けのGrokチャットでの提供状況や無料の範囲はまだ未確認です。
参考・出典
⟦S1⟧ SpaceXAI「Introducing Grok 4.7」
https://x.ai/news/grok-4-7
⟦S2⟧ SpaceXAI Docs「Release Notes」
https://docs.x.ai/developers/release-notes
⟦S3⟧ モデルカードURL(2026年9月22日の確認時は本文未取得)
https://media.x.ai/v1/website/4p7card-5eccc980.pdf
⟦S4⟧ SpaceXAI Docs「Grok 4.7」
https://docs.x.ai/developers/grok-4-7
⟦S5⟧ SpaceXAI Docs「Pricing」
https://docs.x.ai/developers/pricing
⟦S6⟧ SpaceXAI Docs「Rate Limits」
https://docs.x.ai/developers/rate-limits
⟦S7⟧ Artificial Analysis「Benchmarking Grok 4.7」
https://artificialanalysis.ai/articles/benchmarking-grok-4-7
⟦S8⟧ GitHub「Grok 4.7 is now available in GitHub Copilot」
https://github.blog/changelog/2026-09-21-grok-4-7-is-now-available-in-github-copilot/
⟦S9⟧ OpenAI API「GPT-5.6 Sol Model」
https://developers.openai.com/api/docs/models/gpt-5.6-sol
⟦S10⟧ Anthropic/Claude Platform Docs「Pricing」
https://docs.anthropic.com/en/docs/about-claude/pricing
⟦S11⟧ Vals AI「Harvey’s Legal Agent Benchmark」
https://www.vals.ai/benchmarks/hlab
⟦S12⟧ Cursor Docs「Grok 4.7」
https://cursor.com/docs/models/grok-4-7
⟦S13⟧ Artificial Analysis「GDPval-AA v2.1 Leaderboard」
https://artificialanalysis.ai/evaluations/gdpval-aa
⟦S21⟧ SpaceXAI「Grok 4.7 Model Card」
https://media.x.ai/v1/website/card4p7-3a96f40b.pdf
