映像素人がAIを“助監督”にして実写MVを作る

―デモ→解析→改善、そして「画像で構図を吟味してから動画にする」制作ログ(届かない青)
はじめに:派手さより地味エモAI MVを狙う
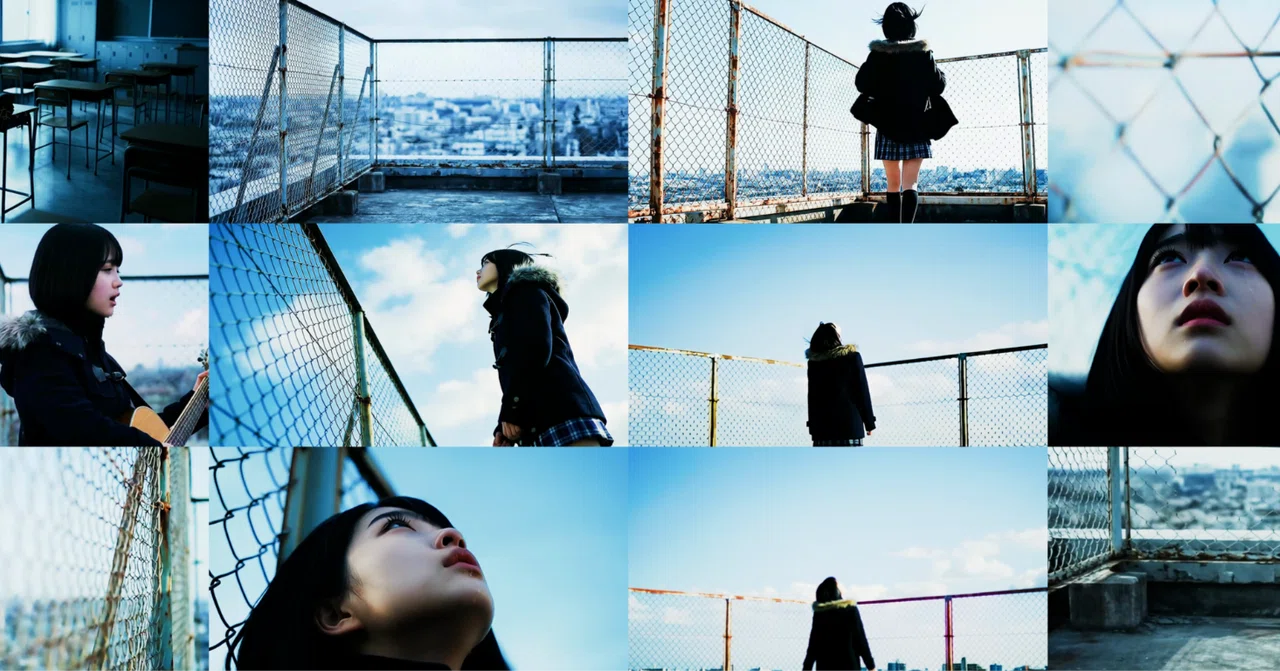
AI MVは、派手な画作り・強いモーフィング・リップシンク多用など「AIがすごい」に回収されやすい方向にあります。 ただ今回はそこから距離を取り、「実写映画っぽい」「地味なエモさ」を狙いました。
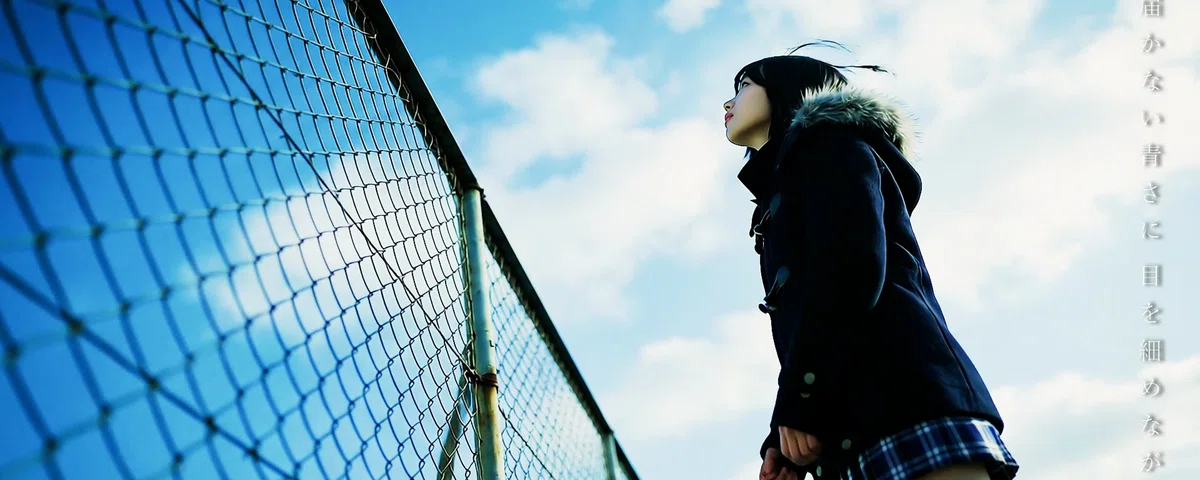
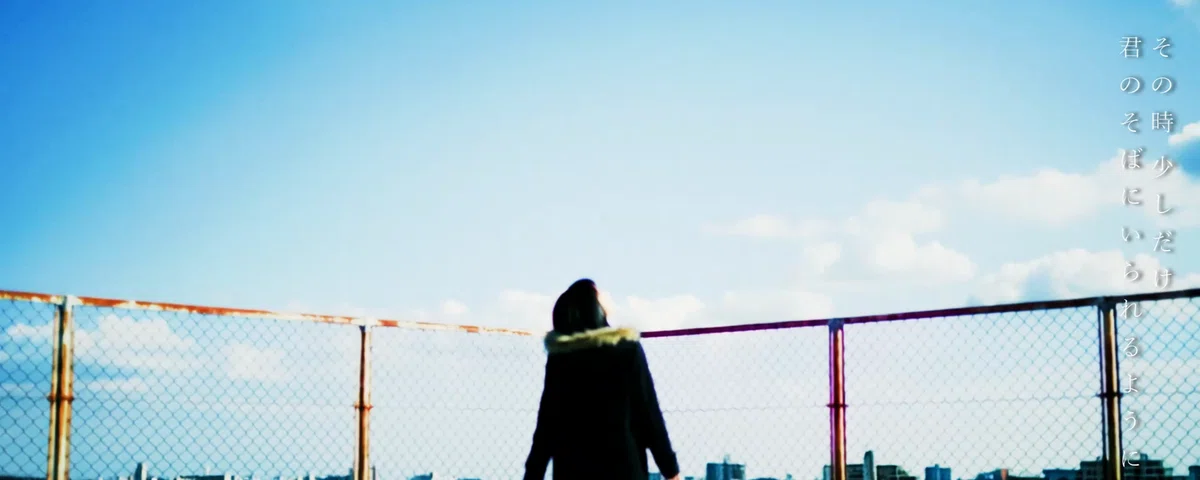
舞台は 屋上/金網フェンス/冬の青空/街並み。 映像側の設計軸はこの3つです。
青の統一感(色で世界観を固定する)
余白の感情(演技を盛りすぎない)
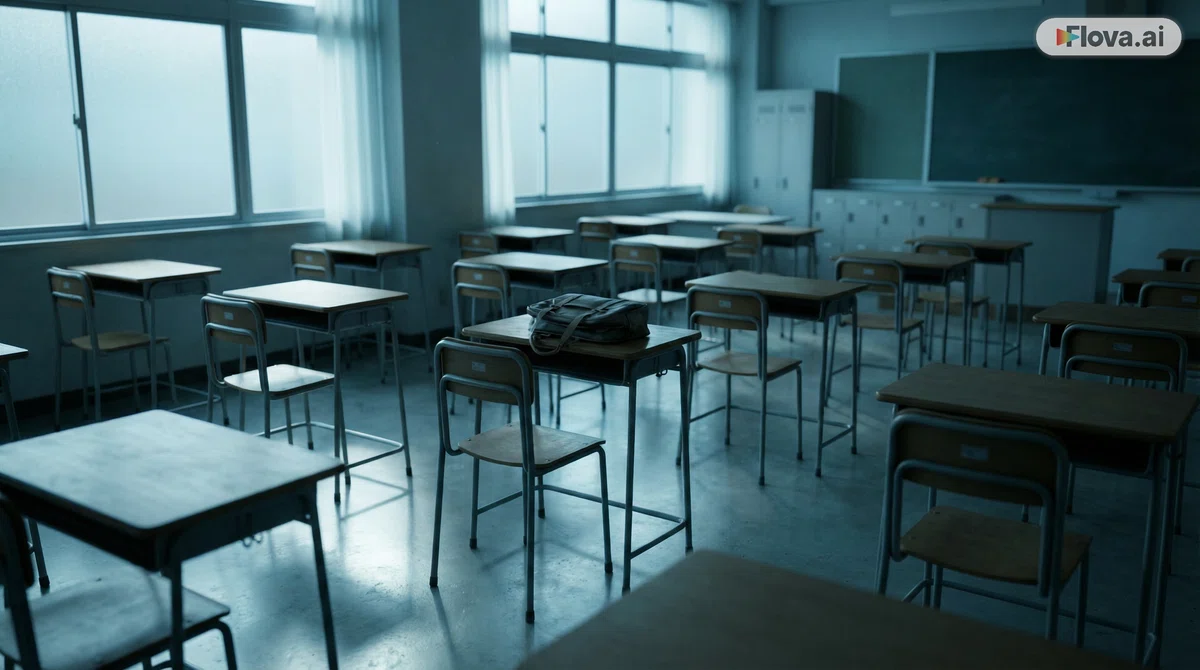
背景の質感をあえて錆びや汚れを入れAIっぽさを排除
結論(TL;DR)
今回の制作で効いたのはこの3点でした。
デモテイクを先に作り、AIに解析させて“助監督レビュー”で詰める
動画の前に画像生成で構図を勝つ(NanoBanana等)
クレジット消費は設計で抑える(Grokで検証→Flova.aiの無駄打ちを減らす)
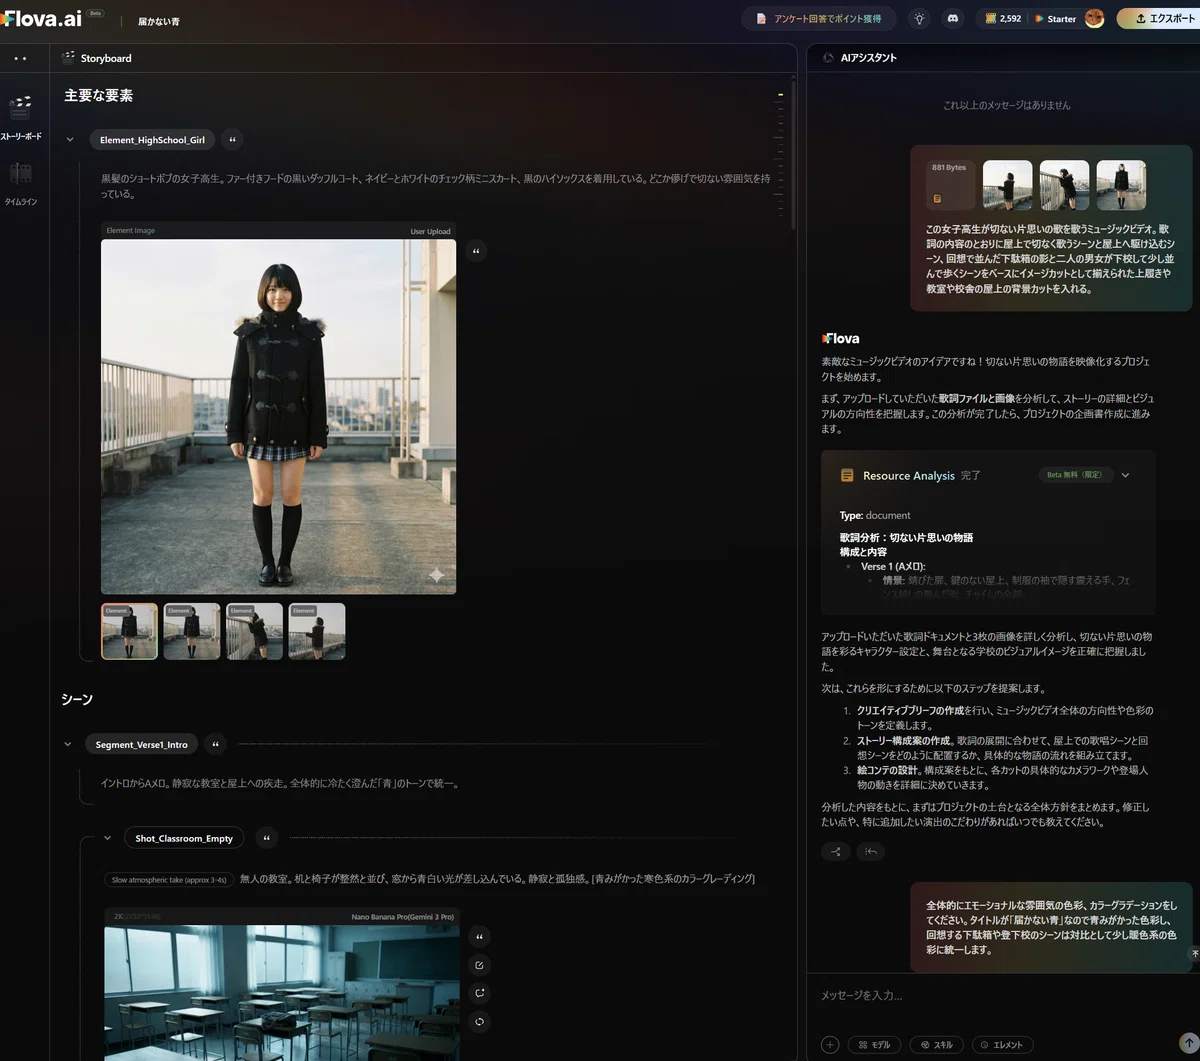
1. 使用ツール構成(今回のスタック:実態ベース)
制作は「構図設計」「検証」「本番生成」「編集」「レビュー」で分離しました。
① 画像生成(構図設計の主戦場)
NanoBanana など
まずここで 構図・視線・余白・画角 を詰める。 動画生成はフレーム間で崩れやすいので、“良い一枚”を作ってから動画化した方が成功率が高い、というのが今回の実感です。また画面プロンプト設計の際、GrokやVeoなどで生成した動画の中からフレームを切り出し、そこからさらに画を詰めるという方法が有効でした。
② テスト生成・検証(クレジット最適化の要)
Grok
背景素材の生成
カット用プロンプト設計の検証(テスト動画生成)
目的は「本番生成の前に当たりを付ける」ことで、Flova.ai側の無駄な動画クレジット消費を抑えること。 テスト素材でもそのまま使える出来なら採用します(体感として、手の動きやカメラの情緒が良い方向に出ることがあり、積極的に試しました)。Flow(Veo3.1)
草案/テスト用のショートMV制作に使用。 本番の主生成ではなく、短尺で成立する見せ方の当たりを取る用途です。GoogleAIProプランに加入しているので、1000クレジット分の生成枠がありました。テスト草案用なのでVeo3.1-fastで生成し、クレジット消費は抑えました。
ショートデモ版
FlowのVeo3.1を使って歌唱シーンを作って半ば強引にリップシンクシーンを差し込んでみる。… pic.twitter.com/noP6dHFn7d
— WTR (@wtry1102) January 12, 2026
③ 動画生成(本番ショット作成)
Flova.ai
本番用ショット生成と、仮組(ゼロ草案)用途。 「いきなりFlovaで試行錯誤」をするとクレジットが溶けるので、前段で検証してから投入します。Higgsfield
無料クレジット枠でリップシンクを1カットだけ作成(要所に限定投入)。 “歌っている感”の担保としてピンポイントで使う判断です。
④ 解析・設計(助監督運用)
Gemini / ChatGPT
デモテイク解析(カット割り・テンポ・情報量) 改善案の列挙と優先順位付け “次に足すべき最小カット”の提案 動画プロンプト設計
⑤ 編集・仕上げ
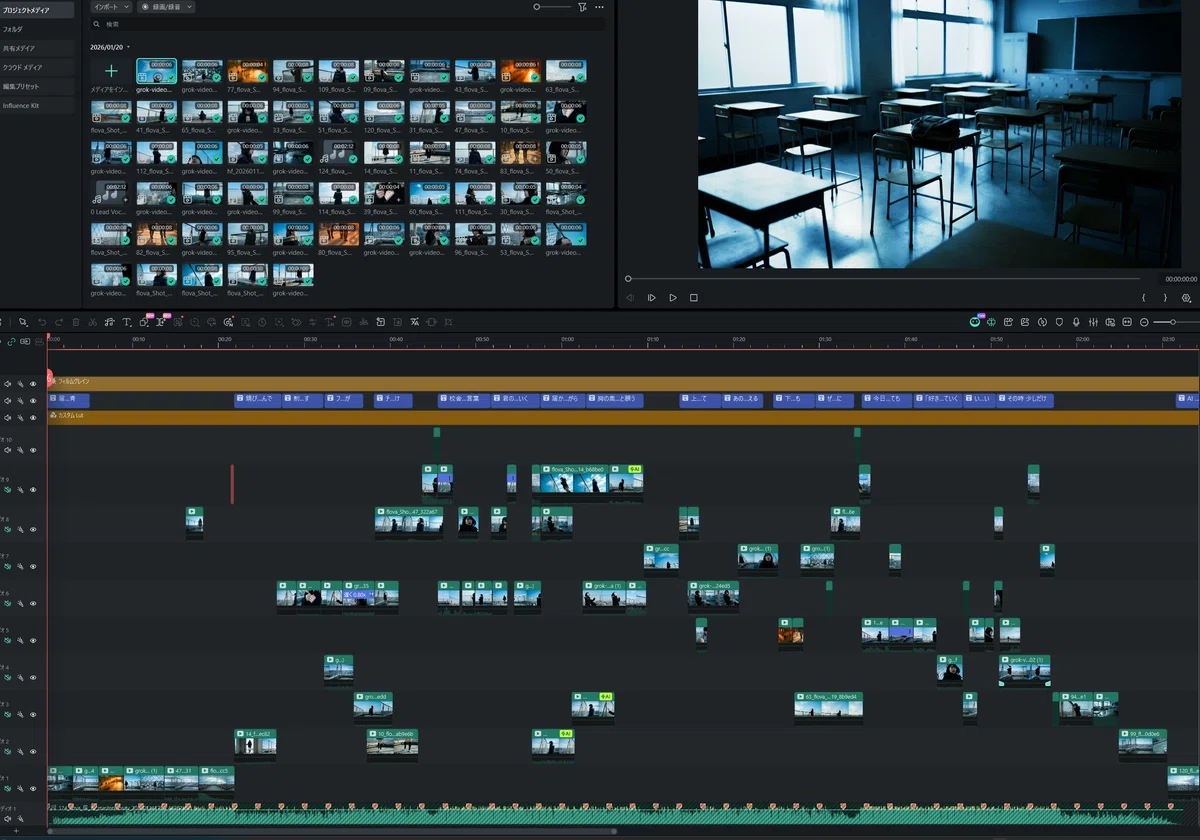
Filmora カット編集/カラーグレーディング/テキスト/微ズーム(破綻隠し兼演出)
2. 今回の肝:動画の前に「画像で構図を勝つ」
学びを一言にするとこれです。
動画生成モデルに期待しすぎると負ける。 先に画像生成で構図を詰めてから動画化した方が勝率が高い。
動画はフレーム間で破綻が出やすく、 「良い構図」「良い表情」「良い余白」を維持しにくい。 だから制作順序をこう固定しました。
NanoBanana等で「良い一枚」を作る(構図・視線・余白)
その一枚を起点に動画化する(ブレを最小化)
動画の中から良いカットが出来たらそのフレームを切り出しさらに構図を詰め派生素材を作る
破綻は編集側で隠す(見せない設計)
3. クレジットを溶かさない“検証レイヤー”(Grokの使い方)
Flova.aiのようにクレジット消費が発生する環境で、試行錯誤を本番でやるのはコスト的に危険です。 そこで Grokを検証用サンドボックスとして使いました。
素材の当たりを付ける
プロンプトで「どの方向に寄るか」をテストする
意図通りの画が見えたら、Flova.aiで本番ショットを作る
結果としてFlova.aiの無駄打ちを抑える運用になりました。 一方で、Flova.aiの多様なモデルを本格的に使うのが初めてだったため、癖を掴む学習コストとして一定のクレジットは必要でした。無料枠やキャンペーンの増量がなければ、運用難易度は上がっていたと思います。
4. AIを“助監督”にする:デモ→解析→改善の反復
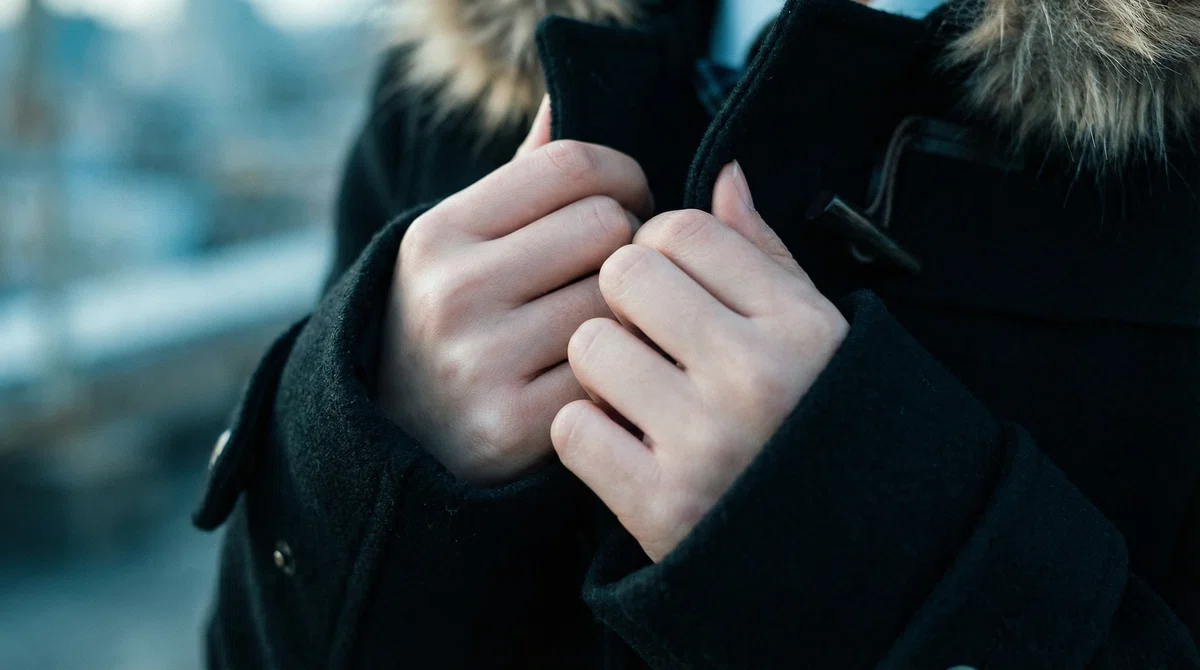
映像素人にとって一番きついのは、編集操作ではなく判断です。 そこで採用したのが、デモテイクを先に作り、AIに叩かせる方法でした。
流れ
まず仮で繋ぐ(デモテイク)
AIに解析させる(助監督レビュー)
直す(追加生成/差し替え/尺調整)
仕上げで統一(色・肌・温度)
重要なのは、AIの提案を正解扱いしないこと。 採用基準は常に 「意図に合うか」「統一感を壊さないか」「視聴体験が良くなるか」 です。今回はテイク7まで作りました。
5. カット設計の基本方針(屋上MVの方向性)
屋上×フェンス×街並みは情報量が少ない分、設計が弱いと単調になります。 そこで、画作りを3軸で管理しました。
① 視線の軸(空・街・自分)
空を見る:想い/預ける
街を見る:現実/距離
目を閉じる:内面/祈り
② 距離の軸(Wide→Mid→Close)
ワイド:孤独と余白
ミドル:感情の輪郭
クローズ:祈り/決意(刺すカット)
③ 動きの軸(被写体よりカメラで作る)
派手な演技をさせない代わりに、カメラワークと構図で立体感を作る。 (例:ゆっくりドリーイン、回り込み、フェンス越しの寄り→街へ抜く)
6. プロンプト設計の考え方:盛らない、空気を残す
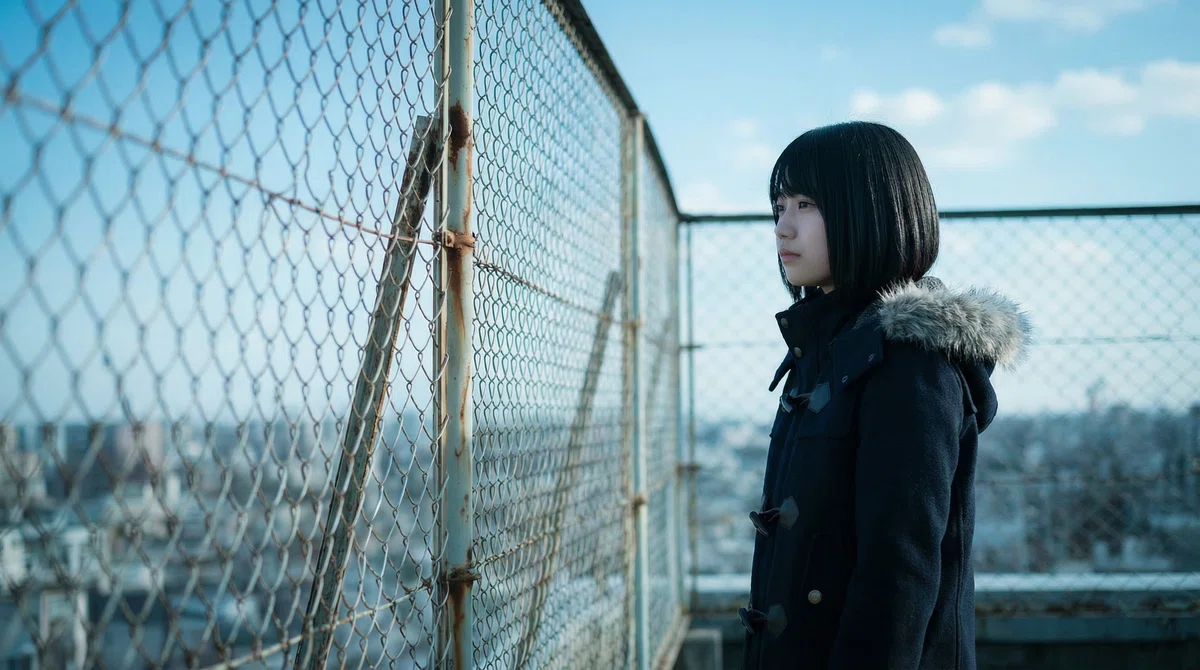
プロンプト設計はChatGPTで行います。今回徹底したのは「盛らない」こと、そして画面内の空気感です。
演技:顔・視線・呼吸・風
動き:カメラで作る
情報:屋上の風景を固定資産化(世界観が揺れない)
「空へ預ける」を作る時も、投げる/走る/大げさなジェスチャーは不要で、 目を細める→ゆっくり見上げる→手を握る くらいで成立します。
7. 編集で“作品”にする(Filmora)
AIが生成した素材は、それ単体だと断片的なクリップです。 MVとして成立させるのは編集工程で、私が意識したのは次の3点でした。
直繋ぎを基本にしてテンポを作る(トランジションは意味がある場所だけ)※今回は最終判断でFilmoraの付属のトランジションは使用せず、イントロからのブラックアウト切り替え1点のみ使ってます。
足りない感情カットが出たら 追加生成→差し替え を即回す(デモ→更新の反復)
破綻は 短く切る/微ズームで逃げる(“見せない設計”を演出に変換)
8. リップシンクは“ピンポイント投入”で効かせる(Higgsfield)
リップシンクは説得力を上げますが、コストと手戻りを考えると「多用=正義」ではありません。 今回は Higgsfieldの無料枠で1カットだけ作り、要所に置くことで「歌っている感」を担保する方針にしました。
9. 仕上げで完成度を決めた:カラー設計(Filmora)
AI素材は放置するとバラつきが出て、素人っぽさが一気に出ます。 最終的に“作品”にする決定打はカラー設計でした。フィルターで全体の質感を統一しつつ、カットごとにAIカラーパレットで調整しました。
イントロ風景:青みを足して “青”を主題化
回想(下駄箱):赤み→モノトーン寄せで 世界観と差別化を両立
肌色:スマホ視聴基準で違和感を潰す(色温度・彩度を微調整)
10. ここは課題:動画生成モデルの使い分けは“知識と検証”が必要
今回痛感したのは、動画生成モデルの使い分けにはまだ検証と知識が足りないという点です。
どのモデルが「人物の安定」に強いのか
どのモデルが「カメラワークの自然さ」に強いのか
どのモデルが「破綻の少なさ」と「コスト」のバランスが良いのか
加えて、モデルによってはコンテンツポリシー判定が厳しく、意図しない形で生成が弾かれることがあります。 今後はショット種別ごとにベンチマークを取り、生成モデルの最適化とパターン化していく予定です。
まとめ:AI MVの完成度は「生成」より「設計」と「統一感」
動画生成は万能ではない。画像で構図を勝ってから動画化した方が安定する
クレジットは設計で守る。Grokで検証→Flova.aiで本番が効いた
AIは監督ではなく助監督。デモ→解析→改善で判断の根拠を増やす
仕上げの統一感(色・肌・温度)が、素人っぽさを消す
映像素人にとって最も効いたAI活用は、生成そのものより 「デモを作ってAIに叩かせる=助監督レビュー」 でした。
