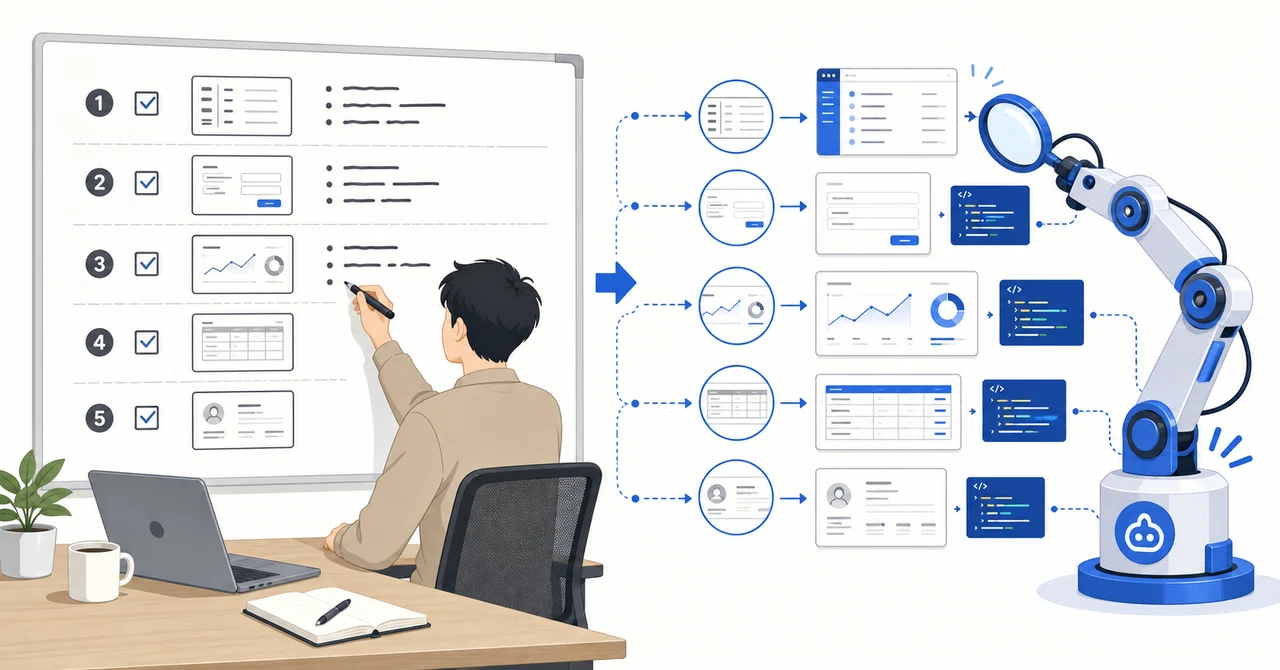
Opus前提のスキルをGPTで動かすと、幅の網羅が落ちる

Claude Code で使っているスキルは、Opus を前提に作ったものがほとんどでした。あるとき、そのスキルを Copilot CLI 経由で GPT-5.4 に渡して同じ作業をさせてみたところ、結果が大きく変わりました。同じ手順書のはずなのに、対象の網羅のされ方がまるで違ったのです。
同じスキルなのに、GPTで動かしたら仕上がりが変わった?
AI コーディングエージェントを複数使い分けていると、こういう経験はないでしょうか。
Claude Code 用に作ったスキルを別のエージェントに渡したら、細かい項目や周辺機能を見逃す
要件や設計の同期を頼んでも、一部しか反映されずに戻ってくる
「同じ指示を渡しているのに、なぜ結果が違うのか」と首をひねる
これは渡した先のモデルの精度が低いわけではありません。前提にしていたモデルが変わり、スキルが暗黙に頼っていた「幅を見る力」が失われていたのが実態でした。
Opus は指示された作業の横のつながりまで見て、周辺の項目を自分から拾いにいきます。GPT は深さと精度が高いモデルです。ただ、指示された範囲の外まで自分から広げることはしません。
Claude Code で Opus 前提に作ったスキルを別のコーディングエージェントで動かすときは、幅の網羅の観点を明示的に渡す必要があります。
Copilot CLI × GPT-5.4で、幅の網羅が消えた
ある支援先で使っているスキルの多くは、GitHub Copilot 上で Opus との対話をベースに作ってあります。そのスキルをそのまま Copilot CLI 経由で GPT-5.4 に渡し、既存画面の再現を任せました。主要な要素は作ってくれるのですが、細かい項目や周辺機能を見逃すことが多くありました。
最初は「GPT はこういうものか」と思っていました。ですが、同じスキルを Opus 4.8 で動かすと、抜け漏れがほとんど起きません。差はモデルの精度ではなく、幅を見る力にありました。
Opus は、指示された作業の周辺にある関連項目まで自分から拾いにいきます。画面ならタブやモーダル、要件なら関連する例外パターンまで、指示していない範囲を横に広げて見てくれるのです。GPT は、指示された項目について深く正確に実装してくれます。ただ、指示の外側にある関連項目までは、自分から探しにいきません。
要件や設計を扱わせても、同じ差が出ました。Opus に渡したときは関連する周辺仕様まで拾って同期してくれます。GPT に渡したときは、指示した項目だけが正確に反映され、周辺の項目は取りこぼされたままでした。
モデルによって、幅を見る力が違う
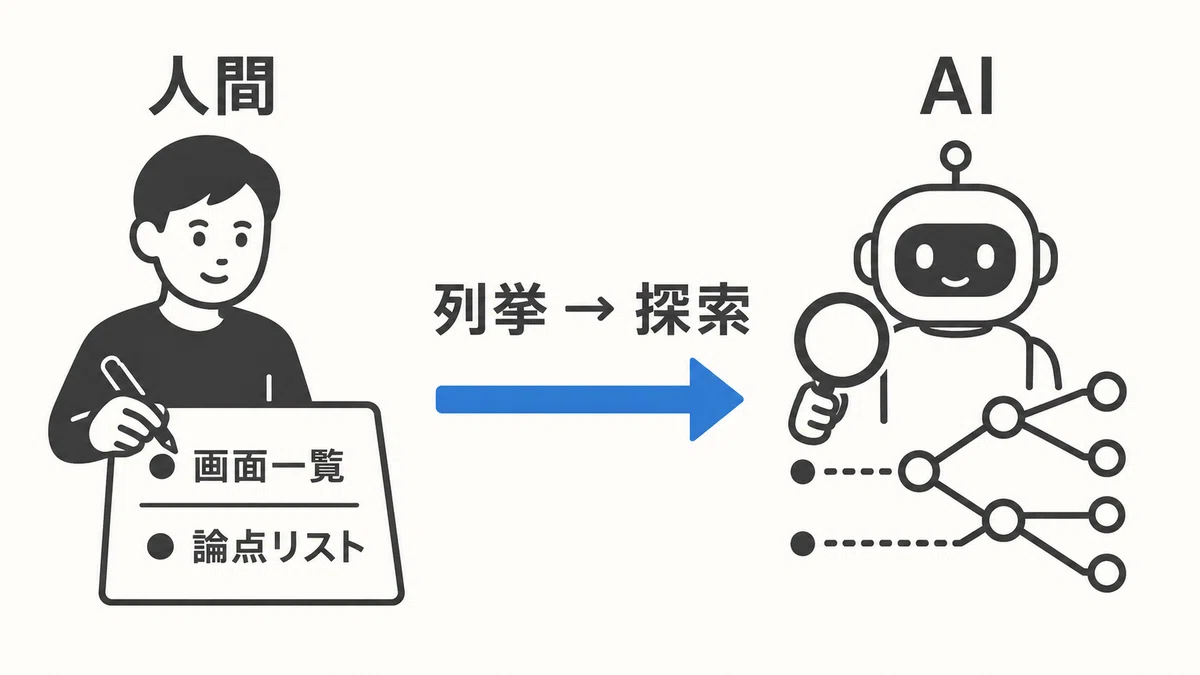
AI コーディングエージェントは、土台にしているモデルによって得意なことが違います。この違いを整理すると、スキルを別のモデルに渡すときに何を補えばいいかが見えてきます。
Opus: 指示されていない周辺項目まで、自分から探索して拾う
GPT: 指示された項目に絞って、深さと精度で正確に応える
Opus は幅の網羅が得意で、GPT は深掘りの精度が得意という役割の違いです。
だからといって、GPT に幅を諦めさせる必要はありません。人が対象の一覧を先に列挙して渡せば、GPT はその一覧の各項目を深く正確に実装してくれます。幅の網羅を人が担当し、深さの実装を GPT が担当する形に切り替えれば、精度の高さはそのまま活きます。
逆にGPTをベースに作成したスキルをOpusに渡せば、深さに不安が残ります。この場合は、レビュアにGPTのモデルを適用すれば補完できます。
スキルを別のモデルに渡す前に、確認したいこと
作ったスキルを別のモデルで動かす前に、使える問いがあります。
そのスキルは、どのモデルを前提に作られているか
前提のモデルは、幅と深さどちらを重視したタイプか
新たに渡す先のモデルの特徴がわかっていない場合、実行結果の差分から、知っているモデルの特性で補うステップを、既存の前後に追加することで品質を一定に保つことができます。
スキルの前提モデルを、意識していますか
今後も新しいモデルは登場し続け、性能は伸び、コストは変動していきます。これらに振り回されずに成果を安定させていくには、スキルの前後での、幅と深さを網羅するハーネスが大切になってきます。
あなたが 作ったスキルの中に、別のモデルで動かすと 結果が変わるもの はありませんか?
いいなと思ったら応援しよう!
 いつも応援していただいている皆さん支えられています。
