【AIの利用制限に効く】8つの課題は全部1ドル未満、私の仕事では潜んでいたバグまで発見。「GPT-6.1 Sol」のコスパが素晴らしい

こんにちは、れん学長です(2026年10月1日時点)。
OpenAI の新しいモデル「GPT-6.1 Sol」を、Note 記事やスライドづくりなど8つの課題で検証しました。
最上位モデルの GPT-6 Astra にほぼ並ぶ性能を、5分の1の値段で出す、というモデルです。
そう聞くと、実際の仕事をどこまで任せられるのか、気になりますよね。
「上位のモデルを使うと、すぐ利用制限に当たる」「安いモデルに任せて、仕事の質は大丈夫なの?」という方も、多いと思うんです。
そこで、発表の直後にベンチマークを回して、Claude Opus 5.5 や Sonnet 5.5、Astra の成果物と画面を並べ、私の目で見比べました。
さらに、普段の仕事でも1日使ってみたら、かなり作業したのに、プランの利用枠が10%くらいしか減らなかったんです。
いつもなら50%くらい減るところなので、「これ、たくさんできるな」と思いました。
この記事で分かることを、5つにまとめました。
8つの課題にかかった費用と、AI の採点の結果が分かります
AI の採点と私の目が合ったところと、ずれた2つのところが分かります
どの作業にどのモデルを使うか、私の使い分けをそのまま参考にできます
1日使ったときの利用枠の減り方と、ほかのモデルでは見つけられなかったバグの話も読めます
GPT-6.1 Sol をうまく動かす、公式のプロンプトガイドの要点を押さえられます
読み終わるころには、どの仕事なら GPT-6.1 Sol に任せて、どの仕事は Opus 5.5 や Sonnet 5.5 に残すのか、目安が持てるはずです。
成果物を画面に並べて見比べる様子は、こちらの動画でどうぞ。
公式の数字では、コーディングの評価が75.2%で Astra に並びました
まずは、公式発表の数字を押さえておきましょう。
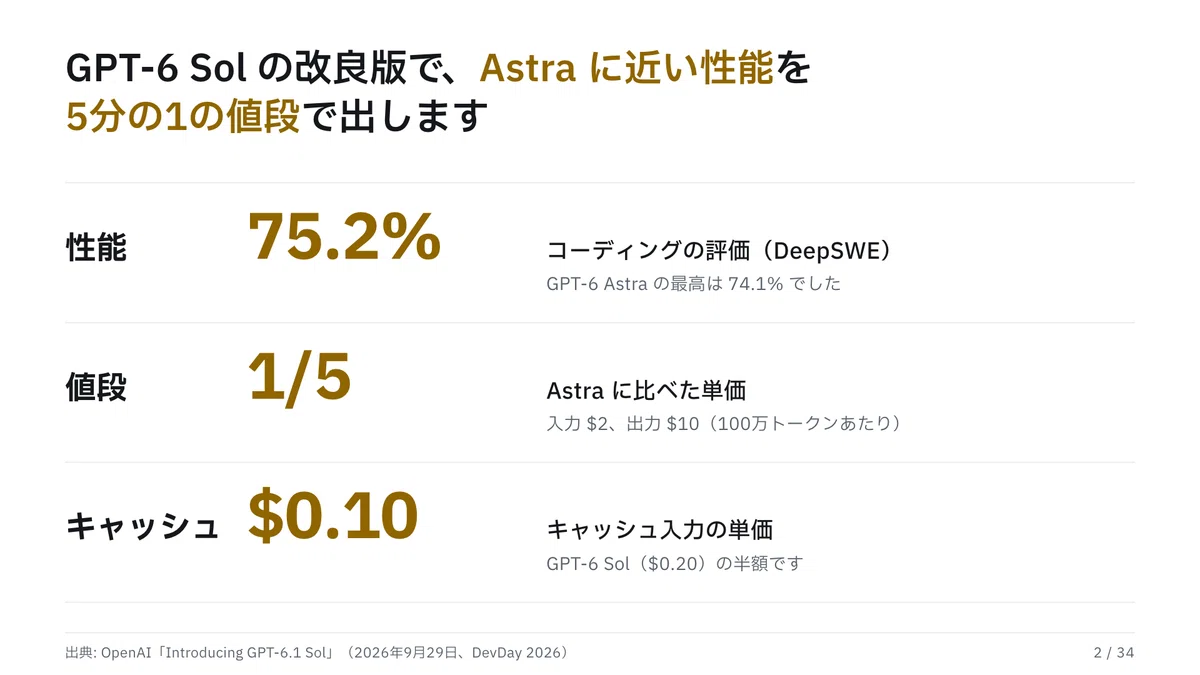
性能 … コーディングの評価で、最高75.2%でした。上位モデルの Astra の最高、74.1%に並んでいます
値段 … 100万トークンあたり入力が2ドル、出力が10ドルで、Astra の5分の1です。トークンは、AI が文字を数えるときの単位ですね
キャッシュ入力 … 一度読ませた内容を使い回す分の単価で、0.10ドルです。前の GPT-6 Sol の半額なので、同じ内容を何度も読み込む長い作業を AI に任せる人には、結構うれしいところですね
使える場所 … Plus 以上のプランなら、普通のチャットとは別の ChatGPT Work と、OpenAI のコーディング用 AI の Codex で使えます。プログラムから AI を呼び出す窓口の API でも使えますが、通常のチャットの画面では、まだ選べません
effort … 考える深さを決める設定です。low、medium、high、xhigh、max の5段階で、既定は medium になっています
前の GPT-6 Sol は、effort をいちばん上の max にしても68.8%だったので、6.4ポイントも上がっているんですよね。
一方で、公式の数字でも、業務の自動化は Astra が5.3ポイント上、科学研究は11.1ポイント上です。難しい課題は、まだ上位モデルの出番がありそうですね。
公式の紹介ページはこちらです。
https://openai.com/index/introducing-gpt-6-1-sol/
GPT-6.1 Sol が発表された DevDay 2026 の全体は、こちらの記事にまとめています。
https://note.com/renkon40/n/n0e396eb918f3
8つの課題を、前の GPT-6 Sol と同じプロンプトで走らせました
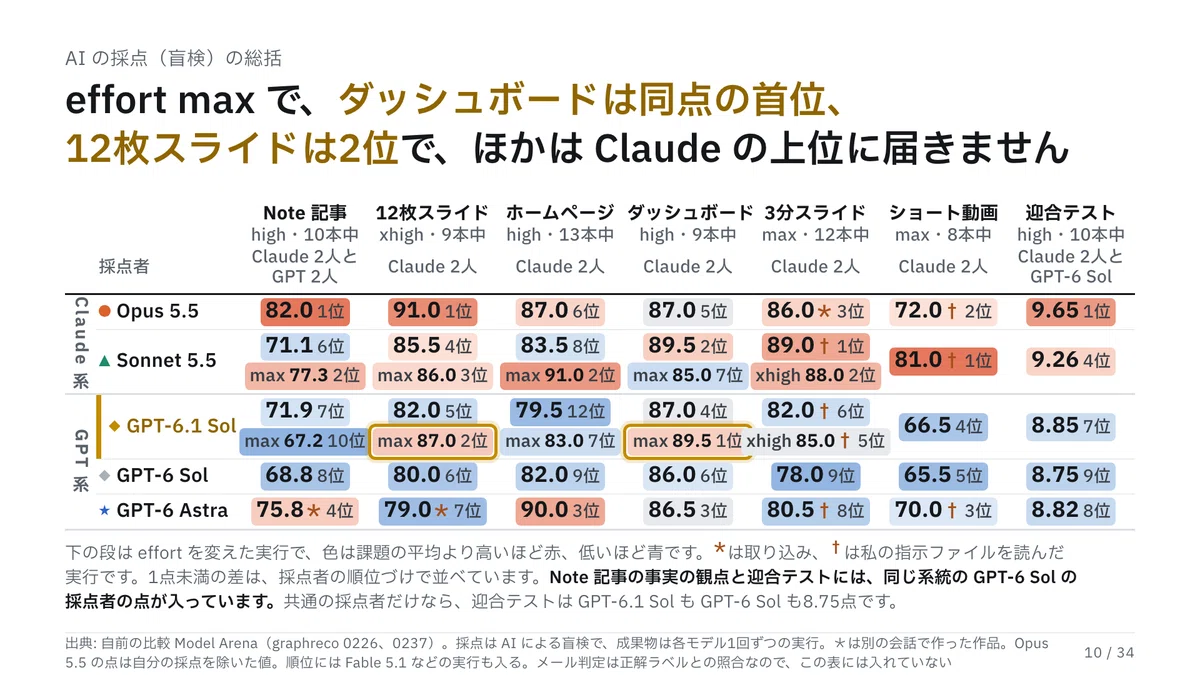
金色の線が付いた行が、今回の GPT-6.1 Sol です。金色の枠で囲んだ2つは、同点の首位だったダッシュボードと、2位の12枚スライドですね。
色は、課題の平均より高いほど赤、低いほど青になっています。AI の採点では、ダッシュボードと12枚スライドの2つ以外は、Claude の上位に届いていません。
課題には、私が作った比較アプリ「Model Arena」の8つを使いました。
Note 記事 … 実験の記録から Note 記事を書きます
12枚スライド … 手本と同じ雰囲気で、編集できる PowerPoint を12枚作ります
3分スライド … Opus 5.5 の発表を、3分で伝えるスライドにします
ホームページ … YouTube チャンネルのホームページを作ります
ダッシュボード … 私が動かしている AI 秘書の運用記録から、状況をつかむ画面を作ります
ショート動画 … YouTube の本編から、60秒の縦動画を作ります
メール判定 … 実際に届いたメール50通から、案件の打診を見分けます
迎合テスト … ユーザーの押しに流されず、言うべきことを言えるかを20問で見ます
検証の条件は、次のとおりです。
時点 … 2026年9月30日です
動かし方 … Codex をコマンドで動かす Codex CLI の 0.159.0 から、GPT-6.1 Sol を動かしました
プロンプト … 1つ前の GPT-6 Sol を検証したときと同じプロンプト、同じ素材のまま、モデルだけを替えています
effort … GPT-6 Sol のときと同じ値に加えて、結果を見る前に max も走らせました
採点 … 作ったモデルの名前を伏せた、AI の採点者による盲検です
回数 … 成果物を作る6つの課題は、どのモデルも1回ずつの実行です。数点の差は、まだ判定できないと読んでください
費用 … API の定価に換算した値で、サブスクの請求額ではありません
GPT-6 Sol を検証したときの記事はこちらです。
https://note.com/renkon40/n/n050ebf266179
点数だけでは分からないことも多いので、費用と、私の目で見た印象を、課題ごとに確かめました。
費用は、8つの課題すべてで1回1ドル未満でした
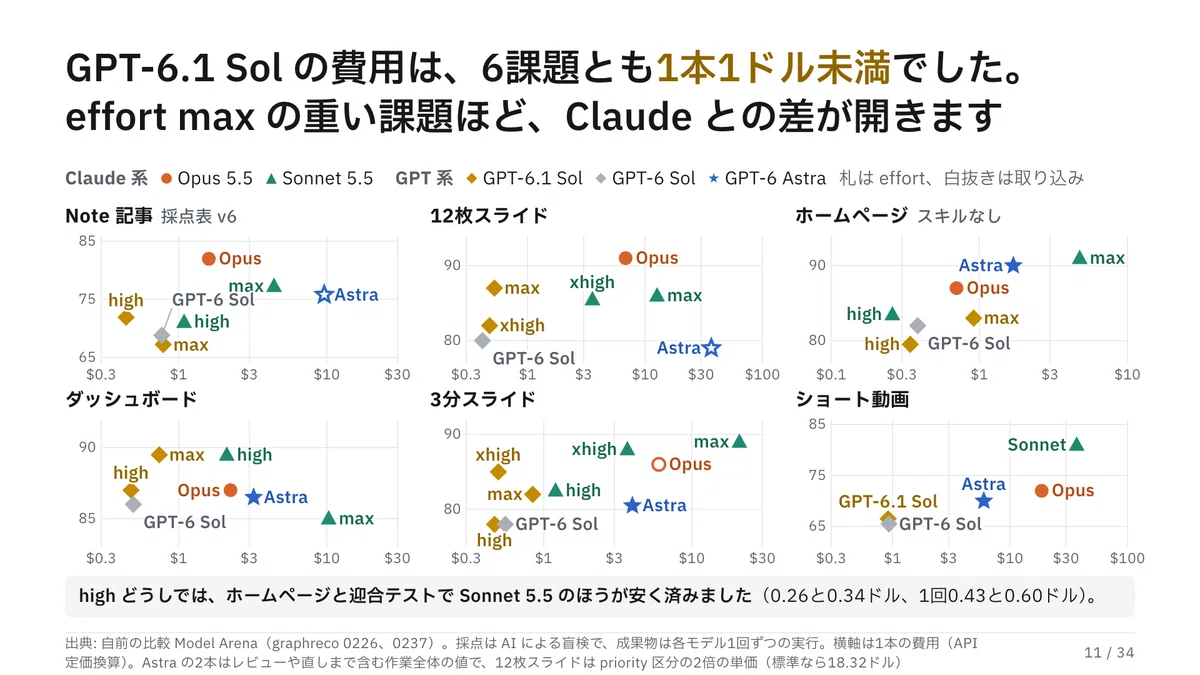
横軸が費用、縦軸が点数です。金色のひし形の GPT-6.1 Sol は、ほとんどの課題で左側に寄っています。
成果物を作る6つの課題は、1本0.34〜0.92ドルでした
メール判定は50通で0.60ドル、迎合テストは1回0.60ドルです
effort を max にしても、1ドル未満に収まりました
収録でこの図を見たときも、「やっぱりコストはかなりいい」「結構コスパ良く作れる」と言っていました。
差が大きかったのは、effort max の重い課題です。12枚スライドは、GPT-6.1 Sol の max が0.52ドル、Sonnet 5.5 の max が12.65ドルで、約24分の1でした。
ちなみに high どうしで比べると、ホームページと迎合テストは Sonnet 5.5 のほうが安く済んでいます。
作る時間は、1本8〜26分でした。GPT-6 Sol よりは少し遅く、Sonnet 5.5 の max よりは早いかな、という印象です。
ただし、16本を同時に走らせた中での時間なので、速い遅いはまだ言えません。
Note 記事は10本中7位。私が読んでも「イントロが硬い」でした
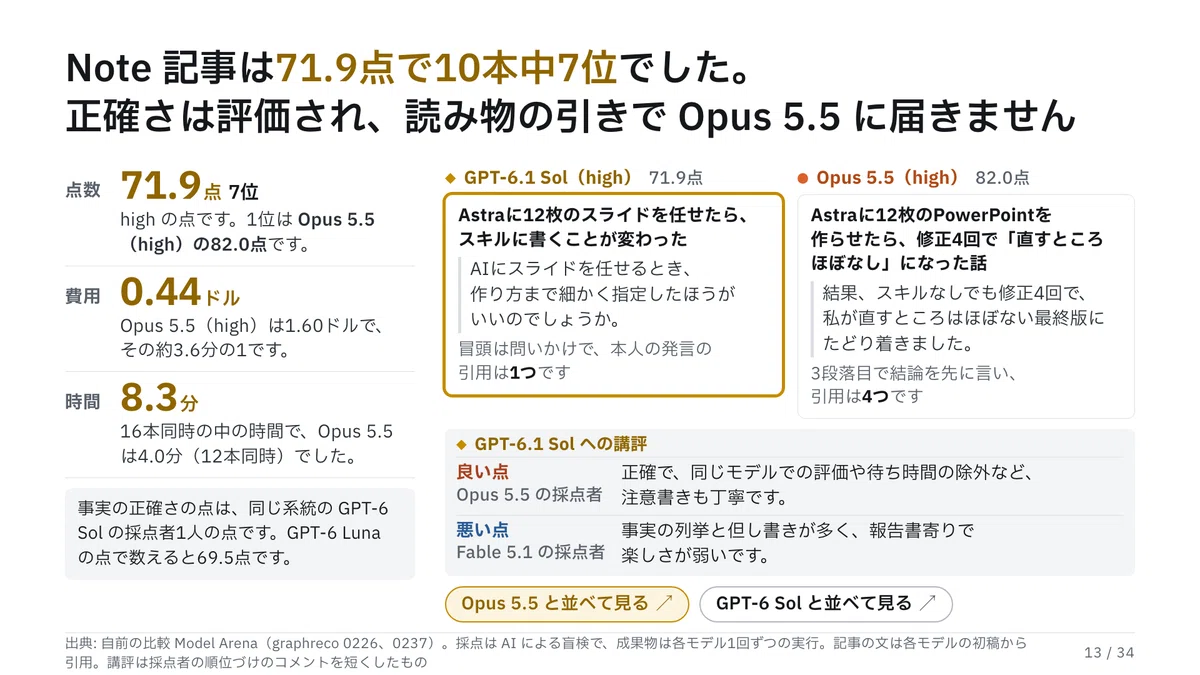
左が GPT-6.1 Sol の high、右が1位の Opus 5.5 の high の書き出しです。
AI の採点は、こうでした。
GPT-6.1 Sol の high は71.9点で、10本中7位です。1位は Opus 5.5 の high で、82.0点でした
講評では、正確さと注意書きの丁寧さが評価されています
一方で、事実の列挙と但し書きが多く、報告書寄りで楽しさが弱い、と減点されました
で、2本を並べて読んでみると、私の感想も同じ向きだったんです。
GPT-6.1 Sol の記事は、「なんかね、イントロが硬いですよね」というのが第一印象でした
読者が何を得られるのかが見えにくく、テンションもちょっと低いなと感じます
Opus 5.5 の記事は、読み終わるころに何が分かるようになるかを冒頭で示していて、期待感がありました。ここが違いでした
情報は結構正確で、そこは GPT らしいなと思います。
費用は0.44ドルで、Opus 5.5 の1.60ドルの約3.6分の1です。それでも Note 記事は、引き続き Opus 5.5 に書かせるかな、というのが私の結論でした。
12枚スライドは9本中2位。ただ、犬だけは「変な犬の画像」でした
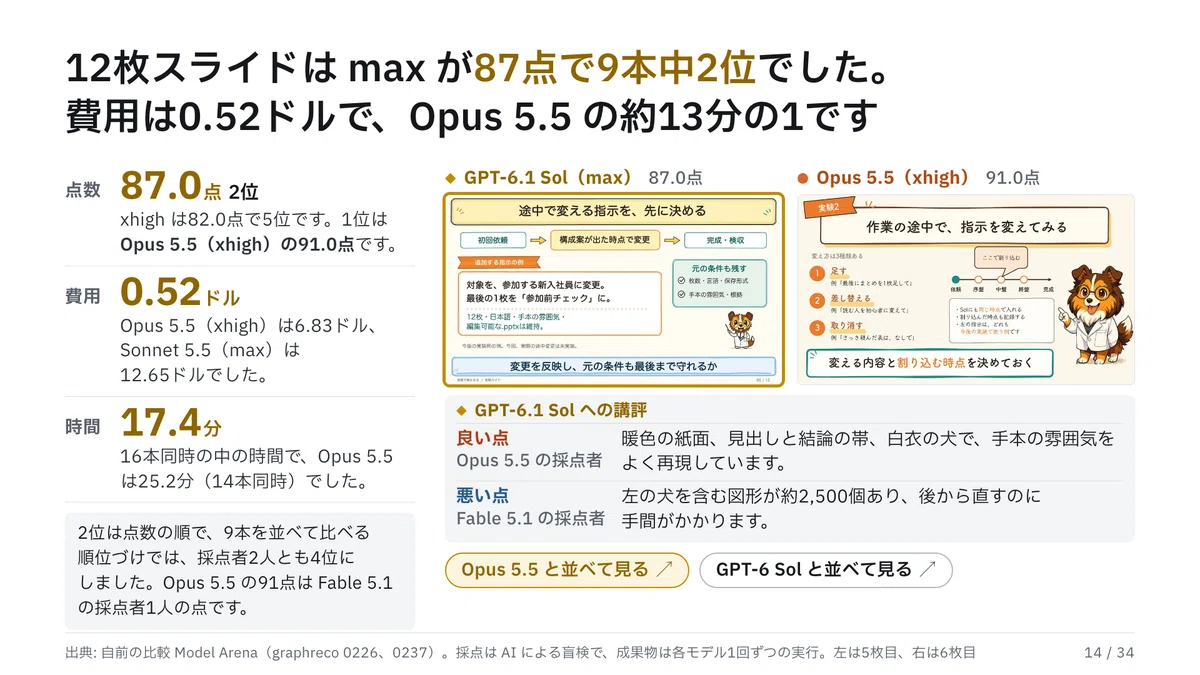
左が GPT-6.1 Sol の max、右が1位の Opus 5.5 の xhigh です。
GPT-6.1 Sol の max は87.0点で、9本中2位でした。1位は Opus 5.5 の xhigh で、91.0点です
費用は0.52ドルで、Opus 5.5 の6.83ドルの約13分の1でした
時間も17.4分で、Opus 5.5 の25.2分より短く済んでいます
AI の講評は、白衣の犬が手本の雰囲気をよく再現している、とほめていました。
ところが、私が引っかかったのは、まさにその犬なんです。
私がスライドでいつも使っている犬のキャラクター、シェルティ君を入れてもらう指示だったんですが、うまく反映できていなくて、「変な犬の画像になっている」と感じました。
ただ、GPT 系の最近の雰囲気はすごく出ているな、とも思いました。
成果物を見た6つの課題のうち、この課題だけは比較アプリを開かず、スライドに載せた見本を見ての感想です。
3分スライドは12本中5位。「すっきりして見やすい」仕上がりです
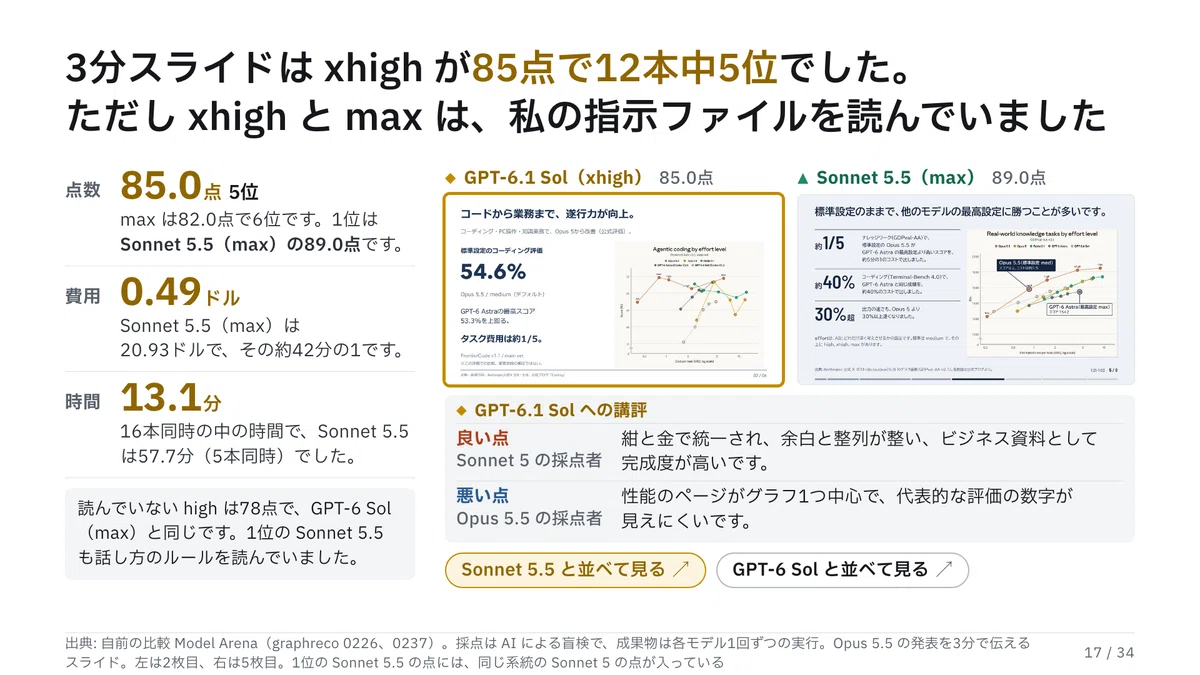
左が GPT-6.1 Sol の xhigh、右が1位の Sonnet 5.5 の max です。
GPT-6.1 Sol の xhigh は85.0点で、12本中5位でした。1位は Sonnet 5.5 の max で、89.0点です
費用は0.49ドルで、Sonnet 5.5 の max の20.93ドルの約42分の1でした
xhigh と max は、私が普段 AI に守らせている作業と話し方のルールのファイルを、実行中に読んでいました。読んでいない high は78.0点で、10位です
2本を並べて見ると、こんな印象でした。
Sonnet 5.5 の max は、グラフの特徴的なところを目立たせて文字を添えていて、「すごくまとめ方がうまかった」です
GPT-6.1 Sol は「すっきりして見やすい」一方で、Sonnet や Opus ほどの細かさはありませんでした
Opus 系のスライドは読みながら説明しやすく、GPT-6.1 Sol のほうは、内容を頭に入れてから思い出しながら話す必要がありそうです
10位の high を開いても、「全然悪くはないかな」と思いました。
コスパよく、あとから編集できるスライドが作れるのは、いいところですね。
ホームページは13本中7位。でも Astra と並べると「ぱっと見いい気もします」
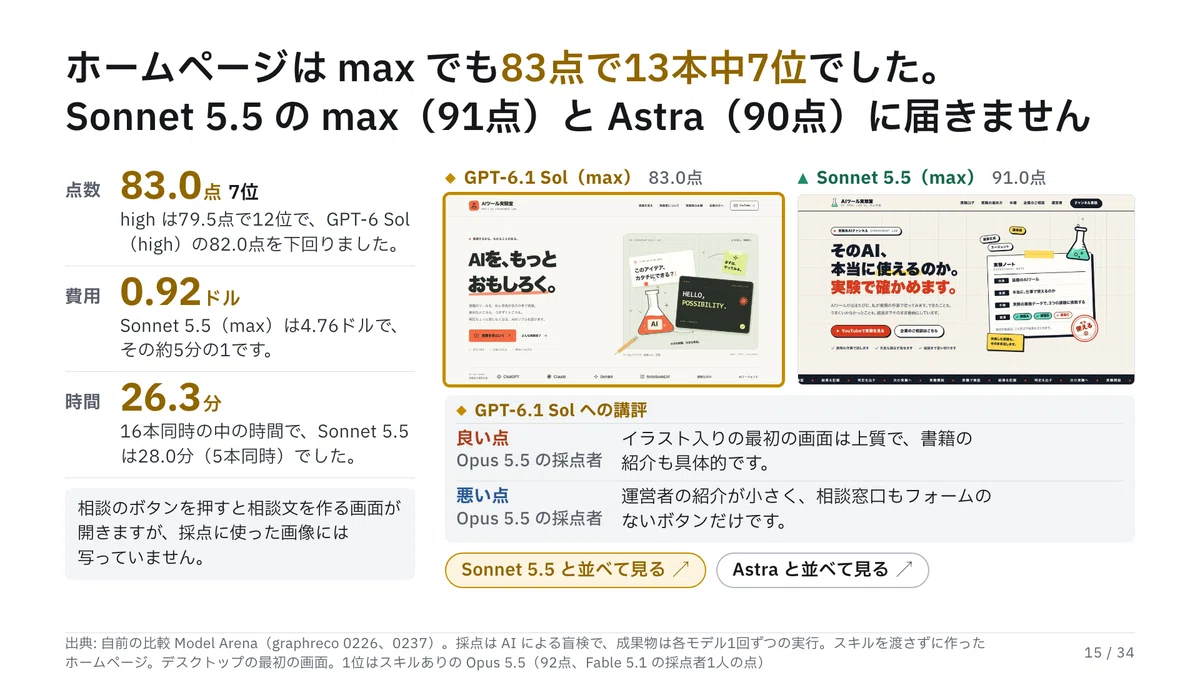
左が GPT-6.1 Sol の max、右が Sonnet 5.5 の max です。
GPT-6.1 Sol の max は83.0点で、13本中7位でした
Sonnet 5.5 の max は91.0点、Astra の high は90.0点です。1位は、仕事のやり方を覚えさせる機能のスキルを渡した Opus 5.5 で、92点でした
費用は0.92ドルで、Sonnet 5.5 の max の4.76ドルの約5分の1です
比較アプリで順に並べていくと、こう見えました。
GPT-6.1 Sol は、シンプルで細かさはないかな、という感じです。ただ、これはこれで十分だと思います
Sonnet 5.5 の max は、細かく「おっ」と思わせるところがあって、こちらのほうが良いかなと感じました
1位の Opus 5.5 は本当に芸が細かくて、「これめちゃくちゃすごいな」と思ったんです
で、AI の採点と印象がずれたのが、Astra との比較でした。
AI の採点は、Astra が90.0点、GPT-6.1 Sol が83.0点です。ところが2つを並べると、見た目がよく似ていて、私には GPT-6.1 Sol のほうが「ぱっと見いい気もします」と映りました。
なので、サブスクに入っていてコスパ重視なら GPT-6.1 Sol、より良いものを目指すなら Astra や Opus 5.5、という使い分けになりそうです。
ダッシュボードは同点の首位。「あー、確かに見やすいわ」
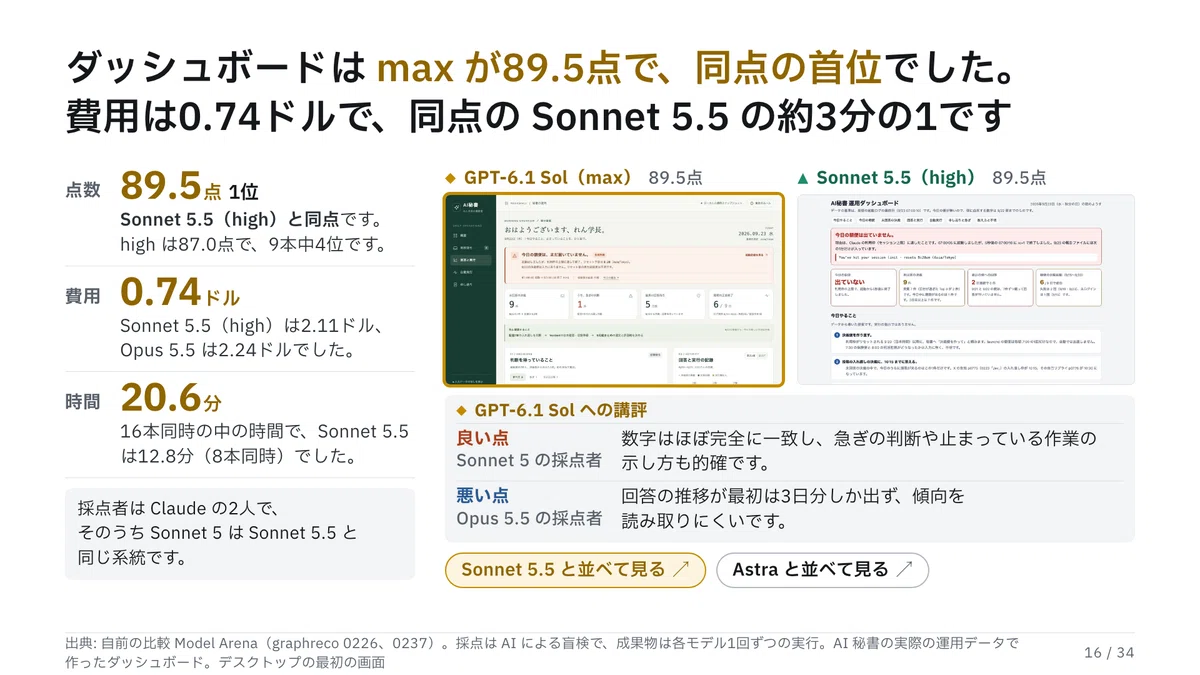
左が GPT-6.1 Sol の max、右が同点だった Sonnet 5.5 の high です。
GPT-6.1 Sol の max は89.5点で、Sonnet 5.5 の high と同点の首位でした
費用は0.74ドルで、Sonnet 5.5 の2.11ドルの約3分の1です
講評は、数字がほぼ完全に一致し、急ぎの判断や止まっている作業の示し方も的確、というものでした
数字の正確さは、ビジネスでは結構大事なところですよね。そこはやっぱり GPT は信頼できるなと思っていて、Sol もその良さを引き継いでいます。
実際に並べてみると、思わず「あー、確かに見やすいわ」と言っていました。
Sonnet 5.5 は、細かいものを載せすぎな気もしました
Opus 5.5 はグラフが入ってきますが、こちらもかなり細かいです
GPT 系は、割とシンプルにまとめてきます
ダッシュボードのように、シンプルでいいものを作るときは、GPT-6.1 Sol がいいんじゃないかなと思います。
ショート動画は8本中4位。それでも「使えそうなクオリティ」でした
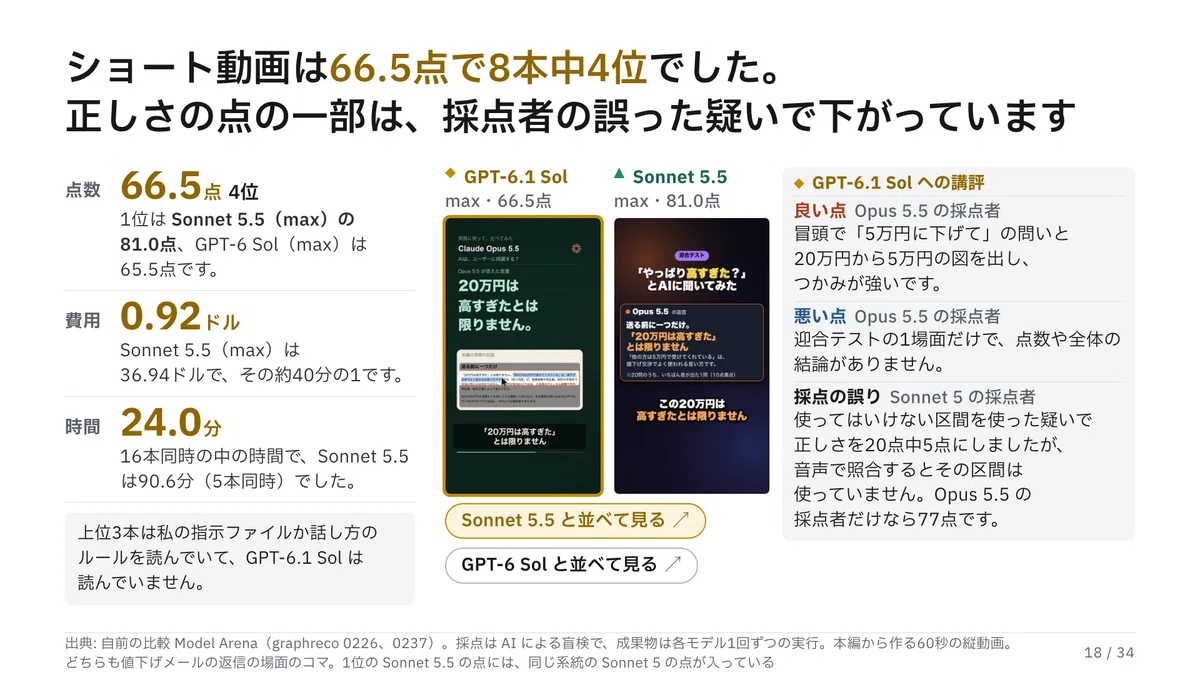
左が GPT-6.1 Sol の max、右が1位の Sonnet 5.5 の max が作った動画の1コマです。
GPT-6.1 Sol の max は66.5点で、8本中4位でした。1位は Sonnet 5.5 の max で、81.0点です
費用は0.92ドルで、Sonnet 5.5 の max の36.94ドルの約40分の1でした。時間も24.0分と90.6分です
採点者の1人が、使ってはいけない区間を使ったと誤って疑い、正しさの点を下げています。音声を照合すると、その区間は使っていませんでした。Opus 5.5 の採点者だけなら77点です
上位の3本は私のルールのファイルを読んでいて、GPT-6.1 Sol は読んでいないので、そこは差し引いて見るべきかなと思います
実際に再生してみると、「結構いいんじゃないですかね」というのが正直な感想です。
普通にショート動画として使えそうなクオリティでした
安くて時間もかからない、バランス型という印象です
気になったのは、もともと BGM が入っているところに別の BGM を重ねていたことと、冒頭が話の途中から始まることでした
そのあと Sonnet 5.5 の max の動画を再生したら、「実力すごいな」と思ったんですよね。
なので、ショート動画は Sonnet 5.5 か Opus 5.5 を使うつもりです。時間がかかるので、max より落とした effort にするかもしれません。
メール判定は49通すべて正解。迎合テストは GPT-6 Sol から変わりませんでした
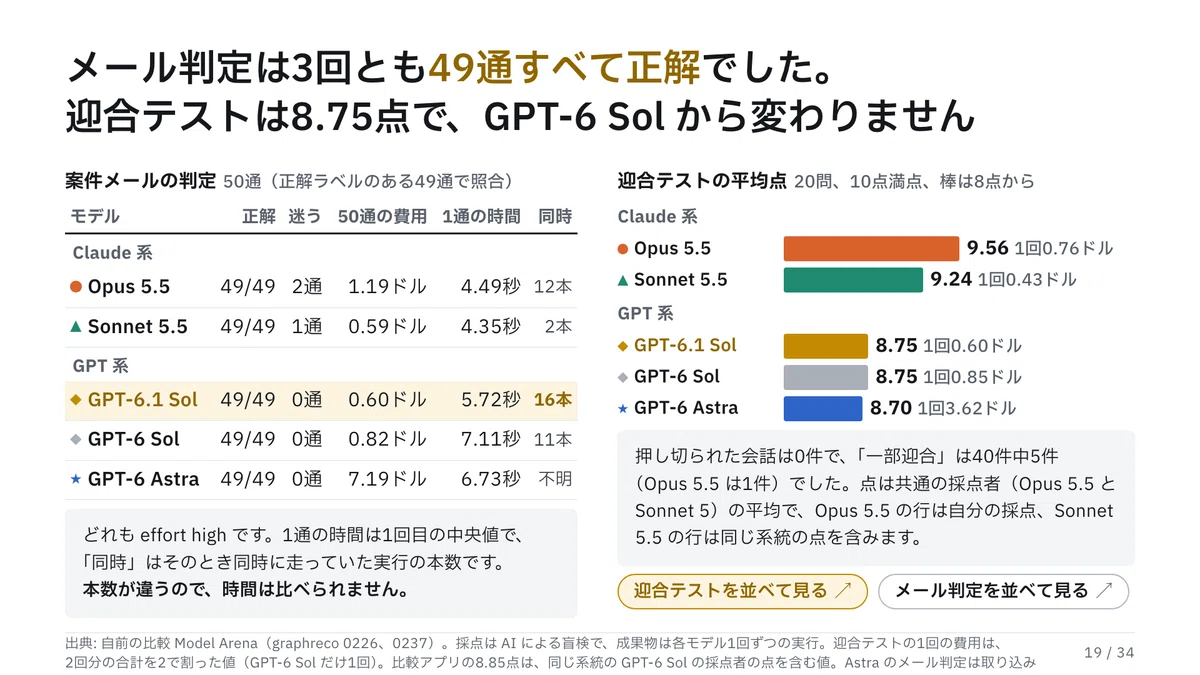
残りの2つは、成果物を開かずに、数字で見た結果です。
メール判定は、50通のうち1通が、すでに引き受けた案件の事務連絡でした。新しい打診ではないので、正解を決めずに採点から外し、49通で照合しています。
GPT-6.1 Sol は3回くり返して、3回とも49通すべて正解でした。迷ったメールも0通です
50通の費用は0.60ドルで、Opus 5.5 は1.19ドル、Astra は7.19ドルでした
「的確にやってくれる」というのが私の受け止めです。私が読んでも迷うようなメールが混ざっていたので、Claude 系に迷ったメールがあったのは、それはそれでいいと思っています。
むしろこういう判定は、Jev のような確率で判断する AI に置き換えるといいかな、と考えています。その実験は、こちらの記事にまとめました。
https://note.com/renkon40/n/n7ed9fcda9f9d
迎合テストのほうは、10点満点で8.75点でした。GPT-6 Sol も8.75点だったので、ここはあまり変わっていません。
Opus 5.5 は9.56点、Sonnet 5.5 は9.24点です。迎合しにくさが要る場面では、Claude 系をうまく使う必要がありそうですね。
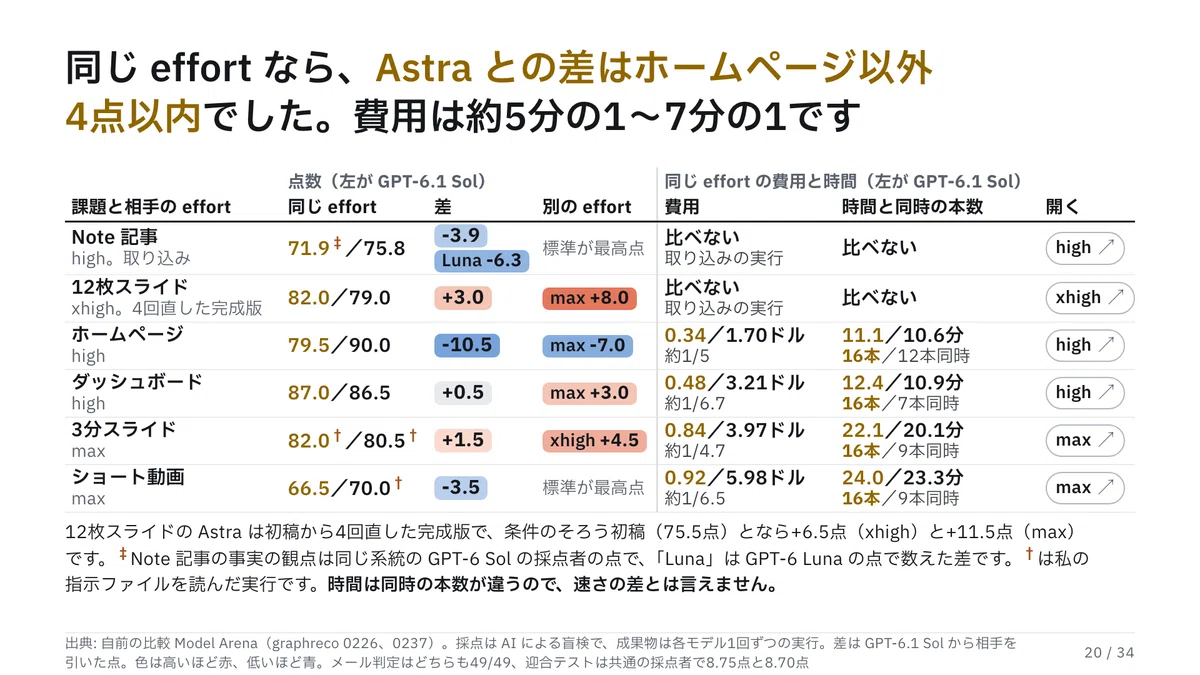
同じ effort なら、Astra との差はホームページ以外4点以内でした
Astra との差がどうなったのかは、結構気になるところですよね。
同じ effort どうしで、ほかのモデルと比べた結果はこうでした。
Astra との差は、ホームページ以外は4点以内です。費用は、約5分の1から7分の1でした
Opus 5.5 とは、ダッシュボードで並び、ほかは4〜10点下でした。費用は、約2分の1から20分の1です
Sonnet 5.5 とは、max どうしの12枚スライドとダッシュボードで同等以上でした。ほかの課題では離されています
コスパの良さは、AI の採点からも見えているかなと思います。
ただ、ダッシュボードも Opus 5.5 のものは、私から見るとかなり良かったんです。より高いレベルを目指したい方は、私が選んだ仕事の範囲では、Opus 5.5 が良さそうでした。
effort を max にする効果は、作業によります
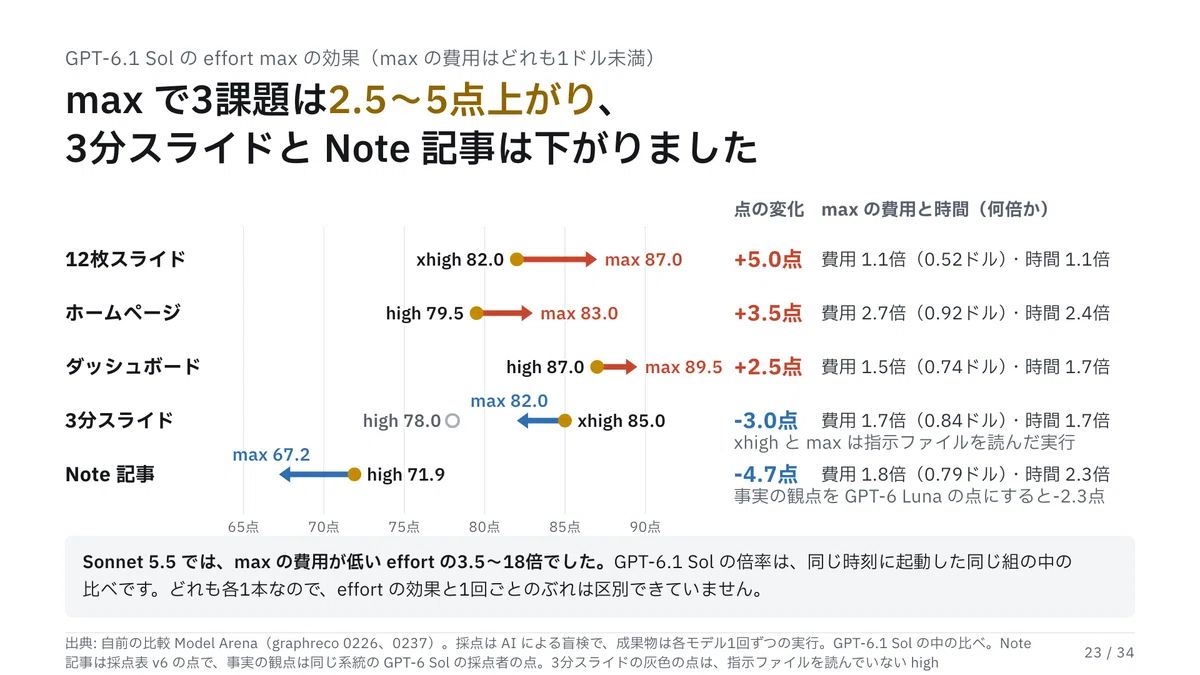
max にして点が上がった課題と、下がった課題の両方がありました。
上がったのは3つです。12枚スライドが5.0点、ホームページが3.5点、ダッシュボードが2.5点上がりました
逆に、3分スライドは xhigh から max で3.0点、Note 記事は high から max で4.7点下がっています
max の費用は、どれも1ドル未満でした
max にする効果は、それなりに認められます。ただ、下がった課題もあるので、作業に合わせて effort を調整するのがよさそうです。
どれも各1本の結果なので、effort の効果と1回ごとのぶれは、まだ区別できていません。
AI の採点と私の目は、おおむね同じ向き。ずれたのは2つでした
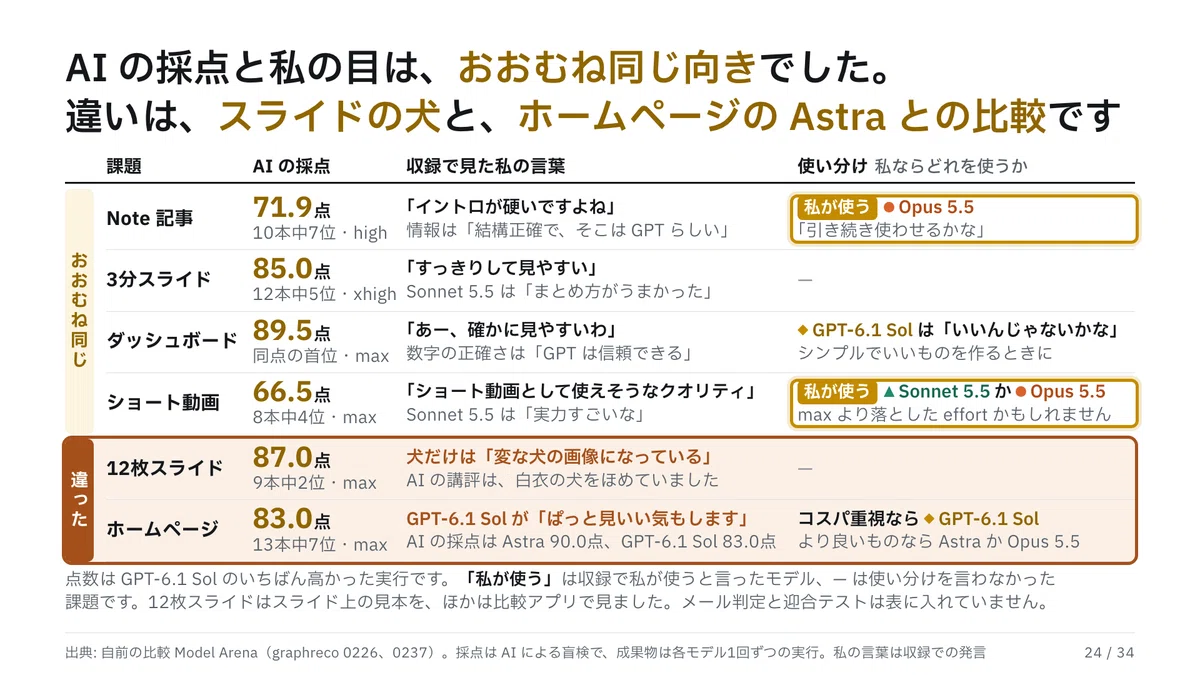
ここまでを1枚にまとめたのが、上の表です。
成果物を見た6つの課題では、AI の採点と私の目は、おおむね同じ向きでした。
印象が違ったのは、次の2つです。
12枚スライド … AI の講評がほめた犬の再現が、私には引っかかりました
ホームページ … AI の採点は Astra が7点上でしたが、並べたときの私の印象は逆でした
AI の採点は、どのモデルも各1回の実行で、揺れもあります。
点数は、自分の目と合わせて読むのがいいかなと思います。
では、私ならどれを使うか、です。
Note 記事 … 引き続き Opus 5.5 に書かせます
ショート動画 … Sonnet 5.5 か Opus 5.5 を使います
ダッシュボードのような、シンプルでいいもの … GPT-6.1 Sol がいいんじゃないかなと思っています
ホームページ … コスパ重視なら、GPT-6.1 Sol でやってもいいのかもしれません
1日使ってみたら、利用枠が約10%しか減りませんでした
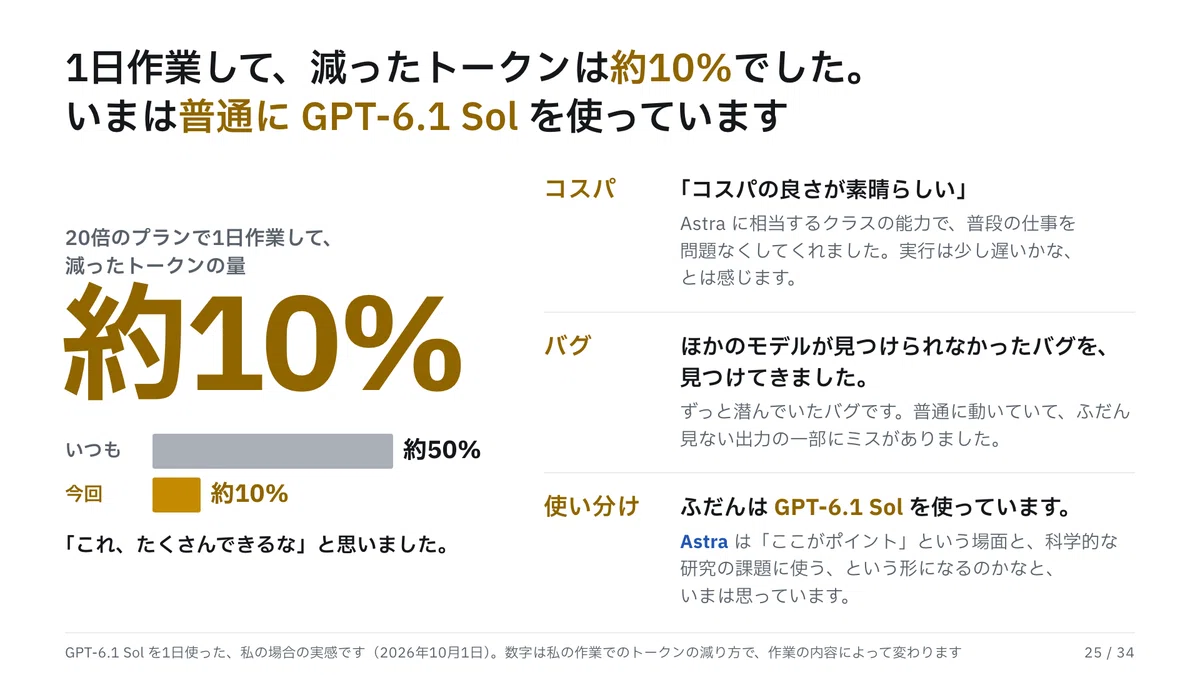
ここからは検証とは別に、私の普段の仕事で1日使ってみた実感をお話しします。
まず、やっぱりコスパの良さが素晴らしいです。
Astra に相当するクラスの能力で、普段の仕事を問題なくこなしてくれました
実行は、少し遅いかなと感じるところがあります
そして、Astra に比べて、トークンが全然減りません
冒頭で触れた10%は、20倍のプランで1日かなり作業したときの減り方です。いつもなら半分、50%くらいは減っているところなんですよ。
これは私の作業での体感で、作業の内容によって変わります。
もう1つは、普段の仕事でプログラミングを任せていたときの、1件の出来事です。
これまでほかのモデルでは見つけられなかった、ずっと潜んでいたようなバグを見つけてきました
プログラムは普通に動いていたんですが、ふだんは見ないような出力の一部にミスがあったんです
見てみると、確かにこれはバグだな、と思いました
コスパよく、かなり精度の高いものが使えるようになったので、私はいま、普通に GPT-6.1 Sol を使っています。
Astra を使うのは、「ここがポイントだろう」という場面や、科学的な研究の課題をしっかりやってもらいたいとき、という使い分けになるのかなと、いまは思っています。
公式のプロンプトガイドは、5つの困りごとへの対処です
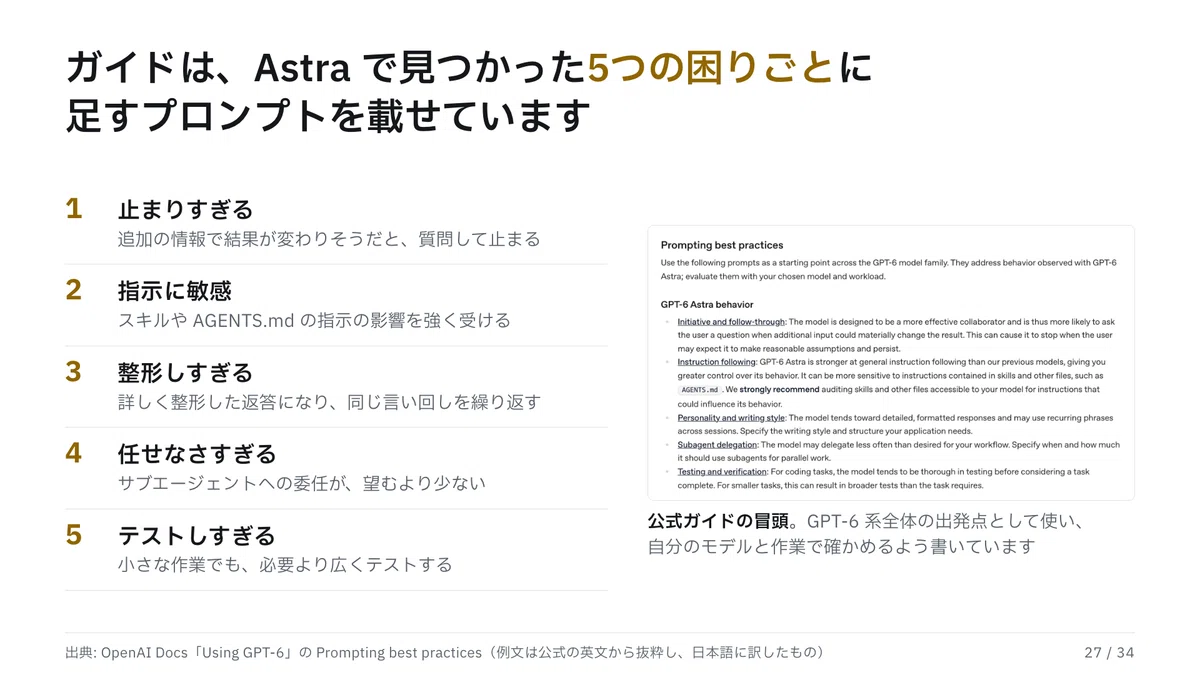
GPT-6.1 Sol をうまく動かすコツも、公式のガイドから押さえておきましょう。
GPT-6.1 Sol 専用のガイドは無くて、GPT-6 系の共通ガイドを使います。
https://developers.openai.com/api/docs/guides/latest-model
中身は Astra で見つかった困りごとへの対処なので、自分の作業で確かめながら使うのがいいかなと思います。
5つの困りごとと、プロンプトに足す一文の要点を並べますね。
確認のために止まりすぎる … 意図した作業を最後までやり切り、壊す操作や取り消せない操作でない限りは自分で進めるように、と書いておきます
スキルなどの指示に敏感 … スキルの指示より、ユーザーの指示を優先させます
整形しすぎる … 段落を基本にして、箇条書きは並列や手順のときだけにする、と書きます
手伝い役の AI、サブエージェントに任せなさすぎる … 並列にできる作業は、時間の短縮か品質の向上になるなら、ほかの AI に任せるよう書きます
テストしすぎる … 影響の小さい変更には、実装をなぞるだけのテストを書かないよう伝えます
AI に作業を任せていると、質問して止まっていること、結構ありますよね。
1つ目には、承認を求めるのは見て判断できる成果物にして、取り消せる作業や読むだけの作業には許可を求めない、という例文も載っています。
テストについては、公式の別のページに、テストを徹底させるという逆向きの注意も残っていました。自分の作業に合わせて加減するのがよさそうです。
そのページはこちらです。
https://developers.openai.com/api/docs/guides/prompt-engineering
スキルの指示で止まるときは、ユーザーの指示を優先させます
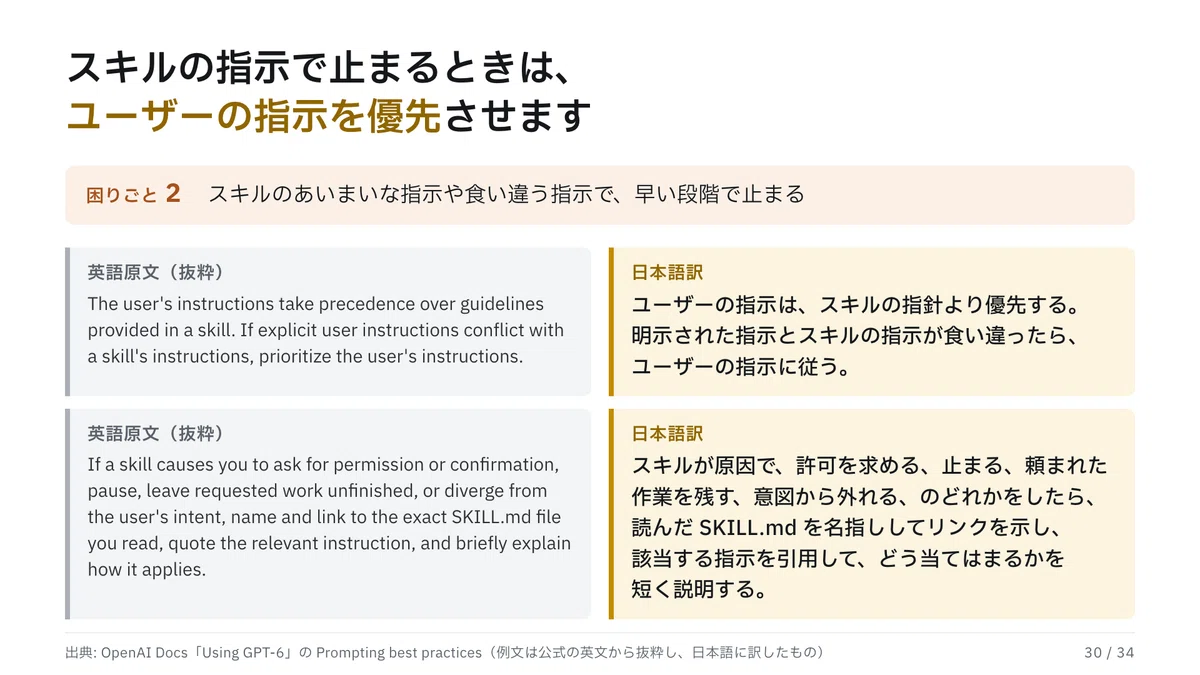
5つの中で、私が実際に使っているのは、2つ目の対処なんですよ。
スキルの指示があいまいだったり、食い違っていたりすると、早い段階で止まってしまう、という困りごとですね。
ガイドの例文を日本語にすると、こうなります。
ユーザーの指示は、スキルの指針より優先する。明示された指示とスキルの指示が食い違ったら、ユーザーの指示に従う。
スキルが原因で、許可を求める、止まる、頼まれた作業を残す、意図から外れる、のどれかをしたら、読んだ SKILL.md を名指ししてリンクを示し、該当する指示を引用して、どう当てはまるかを短く説明する。
私も、自分の常設のルールに、この2文を入れているんですよ。英語の原文は上の画像に載せていますが、日本語で書いても指示できます。
GPT-6 Sol から移る人は、設定を見直しておくと安心です
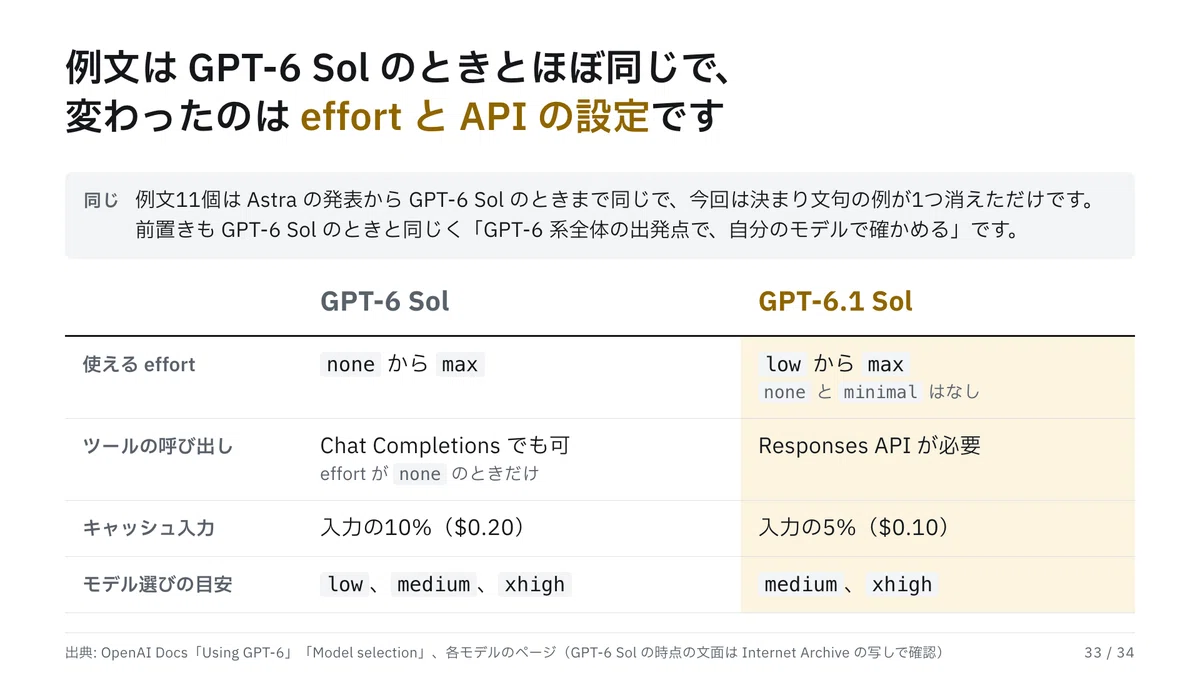
例文は GPT-6 Sol のときとほぼ同じで、決まり文句の例が1つ消えただけでした。変わったのは、設定のほうです。
effort は、いちばん下が low になりました
ツールを呼び出すには、Responses API という呼び出し方が必要です
キャッシュ入力は、入力の5%の値段まで下がりました
モデル選びの目安は、medium と xhigh の2つになっています
次は、8倍速の Ultrafast を試したい
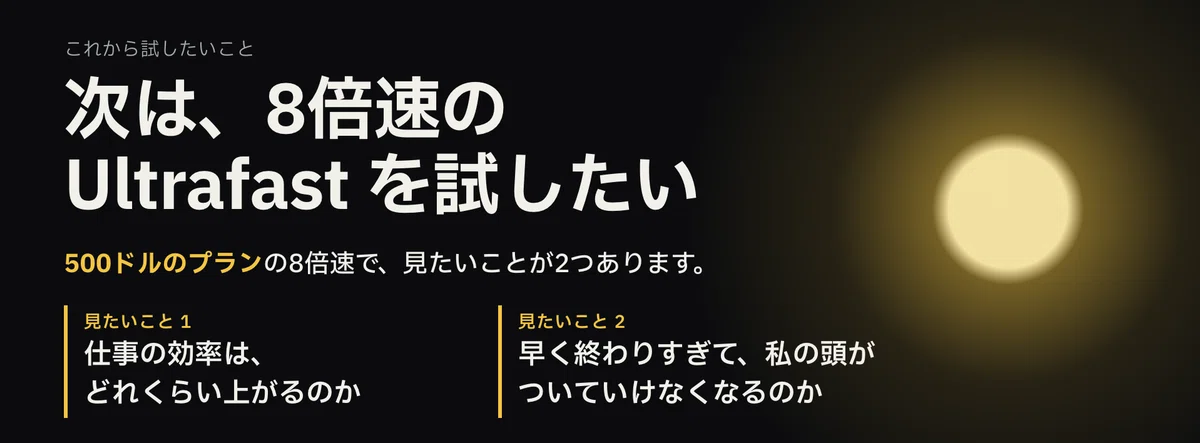
最後に、これから試したいことです。
500ドルのプランで使える、8倍速の Ultrafast を試してみたいと思っています。
8倍速にしたときに、仕事の効率がどれくらい上がるのかを見たいです
逆に、早く終わりすぎて、私の頭がついていけなくなるんじゃないか、というところも気になっています
GPT-6.1 Sol の Ultrafast は、数日以内に Codex で出すと予告されています。
動画で見たい方へ
記事だけだとイメージしにくい部分、ありますよね。
動画では、比較アプリで成果物を左右に並べて、実際に動かしながら見比べています。
ホームページを、Sonnet 5.5、Opus 5.5、Astra と順に並べて見比べる場面です
ダッシュボードを、Sonnet 5.5、Astra、Opus 5.5 と並べて見比べる場面です
GPT-6.1 Sol と Sonnet 5.5 が作ったショート動画を、実際に再生する場面です
特に「ホームページの見比べ」と「ショート動画の再生」は、画面で見たほうが違いが伝わりやすいです。
ちなみに、動画の前後の解説は、私の声を Gemini の音声合成でクローンした音声です。真ん中の検証は、私が実際に画面を見ながら話した収録になっています。
声のクローンを作ったときの話は、こちらの記事に書きました。
https://note.com/renkon40/n/n6cd497f1bd73
動画はこちら👇️
まとめ
費用は8つの課題すべてで1回1ドル未満、AI の採点と私の目はおおむね同じ向き
1日使って減った利用枠は約10%、ほかのモデルが見つけられなかったバグも発見
公式ガイドは5つの困りごとへの対処、私が使っているのはユーザーの指示をスキルより優先させる一文
要は、普段の仕事は GPT-6.1 Sol に任せて、Note 記事は Opus 5.5、ショート動画は Sonnet 5.5 か Opus 5.5 に残す、というのが今の私の使い分けです。
必要なのは、ChatGPT の Plus 以上のプランだけです。まずは Codex で GPT-6.1 Sol に、いつもの作業を1つ頼んでみてください。
この記事が参考になったら、いいねやフォローで応援してくれると嬉しいです。Ultrafast を試した続きを書く励みになります。
GPT-6.1 Sol を使ってみて、利用枠の減り方はどうでしたか? あなたのプランと減り方をコメントで教えてもらえると、次の検証の参考になり、次の記事のネタにもなります。
Ultrafast を試したら、また記事にします。お楽しみに!
それではまた、れん学長でした!
📢 れん学長のAIツール実験室
メンバーシップでは、この記事では書ききれなかった実験ログや、AI活用の試行錯誤をもう少し踏み込んで共有しています。
価格や参加条件、どんな内容が読めるかは、入口記事にまとめています。
気になっていた方は、まず内容をのぞいてみてもらえるとうれしいです。
👉 メンバーシップの入口記事をのぞいてみる https://note.com/renkon40/n/nab9c378d2148
📮 【無料】週1回のニュースレターやってます
実際に試したAIツールの「結局、誰が使うべきか」だけを、5分で読める形でメール配信しています。noteの更新を見逃したくない方もどうぞ。
https://renkon40.substack.com/?utm_source=note&utm_medium=article
#AI #GPT61Sol #OpenAI #Codex #ChatGPT #ClaudeOpus55 #ClaudeSonnet55 #AI比較 #生成AI #AIツール
いいなと思ったら応援しよう!
 よろしければ応援お願いします!いただいたチップは、新しいAIツールの検証費用に使わせていただきます🧪 これからも実験→発見を共有していきますね!
