【出力は無料】文章を書かないAI「Jev」とは?0.1秒で判断だけ返す新型モデルを、公式ベンチマークとXの実測で整理しました

こんにちは、れん学長です(2026年9月20日時点)。
「Jevはぶっ飛んでる」「出力トークンは永久無料」「構造上ハルシネーションが起きない」。ここ数日、あなたのXのタイムラインも、こんな投稿でいっぱいじゃないですか?
私も気になって、気づいたらブックマークが9件たまっていました。
「ChatGPTやClaudeと何が違うの?」と思った方も多いと思います。
で、AIと一緒に一次情報から調べてみたら、これはChatGPTの仲間ではありませんでした。文章を一切書かないAIだったんです。
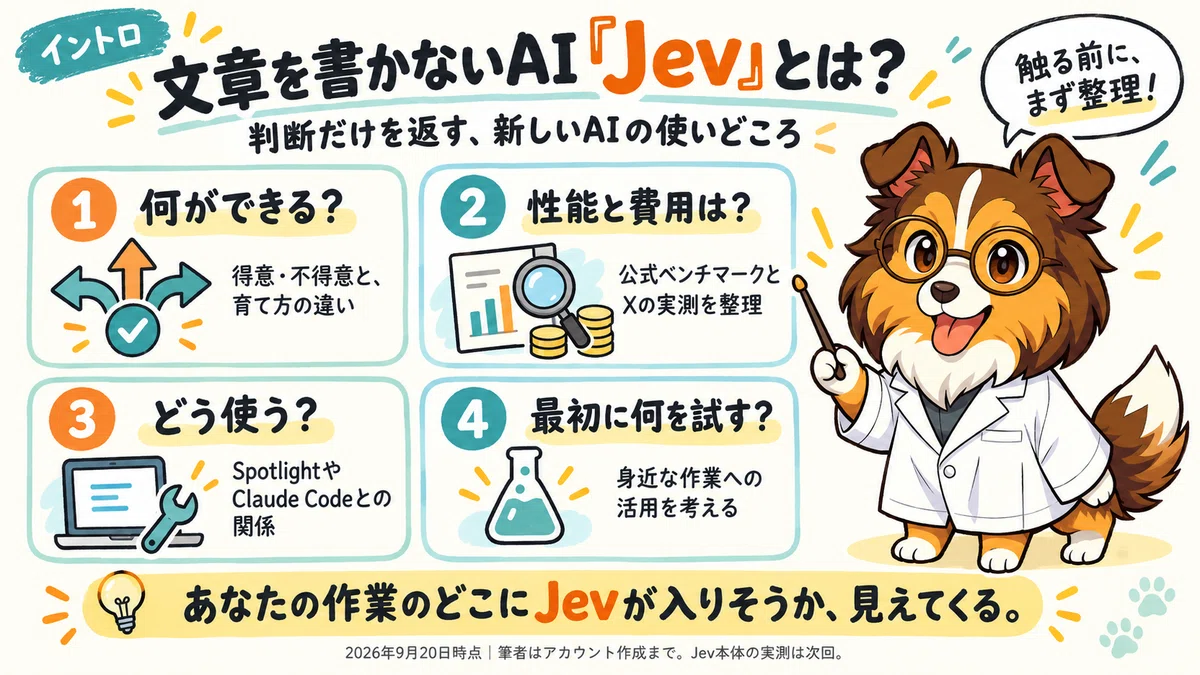
この記事で分かることは、この4つです。
Jevが何で、何ができて、何ができないか。そして、ChatGPTたちと育て方がどう違うかが分かります。
公式の性能テスト、いわゆるベンチマークの精度と費用と、Xで流れてきた実測の数字を、まとめて見られます。
「MacのSpotlightより良いの?」「作るときはClaude Code?」という、私が実際に引っかかった疑問の答えが分かります。
私が最初に試そうと思っていることを共有します。
先にお伝えしておくと、私はまだJevそのものには触れていません。順番待ちに登録して、「アカウントの準備ができました」というメールが届き、アカウントを作ったところです。実際に動かした結果は次の記事で報告します。今回は「触る前に、ここまで分かった」というまとめです。
読み終わる頃には、あなたの作業のどこにJevが入りそうか、具体的に思い浮かぶと思います。
Jevは「文章を書かないAI」です
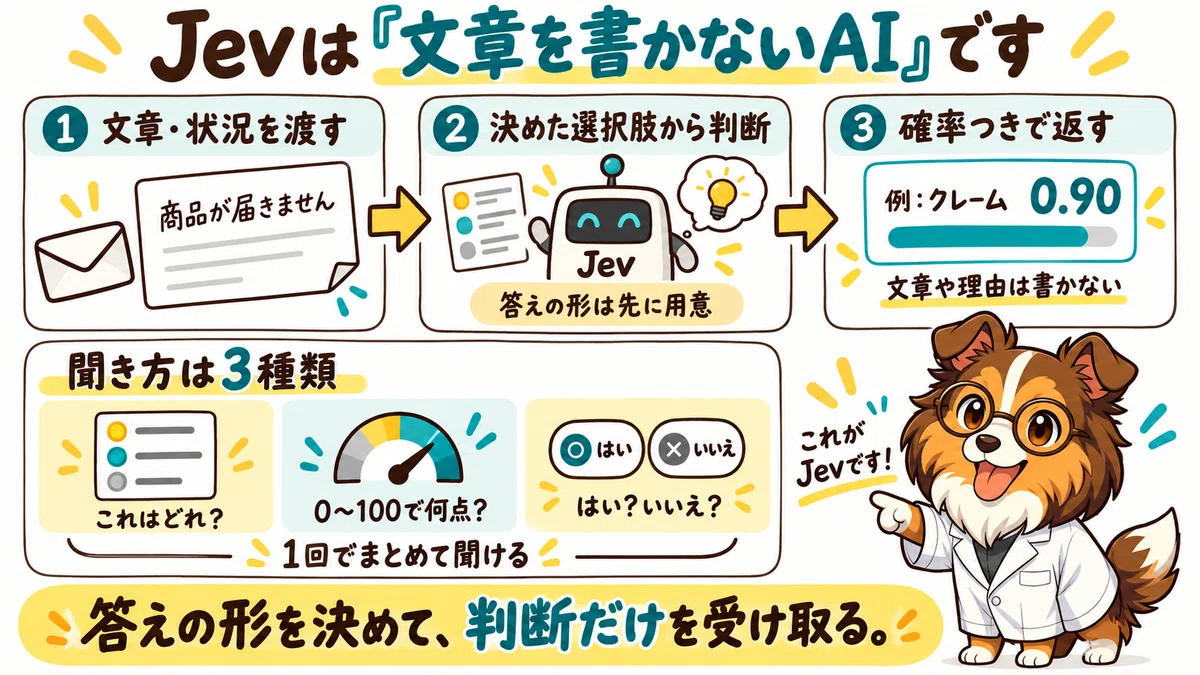
ひとことで言うと、Jevは「渡した文章や状況を読んで、こちらが先に決めた型の答えを、確率つきで即答するAI」です。
たとえるなら、書類を渡すと「これはクレームです、確率0.9」とだけ即答して、理由は語らない仕分け係ですね。速くて、安くて、疲れません。そのかわり、答えの形はこちらが先に決めておく必要があります。
ChatGPTやClaudeのように文章を書くAIは、LLM(Large Language Model、大規模言語モデル)と呼ばれます。Jevは、この仲間には入りません。
Jevを作ったのは、ChatGPTの土台になった技術の研究に関わった元OpenAI研究者、Diogo Almeidaさんが創業したTypeSafe AIという会社です。2026年9月15日に、早期アクセスとして公開されました。
ちなみにJevという名前は、何かの略ではありません。19世紀の経済学者William Stanley Jevonsさんから取ったものだと、公式が説明しています。蒸気機関の効率が上がったら石炭の消費がかえって増えた、という「ジェボンズのパラドックス」で知られる人で、AIも安く速くなるほど使われる量が増える、という見立てが名前に込められています。
話を戻して、Jevに聞けるのは3種類だけです。
「これはどれ?」と、選択肢から選ばせる質問です。
「0〜100で何点?」と、点数をつけさせる質問です。
「はい?いいえ?」と、確率で答えさせる質問です。
この3種類は、1回の問い合わせに何問でも混ぜて入れられます。1問だけでもかまいません。公式は「関係ありそうな質問はまとめて先に全部聞いておき、使う答えだけコードで拾え」と勧めていて、質問を増やしても答えが返る時間はほぼ変わらないそうです。
答えは必ず、こちらが先に決めた型で返ってきます。報道で紹介されていた例だと、カスタマーサポートの振り分けで「技術サポート 0.85、請求 0.08、営業 0.07」のような確率つきの答えになります。
公式の言い方だと、これが「賢いif文」です。プログラムの「もし〜なら、こうする」の「もし〜なら」の部分を、決め打ちのルールの代わりにAIの判断で書ける、というイメージです。エンジニアの方にはこの一言がいちばん早いかもしれません。
公式が出している数字と料金
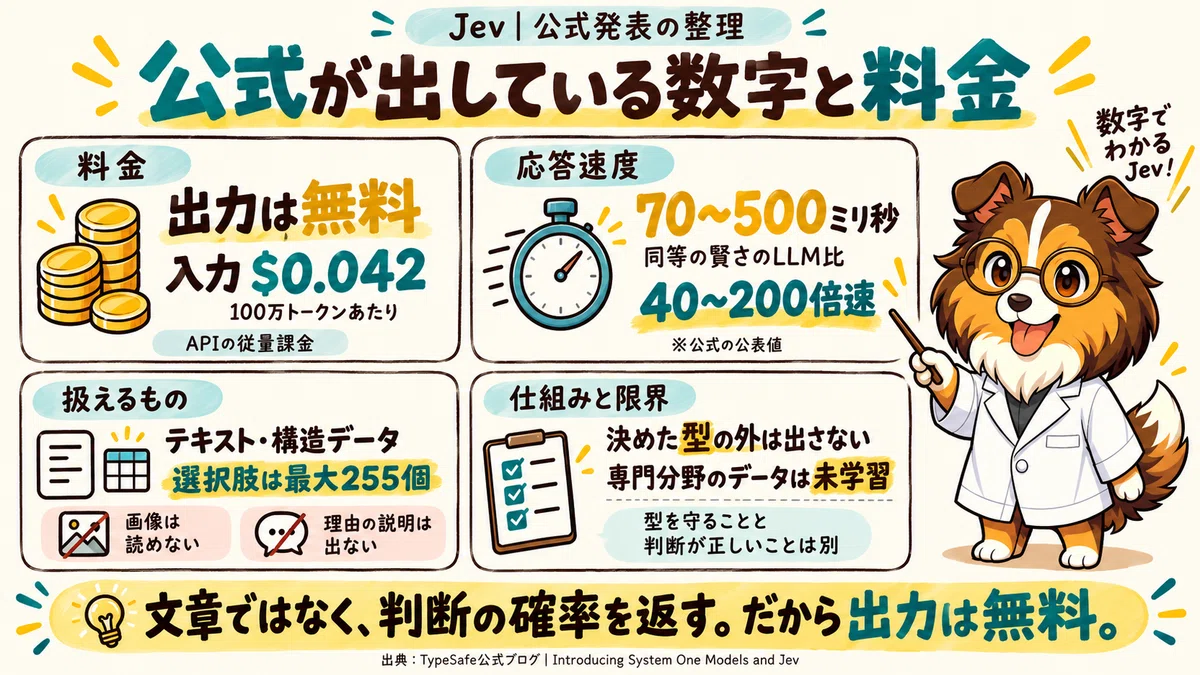
公式が出している数字を並べておきますね。
料金は、AIが文章を数える単位であるトークンで決まっていて、入力100万トークンあたり0.042ドル、出力は無料です。
応答は70〜500ミリ秒で、同じくらいの賢さのLLMより40〜200倍速いとしています。
画像は読めません。テキストと、表やリストのように形の決まった構造データだけです。
選択肢は最大255個までです。
「なぜそう判断したか」の説明文は出ません。
決めた型の外側を出せない作りなので、「ハルシネーションできない」と公式はうたっています。
専門分野のデータでは学習していない、と公式が限界に挙げています。
出力が無料なのは、返すのが確率の数字だけで、量がごくわずかだからです。公式が「安すぎて課金の計測ができない」と書いているくらいなんですよね。
ちなみに料金は、プログラムからインターネット越しに問い合わせを送る窓口、いわゆるAPIの従量課金だけです。公式サイトに料金ページはなく、月額プランも見当たりませんでした。早期アクセスで作ったアカウントには5ドル分のクレジットが付くようで、私のアカウントにも作った直後の残高に5.00ドルと表示されていました。
公式の発表はこちらです。
「System One」という名前と、育て方の違い
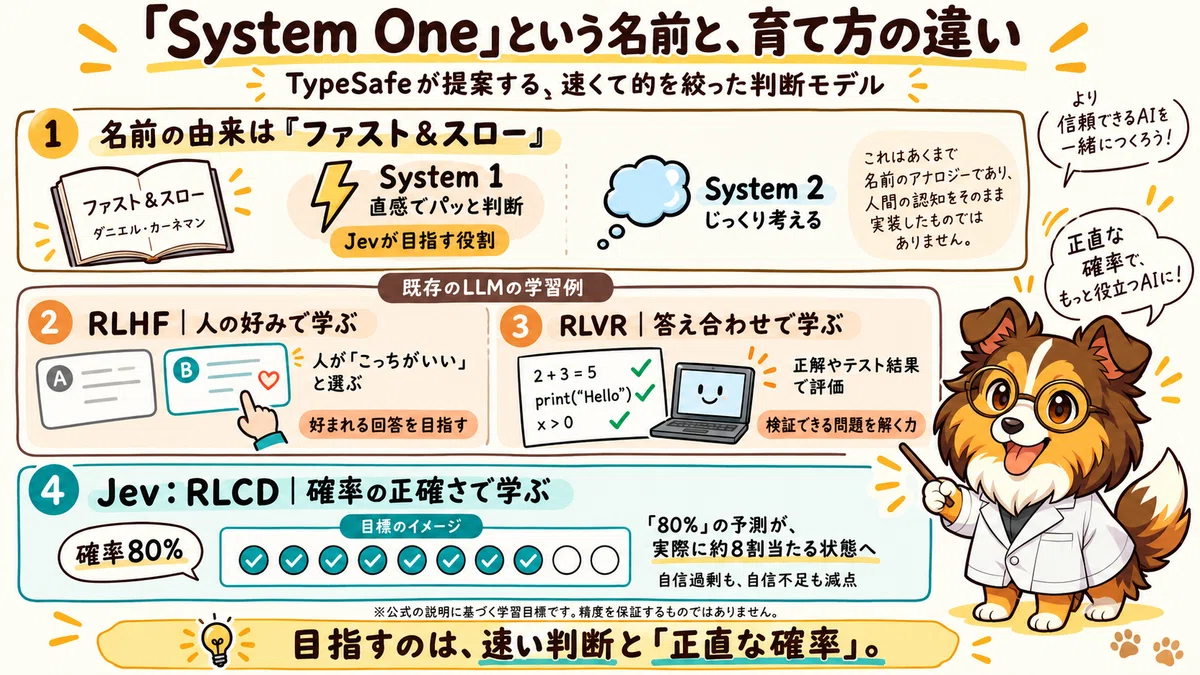
TypeSafeは、JevをLLMとは別の種類のモデルだとして「System One Model」と呼んでいます。
この名前は、心理学者のDaniel Kahnemanさんの本「ファスト&スロー」から来ていると公式が説明しています。人の頭には、直感でパッと答える速い思考のSystem 1と、じっくり考える遅い思考のSystem 2がある、という有名な区分ですね。Jevは前者の「速くて、的を絞った判断」だけを担当する、という宣言です。
公式も「System 1 思考には間違えやすいという含みがある」と認めたうえで、「System One Modelはむしろ信頼できるものにできると考えている」と書いています。
で、その根拠が育て方の違いなんですよね。公式の比較表を、私なりに噛み砕くとこうなります。
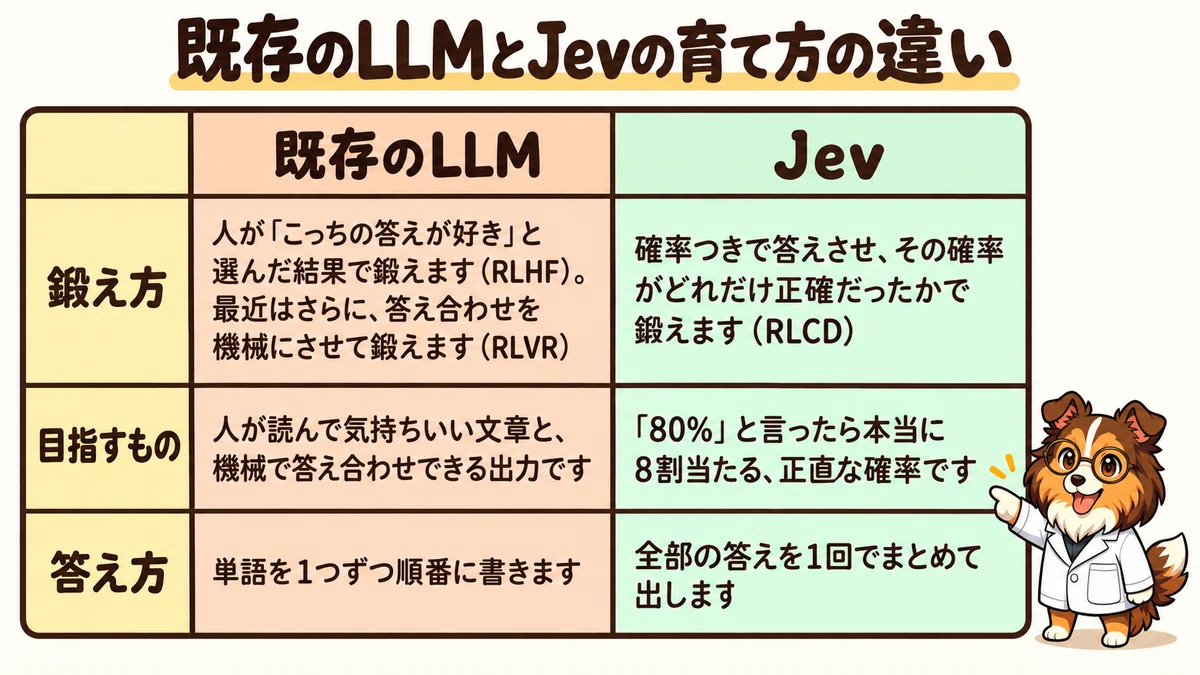
表の鍛え方の欄にある3つの略語だけ、説明しておきますね。
RLHFは、AIが出した答えを人が2つ並べて見比べ、「こっちのほうがいい」と選んだ結果を積み重ねて鍛える方法です。ChatGPTが感じのいい文章を書けるのは、この鍛え方のおかげだと言われています。Reinforcement Learning from Human Feedback、人間のフィードバックによる強化学習の略です。
RLVRは、数学の答え合わせやプログラムのテストのように、正解かどうかを機械が自動で判定できる問題をたくさん解かせて、当たったら褒めるやり方です。人が見なくていいので大量に回せて、最近のAIの「考える力」はこれで伸びたと言われています。Reinforcement Learning with Verifiable Rewards、検証できる報酬による強化学習の略です。
RLCDは、Jevのための新しい鍛え方です。「これはクレーム、確率0.8」のように確率つきで答えさせ、その確率が結果と合っていたかで褒めたり叱ったりします。自信過剰でも自信なさすぎでも減点される設計だと理解しています。Reinforcement Learning for Calibrated Decisions、較正された判断のための強化学習の略です。
大事なのは、Jevが「当たる確率を正直に言う」方向に鍛えられている、という一点です。人が好む答えを目指す鍛え方とは、ここが違います。だから返ってきた確率を、そのまま「どれくらい信じていいか」の目安に使えるんですよね。
速さの正体は表の3行目です。文章を書くAIは1単語ずつ順番に書きますが、Jevは全部の答えを1回で出します。
公式ベンチマークで見る、精度と費用
「安くて速いのは分かった。で、どれくらい賢いの?」が気になりますよね。公式が出しているグラフが2枚あります。
精度と費用のグラフ
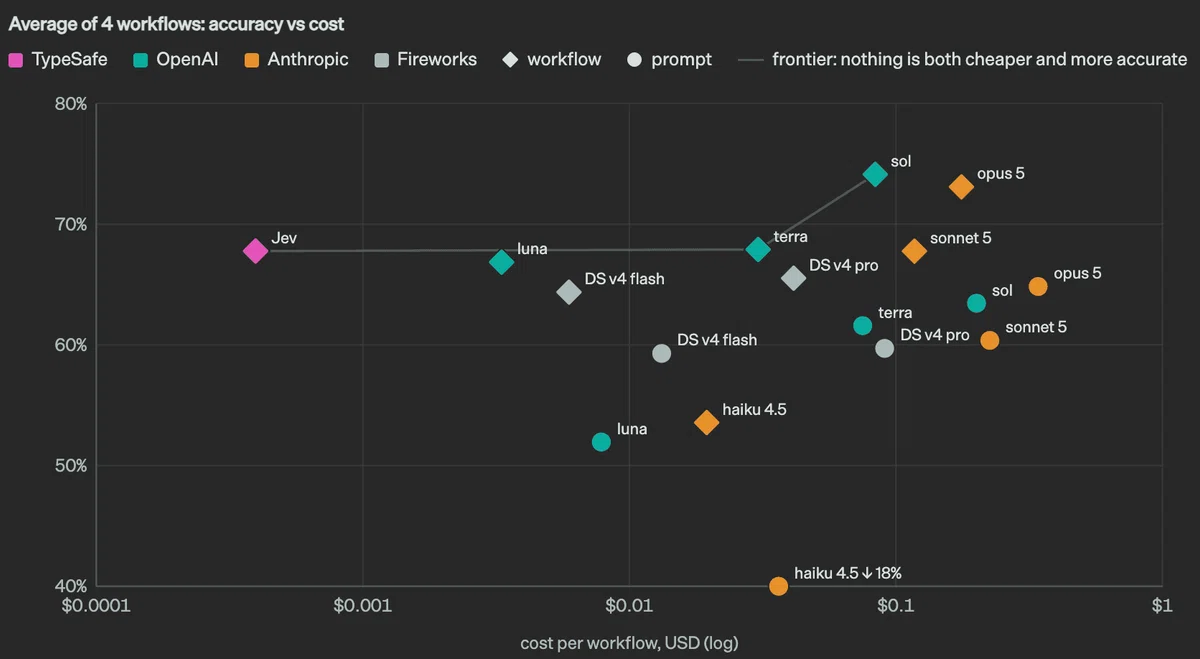
縦が精度、横が1件あたりの費用で、右へ行くほど高くなります。
左上にあるほど「安くて賢い」です。
ここでの精度は、いちばん賢いモデルのGPT-6 AstraとClaude Fable 5.1の平均判断にどれだけ一致したか、で測っています。人が付けた正解と比べたものではありません。公式の数字を転載した解説記事の表によると、こうなっています。
https://www.datacamp.com/blog/system-one-models-jev
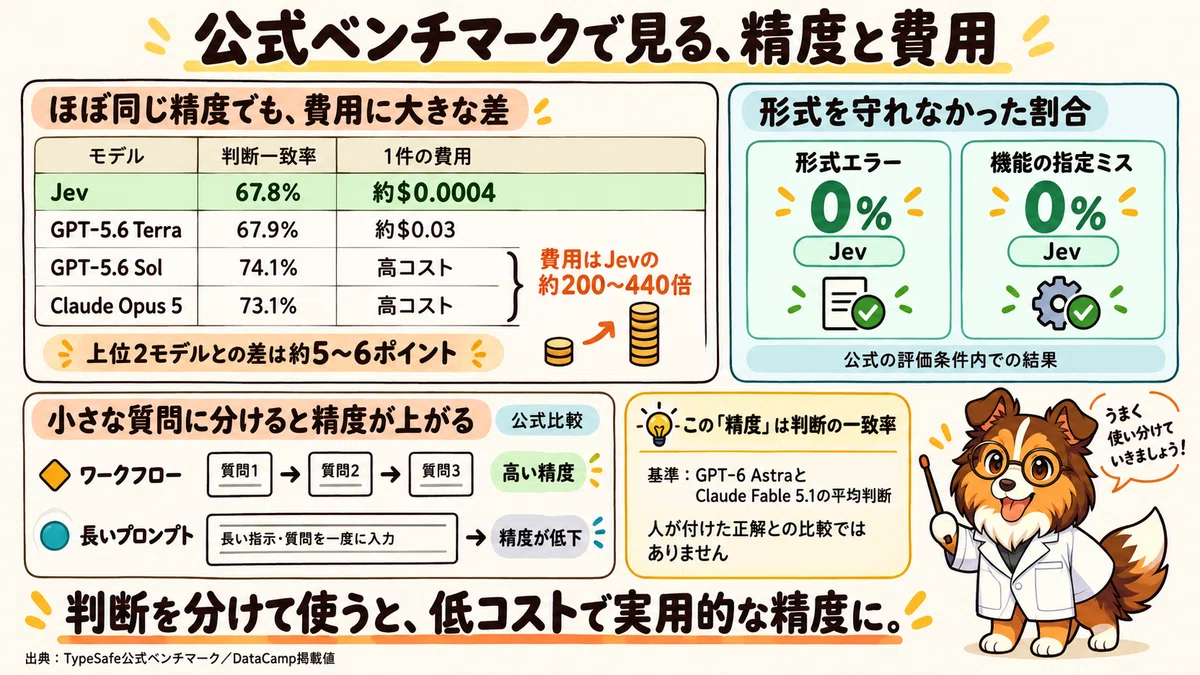
Jevは1件あたり約0.0004ドルで、精度は67.8%です。
OpenAIのGPT-5.6 Terraは約0.03ドルで67.9%と、Jevとほぼ同じ精度で費用は約80倍です。
精度で上回るのは、GPT-5.6 Solの74.1%とClaude Opus 5の73.1%で、費用はJevの200〜440倍です。
つまり、比較に並んだ中で精度が高いGPT-5.6 SolとClaude Opus 5には5〜6ポイント届かないけれど、費用は数百分の1、というのが公式の主張です。最上位のGPT-6 AstraとClaude Fable 5.1は採点の物差し側なので、グラフには載っていません。Jevとの差は、この2つが相手ならもっと開くと思っておいたほうがいいですね。
もう一つ面白いのが、ひし形と丸の違いです。グラフの凡例にあるとおり、ひし形が「workflow(ワークフロー)」、丸が「prompt(プロンプト)」です。
ワークフローは、課題を小さな質問に割って、コードが順番にモデルへ聞いていくやり方です。
プロンプトは、同じ課題を1つの長い指示にまとめて、モデルに丸ごと考えさせるやり方です。
公式の説明では、どのモデルもワークフローのほうが精度が高く、プロンプトで丸投げすると大きく落ちるとしています。グラフでも、同じモデルの丸はひし形より必ず下にあります。Jevの使い方そのものが、このワークフロー型なんですよね。
決めた形式を守れなかった割合
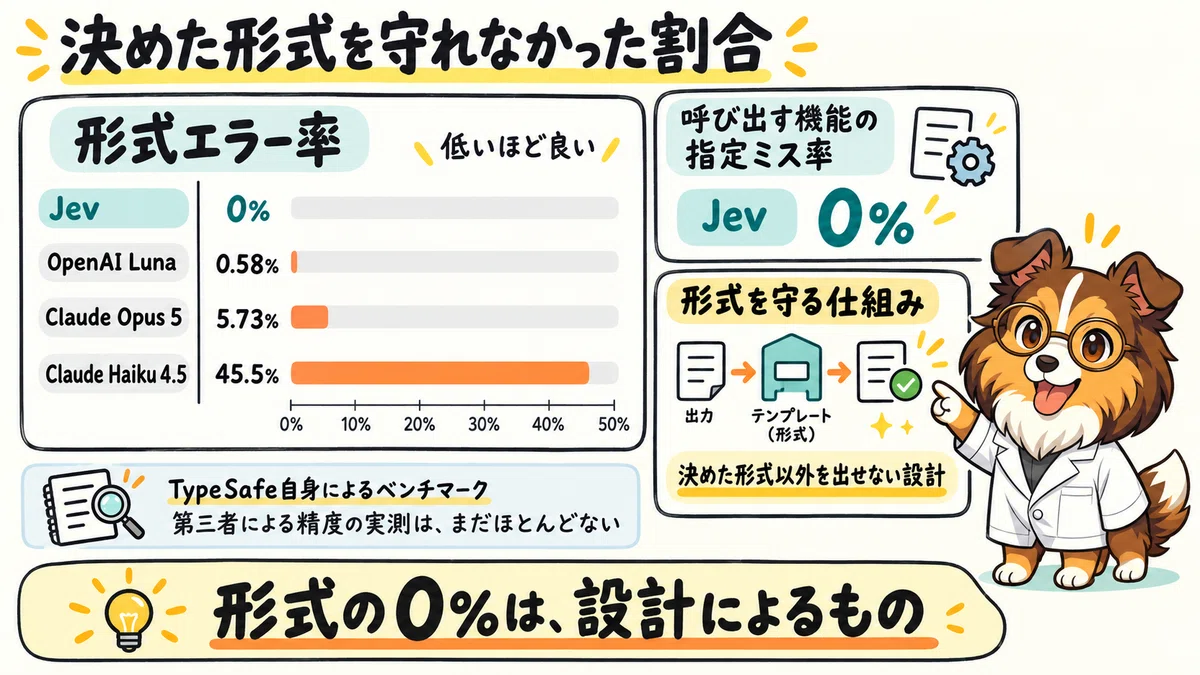
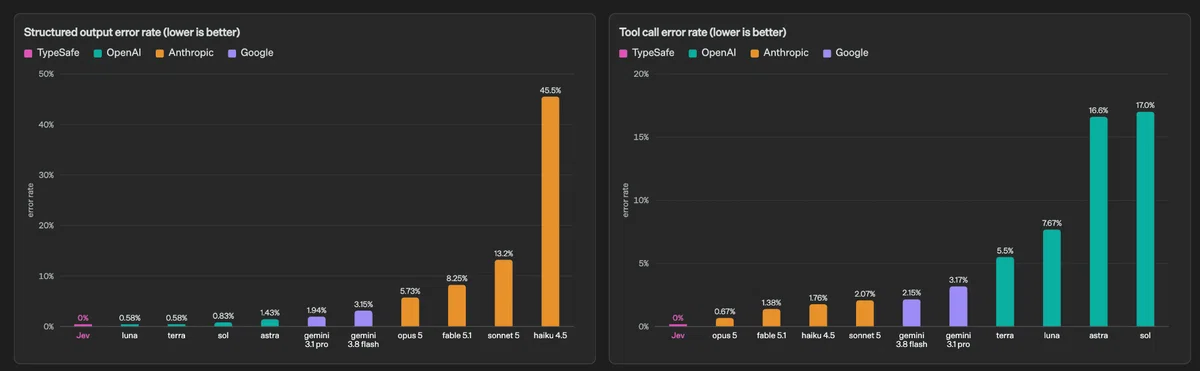
こちらは、左が「決めた形式を守れなかった割合」、右が「AIが検索や計算などの外部の道具を使うときに、その呼び方の指定を間違えた割合」です。
Jevはどちらも0%で、他のモデルは形式エラーがOpenAIのLunaで0.58%、Claude Opus 5で5.73%、Claude Haiku 4.5では45.5%でした。
Jevの0%は、頑張った結果というより、そもそも決めた形式以外を出せない作りだからです。ここは記事の終わりの「使う前に知っておいてほしいこと」でもう一度触れます。
注意点として、このベンチマークはTypeSafe自身が用意したものです。第三者による精度の実測は、まだほとんど出ていません。
Jevには「目」も「手」もありません
数字の話はここまでにして、次はXで見かけたデモの中身です。
ここ、私も壁打ちの途中でAIに「Jevにブラウザ操作の機能があるの?」と聞いてしまったところです。
Xや、プログラムを公開・共有するサイトのGitHubには、「声でブラウザを操作」「ゲームを遊ばせた」「キーボードからアプリやファイルを呼び出すランチャー」といったデモが並んでいます。これを見ると、Jevがブラウザやゲームを動かしているように見えますよね。
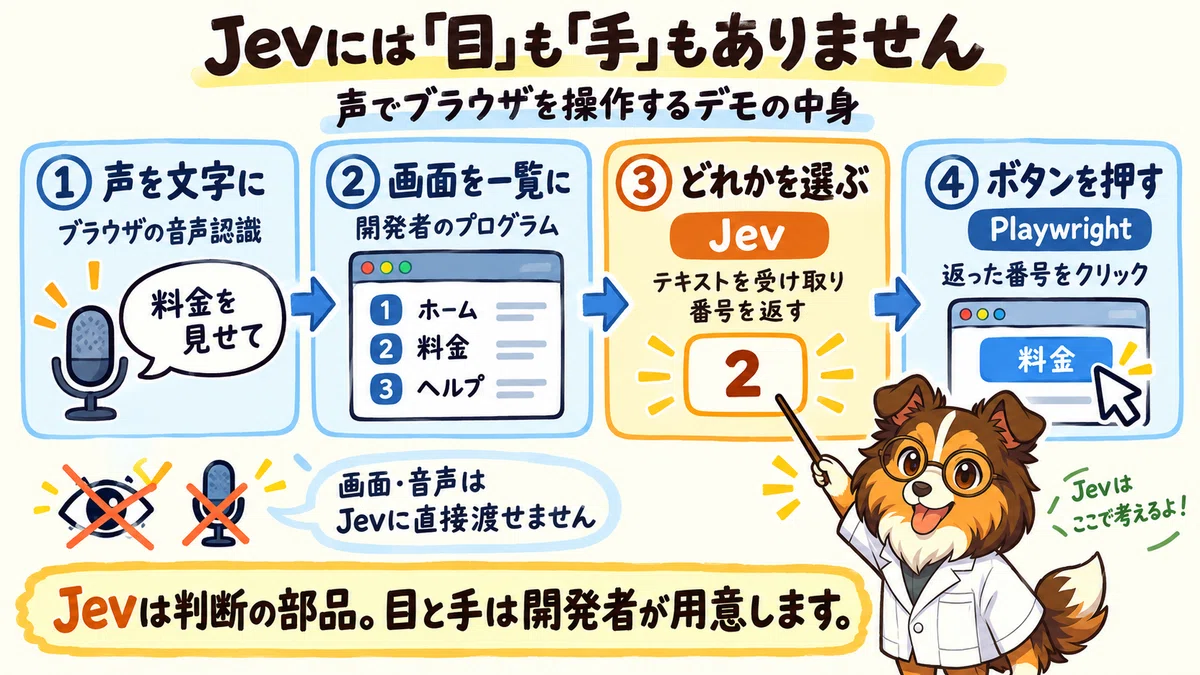
でも違いました。Jevが受け取るのはテキストだけで、画面も音声も読めません。ブラウザを見るのも、クリックするのも、開発者が自分で書いたプログラムの仕事なんです。
声でブラウザを操作するデモの中身は、こうなっています。
ブラウザの音声認識が、話した言葉を文字にします。
プログラムが、画面に見えているリンクやボタンを番号つきの一覧にします。
Jevに「ユーザーが押したいのはどれ?」「危ない操作?」と、まとめて聞きます。
Jevから返ってきた番号のボタンを、Playwrightというブラウザ自動操作の道具がクリックします。
つまりJevは「どれを選ぶか」だけを返す、判断の部品なんですよね。目と手は自前です。
ちなみに、これらのデモはGitHubで公開されている各開発者の自作ツールです。声で操作するものはjev-voice-browser、LLMが計画してJevが選ぶものはjev-browserという名前で公開されています。 https://github.com/moritzkremb/jev-voice-browser
https://github.com/Ying-Kai-Liao/jev-browser
「Spotlightより良いの?」と思った話
Also have been playing with @typesafeai Jev, insane!
— nader dabit (@dabit3) September 18, 2026
So many immediate use cases and new apps are possible. What a time to be a builder!
Sharing some experiments here starting with:
Keystroke oracle / predictive launcher:
Your launcher ranks by aliases, fuzzy match, and… pic.twitter.com/QDVQdJd04s
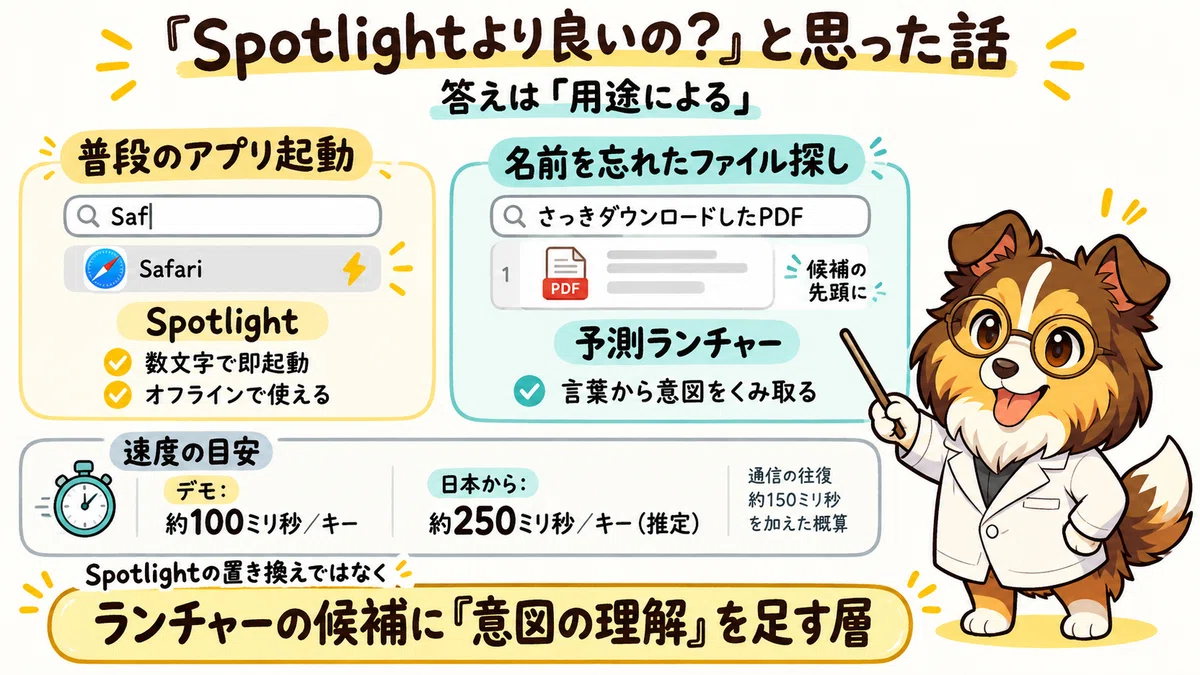
ファイル名を覚えていなくても「さっきダウンロードしたPDF」と打つと、そのファイルが先頭に出てくる予測ランチャーのデモがありました。1キー打つごとに約100ミリ秒で候補が並べ替わるそうです。
これを見て「Macの検索機能のSpotlightより良いの?」と思ったんですが、答えは「用途による」でした。
アプリ名を数文字打つ普段使いなら、即時でオフラインのSpotlightには勝てません。
「さっきダウンロードしたPDF」のように言葉で探すときだけ、名前を覚えていないファイルが先頭に来る、という差が出ます。
次の節で紹介する実測だと、日本からは往復で150ミリ秒ほど余計にかかるので、1キーあたり250ミリ秒くらいになりそうです。
Spotlightの置き換えではなく、ランチャーの候補に「意図の理解」を足す層、と見るのが正確かなと思います。
Xで流れてきた実測を並べます
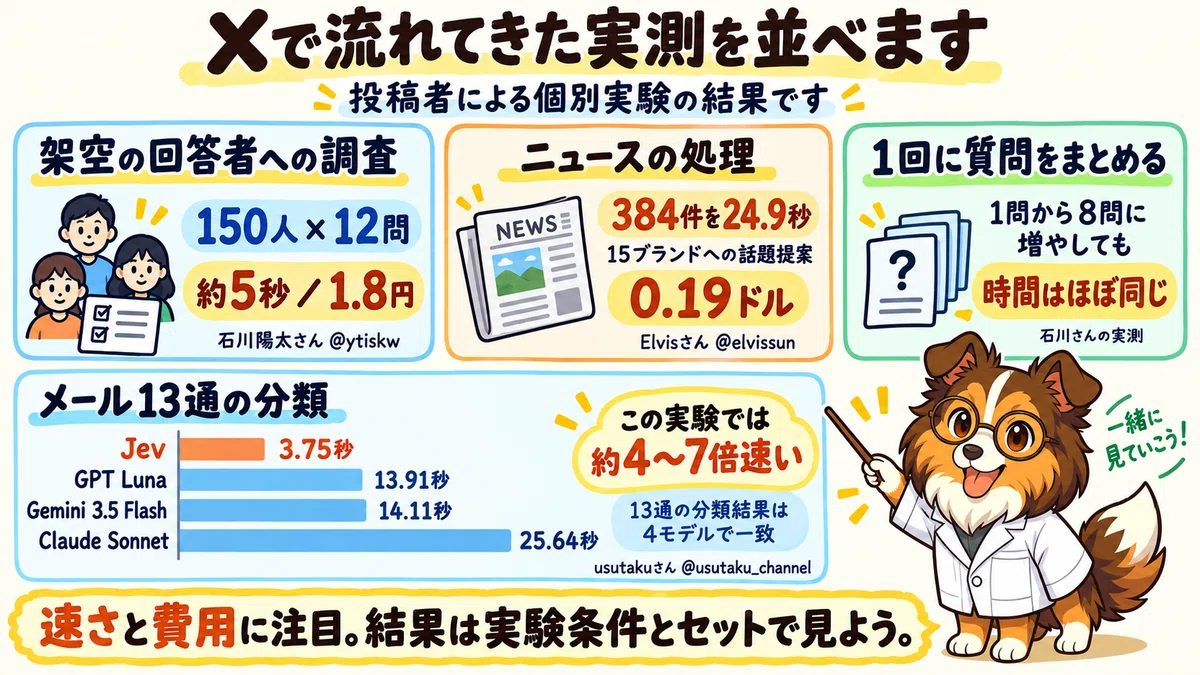
私のブックマーク9件のうち、実際に動かしてみた投稿を並べてみます。
架空の回答者150人に12問ずつ聞いて、1.8円
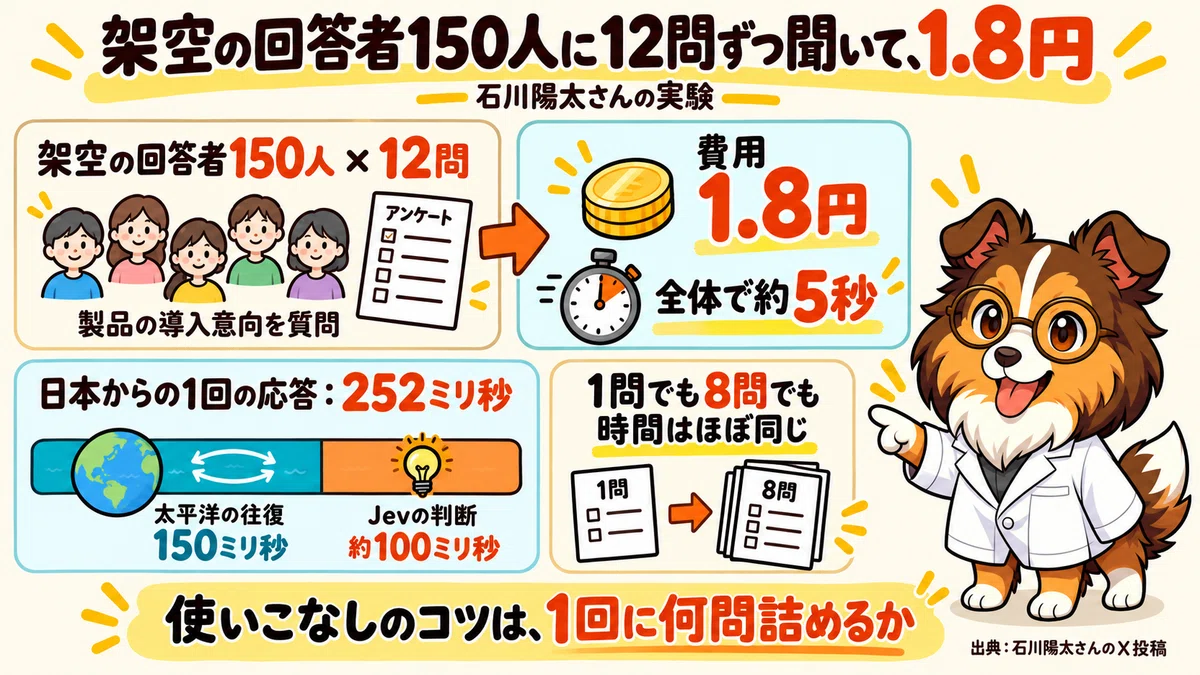
話題のJevで架空のペルソナ150人に製品の導入意向を聞く仕組みを作ってみた。150人ごとに12個の質問をAPIで投げる。
— 石川陽太 Yota Ishikawa (@ytiskw) September 17, 2026
実際にかかった費用は、1.8円でかかった時間は約5秒。十分爆速だけど日本↔︎アメリカのレイテンシが含まれているので本来はもっと早いはず pic.twitter.com/6lbFXY9jjH
石川陽太さんの実験です。架空の回答者150人に製品の導入意向を12問ずつ聞いて、費用は1.8円、時間は約5秒でした。
面白いのは続きの投稿で、日本から叩くと1回252ミリ秒のうち150ミリ秒は太平洋の往復で、Jevが判断している時間そのものは約100ミリ秒だったそうです。しかも質問を1問から8問に増やしても、時間はほぼ変わらなかったとのことです。
第1節で触れた公式の勧めと同じで、「呼ぶ回数を減らす」より「1回に何問詰めるか」が、使いこなしのコツになりそうですね。
ニュース384件を24.9秒で読んで、0.19ドル
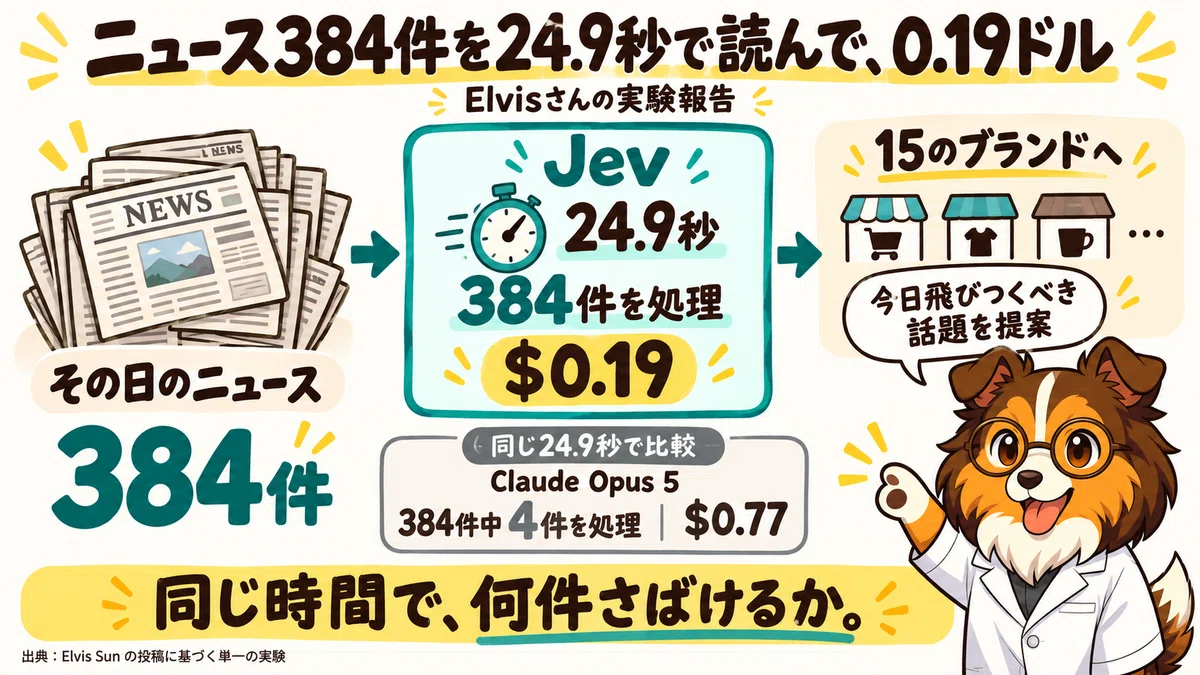
Jev is INSANE. 🤯
— Elvis (@elvissun) September 18, 2026
in 24.9 seconds it read 384 news from this morning and told 15 brands which stories to hop onto today, for $0.19.
Claude Opus 5, running on the same feed at the same time, got through 4/384 and cost $0.77.
per headline that is ~390x cheaper, and the answer… pic.twitter.com/pjgmANxw9U
Elvisさんの実験です。その日のニュース384件を24.9秒で読み、15のブランドに「今日飛びつくべき話題」を提案して、料金は0.19ドルでした。
同じ時間だけClaude Opus 5を動かしたら、384件中4件しか処理できず、料金は0.77ドルだったそうです。「同じ時間で何件さばけたか」という比べ方が、Jevの性格をよく表していると思います。
メール13通の分類で、他の高速モデルの約4〜7倍速い
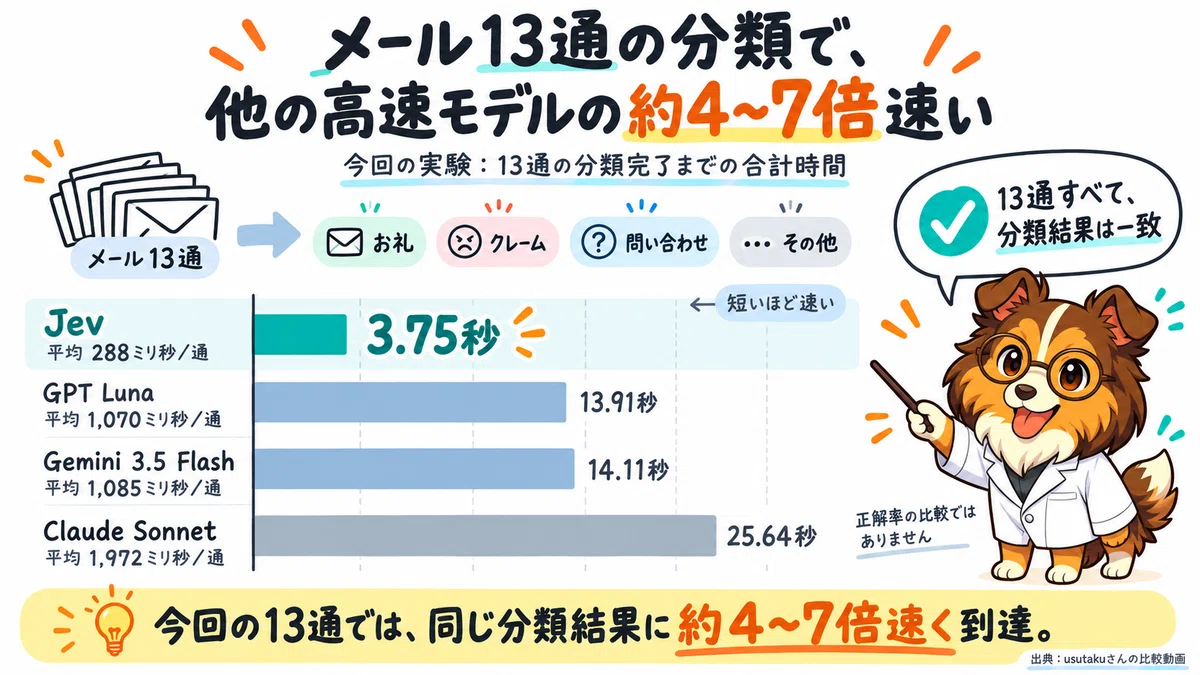
今最も話題の「Jev」の判断力の速さを確かめるために、メール分類をさせてみました。
— usutaku (@usutaku_channel) September 18, 2026
比較したのはAI各社の高速モデルである、Luna、Sonnet、Flash。結果は...ダントツ。 pic.twitter.com/xKkOX7xlav
usutakuさんは、カスタマーサポートのメール13通を「お礼」「クレーム」「問い合わせ」「その他」に振り分ける速さを、4つのモデルで同時に競わせる画面を作っていました。
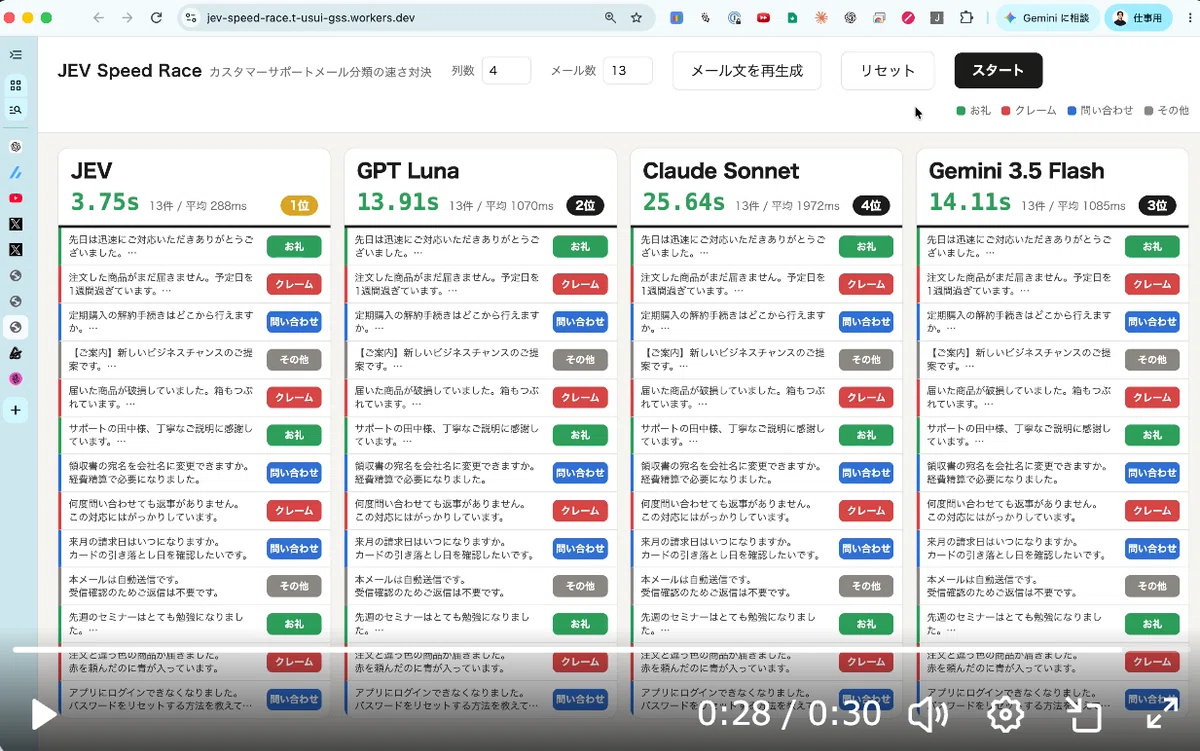
動画の最終場面です。左からJev、GPT Luna、Claude Sonnet、Gemini 3.5 Flashで、上の秒数が13通を分類し終えるまでの合計時間です。モデル名は画面の表記のままにしてあります。
Jevは3.75秒で、1通あたり平均288ミリ秒でした。
GPT Lunaは13.91秒で、平均1,070ミリ秒でした。
Gemini 3.5 Flashは14.11秒で、平均1,085ミリ秒でした。
Claude Sonnetは25.64秒で、平均1,972ミリ秒でした。
画面を見ると、13通の振り分け結果は4つのモデルで全部同じでした。この実験は速さの勝負で、精度の差はここでは出ていません。
「分からない」箱を作る、という知恵
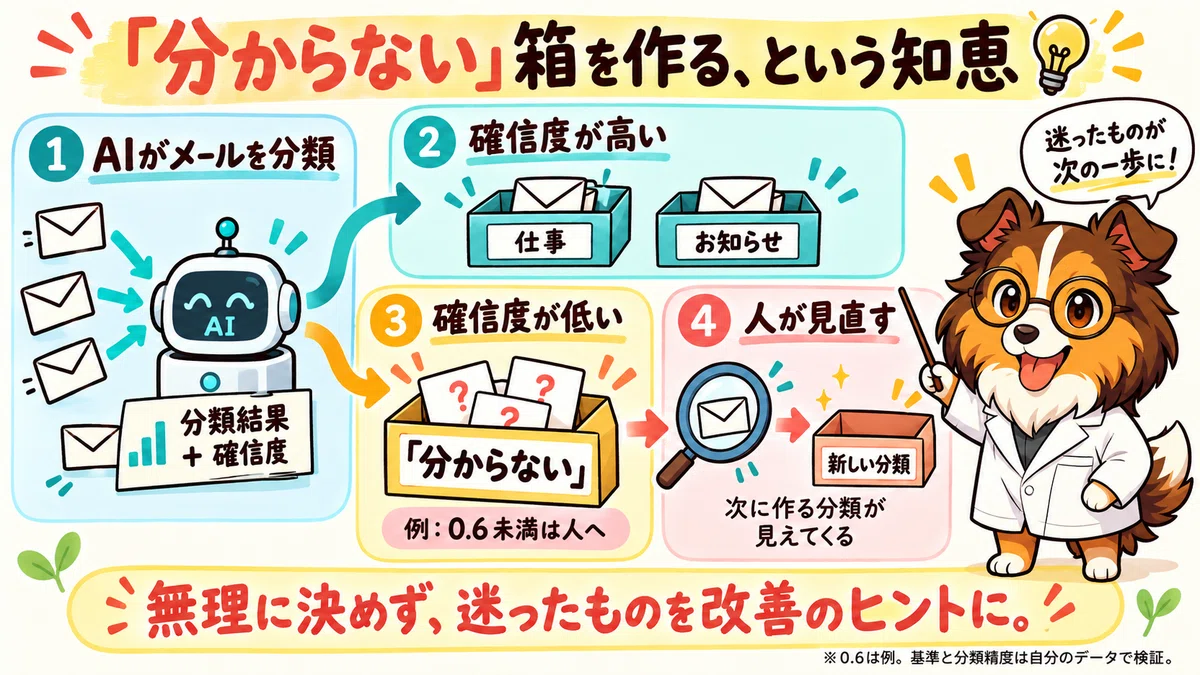
この投稿の返信欄に、Maruさんという方がこんなコメントを書いていました。
速いぶん、AIが外した分を見直す回数を増やせるのがいいですね。うちでメール分類をやらせたときは、AIに「分からない」箱を1つ作らせてから安定しました。どれかに必ず入れさせると、後から探せなくなる。そこに溜まったものが、次に作る箱の名前になります。
これ、すごく実務的な知恵だと思うんですよね。で、Jevには「確からしさの確率」が必ず付いてくるので、この知恵と相性がいいんです。分類するものを作るなら、確率が決めておいた線を下回ったものを「分からない」箱に入れる作りにするのがよさそうです。
公式のドキュメントでは、この確率を確信度と呼んでいて、同じ考え方が載っています。「答えは何をするかを教え、確信度は動いていいかを教える」という一文があって、例では確信度0.6未満は人に回す、という線の引き方をしていました。
ここまで見て気づいたのは、Xの実測はどれも「速い」「安い」で、「精度がどれだけ落ちるか」を測った投稿がほとんどないことです。ここは自分で測りたいところですね。
作るときはClaude Codeに書かせて、動くときにJevを呼ぶ
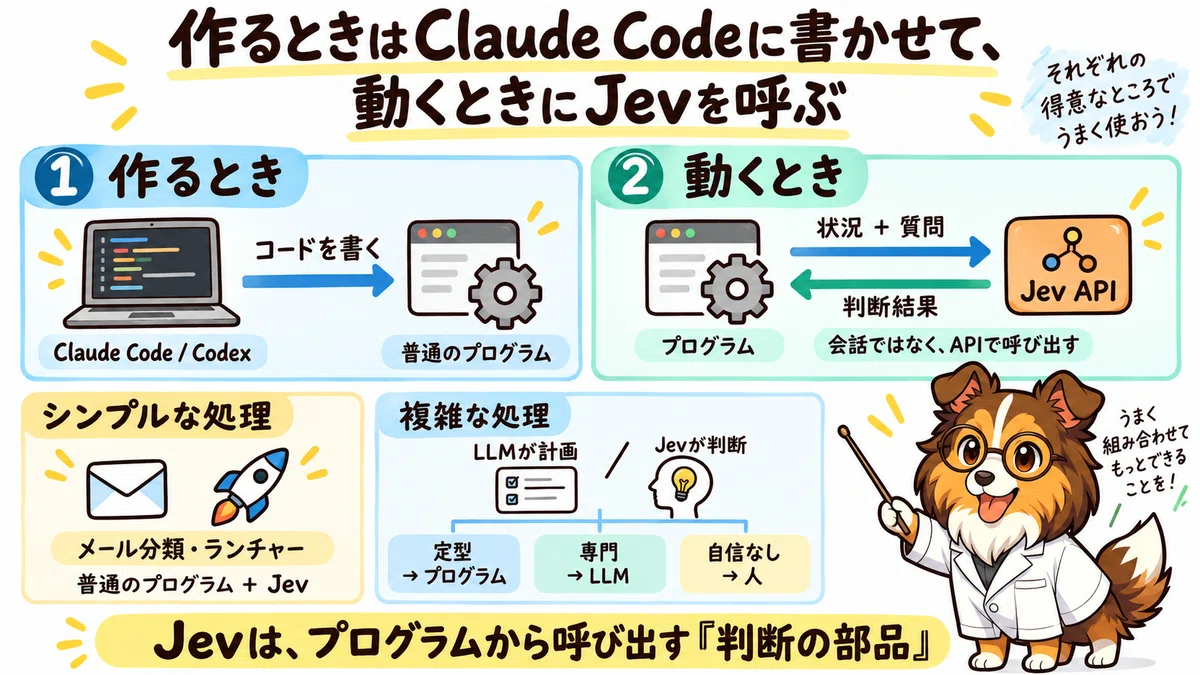
「こういうツールを作るときって、Claude CodeやCodexで作るイメージなのかな」。私が壁打ちの中でAIに聞いた質問です。
答えは「作るときと動くときで、登場人物が違う」でした。
作るときは、ツール本体は普通のプログラムで、それをClaude CodeやCodexに書かせます。
動くときは、できたプログラムが、判断の要る箇所でJevを呼び出します。
「呼び出す」というのは、プログラムがJevのAPIに「いまの状況」と「質問」を送って、答えを受け取ることです。ChatGPTのような会話画面はありません。
で、動くときにLLMが要るかどうかは、設計次第なんですよね。
メール分類やランチャーは、Jevと普通のプログラムだけで動きます。
ブラウザ操作のように複雑なものは、「LLMが計画して、Jevが決める」の二段構成にします。
問い合わせの受付役をJevに任せる使い方もあります。届いた問い合わせをまずJevが「定型の照会か、専門的な質問か」に振り分け、定型はプログラムで即答し、専門的な質問は専門知識を持たせたLLMへ、確率が低くて自信の持てないものは人へ回します。公式のドキュメントにある「意図の振り分け」のパターンです。
つまりJevは、Claude Codeが書いたプログラムがAPI越しに呼び出す部品です。Claude Codeの代わりになるものではありません。
ちなみに公式が、Claude CodeやCodexにJevの使い方を覚えさせるスキルを配っています。Claude Codeならプラグインとして入れるだけです。
私が最初に試したいこと
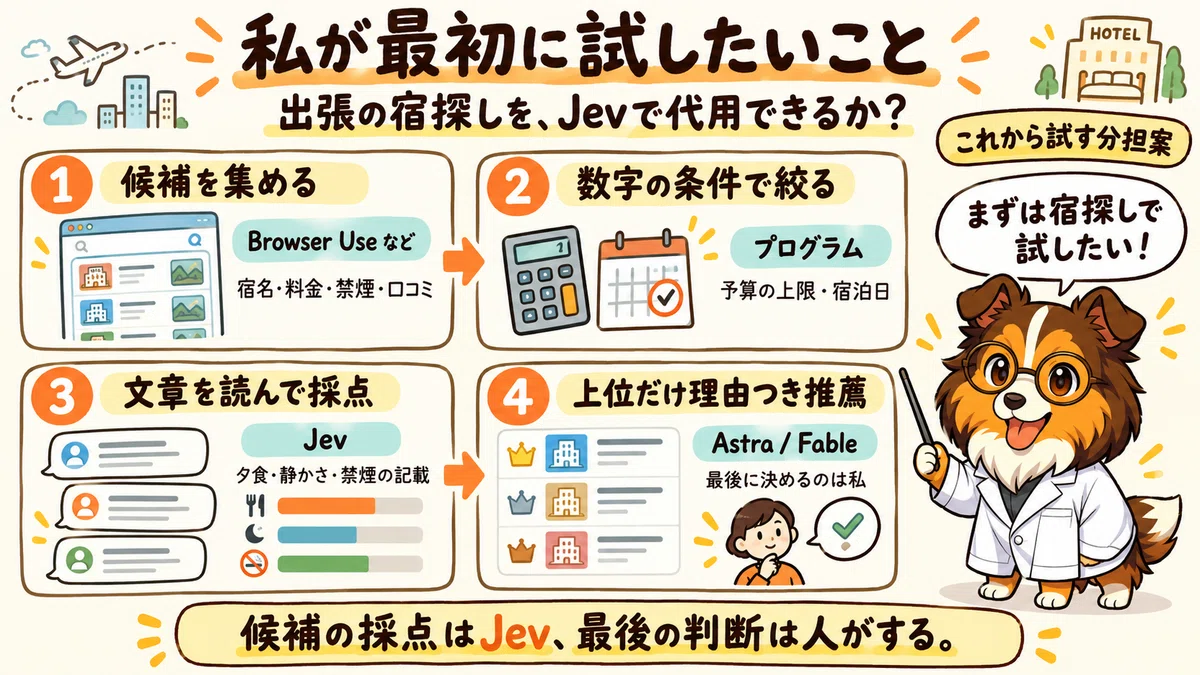
出張の宿探しを、Jevで代用できるか
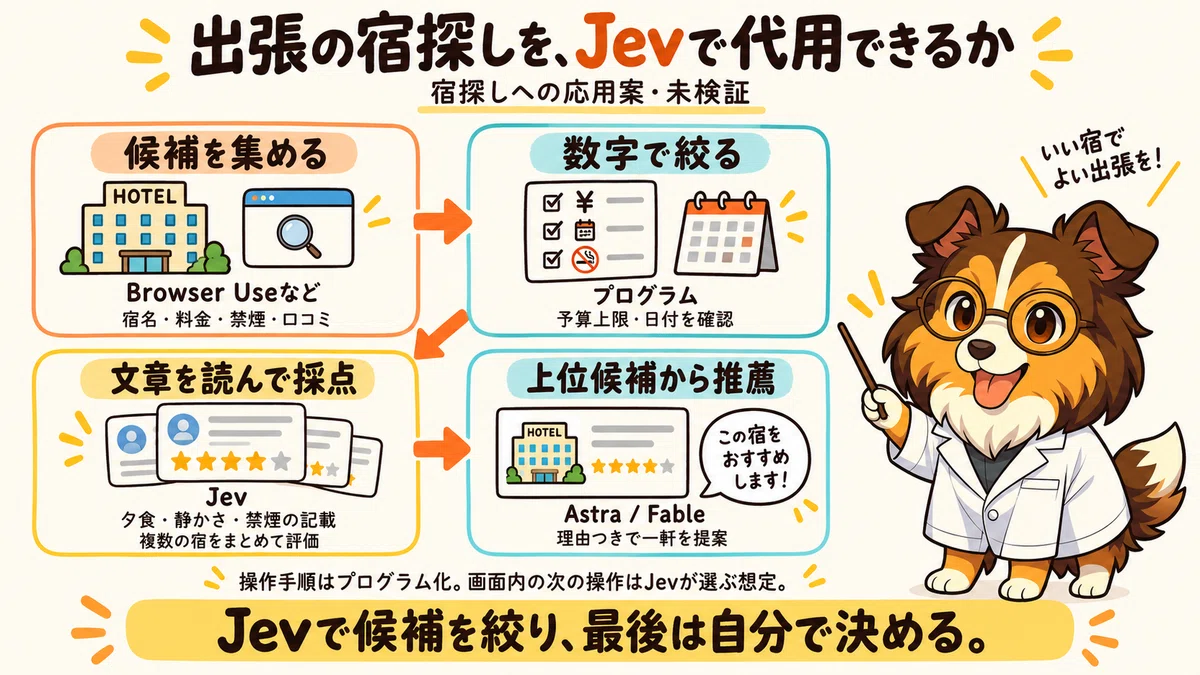
出張の宿や飛行機の便、必要な商品の候補探しを、今はChatGPTのデスクトップアプリのCodexや、パソコンを直接操作させる機能にやらせているんです。ただ正直、これがトークンを結構食うんですよね。中でも回数が多いのが宿探しです。
— にく (@29meat_ai) September 18, 2026
にくさんがXの記事機能で書いた、海外と日本の実装例30本のまとめに、Googleフライトで便を探す例が載っていました。ページの読み込みから7.1秒、費用は0.0039ドルだったそうです。
仕組みとしては、Browser Useというオープンソースのブラウザ操作ライブラリが画面のボタンや入力欄を一覧にし、Jevは「次にどの操作を、どの要素に」を選ぶだけです。
文字の入力が要るときだけ、InceptionのMercury 2.5という小さな言語モデルが呼ばれます。
段取りを組むLLMはいなくて、目標を1つ渡すと、あとは毎ステップJevが選んで進みます。完了するのも検索結果の表示までで、購入までは踏ませない、と正直に書いてありました。
宿探しに置き換えるなら、こういう分担になると考えています。
候補を集めるのは、Browser Useのようなブラウザ操作の道具の仕事です。宿の名前、料金、禁煙かどうか、夕食の口コミを一覧にします。
予算の上限や日付のような数字の条件は、プログラムで先に絞ります。Jevは計算や日付の比較が苦手だと、公式が弱点として明記しているからです。
「夕食が美味しそうか」「静かに過ごせそうか」「禁煙が明記されているか」のような、文章を読んで決める条件は、Jevに宿ごとの点数をつけさせます。何軒あっても1回の問い合わせで済みます。
点数の上位数軒だけをAstraやFableに渡して、理由つきで一軒を推薦してもらいます。最後に決めるのは私です。
で、あなたも気になるであろう「LLMを噛ませずに済むのか」については、触る前の見立てはこうです。
「どのサイトで、何を入力して、どの順で絞り込むか」という段取りは、プログラムに書くか、LLMに組ませます。フライト検索のデモは段取りを組むLLMなしで回っていたので、宿探しも段取りが毎回同じならプログラムで足ります。
画面の中で「次にどのボタンを押すか」を毎回選ぶ機械的な部分は、Jevの仕事です。
「あなたの好みならここ」と理由つきで一軒を推す仕事だけは、理由を語れないJevより、AstraやFableが向いています。
なので、Jevが数十軒を安く速く数軒まで絞り、AstraやFableがその数軒を読み比べて理由つきで一軒を推す、という二段構えが現実的かなと思っています。高いモデルに読ませる量が数十分の一になるので、トークンの節約にもなるはずです。
後段は、GPT-5.6 SolやClaude Opus 5のような、最上位の一つ下のクラスのモデルでも十分かもしれません。数軒の口コミを読み比べる程度なら、最上位の推論力までは要らないはずなので、ここも試して決めます。「Jevと環境を用意したら、深く考えなくても宿探しがパッと回るのか」が最初の実験です。
AI秘書の判断を、Jevに差し替える3つの候補
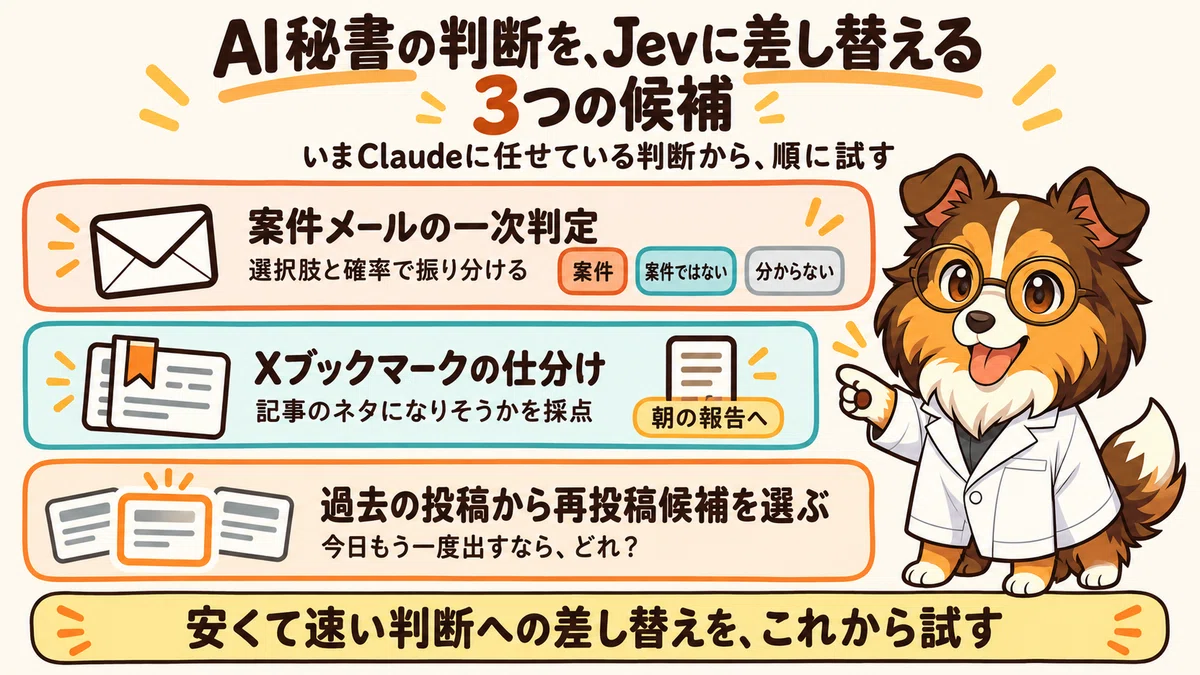
もう一つは、私のAI秘書に組み込む案です。私は、届いた企業案件のメールの振り分けや毎朝の報告づくりをClaudeに任せる自分用のAI秘書を動かしているんですが、その中で「Claudeに読ませて判断させている」箇所を、Claudeと相談して3つに絞りました。
案件メールの一次判定です。「案件か、そうでないか」を今はClaudeに読ませていますが、ここは選択肢と確率で足ります。さっきの「分からない」箱も作ります。
Xブックマークの仕分けです。毎日たまる投稿に「記事のネタになりそうか」の点数をつけて、朝の報告に載せます。
過去の投稿から「今日もう一度出すならどれか」を選ぶ役です。候補を並べて選ばせるのは、まさにJevの得意な形です。
どれも、いまClaudeにやらせている判断を、安くて速い判断に差し替える話です。こちらも順に試していきます。
使う前に知っておいてほしいこと
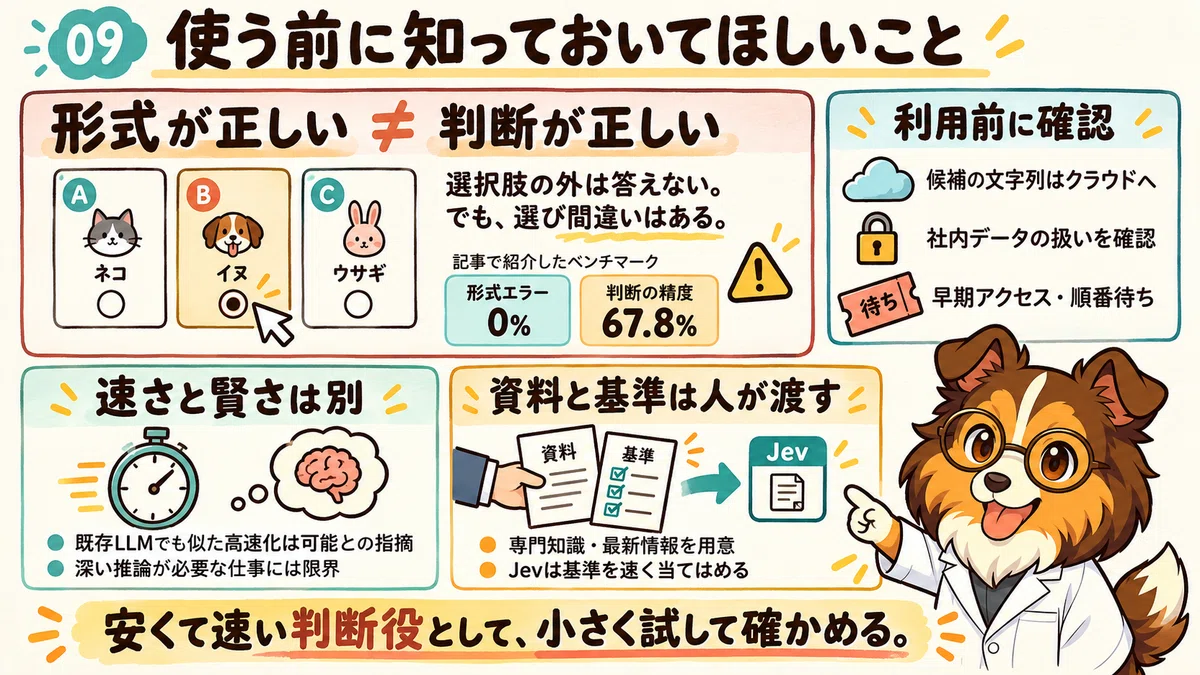
盛り上がりの一方で、冷静な指摘も出ています。安心して試してもらうために、先にお伝えしておきますね。
「ハルシネーションしない」の読み方
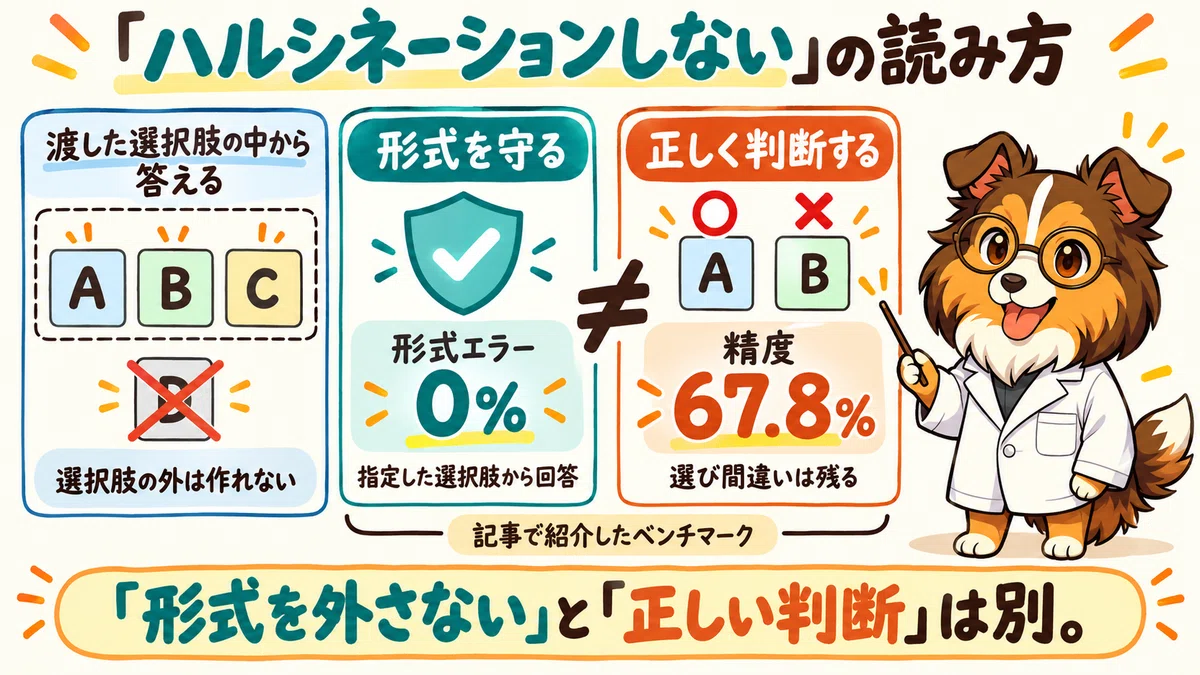
まず「ハルシネーションしない」は、少していねいに読む必要があります。Jevは、こちらが渡した選択肢の外にあるものを答えられません。存在しない機能や架空の数字を作り出せない、という意味では、確かに「でっち上げ」は起きないんです。
ただ、3つの選択肢のうち間違ったほうを選ぶことはあります。「形式を外さない」と「正しい判断をする」は別の話で、後者はこれまでどおり精度の問題として残ります。さっきのベンチマークで形式エラーが0%だったのは前者の話で、精度が67.8%だったのは後者の話です。
専門知識は、渡す側の仕事です
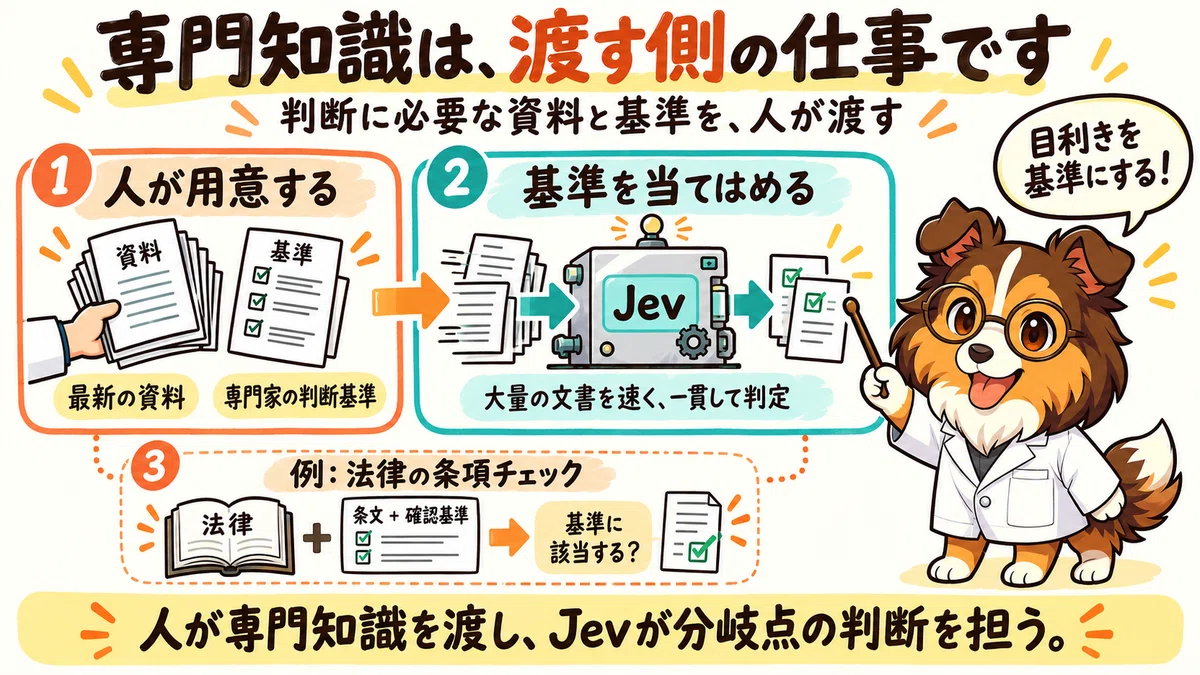
「Jevは知識を持たない」という言い方をXで見かけた方もいると思います。これは、モデルの中の知識に頼らず、判断に要る資料と基準を渡す前提で設計されている、という意味なんですよね。公式の設計ガイドにも「最新の情報が自分の知識ベースから出せるなら、モデルの中の知識に頼るな」とあります。
法律なら、条文と確認したい基準を渡して「この条項は基準に該当するか」を判定させる、という使い方になります。専門家の判断基準は人が書き、Jevはそれを大量の文書に速く一貫して当てはめる役、という分担です。
ほかに押さえておきたいこと
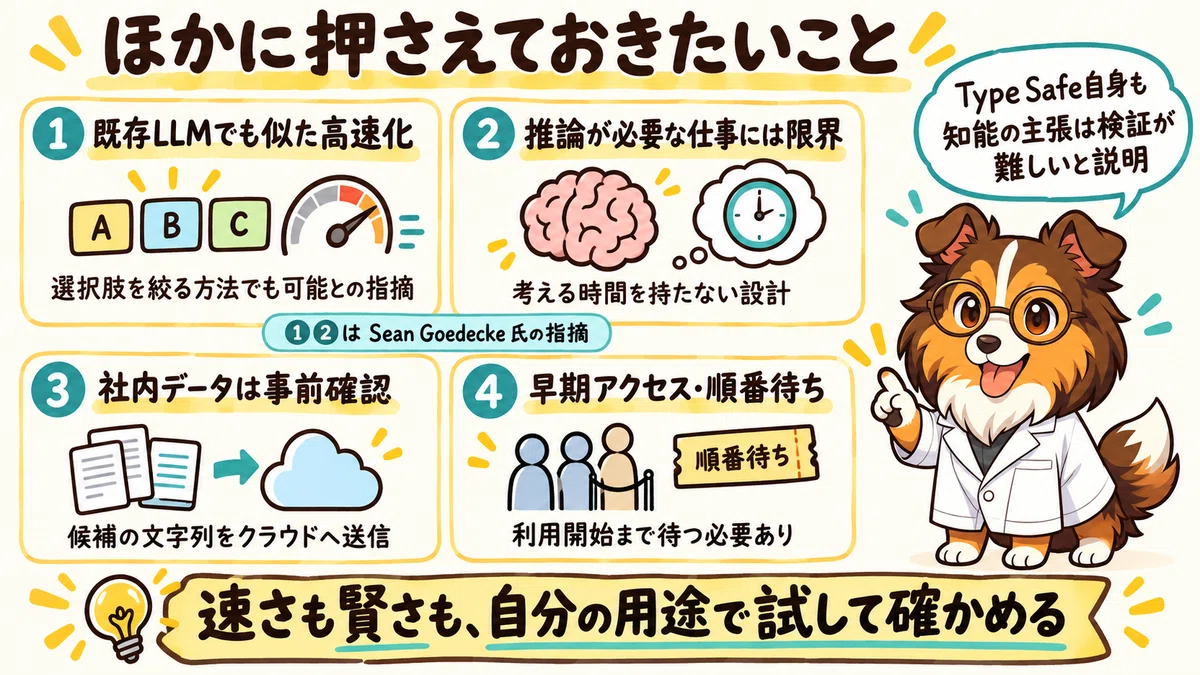
指摘はほかにもあって、4つ挙げておきます。
「選択肢を絞って答えさせる」だけなら、既存のLLMでも似た高速化ができる、という技術者の指摘があります。
考える時間を持たないぶん、推論の要る仕事では賢さに上限があります。
候補の文字列をクラウドに送るので、社内データを扱うときは確認が要ります。
今は早期アクセスで、順番待ちです。
最初の2つは、Sean Goedeckeさんというエンジニアのブログの指摘です。
面白いのは、TypeSafe自身も慎重な点です。アカウントを作った直後に出てくる歓迎画面は「System 2のタスクは得意ではない」を限界に挙げたうえで、System 1でのフロンティア級の知能については「これがいちばん守りにくい主張で、この分野の誰も、それを証明するよい方法を見つけていない。ぜひ自分で実験して確かめてほしい」と書いてありました。
私自身は、「プログラムの分岐点に差し込む、安くて速い判断」として付き合うのが正解かなと思っています。賢いAIの代わりを期待すると、期待外れになると思います。
まとめ
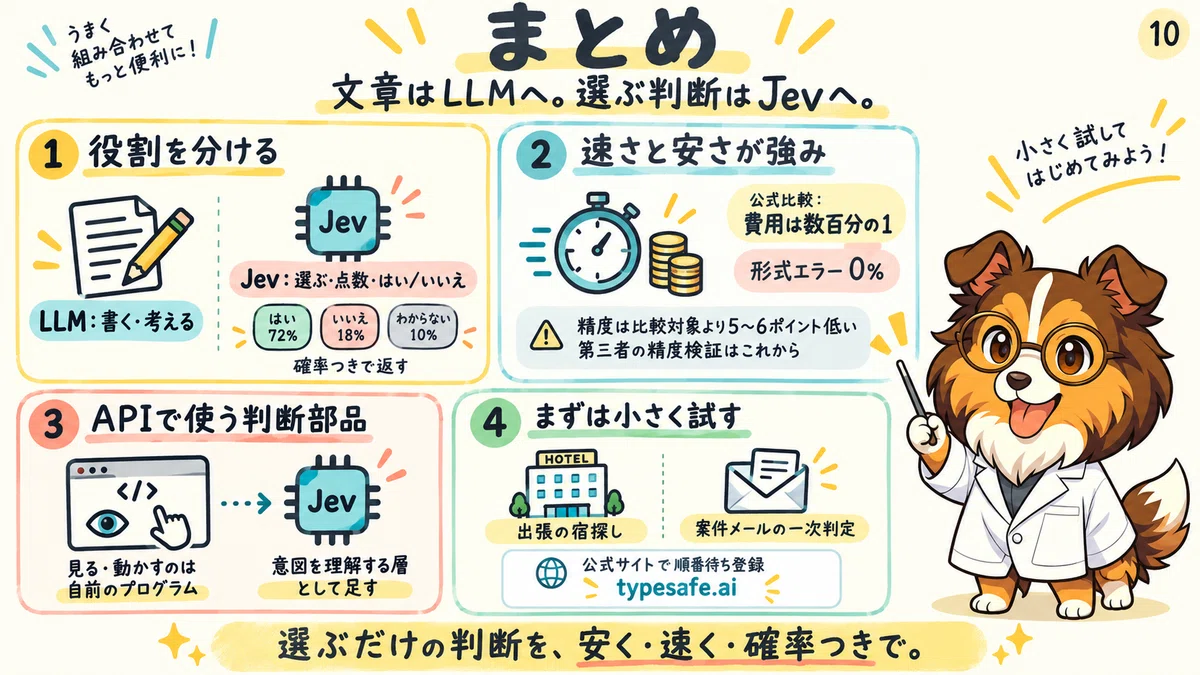
Jevは文章を書かず、選択・点数・はい/いいえを確率つきで返す判断専用のAI。判断の当たり外れで確率の正直さを鍛えたSystem One Modelという新しい種類で、返ってきた確率はそのまま信頼度の目安に使える
公式ベンチマークでは、精度はGPT-5.6 SolやClaude Opus 5に5〜6ポイント劣り、費用は数百分の1、形式エラーは0%。採点の物差し側なので、精度では最上位のAstraやFable 5.1と比べられていない。Xの実測は速さと安さの報告ばかりで、第三者の精度実測はこれから
目も手もないので、見る・動かすは自前のプログラム。Spotlightの代わりではなく、意図の理解を足す層。作るのはコーディングAIに任せられて、動かすときにAPIで呼ぶ部品
私はまず、出張の宿探しの代用と、AI秘書の案件メール一次判定から試す
要は、こういうことなんですよね。文章を書いたり筋道を考えたりする仕事はこれまでどおりLLMに任せて、「どれ?」「何点?」「はい?いいえ?」で答えられる判断だけを切り出す。その切り出し先として、安くて速いJevが出てきた、ということです。
最初の一歩は、公式サイトから順番待ちに登録しておくことです。私は9月19日の夜7時ごろにGoogleアカウントでサインインして用途の質問に答え、翌日の深夜1時半ごろに「アカウントの準備ができました」のメールが届きました。約6時間半でした。
ちなみに、順番待ちを待たずに試せる入口が3つあると、まさおさんの動画で知りました。Vercel AI Gateway、OpenRouter、Cloudflare Workers AIの3つで、どれも公式と同じく「状況と型つきの質問を送ると、確率つきの答えが返る」形です。
OpenRouterは料金も公式と同じで、入力100万トークンあたり0.042ドル、出力は無料でした。
私は公式の順番待ちを通ったので、次の記事は公式の入口で試します。どれも開発者向けの中継サービスで、プログラムから呼ぶ前提ですが、待ちたくない方は、まさおさんの動画で手順を見てみてください。 https://www.youtube.com/watch?v=YhyjMcYhzII
この記事が参考になったら、いいねとフォローで教えてもらえると嬉しいです。次は、宿探しの実験と案件メール判定の置き換えを、試した順に書く予定です。
あなたの作業の中で、「選ぶだけ」「仕分けるだけ」になっている判断はどこですか?コメントで教えてもらえると、実験のネタにします。
それではまた、れん学長でした!
📢 れん学長のAIツール実験室
メンバーシップでは、この記事では書ききれなかった実験ログや、AI活用の試行錯誤をもう少し踏み込んで共有しています。
価格や参加条件、どんな内容が読めるかは、入口記事にまとめています。
気になっていた方は、まず内容をのぞいてみてもらえるとうれしいです。
👉 メンバーシップの入口記事をのぞいてみる https://note.com/renkon40/n/nab9c378d2148
📮 【無料】週1回のニュースレターやってます
実際に試したAIツールの「結局、誰が使うべきか」だけを、5分で読める形でメール配信しています。noteの更新を見逃したくない方もどうぞ。
https://renkon40.substack.com/?utm_source=note&utm_medium=article
#AI #Jev #TypeSafeAI #SystemOneModel #ClaudeCode #Codex #AIエージェント #自動化 #AIツール
いいなと思ったら応援しよう!
 よろしければ応援お願いします!いただいたチップは、新しいAIツールの検証費用に使わせていただきます🧪 これからも実験→発見を共有していきますね!
