#84【生成AI】Mythos級モデル「Claude Fable 5」について。軽い使用感。参ったよ。

※使用感を記事最後に追記。せっかくなので、エフォート「最大」で、以前Opus4.8にやらせた法律関係の問題をFable5にふってみた。
昨日、Claudeの最新モデル、Claude Fable 5がリリースされた。「ファブル」読みかと思ったら「フェイブル」? 伝説とか作り話とか、おとぎ話とか。そのあたりの意味のようだ。
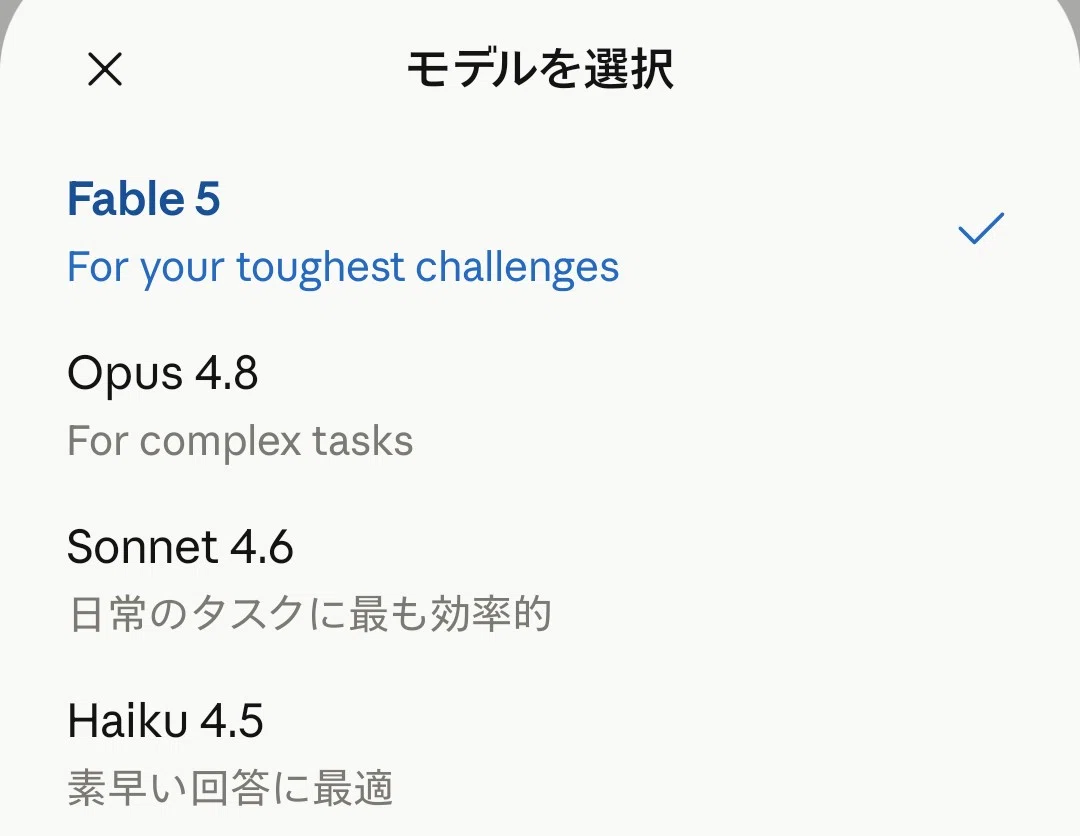
いままでの最上位モデルが「Opus(オーパス)」で「章」、モデルが進化して「物語」になってしまった。
私はチャットユースなので、各モデルの威力を十二分に使いこなしているとは到底思えないし、使えていないのは事実だと思う。
昭和が遠い、どころではない。生成AIの応答にスマートフォンの画面を叩き割りそうになっていた、時間軸ではたかが「昨年夏」が、すでに遠い。進化が早すぎる。…
使ってみた
正直、チャットユースではOpus4.8との違いはよく分からない。添付データの分析を頼むと、細かいところまで良く拾って、多方向から読み解き、分解して組み立て、整理して出してくる。
このへんの解像度の高さはOpus4.8と同じ。分析元のデータの量や複雑さでは結果は違ってくるかも知れない。Opus4.8で気付いたのが、社会人必須スキルの「仕事の優先順位をつける」ことと「軽重をつける」ことをやるようになったという部分で、たぶん、このあたりは変わってないんじゃないかと思う。そして、Fable5を少し触ってみた感じでは、分析結果から提案の際に、
一歩進めてくる
ところがあると気づいた。(能力有り余ってるんだろうな)
例えば、日曜日昼の献立の相談で、冷蔵庫にこういう材料があって、人数分は何人で、気分としてはカレーかスープか、というざっくり質問をした際の回答に、カレーかスープかの絞り込みのヒント(比較検討材料)を出してくるのは当然、ランチ時間から逆算して、何時からキッチンに立ったほうが良いという目安を出してくる。(あくまで例え話で、私が実際に相談したのはトレード関係)
まとめると、分析の解像度そのものではOpus4.8との差は分からないが、分析結果をユーザーの質問に対してどう配置するかについて、立体的になっている、ように思った。
Opus4.7(4.8はまだ使いはじめて間もない)では気づかなかったところだし、ChatGPT5.5 Thinkingでもカバーしてない部分だと思う。もちろん、Opus4.7や4.8、ChatGPT5.5 Thinkingでも、ユーザーが指示すればカバーしてくるはずなので、要は使い方の話か。
とはいえ、ユーザーとしては、質問の初手から自分が何を知りたいか、また何を知っておくべきかが分からない状態でなんとなくAIのチャット欄を叩くことが多いんじゃなかろうか(私はそう)。そういう意味では、Fable5の能力は、チャットユースの私でも、使う場面はありそうではある。
ま、オーバースペックだな!
というのが本音のところ。
料金体系も、6月22日まではPro以上の各プランの範囲の中で使えるようだ。23日以降は追加費用ありの、利用クレジットが必要とか。気になる方は早めのお試しをおすすめ。
【追記】
冒頭に書いたとおり、使用感を追記。
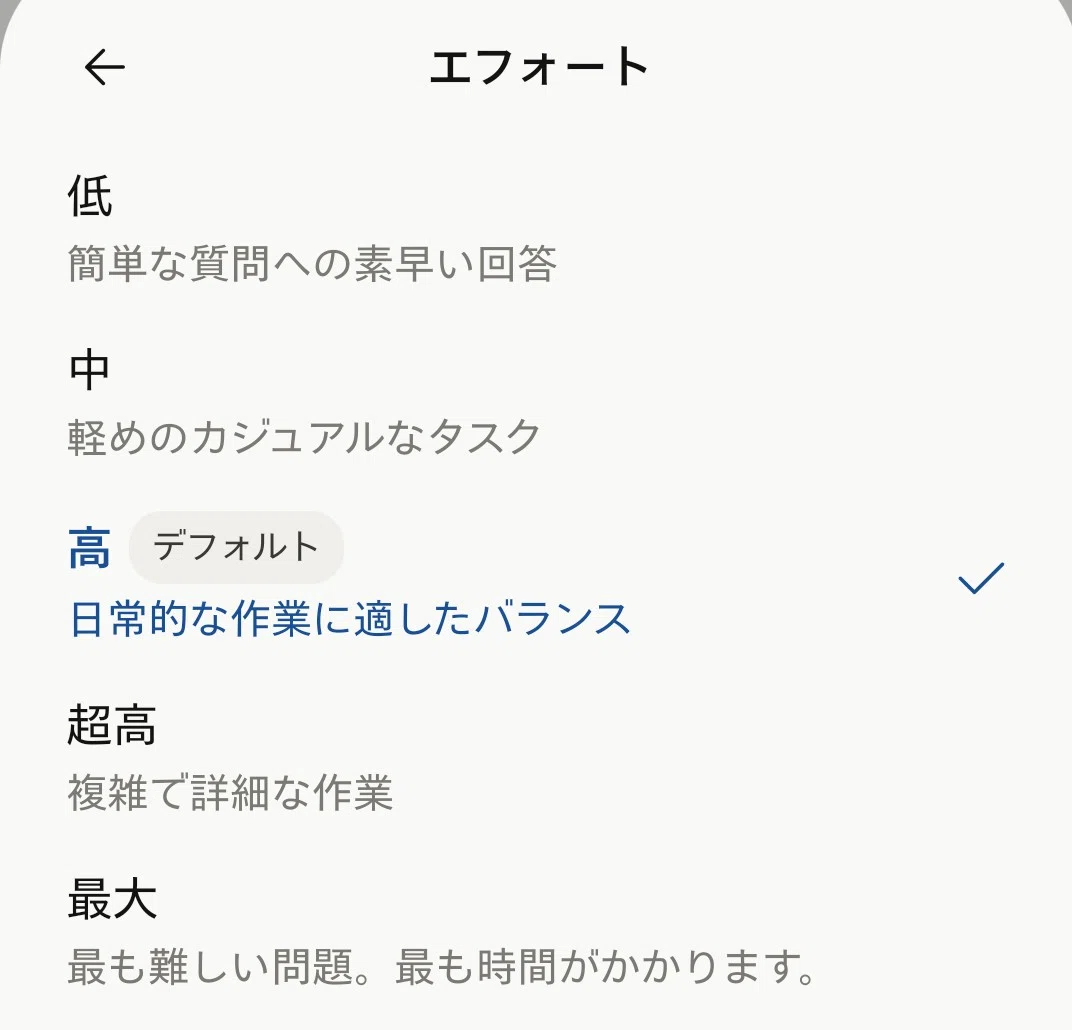
エフォートを「最大」にして、過去、Opus4.8に投げていた法律関係の問題をFable5にふってみた。ちなみに法律関係の問題とは、六法を引いてすぐに分かる問題ではなく、法令や様式集その他からの推論が必要になる問題で、ネット他書籍を探してみたが類似案件がほぼ出てないレアケース。
Fable5の回答は、Opus4.8とあきらかな差があった。結論までの方向性同じで、結論もほぼ同じだったが、回答の組み立て方が違った。
まず「結論」について。ネット上に答えはない(調査済)ので、多角的に検証しなければ出てこない結論の、その推論過程が整然としていて納得がいった。あー、確かに。と頷くほかないレベルの回答がきた。
「組み立て方」について。ユーザーが何を知りたいのかについての推論が、Opus4.8よりも一段か二段上だった(私の体感)。
プロンプト内容からユーザーが真に知りたいのはおそらくこれ、と目標を定めてから、その目標に沿ってメニューを出してくる。おそろしいことに笑、その推論正しいんだ。よく分かるな。そして、Opus4.8が出してきた答えよりも短く整理されていて的確。こりゃ参った。
