Claude Opus 5.5、登場。Fable 5.1級の性能が4割安く、答え方まで「結論から」に

いつものようにClaudeを開いたら、「Claude Opus 5.5が出たよ」って案内が表示されてたんだ✨ 前の日にGPT-6 SolとLunaの揃い踏みを記事にしたばかりで、今度はAnthropicからの一手なんだよね。 せっかくだから、Opus 5.5で何が変わって、僕らの使い方がどう変わるのか、一緒に紐解いていこうかな。
さっそく発表を読んでみたら、思わず二度見した数字があったよ💡 上位モデルのFable 5.1とほぼ同じ性能なのに、コストはOpus 5より4割安い。 しかも答え方まで「結論から」に変わってるんだ。
チャットで使う人も、APIで組み込んでる人も、見るべきポイントはちゃんと分けてあるからね。
🚀 Claude Opus 5.5で何が起きたか
2026年9月22日、AnthropicがClaude Opus 5.5を公開したよ。 これはClaude 5.5ファミリーの最初のモデルで、Sonnet 5.5とHaiku 5.5も「数週間以内」に続く予定なんだって。 ClaudeのアプリはもちろんAPIでも即日使えて、Amazon Bedrock・Google Cloud・Microsoft Foundryにも同じ日に来てるんだ。
✨ Fable 5.1級の性能を、Opusの価格帯で
まず前提から。 Fable 5.1というのは、Opusよりさらに上に置かれている高性能モデルのことだよ。 性能は高いけど、そのぶん値段も重いクラスなんだよね。
Anthropicの説明では、Opus 5.5はほとんどのタスクでFableと同じレベルで動くとされてる。 しかもエージェント型のコーディングや知識労働のベンチマークでは、Fable 5.1を上回る数字まで出てるんだ。
Terminal-Bench 4.0(ターミナル操作を伴うエージェント型コーディング):Opus 5.5が66.4%、GPT-6 Astraが57.9%、Fable 5.1が55.8%、Opus 5が52.3%
CursorBench 4.0(エディタ上でのコーディング):Opus 5.5が57.8%、Fable 5.1が51.8%、Opus 5が46.6%
GDPval-AA v2.1(実務に近い知識労働の評価):Opus 5.5が1846、Fable 5.1が1735、Opus 5が1708
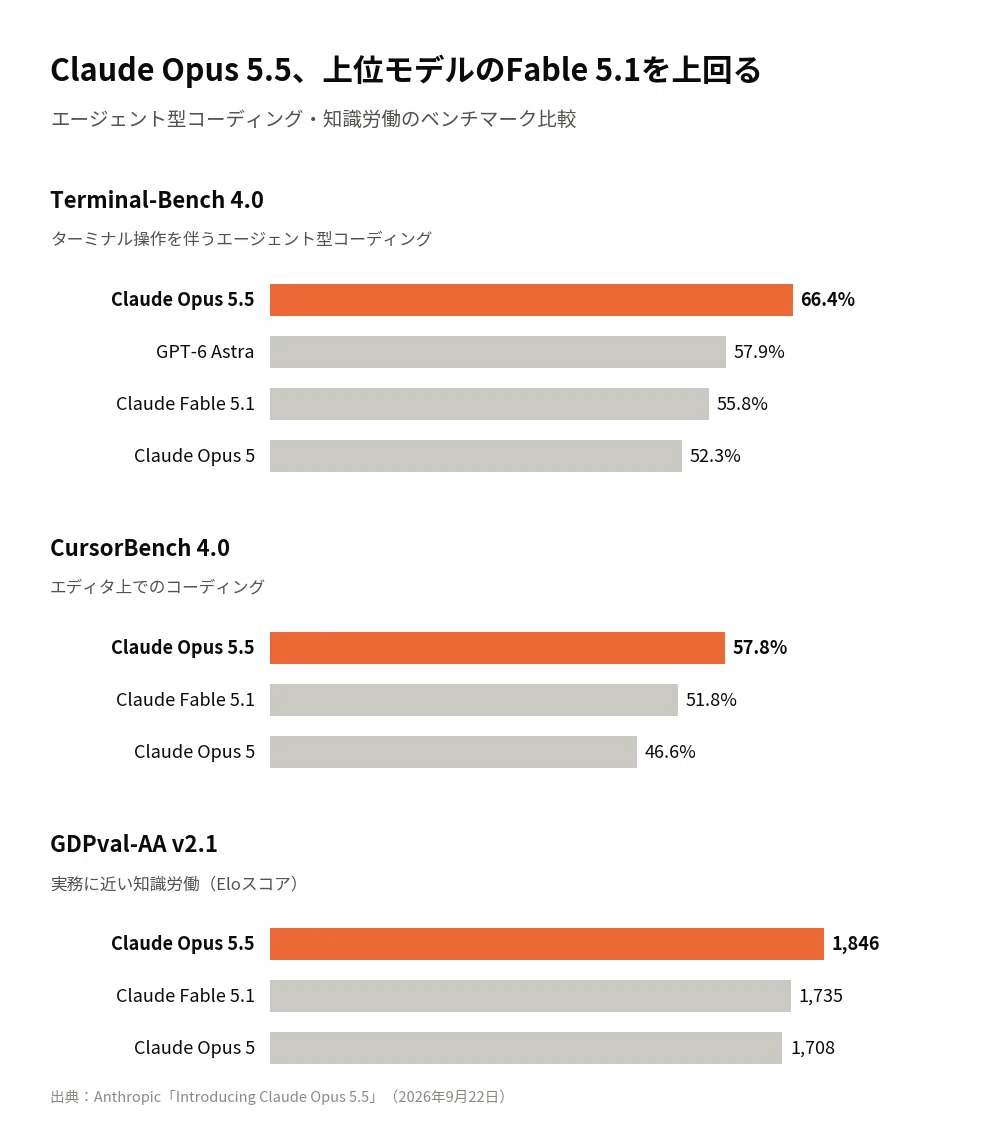
じゃあ、なんで一段下のモデルが上位モデルに追いつけたのか。 Anthropicが強調してるのは、自分の作業を自分で確かめる力と、サブエージェントに仕事を振る力が上がったことなんだ。 つまり「一発で賢い答えを出す力」よりも、「長い作業を途中で崩さずにやり切る力」が伸びたってことだね。 ベンチマークで差が大きく開いてるのが、どれも何ステップも続くエージェント型のタスクなのは、たぶん偶然じゃないと思う🤔
ただ、全部の領域で勝ってるわけじゃないよ。 ITmediaの報道によると、一部の科学研究系ベンチマークではGPT-6 Astraに届いていないみたいだ。 得意・不得意はちゃんとあるんだよね。
🔍 早期テスターの事例がすごい
数字だけだとピンとこないかもしれないから、公開前に試した人たちの事例も並べておくね。
68万行のコード移行を1日かからずに完了(従来なら数週間かかる規模)
20万行のコード監査を3時間以内に完了(Opus 5では20時間超)
HAProxyをC言語からRustに書き換える作業で、Fable 5.1と同等の結果を9.5時間で、コストは51%少なく達成
Webページの表示速度の改善で、40回中39回成功
「週単位の仕事が日単位になる」って、言葉にすると大げさに聞こえるよね。 でも68万行の移行が1日って、まさにそういう話なんだよ。 しかもそれを最上位モデルじゃなく、Opusの価格帯でやってるのがポイントなんだ✨
💡 何が変わるか:安く、速く、読みやすく
🔧 単価は2割下げ、実行コストは4割減
API料金は、100万トークンあたりでこうなったよ。
入力:5ドル → 4ドル
出力:25ドル → 20ドル
キャッシュ読み込み:0.5ドル → 0.2ドル
バッチ処理:さらに半額(入力2ドル、出力10ドル)
単価の値下げは2割なのに、Anthropicは「典型的な作業でOpus 5より4割安く動く」と言ってるんだ。 この差は、同じ仕事をより少ない処理で終えられるようになった分、と読むのが自然かな。 出力の速度も30%以上速くなってるから、待ち時間まで含めた体感はもっと大きく変わりそうだね。
テクノエッジの記事では、標準設定のGPT-6 Astraと比べて、同じくらいのスコアを1タスクあたり約5分の1のコストで出せるとも紹介されてる。 性能で並んで、コストで大きく差をつける。 今回の発表の芯はここにある気がするよ🚀
✨ 「結論から話す」Claudeになった
個人的にいちばん刺さったのはここ。 Anthropicは、Opus 5.5が前のモデルより自然に話すようになったと説明してるんだ。
具体的には、こんな変化だよ。
大事な情報を先に出す
専門用語やクセのある言い回しを減らす
ユーザーが指定した書き方のルールに、よりきちんと従う
長い説明より先に、欲しい答えがまず目に入る。 これだけで、読むテンポがぐっと軽くなるんだよね💡 ベンチマークの数字より、毎日の体感に効くのはむしろこっちかもしれない。
🤝 どう使えるか:チャット勢とAPI勢で見るポイントが違う
🎯 Claudeアプリで使う人
Pro・Max・Team・Enterpriseの各プランで、発表当日から使えるようになってるよ。 しかも、5時間ごとの利用上限もあわせて引き上げられたんだ。
さらに、サブスク利用者には「レート制限のリセット」が1回分配られてる。 上限に達したときに、好きなタイミングで枠を回復できる権利みたいなものだね。 報道では10月22日までに使う形と伝えられてるから、重い作業をする日のために取っておくのがよさそうだよ🙆♂️
🔧 APIで使う人は移行チェックを忘れずに
APIでは、モデルIDを claude-opus-5-5 に変えるだけ、とはいかないんだ。 Opus 5から動作が変わっている点がいくつかあるよ。
思考(thinking)をオフにできない。状況に応じて考える量を変えるアダプティブ思考が常にオン
考える深さは effort で調整する。デフォルトは medium(Opus 5は high)
tool_choice の any や特定ツールの強制指定は使えない。auto と厳格なツール定義(strict)で代替する
Claude APIとGoogle Cloudでは、コンピュータ操作ツールが新しい computer_toolset_20260801 に切り替わる
思考が常にオンというのは、考えることが前提のモデルとして設計されてるってことなんだ。 オン・オフの二択じゃなく、effortで「どれくらい考えさせるか」を調整する思想に変わったと見ると、すっと腹に落ちると思う💡
🧩 Miccellの視点:「いちばん上を使う理由」が薄れていく
🔍 前回のGPT-6と、同じ方向を向いていた
前回の記事では、GPT-6 SolとLunaがAstraに加わって3モデルがそろい、用途に合わせて使い分ける形がはっきりした、という話をしたよね。 Sol・LunaのAPI料金は前世代の半額で、Solは自動化系のベンチマークでClaude Opus 5を上回ったとされてるんだ。
そして翌日に確認したOpus 5.5も、向いてる方向はまったく同じだったよ。 「最上位の性能を、一段下の価格で」。 OpenAIはAstraの手法を安いSolとLunaに降ろして、Anthropicは上位モデル級の性能をOpusに降ろした。 違う道筋から、同じ場所にたどり着いてる感じがする🤔 一社だけの値下げなら戦略の話で終わるけど、2社が続けて同じ答えを出してきたなら、業界全体の流れと見ていいと思う。
💡 選び方の軸が「最強」から「設計」へ
前回、GPT-6の3モデルを見て「最強を1つ選ぶ時代から、組み合わせる時代へ」と書いたけど、Opus 5.5でその確信がもう一段強くなったんだ。
これまでは「難しい仕事ほど最上位モデル」という選び方が自然だったよね。 でもOpus 5.5みたいに、上位モデルの性能が一段下の価格帯に降りてくると、話が変わってくる。 最上位を使う理由は「本当にそこでしか解けない仕事」だけに絞られていくんだ。
じゃあ代わりに何が大事になるのか。 僕は「どの仕事にどのモデルをどれだけ考えさせるか」の設計だと思う。 effortで思考の深さを細かく決められて、サブエージェントに仕事を振る力も上がってる。 これって、ひとつの賢いAIにお願いする形から、得意分野の違うAIを組み合わせて回す形へ、道具の側が寄ってきてるってことなんだよね🤝 個々のツールの限界を、つなぎ方でカバーする。 その「仕組みで乗り切る」やり方が、ますます効く時代になってきたんじゃないかな。
もうひとつ見逃せないのが「結論から話す」改善なんだ。 これは賢さの向上というより、伝わり方の向上だよね。 AIの評価軸が、ベンチマークの点数から「人がどれだけ楽に受け取れるか」まで広がってきたサインだと僕は読んでる。
とはいえ、Astraに届かない領域もあるし、ベンチマークは結局ベンチマーク。 自分がいつも頼んでいる仕事で、Opus 5と並べて試してみるのがいちばん確かだと思うよ。
まとめ:性能は上位級、値段と口調は身近に
Claude Opus 5.5のポイントをまとめておくね。
Fable 5.1級の性能を、Opus 5より4割安いコストで実現
出力は30%以上高速化、回答は結論ファーストで読みやすく
アプリ利用者は利用上限の引き上げとリセット1回分つき
API利用者は思考の常時オンやtool_choiceの変更に注意
Sonnet 5.5とHaiku 5.5も数週間以内に登場予定
前回のGPT-6 Sol・Lunaに続き、Anthropicも上位級性能の低価格化へ
性能が上がったこと以上に、上位級の性能が「普段使いの価格」に降りてきたことに意味があるんだよね。 まずはいつもの質問を1つ投げて、答えの出だしが変わったかどうか確かめてみてほしいな✨
Miccell - 最強の座より結論ファーストの一言が効く日もある
#Claude #生成AI #AI #Anthropic #OpenAI #AIニュース #AIエージェント #ClaudeOpus #Opus55 #GPT6 #ClaudeOpus55