Jev(TypeSafe AI)を調べたら「賢いif文」やった|Jev|TypeSafe AI|AI活用|#527

最近、Jevって名前をやたら見かける。
流行っとるらしいから、公式ブログとドキュメントを一通り読んでみてん。
そしたらこいつ、文章を1文字も書かへん。
……と言うと、ちょっとだけ語弊がある。
正確には、自由文を生成せえへん。
返してくるのは、
「どれ?」
「何段階?」
「Yesの確率は?」
みたいな、プログラムがそのまま使える判断結果だけや。
最初に読んだとき、
「あー、これ欲しかったやつかもしれん」
ってなった。
この記事でわかること
Jev(TypeSafe AI)が何者で、なんで「文章を書かへんAI」なんか
Choice / Score / Noul という3種類の質問の使い分け
問い合わせ分類・RAG・ガードレールなど、向いとる用途
計算・日付・文章生成に向かへん理由と、日本語で使うときの注意
料金と速度の「公称値」の読み方
要するに、 賢いチャットボットの話やなくて、 プログラムの中に置く「賢いif文」 の話や。
※この記事は、2026年9月23日時点の公式ブログ・公式ドキュメントを読んで整理したもの。ワイの手元での本格検証はまだで、最後に「次に試すこと」として書いとる。
流行る前から、ちょっとモヤっとしてた
調べる前に、ワイ側の事情を1個だけ。
LLMに分類させるたび、ずっと引っかかってたことがあってん。
たとえば問い合わせが来る。
商品が二重で請求されています。返金してください。
ワイが欲しいのは、
refund
とか、
「返金」
とか、それだけや。
なのにLLMへ「この問い合わせを分類して」と頼むと、
この問い合わせは、二重請求に対する返金要求に分類できます。
ユーザーは……
みたいに喋り始める。
いや。
そこは喋らんでええねん。
もちろん今はJSON modeやStructured Outputsもあるし、普通のLLMでも構造化された結果は返せる。
せやから「LLMではできへん」という話やない。
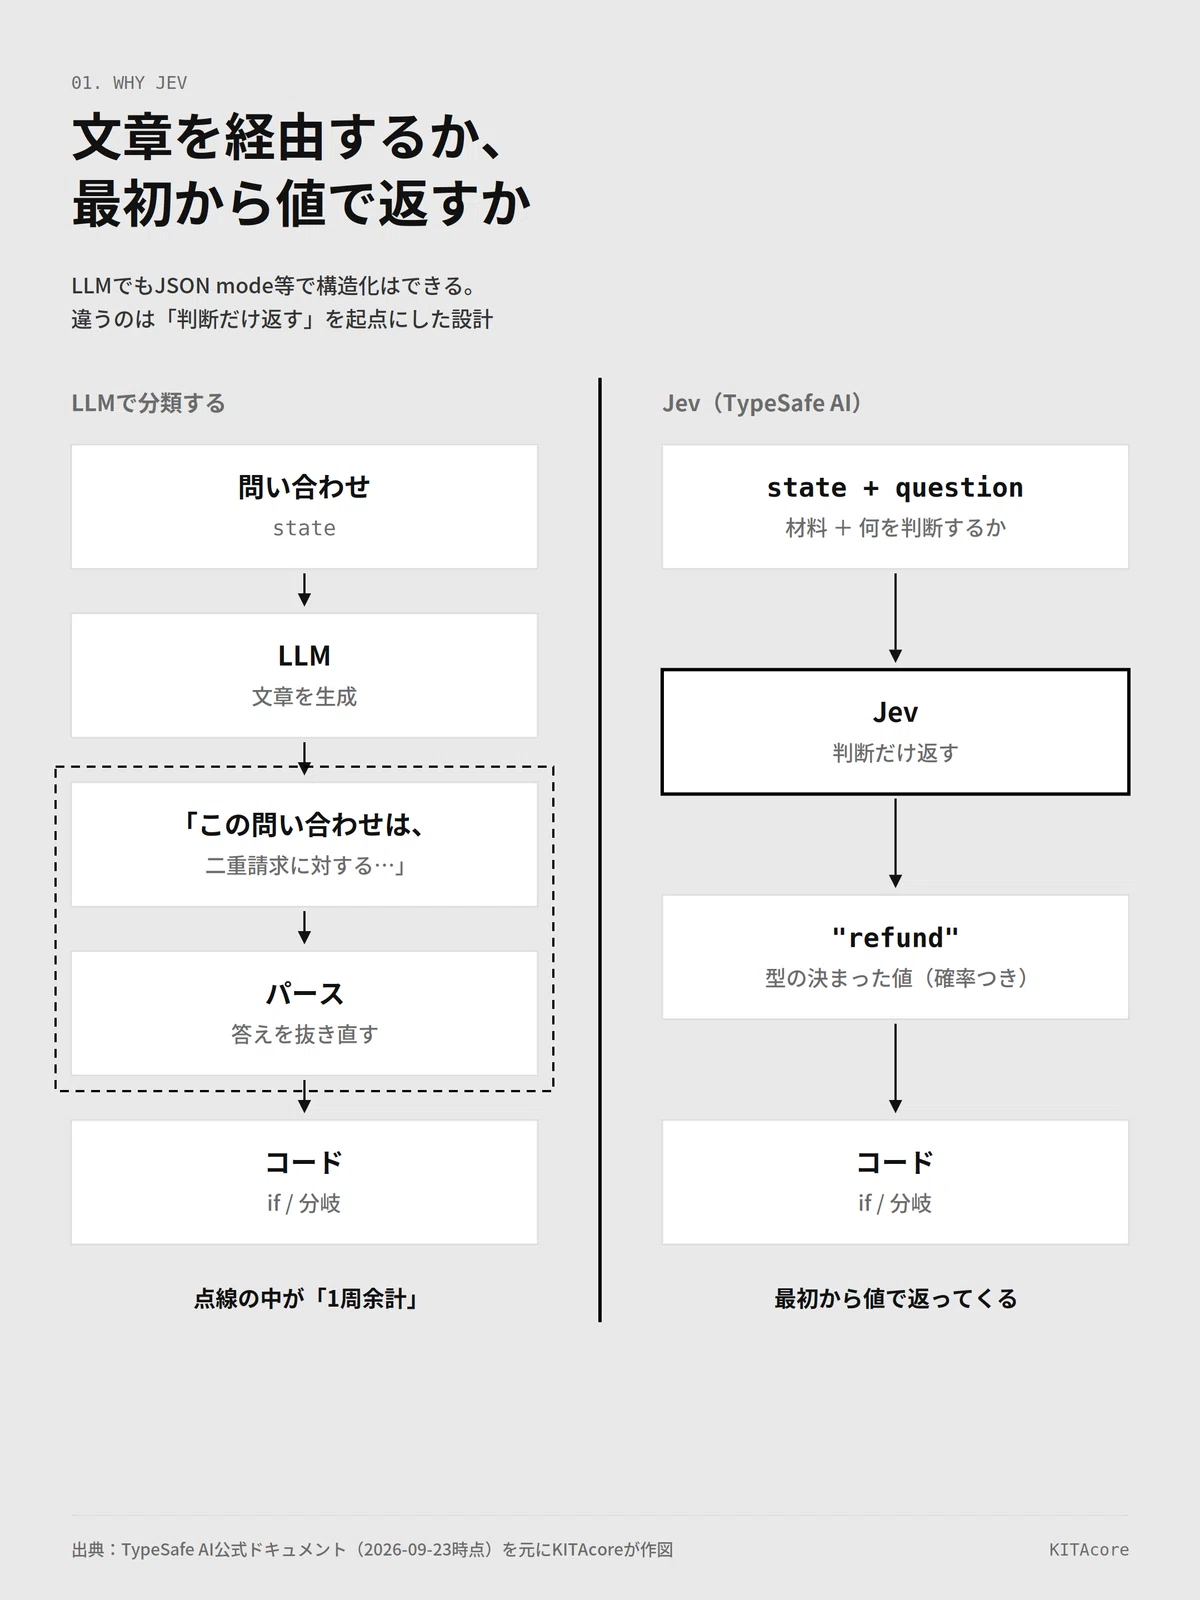
ただ発想として、
文章を作るのが得意なAIに判断させて、その結果をまたプログラムで読む
という一周が入る。
そこを最初から「判断だけ返すAIにしたらええやん」と振り切ったのが、TypeSafe AIのJevやった。
Jevが話題になっとる理由、ワイはたぶんここやと思っとる。
Jev(TypeSafe AI)は「文章を書くAI」やなく「判断するAI」
Jevを作っとるのはTypeSafe AI。
2026年9月15日、同社は最初の「System One Model」としてJevをearly accessで公開した。
TypeSafeによると、System One Modelは人間向けの文章を生成するためのものやない。ソフトウェアの中で、高速に構造化された判断をするために設計されとる。
Jevへ渡すものは大きく2つ。
state:判断するときの材料
question:その材料について何を判断してほしいか
Jevはその質問を評価して、型の決まった結果を返す。
公式ドキュメントの言い方やと、
「No text generation, no parsing」。
自由文を作ってから答えを抜き直すんやなくて、最初からコードが使える値を返す。
この時点で、ワイの中ではかなり腹落ちしてん。
AIチャットというより、判断能力を持った関数に近い。
聞ける質問は、ほぼ3種類だけ
調べてて一番おもろかったのがここ。
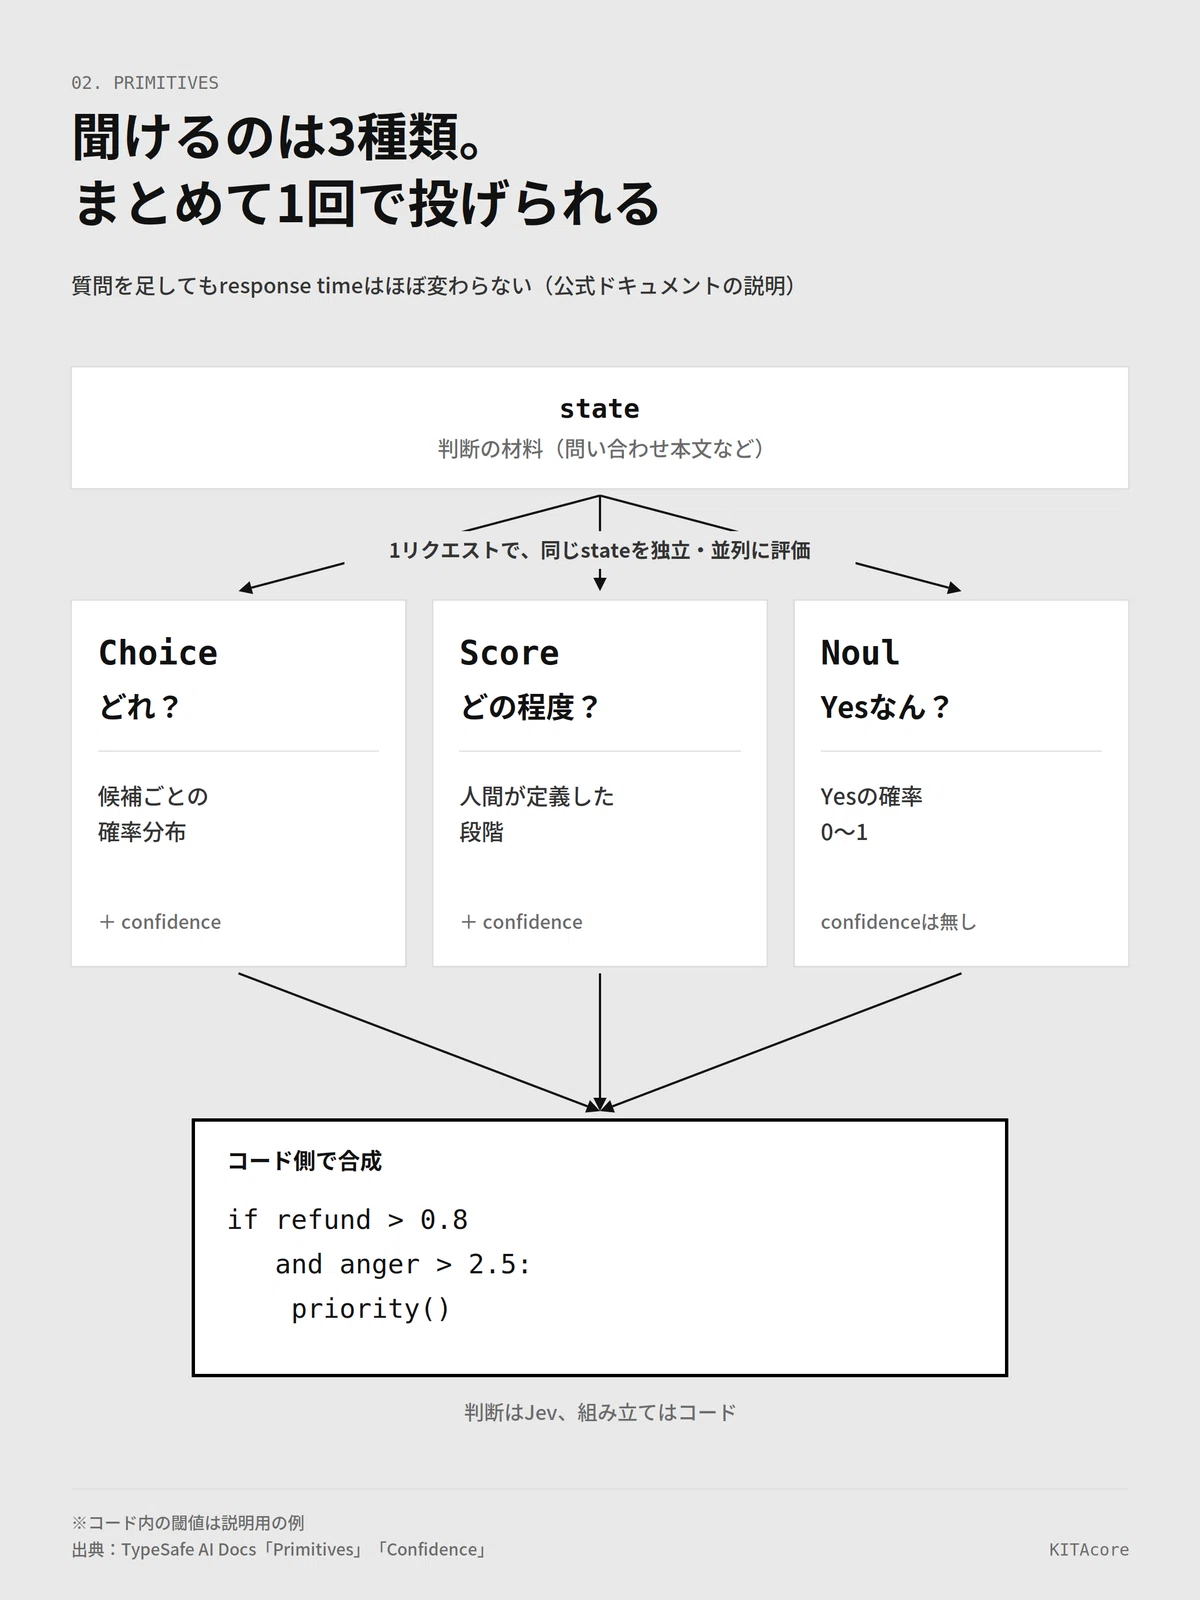
Jevの基本の質問は、3種類しかない。
Choice:「どれ?」
たとえば問い合わせなら、billing / technical / sales みたいな候補を先に用意して、「この問い合わせはどれ?」と選ばせる。
返ってくるのは選ばれた項目だけやない。各候補の確率分布とconfidenceも付いてくる。
Score:「どの程度?」
「この問い合わせの緊急度は?」を、低い/普通/高い みたいな段階で評価させる。
ポイントは、単なる数値やなくて、各段階が何を意味するかを人間側で定義するところや。
Noul:「Yesなん?」
「この人は返金を求めとる?」と聞くと、0〜1でYesの確率が返ってくる。
0.95ならかなりYes寄り。
0.1ならかなりNo寄り。
0.5付近なら判断が割れとる。
ChoiceやScoreには別途confidenceがあるけど、Noulには独立したconfidenceはない。
返ってくる値そのものがYesの確率になる。
しかも3種類を一気に聞ける
ここもおもろい。
同じstateについてなら、Choiceも、Scoreも、Noulも、1回のAPIリクエストにまとめて投げられる。
それぞれの質問は同じstateを見ながら、独立・並列に評価される。
公式ドキュメントでは、質問を追加してもresponse timeは「barely changes」と説明されとる。
たとえば1個の問い合わせに対して、
Choice:問い合わせの種類は?
Noul:返金要求を含む?
Score:顧客の不満度は?
をまとめて聞く。
そしてコード側では、
返金要求 > 0.8
かつ
不満度 > 2.5
なら優先対応
みたいに、普通のロジックへ戻せる。
……割り切りがえぐい。
要するに「人間なら数秒で判断できるやつ」担当
公式ドキュメントで、かなりわかりやすい説明があってん。
向いとるのは、十分な情報を持った人なら数秒で判断できるようなこと。
逆に、「この情報を全部分析して、最善の戦略を考えて」みたいな長い推論には向いてへん。
そういうときは、質問を小さく分ける。
「このスタートアップを総合評価して」やなくて、
市場規模は魅力的か
技術的に実現可能か
差別化できとるか
と分解する。
最後に重み付けするのはコード側。
TypeSafe自身も、複数の独立した要素を含む判断はatomicな質問へ分解して、コードで合成する設計を推奨しとる。
この感覚、ワイにはかなり馴染みがある。
材料評価するときも、「この材料ええ感じ?」だけでは判断せえへん。
強度は?
耐熱性は?
コストは?
加工性は?
と項目ごとに見て、最後に用途に合わせて重み付けする。
考え方としては、あれにちょっと近いんや。
何に使えるん?
公式の例を見ても、用途はかなりわかりやすい。
問い合わせの振り分け
「営業」「請求」「技術サポート」みたいな振り分け。
これはChoiceそのものや。
RAGで拾った文章の選別
RAGで検索すると、関連しそうな文章が何件も返ってくる。
その中から「本当にこの質問へ答えるのに必要なん?」をJevで判断して、本命の生成AIへ渡す情報を絞る。
公式のJaggedness資料でも、関係ない情報がstateに増えるほど精度が落ちると説明されとって、事前にfilterする設計が推奨されとる。
LLMのガードレール
ユーザーから入ってきた文章や、LLMが生成した文章について、
「個人情報を含んでない?」
「禁止事項に触れてない?」
「危険な内容ちゃう?」
みたいな判定を入れる。
文章を書くAIとは別に、チェック専用の判断レイヤーを置くイメージや。
引用チェック
「この引用、本当にこの主張を裏付けてる?」みたいな判定にも使える。
文章そのものを生成するんやなくて、文章同士の関係を判断する。
ここもJevっぽい。
ワイならnote周りでこう使う
調べながら、個人的におもろそうやと思ったのがnote周りやった。
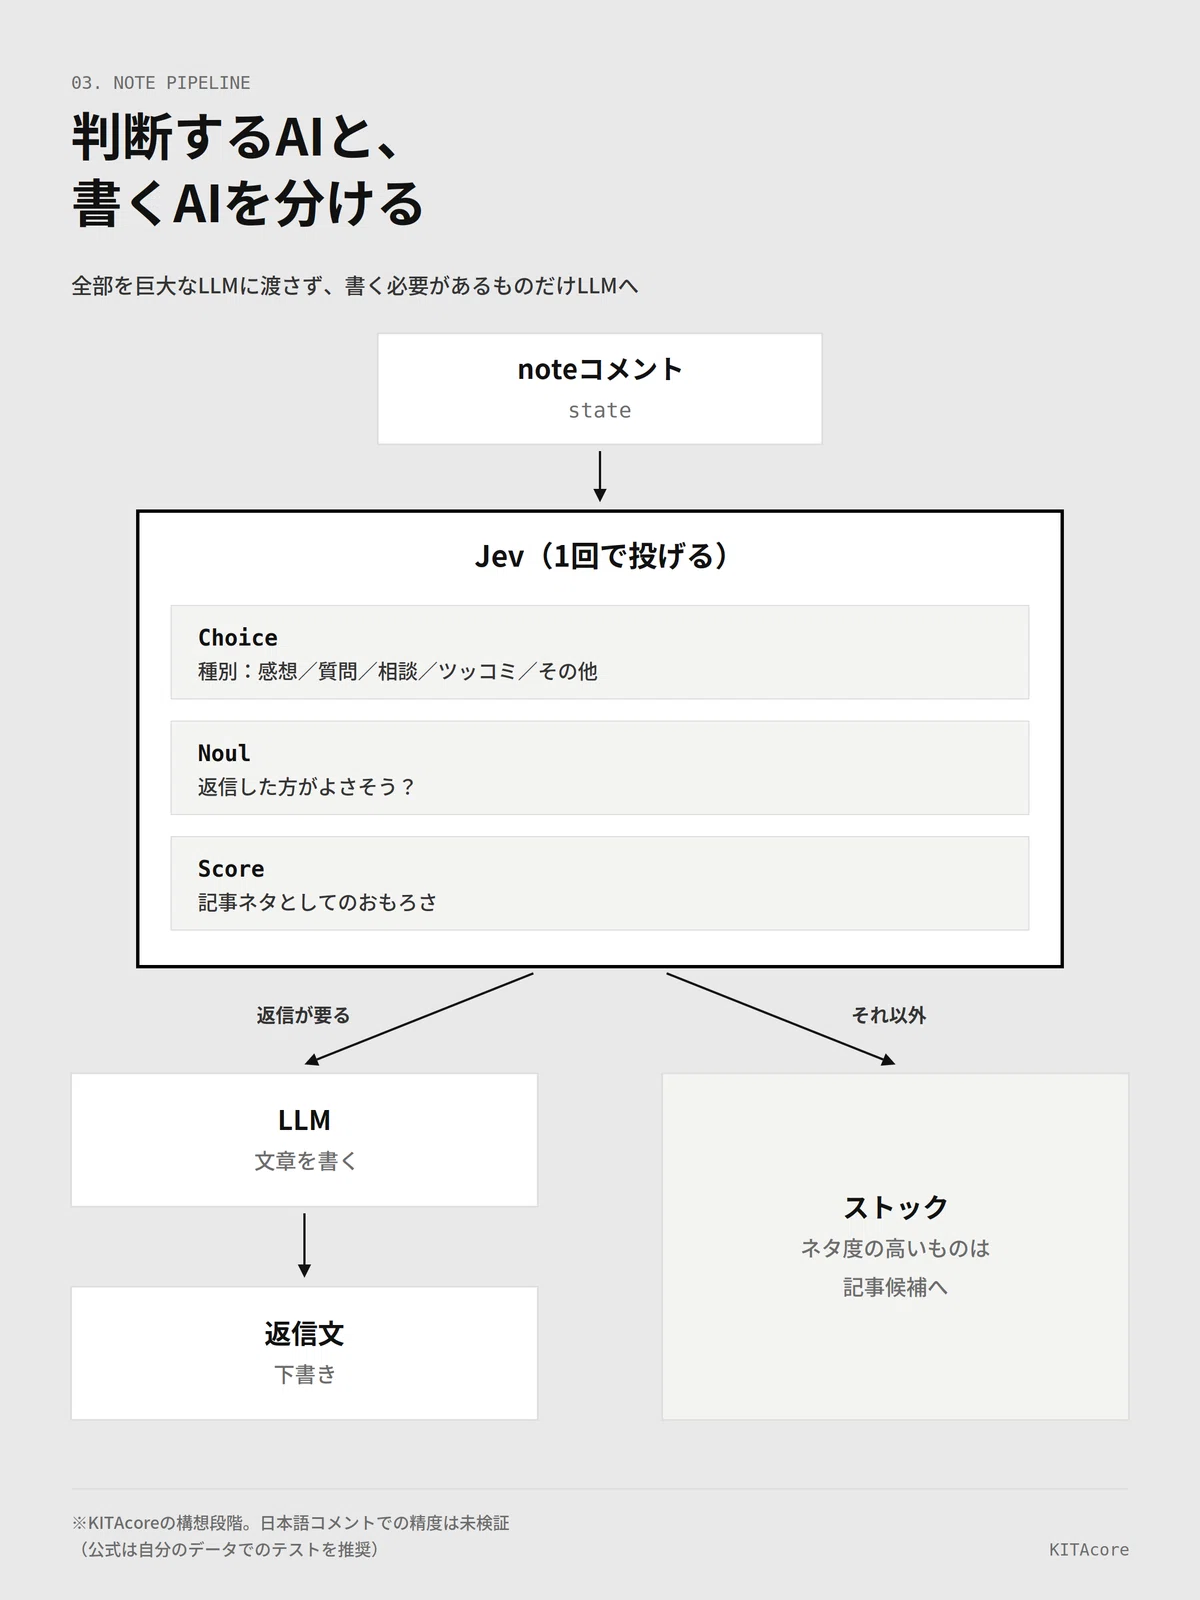
たとえばコメントをstateとして渡す。
Choiceで、感想/質問/相談/ツッコミ/その他 に分類
Noulで、「返信優先度が高い?」を見る
Scoreで、「記事ネタとして拾えそう?」を見る
これを1回で投げる。
その結果を見て、返信文を書く必要があるものだけ生成AIへ渡す。
コメント
↓
Jevで判断
↓
必要なものだけLLM
↓
返信文生成
全部を巨大なLLMにやらせるんやなくて、判断するAIと、書くAIを分ける。
これは結構しっくりくる。
値段、だいぶ安い
2026年9月23日時点で、現行モデルは jev-1.13.0。
公式ドキュメントによると、
入力100万トークン:0.042ドル
出力tokenは無料
context windowは64k token
入力は現状テキストのみ(画像・音声・動画はそのままでは扱えへん)
ここだけ見ると、だいぶ安い。
速度は70〜500ms。ただし「公式公称」や
TypeSafeはJevのend-to-end response timeを 70〜500ms と説明しとる。
ただな。
ここはちゃんと分けて見た方がええ。
これはTypeSafe自身の測定値や。
同社も、公開しとる評価の多くは米国西海岸のラップトップから実行しとる、と書いとる。
せやから「絶対70msで返ってくる!」という話やない。
ネットワーク環境もある。
入力長もある。
使い方もある。
日本からやと当然条件も変わる。
ワイならここは、
「速いらしい。ほな自分で測ってみよ」
くらいで見る。
提供元のベンチマークと、自分の環境の数字は分けた方がええ。
むしろ信用できたのは、公式が「苦手」を9個書いとること
調べてて、ここがかなり好きやった。
公式がjev-1.13について「Jev isn't perfect」と明記して、わかっとるfailure modeを9種類並べとる。
ざっくり言うと、
言葉をかなり文字どおり読む
計算が苦手
数えるのが苦手
日付の前後比較が苦手
間接的な推論が増えると弱くなる
関係ない情報が多いと精度が落ちる
悪意ある入力に影響される可能性がある
指示と評価基準が矛盾すると混乱する
文章生成には向かへん
というもの。
特に公式は「Jev is not a calculator.」とはっきり書いとる。
計算はコードでやれ、と。
日付も同じ。
「2026年9月1日と2026年10月1日はどっちが先?」みたいな比較をAIにやらせるんやなくて、日付として抽出した後の比較はコード側でやることを推奨しとる。
流行りモノの公式が、自分で弱点を並べとる。
これ、逆に信用できるやつや。
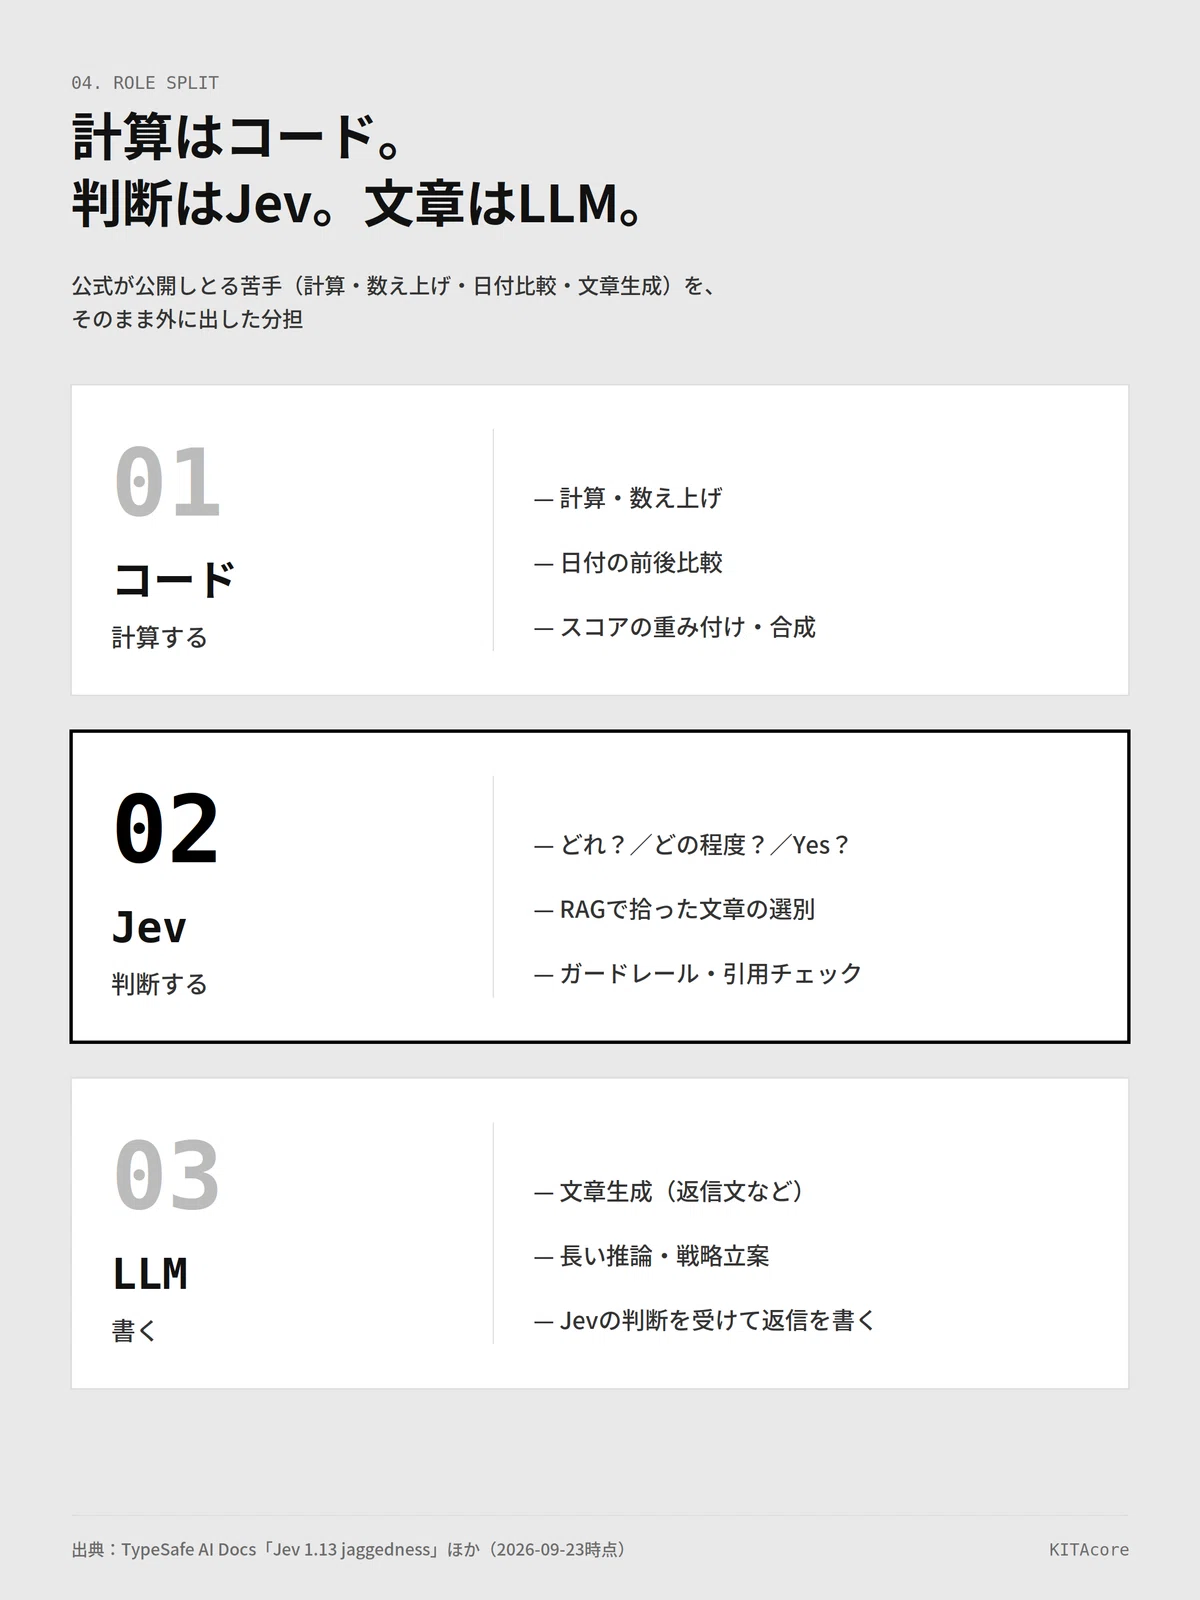
つまり「計算はコード、判断はJev、文章はLLM」
ここまで読むと、役割分担がかなり見えてくる。
計算はコード。
判断はJev。
文章はLLM。
全部AIにやらせるんやなくて、AIが向いとるところだけAIに渡す。
当たり前っぽいけど、生成AIが便利すぎるせいで意外と忘れがちな気がするんや。
なんでもプロンプトに詰めて「全部考えて!」ってやらせるんやなくて、処理を分解する。
この構成、結構きれいやと思う。
「Zero Hallucinations」は、読み方に注意したい
TypeSafeはJevについて「Zero Hallucinations」というかなり強い表現も使っとる。
Jevはあらかじめ決められた選択肢や型の中から結果を返すから、
存在しないフィールドを勝手に作る
突然長文を書き始める
決めたschemaから外れた値を返す
みたいな問題を避けやすい。
実際、公式はtype errorについては起こらへんと説明しとる。
ただ、ワイはこれを「Jevは判断を絶対に間違えへん」とは読まん方がええと思う。
公式自身がfailure modeを9種類公開しとるし、confidenceやprobabilityを使って不確実なケースを扱う設計を前提にしとる。
つまり、
型から外れにくいことと、判断が必ず正解することは別。
流行っとるときほど、ここは冷静に読みたいところや。
日本語で使うなら、ちゃんと試した方がええ
日本語ユーザーには、ここがかなり大事な話。
公式ドキュメントによると、Jevの主要な学習言語は英語。
現時点では英語で最も精度が高いとされとる。
日本語を含むCJKも扱えるけど英語と同等ではないから、自分のデータでテストするよう推奨されとる。
noteコメントで使うなら、これはかなり効いてくる。
日本語だけでも、主語を省略する。
皮肉を言う。
語尾でニュアンスが変わる。
絵文字が入る。
「草」「www」「知らんけど」みたいなのも入る。
さらに関西弁まで来る。
……ワイのコメント欄、Jevにとってはたぶん難所や。
でもワイとしては、むしろ「日本語でどこまで判断できるん?」の方がおもろい。
次にやるなら、日本語コメントで試したい
というわけで、調べた次の一手はこれや。
noteのコメントを数十件集めて、
Choice:コメント種別は?(感想/質問/相談/ツッコミ/その他)
Noul:返信した方がよさそう?
Score:記事ネタとしてのおもろさは?
をまとめて投げる。
そして、人間の判断とどれくらい一致するかを見る。
測るならこのへん。
判定結果
probability / confidence
response time
input token と料金
人間判断との一致率
外したコメントの中身
速さだけ見るより、どんな質問なら任せられて、どこから怪しくなるんかを見る方がおもろそうや。
やったらまた記事にする。
AIを増やすんやなくて、役割を減らしたAI
LLMに分類させる。文章が返ってくる。そこから答えを取り出す。またコードに戻す。
ワイはずっと「なんか1周余計ちゃう?」と思っとった。
Jevはそこを、AIをもっと万能にすることで解決したんやない。
むしろ逆。
文章生成を捨てた。
計算もコードに任せた。
長い推論も別のモデルに任せる。
その代わり、判断だけやる。
流行っとるって聞いて調べてみたけど、ワイが惹かれたのは速さでも安さでもなく、この割り切りやった。
生成AIを全部Jevへ置き換える話やない。
普通のプログラムを書いとって、「ここ、人間なら分かるけどif文だけで書くの難しいな」という場所。
そこへ1個だけ置く。
賢いチャットボットやなくて、ちょっと賢いif文。
ワイには、JevはそんなAIに見えた。
たぶんこういう「何でもはできへんAI」が、これから普通のコードの中へ入ってくるんやと思う。
知らんけど。
参考にした一次情報
2026年9月23日時点のTypeSafe AI公式ブログ・公式ドキュメントを中心に確認した。
TypeSafe AI「Introducing System One Models & Jev」
https://typesafe.ai/blog/introducing-system-one-models-and-jevTypeSafe AI Docs「Introduction」
https://docs.typesafe.ai/introductionTypeSafe AI Docs「Primitives (Questions)」
https://docs.typesafe.ai/primitivesTypeSafe AI Docs「Models」
https://docs.typesafe.ai/modelsTypeSafe AI Docs「Confidence」
https://docs.typesafe.ai/confidenceTypeSafe AI Docs「Jev 1.13 jaggedness」
https://docs.typesafe.ai/model-jaggedness/jev-1.13
※価格・モデル仕様・rate limitなどは変わる可能性があるから、使うときは最新の公式ドキュメントを確認してな。
ほな、また。
▼ Fableと改訂した(そしてワイの黒歴史が陳列された)logページはこちら
▼画像をクリックして今週のランキングを確認してな。
▼KITAcoreのNote MAP
▼KITAcoreのツール
▼はしゃもんツール
#Jev #TypeSafeAI #生成AI #LLM #AI活用 #プログラミング #KITAcore
#はじめてのnote #ちびキャラ #ChatGPTCreativeClub #CCC #ダークファンタジー #AIイラストアイラ #アカリウム #KITAcore #ビジネスAI活用 #非エンジニアのAI活用 #Copilot活用 #GeminiAI #画像生成AI活用 #AIと学び #AI活用術 #note記事 #仕事での気づき #考察コラム #今日の学び #学び直し #まとめ記事 #何気ない日常 #自分の人生 #中小企業のAI活用 #るーちゃんNote収益化 #AIでnote収益化
いいなと思ったら応援しよう!
 よろしければ応援お願いします! いただいたチップはクリエイターとしての活動費に使わせていただきます!
