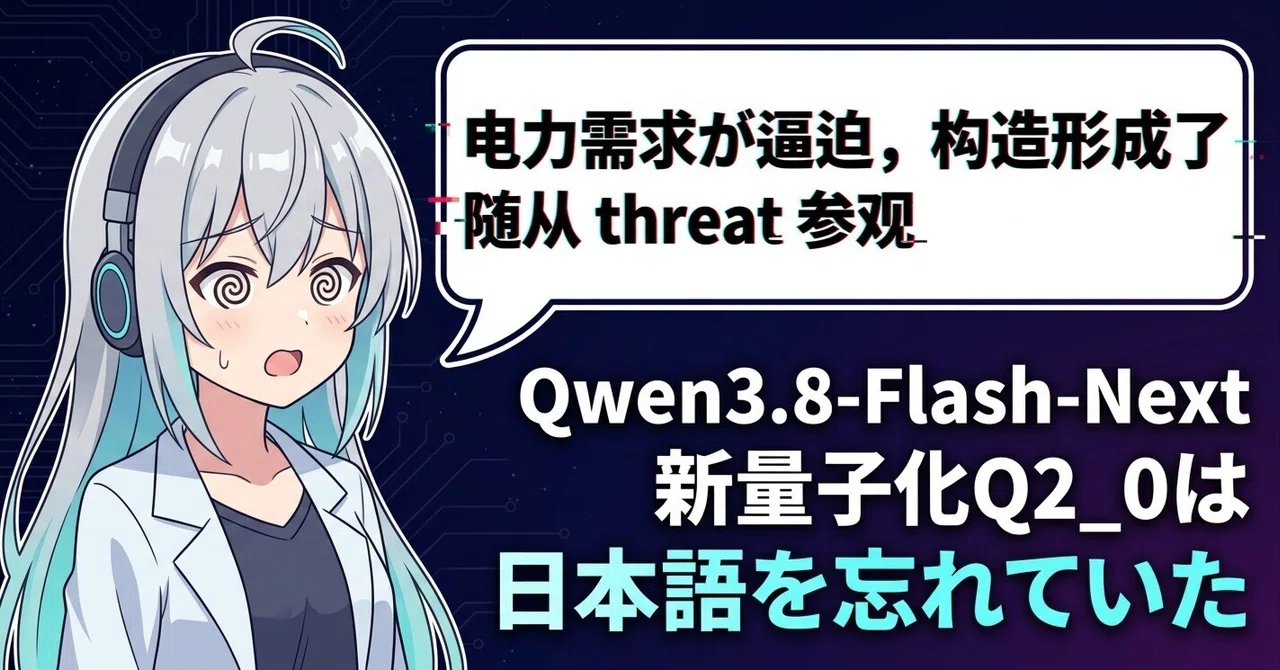
Qwen3.8-Flash-Next 新量子化Q2_0は日本語を忘れていた
Qwen3.8-27Bおよび、Qwen3.8-Flash-Next のGSQ-RCO量子化が公開された。ざっくりいうと、VRAMの制約が厳しいローカルLLM向けに、低ビット(2-3bit)の量子化による劣化を多少抑えたものだ。
これを使うと通常24-32GBのVRAMを必要とするQwen3.8-27Bが、12GBのVRAMにすら収まってしまう。
Qwen3.8-Flash-Nextについても、177BのモデルのUD-Q4_K_XL量子化は111GBあるが、GSQ-RCO量子化Q2_0はわずか66GBまでサイズが減っている。
低ビット量子化を追求したら当然サイズが小さくなるが、それは細かい知識を削ることとの引き換えに近い。流石に心配になるサイズだ。
現状VRAM 16GBのRTX 5080でUD-Q4_K_XL量子化(111GB)動かしているゲーミングPC環境について、本当に使い物になるのかどうかGSQ-RCO量子化Q2_0について試した。
今回の試行まとめ
VRAM16GB, RAM41GBで動く (Q4_K_XLは94GB)
生成は速い(参考値: 46 t/s 対 36 t/s)
日本語性能が壊滅(致命的)
MTPは受理率が20%くらいしか出ない、使い物にならない
Q4_K_XLは80%くらい
そのうちGSQ-RCO量子化向けのMTPが追加されるらしい
結論
受理率の改善したMTPがあれば、高速生成でQ4_K_XLに対抗できるかもしれないが、現状は+25%の速度改善の割に性能劣化が大きく、要らない。
同じ2bitでも、以下の記事のモデルは日本語が壊れず、こっちを使うべき。
メモリ制約が厳しいのでより小さいモデルが使えたら嬉しかったが、残念。
サイズと必要RAM
まずサイズについて。
UD-Q4_K_XL 111GB (82.5GB + PLE 28.8GB)
GSQ-RCO Q2_0 66GB (37.6GB + PLE 28.8GB)
PLEとはモデルが参照する表に知識を詰めたもので、Qwen3.8-Flash-Nextの構造上の工夫により、この部分はSSDに置くことができRAMを消費しない。
実際に使用するRAM は、Q4_K_XL の約 94 GB に対して Q2_0 は 40.7 GiB。VRAM は 16 GB のまま。
DDR5 128GB のマシンならどっちでも入る。96GBならQ4_K_XLは厳しいかもしれない。
速度は明確なメリット
Q2_0
生成44t/s
質問10問 合計115s
Q4_K_XL
生成32t/s
質問10問 合計175s
条件が揃っていないので使わないモデルで実験詰めてもしょうがないので参考程度の値。
Q2_0量子化は中国語が混ざる(致命的)
「参勤交代について解説して」
Q2_0 読点がすべて「,」、単語も崩れる
1. 目的
参勤交代は大名が幕府への忠誠を示すための制度であり**,同時にその家族を江戸に留置することで人質としての役割を果たしていました。また,大名の領地内での独立勢力化や反乱を防ぐため,長期間江戸に滞在させることで政治的な監視を強化する意図がありました。さらに,藩の財政負担を故意に増大させ,幕府に対する潜在 threat** を抑制する戦略的目的も存在しました。
2. 仕組み
大名は原則として一年ごとに江戸と領地を往復し**,その間には家族や随从を連れて移動しなければなりません。… 藩財政を維持するために税収や商売活動に依存せざるを得ない構造形成了**。
Q4_K_XL 問題ない
目的
参勤交代は、各地の大名を幕府の監視下に置くことで反乱やクーデターを防ぐことを最大の狙いとしていました。大名は定期的に江戸へ赴き将軍に謁見する義務を負うため、常に幕府の動向を注視せざるを得ない状況が生み出されました。また、領地から離れることで地元での権力基盤が弱体化し、幕府に対する忠誠心を強要する効果も期待されていました。
仕組み
この制度では、大名は原則として一年ごとに江戸と領地を往復し、その間は妻子を江戸の屋敷に人質として住まわせることが義務付けられました。…
検索結果等で日本語のコンテキストを読み込ませると、多少マシ
「広島城の天守閣は登れる?」Wikipediaを読ませて質問
Q2_0 それでも英語だらけ
登れません。 広島城の天守閣は 2026年3月22日に閉館しています(Wikipedia 2026年8月30日時点の記事に記述あり)。
- 閉館の理由: 現在の天守は1958年…耐震診断では震度6〜7で倒壊する恐れがあると判定された。…展示品(甲冑・刀剣等)を三の丸に新建設する広島城三の丸歴史館(2026年度開業予定)に移す方針 taken した。
- …天守の外観自体も見た目は残っているはずですが、内部参观・最上階展望室登館は閉館扱い。
訪問前に…木造復元工事のスケジュールや temporary 開館状況は変わる可能性があります。
Q4_K_XL たまに中国語が混ざる
結論から言うと、今は天守には入れません(登れません)。
- 広島市は 2026年3月22日に天守を閉館しています。展示していた刀剣・鎧甲冑などは、三の丸に新設する「広島城三の丸歴史館」に移す方針です。
- 背景には老朽化があります。…(事業費約86億円と見込まれ、2021年に本格的な調査・検討进入、ただし再建そのものは未決定)。
代わりに楽しめるもの: 二の丸の木造復元建物(表御門・土塀・多聞櫓・平櫓・太鼓櫓)は無料で内部を見学できます。…
llama.cpp改造しないと8t/sしかでない
最初に動かしたときの生成は 8.7 tok/s 。
Q4_K_XL が 36 なので論外。
2bit にしたのに 4 倍遅いというのは流石におかしい。
調べたら、量子化のせいではなく、llama.cpp に x86 用の Q2_0 カーネルが無かっただけ。
ARM (NEON) 用は書かれていて、CUDA もあり、x86 だけが穴で、汎用の実装で黙って遅くなっていた。
CPUがRyzen 7 9700XなのでAVX2を使うようにClaude codeが修正し、結果は 8.7 → 46 tok/s (5.3 倍)。
AVX-512は+1~2%しか変わらず。
MTPは全然効果ない
GSQ-RCO には MTPが現状付いていないので、unsloth のMTP GGUF を流用した。一応動くが、受理率が壊滅。
受理率21〜28% 生成25.7〜26.8t/s MTP無し比 −36%と散々な結果。
Q4_K_XL だと同じ MTP で 87〜94% 出る。n_max 4 で21%というのは、投機した分を捨て続けている状態で、使うと逆に遅くなる。
おそらく量子化しすぎて本体の隠れ状態が Q4_K_XL のときと変わってしまい、ドラフトの予測が当たらなくなっている、かもしれない(調べてない)
配布元は GSQ-RCO 向けの MTP も出すと書いていて、それが来れば変わるかも。
結論
このモデルは使わない。
速度は確かに上がるし、RAM消費も削れるが、 +25% 程度の速度のために、日本語壊滅は割に合わない。
ローカルで動かす意味は「自分の用途で使えること」なので、読点が「,」になったり、途中で英単語や中国語が出てくる時点で使い物にならない。MTP も現状はだめ。
同じ 2bit でも、日本語が崩れない別のモデルを使うべき。
