1.概要
1-1.緒言
本記事は”学習シリーズ”として自分の勉強備忘録用になります。
過去の記事で機械学習・AIの記事を多数作成しましたが、シンプルな線形モデルは外挿が比較的得意のためいろんな分野で使用されます。
前回記事に引き続き、本記事では重回帰分析を紹介します。
1-2.用語・記号の説明(全般)
本記事で使用する用語および記号は下記の通りです。
1-2-1.用語一覧
●回帰 (regression):実数値を予測する問題
●分類 (classification):カテゴリ(離散値)を予測する問題
●教師あり学習 (supervised learning):機械学習でデータセットに対して正解値(ラベル)がある学習方法
●教師なし学習 (unsupervised learning):機械学習でデータセットに対して正解値(ラベル)が無い学習方法
●予測値 (predicted value):関数で計算された出力変数y(用語は下記参照)
●目標値 (target value):予測値がとるべき値(教師あり学習の正解値)
●目的関数 (objective function):機械学習において性能の良さの指標を表す関数です。一般的には”予想値と目標値の差異”から作成される関数であり、この関数を最小化することでよいモデルと判断します。
●多重共線性(multicollinearity):多変量解析(重回帰分析など)において、いくつかの説明変数間で線形関係(強い相関関係)があると共線性といい、共線性が複数認められる場合は多重共線性があると言います。
●二乗和誤差 (sum-of-squares error):正解値yと予測値y^の差の2乗(y−y^)2です。これをモデルと正解値の誤差とも呼びます。
●最小二乗法:二乗和誤差を最小化することでモデルの当てはまりを最適化する手法です。
1-2-2.記号一覧
●f():y=f(x)におけるf()であり関数と呼びます。中身は入力変数xを処理して新しい出力変数yを生成する計算式です。
●x:y=f(x)におけるxです。複数は下記の通り複数あります。
名称1:説明変数(Explanatory variable)
名称2:独立変数(Independent variable)
名称3:外生変数(Exogenous variable)
名称4:入力変数(Input variable)
名称5:入力値(Input value)
●y:y=f(x)におけるyです。複数は下記の通り複数あります。
名称1:目的変数(Response variable)
名称2:従属変数(Dependent variable)
名称3:被説明変数(Explained variable)
名称4:内生変数(endogenous variable)
名称5:出力変数(Output variable)
名称6:予測値/推論値(prediction value)
●wi(weight):重み(単回帰の場合は傾きとも言う)
●b(bias):バイアス(単回帰の場合は切片とも言う)
1-2-3.ベクトル・行列表記一覧
●M次元の縦ベクトル:x
x=x0x1x2⋮xM
●M次元の横ベクトル(縦ベクトルの転置):xT
xT=[x0x1x2…xM]
●N×M次元の行列(M次元をもつN個のデータ):X
X=x10x20x30⋮xN0x11x21x31⋮xN1x12x22x32⋮xN2⋯⋯⋯⋱⋯x1Mx2Mx3M⋮xNM=x1Tx2T x3T⋮xNT
1-3.サンプル用データ:Diabetes
サンプルデータはScikit-learnのToy datasetsを使用します。今回は回帰(Regression)のため"diabetes"を使用しました。重回帰は多次元の変数を取得できますが、可視化しやすいよう特徴量として重要な"s5"と"bmi"の2つだけ抽出しました。
[IN]
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
from sklearn import datasets
diabetes = datasets.load_diabetes()
data, target = diabetes.data, diabetes.target
df_data = pd.DataFrame(data, columns=diabetes.feature_names)
df_data = df_data[['s5', 'bmi']]
print(type(df_data), df_data.shape, type(target), target.shape)
plt.rcParams['font.size'] = 14
fig = plt.figure(figsize=(10, 10), facecolor='w')
ax = Axes3D(fig)
ax.scatter(df_data['s5'], df_data['bmi'], target, c='b', marker='o', s=50)
ax.set(xlabel='s5', ylabel='bmi', zlabel='target')
plt.grid()
plt.show()
[OUT]
<class 'pandas.core.frame.DataFrame'> (442, 1) <class 'numpy.ndarray'> (442,)
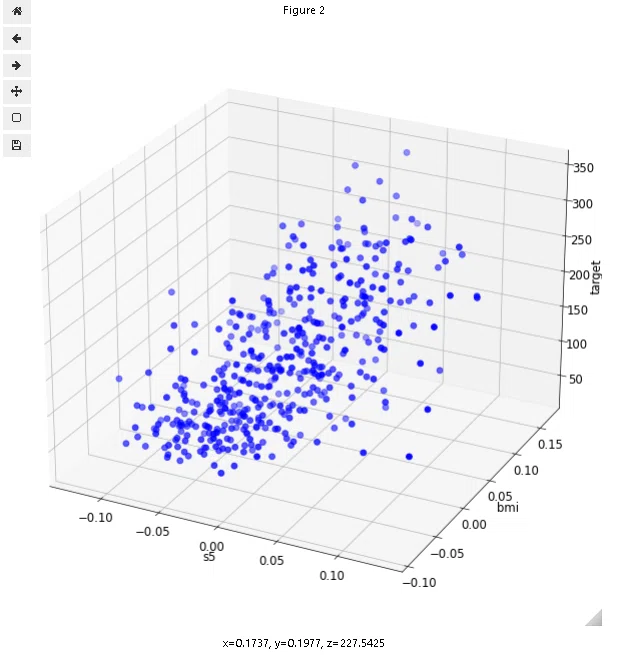
【補足:3Dプロットのinteractive化】
3DプロットをJupyter内で触れるように"ipympl"をインストールしてコード内に"%matplotlib qt"を追加しました。
[Terminal]
pip install ipympl
2.重回帰モデル
2-1.重回帰モデルとは
単回帰分析が「1 つの入力変数xから 1 つの出力変数yを出力するモデル」に対して、重回帰分析は「複数の入力変数xから 1 つの出力変数yを出力するモデル」です。よって単回帰の多次元拡張版モデルのようなものになります。
単回帰と同じで、重回帰はモデルの解釈性が非常に高く外挿での動作も理解しやすいモデルとなります。
●x:入力変数
●y:出力変数
●w:重み(単回帰での傾きaと同等)
●b:バイアス(単回帰での切片と同等)
単回帰:y=wx+b
重回帰:y=w1x1+w2x2+⋯+wMxM+b=m=1∑Mwmxm+b
M次元の入力変数xにx0=1を追加してM+1次元とし、同様にM次元の重みwにw0=bを追加すると下記へ変換できます。
y=w1x1+w2x2+⋯+wMxM+b=w1x1+w2x2+⋯+wMxM+w0x0=w0x0+w1x1+⋯+wMxM=m=0∑Mwmxm
2-2.重回帰を行列に変換
重回帰は多次元のためベクトル・行列で表され、直接解法も行列で計算するため行列式で表現する方が便利となります。
重回帰を重みwと説明変数xのベクトルの内積で表現するることができます。なお注意点は下記の通りです。
バイアスbはx0=1, w0=bよりw0x0=bで存在
バイアスbを含むためw, x共にM+1次元
ベクトル同士の内積を計算するために、重みwは転置
【データ数が1個(1行の行列):1×(M+1)行列】
y=w0x0+w1x1+⋯+wMxM=[w0w1⋯wM]x0x1⋮xM=wTx
【データ数がN個(N行の行列):(N×(M+1)行列)】
y=y1y2y3⋮yN=x1Twx2Twx3Tw⋮xNTw= w10x10+w11x11+w12x12+⋯+w1Mx1Mw20x20+w21x21+w22x22+⋯+w2Mx2M w30x30+w31x31+w32x32+⋯+w3Mx3M⋮wN0xN0+wN1xN1+wN2xN2+⋯+wNMxNM
=x10x20x30⋮xN0x11x21x31⋮xN1x12x22x32⋮xN2⋯⋯⋯⋱⋯x1Mx2Mx3M⋮xNMw0w1w2 ⋮wM=Xw
3.直接解法の計算
深層学習(ディープラーニング)などではモデルの学習時に誤差逆伝搬を使用して学習させますが、重回帰の重みとバイアスは直接計算可能です。
最小二乗法を用いて誤差が最小になるパラメータを直接計算してみます。
3-1.結論
結果は下記の通りであり「Normal Equation(正規方程式)」と呼ばれるものになります。
w=w0w1w2 ⋮wM=bw1w2 ⋮wM=(XTX)−1XTt
3-2.記号の定義一覧
各種変数を示します。参考として統計用語は下記記事をご確認ください。
●データ数N, M+1次元(バイアス項含む)の説明変数:X∈RN×(M+1)
X=x10x20x30⋮xN0x11x21x31⋮xN1x12x22x32⋮xN2⋯⋯⋯⋱⋯x1Mx2Mx3M⋮xNM
●データ数Nの出力変数(推論値):y
y=y1y2y3⋮yN
●バイアスを含むM+1次元の重みベクトル:w∈RM+1
w=bw1w2 ⋮wM=w0w1w2 ⋮wM
●データ数Nの正解値(ラベルデータ):t
t=t1t2t3⋮tN
●最小二乗誤差関数:Loss
Loss= n=1∑N(tn−yn)2=(t1−y1)2+(t2−y2)2+⋯+(tN−yN)2
ベクトルに変換すると
Loss=(t1−y1)2+(t2−y2)2+⋯+(tN−yN)2=[t1−y1t2−y2⋯tN−yN]t1−y1t2−y2⋮tN−yN=(t−y)T(t−y)
3-3.重みとバイアスの導出
3-3-1:二乗和誤差の計算
まずは最小化したい二乗和誤差Lossを計算します。計算には下記転置の公式を使用しました。
【転置の公式】
●(AB)T=BTAT
●(ABC)T=CTBTAT
Loss=(t−y)T(t−y)=(t−Xw)T(t−Xw)={tT−(Xw)T}(t−Xw)=(tT−wTXT)(t−Xw) =tTt−tTXw−wTXTt+wTXTXw
w∈RM+1, X∈RN×(M+1), t∈RNより(tTXw)Tの内積を計算すると値はスカラーとなります。
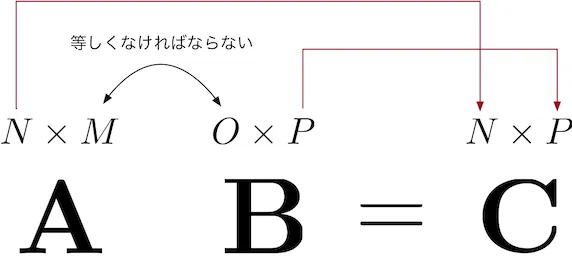
(tTXw)T=R1×NRN×M+1R(M+1)×1=R1×1
スカラーは転置しても形状変化がないため値も変化ありません。また転置の公式を適用すると下記の通りとなります。
tTXw=(tTXw)T=wTXTt
上式をLossの計算結果に代入すると下記が算出できます。
Loss=tTt−2tTXw+wTXTXw
3-3-2.wでの偏微分を計算
二乗和誤差Lossをwでまとめると下記の通りです。
Loss=tTt−2tTXw+wTXTXw=tTt−2(XTt)Tw+wTXTXw=c+bTw+wTAw
各定数A, B, cはそれぞれ下記の通りです。
A bc=XTX=−2XTt=tTt
Lossのwでで偏微分の式は下記の通りです。
∂w∂Loss=∂w0∂Loss∂w1∂Loss⋮∂wM∂Loss=00⋮0
下記変形式を元にLossの偏微分を変換すると下記の通りとなります。
【変形式】
∂x∂(aTx)=[∂x1∂(a1x1+a2x2⋯+anxn)∂x2∂(a1x1+a2x2⋯+anxn)⋯∂xn∂(a1x1+a2x2⋯+anxn)] =[a1a2⋯an]=aT
∂w∂Loss=∂w∂(c+bTw+wTAw)=∂w∂(c)+∂w∂(bTw)+∂w∂(wTAw)=0+bT+wT(A+AT)
誤差の最小は傾き∂w∂Loss=0より、①A=XTX, b=−2XTt を展開、②両辺を転置してwTの転置を戻すと下記の通りです。
−2(XTt)T+wT{XTX+(XTX)T}−2tTX+2wTXTXwTXTX(wTXTX)TXTXw=0=0=tTX=(tTX)T=XTt
最後にXTXに逆行列が存在すると仮定して、両辺に左側から(XTX)−1をかけると重みwの解が求まります。この式を正規方程式 (normal equation) と呼びます。
(XTX)−1XTXwIww=(XTX)−1XTt=(XTX)−1XTt=(XTX)−1XTt
4.単回帰モデルの実装:スクラッチ編
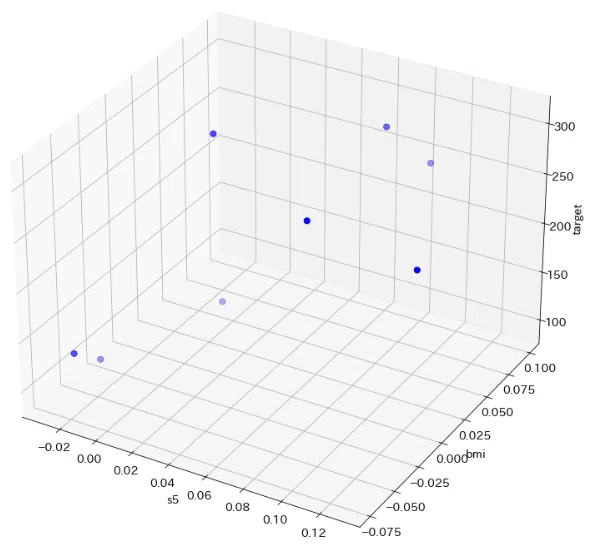
動作を理解するためにPythonのライブラリを使用せずスクラッチで計算します。目視で確認できるようにデータ数を1桁に調整しました。
[IN]
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
import japanize_matplotlib
import seaborn as sns
import os
from sklearn import datasets
from sklearn.model_selection import train_test_split
diabetes = datasets.load_diabetes()
data, target = diabetes.data, diabetes.target
df_data = pd.DataFrame(data, columns=diabetes.feature_names)
df_data = df_data[['s5', 'bmi']]
x_train, x_test, y_train, y_test = train_test_split(df_data, target, test_size=0.98, random_state=0)
print(f'x_train: {x_train.shape}, x_test: {x_test.shape}, y_train: {y_train.shape}, y_test: {y_test.shape}')
print(f'x_train: {type(x_train)}, x_test: {type(x_test)}, y_train: {type(y_train)}, y_test: {type(y_test)}')
_data = np.concatenate([x_train, y_train.reshape(-1, 1)], axis=1)
df_dataset = pd.DataFrame(_data, columns=['s5', 'bmi', 'target'])
display(df_dataset)
if not os.path.exists('data'):
os.mkdir('data')
print(f'ディレクトリを作成しました: {os.path.abspath("data")}')
df_dataset.to_excel('data/dataset_diabetes2dim.xlsx', index=False)
plt.rcParams['font.size'] = 14
fig = plt.figure(figsize=(10, 10), facecolor='w')
ax = Axes3D(fig)
ax.scatter(df_dataset['s5'].values, df_dataset['bmi'].values, y_train, c='b', marker='o', s=50)
ax.set(xlabel='s5', ylabel='bmi', zlabel='target')
plt.grid()
plt.show()
[OUT]
x_train: (8, 2), x_test: (434, 2), y_train: (8,), y_test: (434,)
x_train: <class 'pandas.core.frame.DataFrame'>, x_test: <class 'pandas.core.frame.DataFrame'>, y_train: <class 'numpy.ndarray'>, y_test: <class 'numpy.ndarray'>
s5 bmi target
0 0.014823 0.005650 311.0
1 0.007837 0.025051 122.0
2 0.084495 0.098342 243.0
3 0.129019 -0.007284 248.0
4 -0.029528 -0.030996 91.0
5 0.079121 -0.021295 281.0
6 -0.018118 -0.073030 142.0
7 0.073410 0.071397 295.0
4-1.Pythonで計算:Numpy
結論として、求める重みwの計算式は下記の通りです。
w=bw1w2 ⋮wM=w0w1w2 ⋮wM=(XTX)−1XTt
説明変数Xと目的変数tは下記を使用します。
X=0.01480.00780.08450.1290−0.02950.0791−0.01810.07340.00560.02510.0983−0.0073−0.0310−0.0213−0.07300.0714
t=31112224324891281142295
Xにはバイアス項として1列目に1を追加します。
X=111111110.01480.00780.08450.1290−0.02950.0791−0.01810.07340.00560.02510.0983−0.0073−0.0310−0.0213−0.07300.0714
順序通りに計算すると下記解が得られます。
w=(XTX)−1XTt=bw1w2 =w0w1w2=175.4926.9199.3
[IN]
X = df_dataset[['s5', 'bmi']].values
t = df_dataset['target'].values
bias = np.ones((X.shape[0], 1))
X = np.concatenate([bias, X], axis=1)
X_T = X.T
X_TX = np.dot(X_T, X)
X_TX_inv = np.linalg.inv(X_TX)
X_TX_inv_X_T = np.dot(X_TX_inv, X_T)
weights = np.dot(X_TX_inv_X_T, t)
print('説明変数X')
display(X)
print('\nXの転置行列X_T')
display(X_T)
print('\nX_TとXの行列積X_TX')
display(X_TX)
print('\nX_TXの逆行列X_TX_inv')
display(X_TX_inv)
print('\nX_TX_invとX_Tの行列積X_TX_inv_X_T')
display(X_TX_inv_X_T)
print('\nweights')
display(weights.reshape(-1, 1))
[OUT]
説明変数X
array([[ 1. , 0.015, 0.006],
[ 1. , 0.008, 0.025],
[ 1. , 0.084, 0.098],
[ 1. , 0.129, -0.007],
[ 1. , -0.03 , -0.031],
[ 1. , 0.079, -0.021],
[ 1. , -0.018, -0.073],
[ 1. , 0.073, 0.071]])
Xの転置行列X_T
array([[ 1. , 1. , 1. , 1. , 1. , 1. , 1. , 1. ],
[ 0.015, 0.008, 0.084, 0.129, -0.03 , 0.079, -0.018, 0.073],
[ 0.006, 0.025, 0.098, -0.007, -0.031, -0.021, -0.073, 0.071]])
X_TとXの行列積X_TX
array([[8. , 0.341, 0.068],
[0.341, 0.037, 0.013],
[0.068, 0.013, 0.022]])
X_TXの逆行列X_TX_inv
array([[ 0.214, -2.234, 0.697],
[ -2.234, 58.028, -28.279],
[ 0.697, -28.279, 59.963]])
X_TX_invとX_Tの行列積X_TX_inv_X_T
array([[ 0.185, 0.214, 0.094, -0.079, 0.259, 0.023, 0.204, 0.1 ],
[-1.534, -2.488, -0.112, 5.459, -3.071, 2.959, -1.22 , 0.007],
[ 0.617, 1.978, 4.205, -3.388, -0.326, -2.817, -3.17 , 2.902]])
weights
array([[175.421],
[926.852],
[199.317]])
4-2.Excelで計算1:フルスクラッチ
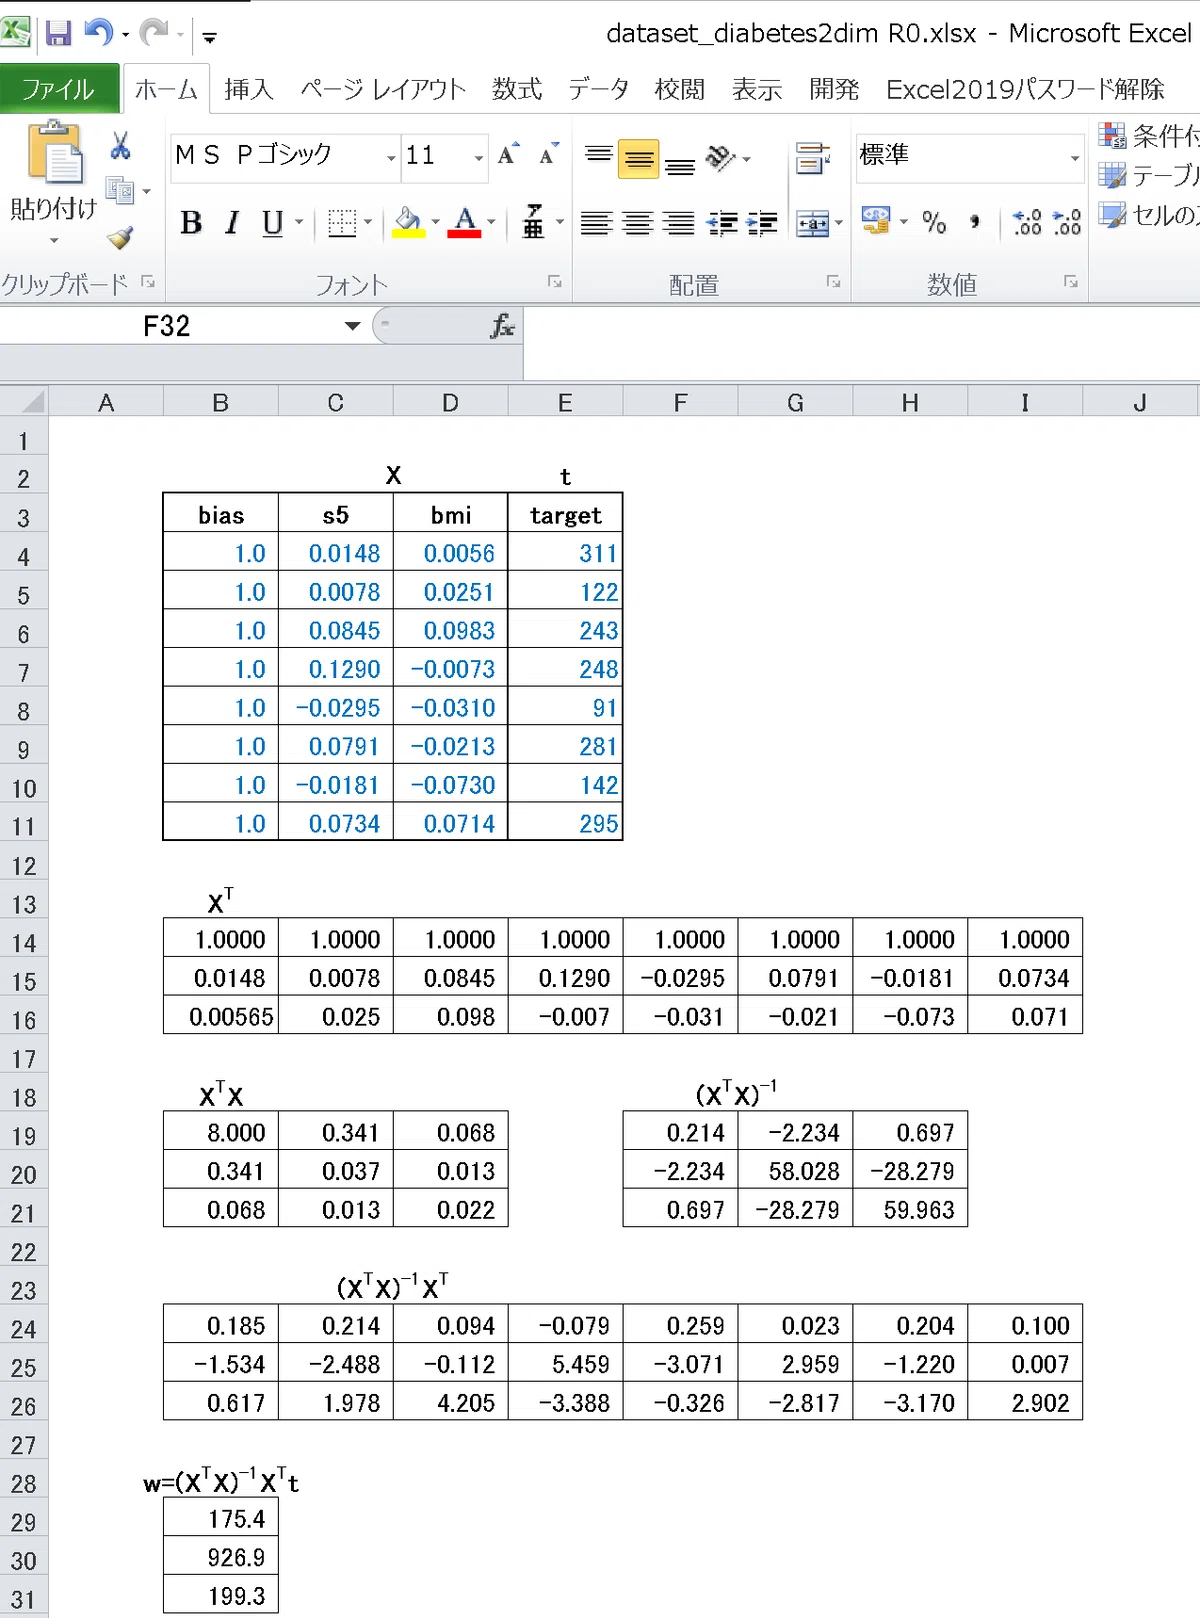
重回帰をExcelを用いてスクラッチで計算します。転置や内積の関数は下記記事をご確認ください。フルスクラッチで計算すると結構手間なので通常は次節で紹介する分析ツールを使用します。
w=bw1w2 ⋮wM=w0w1w2 ⋮wM=(XTX)−1XTt
4-3.Excelで計算2:データ分析(回帰分析)
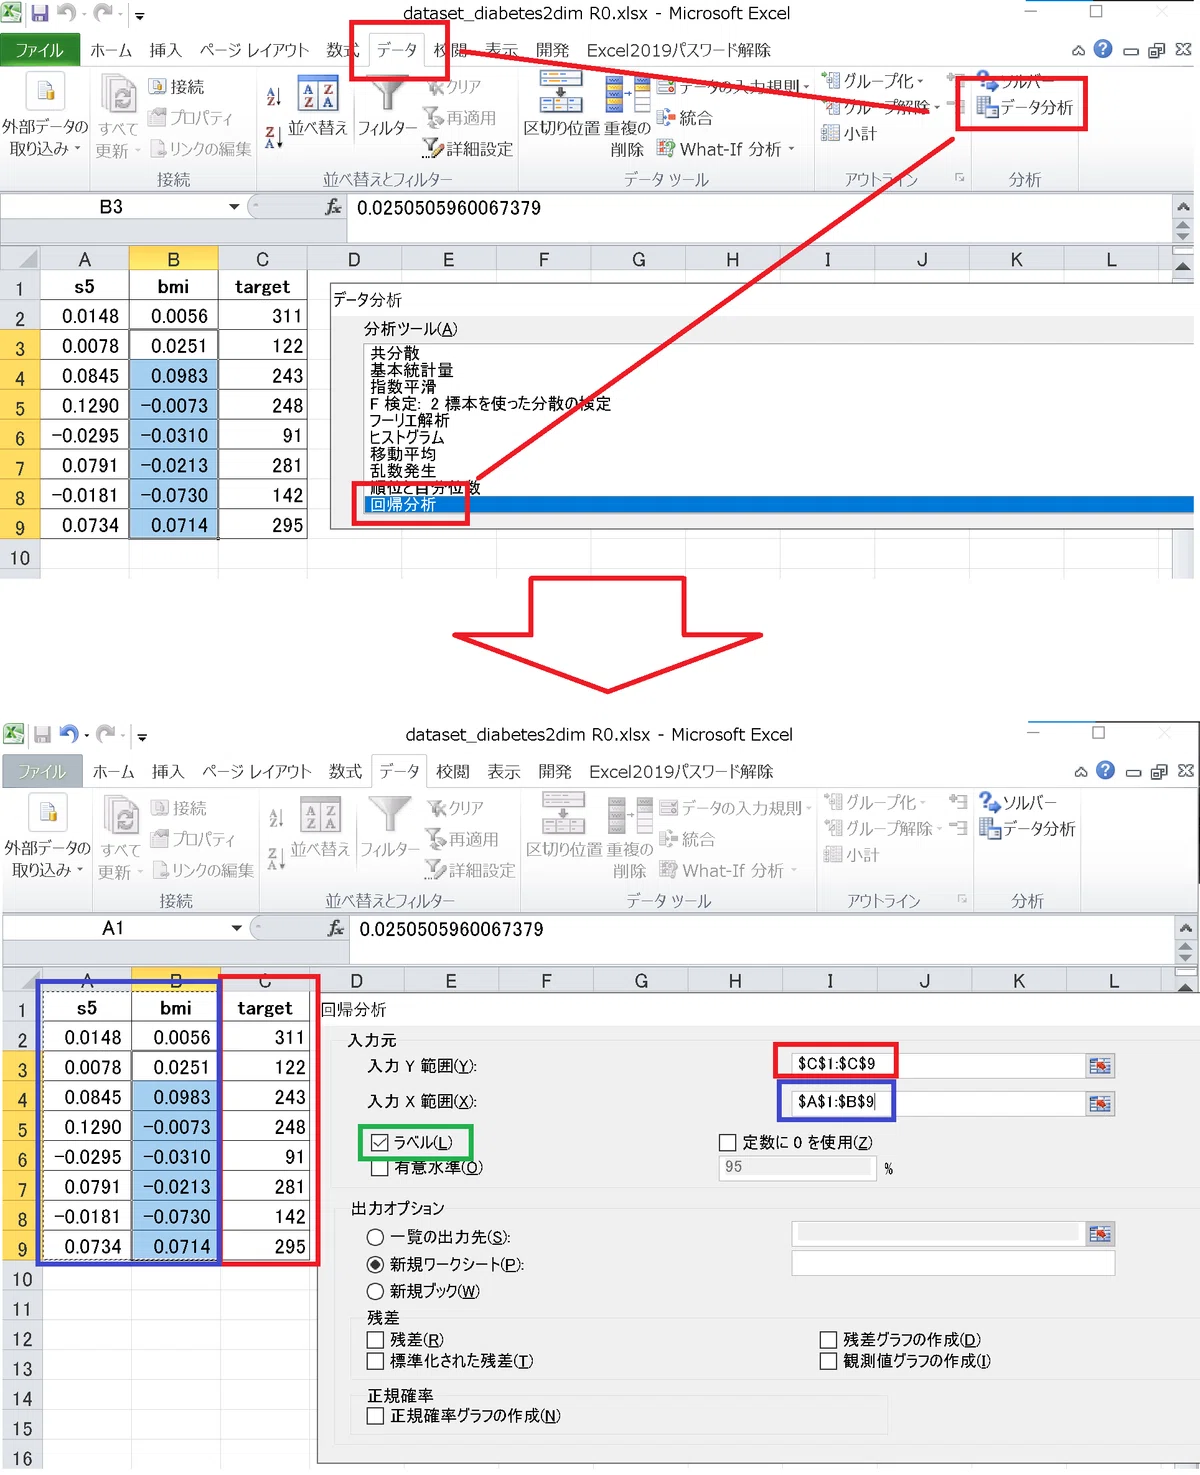
Excelには単回帰/重回帰分析を計算できるツールとして「データ分析」があります。「データ」タブの「データ分析」から「回帰分析」を選択して、ラベル名も含めて選択後に”ラベル”にチェックを入れます。
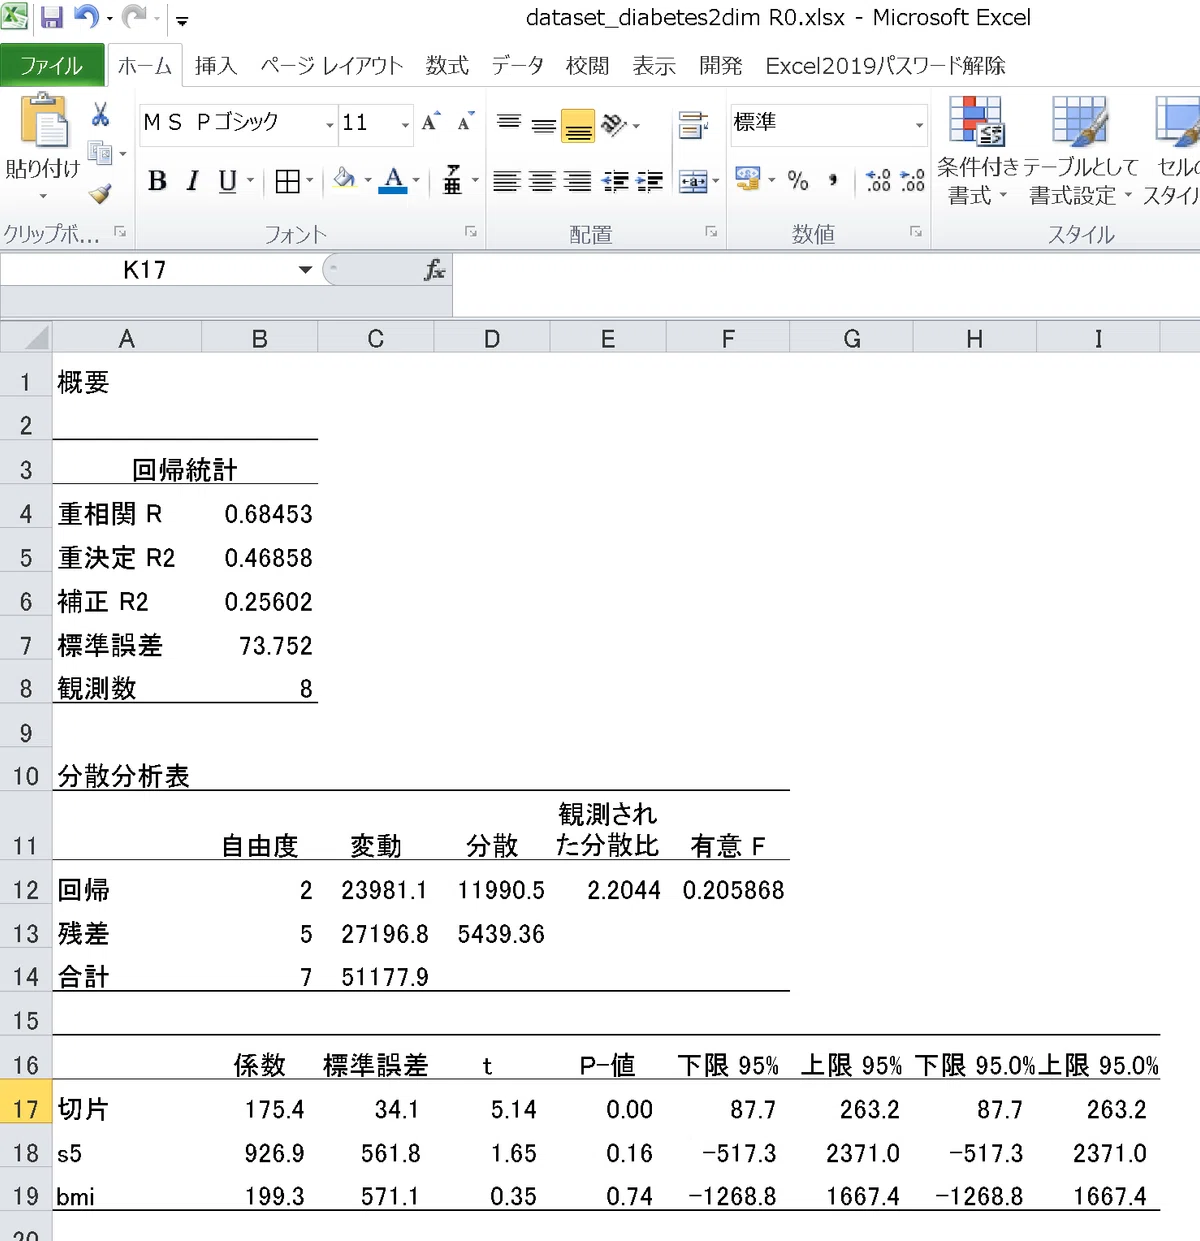
新規シートが作成され出力結果が表示されます。係数の列に重みとバイアスが確認できます。
5.単回帰モデルの実装:ライブラリ編
より簡単にモデルを作成するためにライブラリを使用します。
5-1.Scikit-learn:LinearRegression
Scikit-learnを使用して重回帰を実装します。こちらは単回帰と同じく、重回帰は”LinearRegression”で実装できます。
Scikit-learnのAPIはシンプルでありモデルは下記フローで実装できます。
使用する機械学習モデルをインポート
モデルのインスタンス化
学習:model.fit()
学習後のパイパーパラメータ確認
推論:model.predict()
[IN]
from sklearn.linear_model import LinearRegression
linear = LinearRegression()
linear.fit(x_train, y_train)
y_pred = linear.predict(x_test)
print('Weights:', linear.coef_)
print('bias', linear.intercept_)
[OUT]
Weights: [926.852 199.317]
bias 175.42095342718756
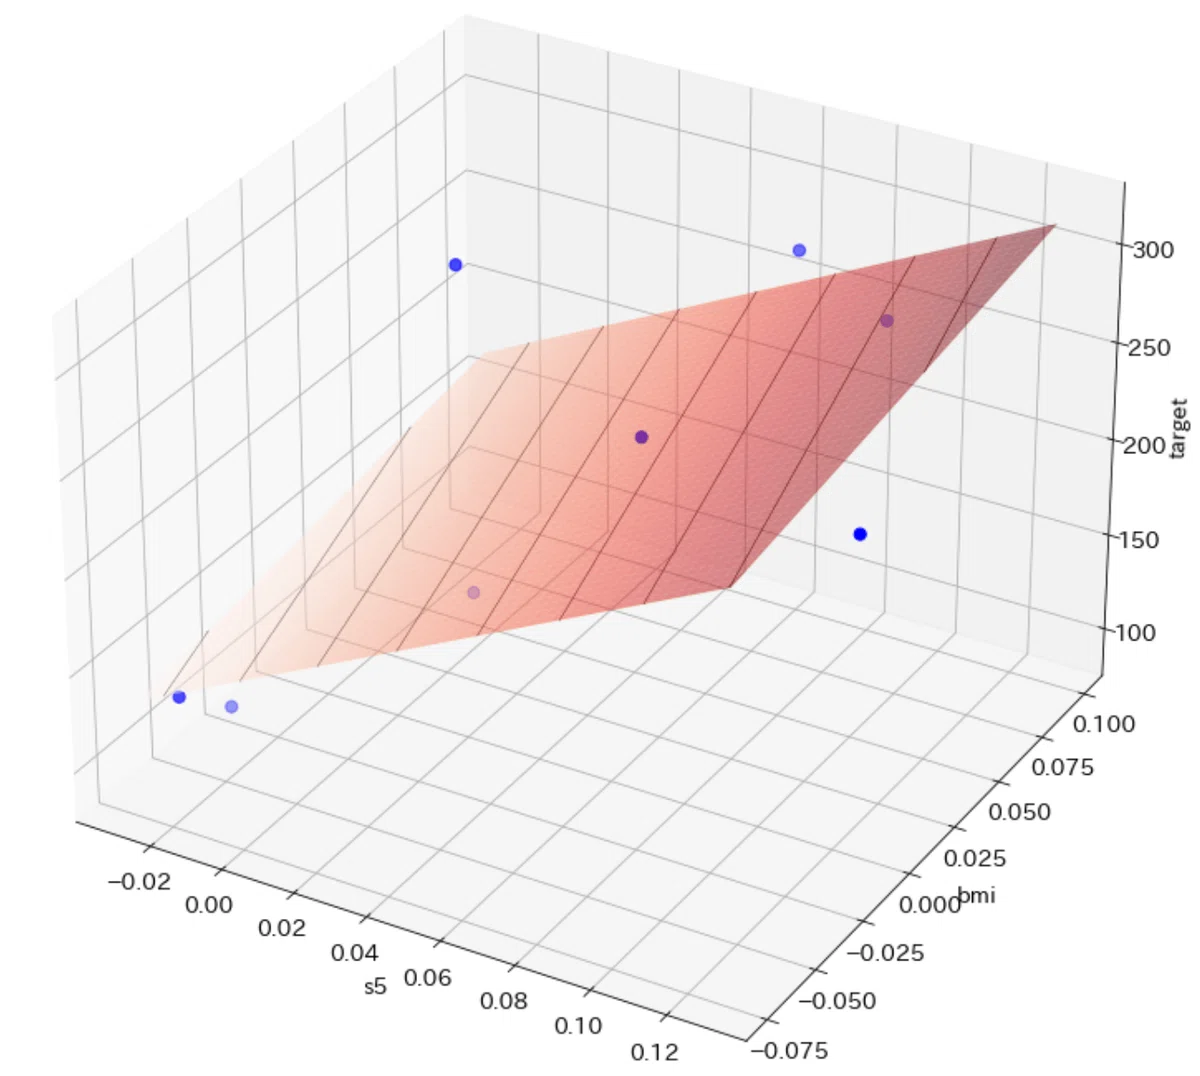
出力も確認しました。下記の通り1次元単回帰モデルは直線で表現されますが2次元重回帰モデルは平面で表現されます。
[IN]
#データの可視化:3次元プロット
plt.rcParams['font.size'] = 14
fig = plt.figure(figsize=(10, 10), facecolor='w')
ax = Axes3D(fig)
 #生データをプロット ax.scatter(df_dataset['s5'].values, df_dataset['bmi'].values, y_train,
           label='data', c='b', marker='o', s=50)

 #重回帰の推論値を平面で表示 x_min, x_max = df_dataset['s5'].min(), df_dataset['s5'].max() #x1の最小値、最大値
y_min, y_max = df_dataset['bmi'].min(), df_dataset['bmi'].max() #x2の最小値、最大値
xs = np.linspace(x_min, x_max, 100)  #x1の最小値から最大値まで100等分 ys = np.linspace(y_min, y_max, 100)  #x2の最小値から最大値まで100等分
X, Y = np.meshgrid(xs, ys)
Z = np.zeros((len(xs), len(ys)))
print(f'形状確認 X:{X.shape}, Y:{Y.shape}, Z:{Z.shape}')

for i in range(len(xs)):
    for j in range(len(ys)):
        Z[j,i] = linear.predict([[xs[i], ys[j]]])

ax.plot_surface(X, Y, Z, alpha=0.5, cmap='Reds')  #平面を表示 ax.contour(X, Y, Z, 10, colors='black', linewidths=0.5)  #等高線を表示
ax.set(xlabel='s5', ylabel='bmi', zlabel='target')
plt.grid()
plt.show()

[OUT]
形状確認 X:(100, 100), Y:(100, 100), Z:(100, 100)
【コラム】
3次元空間(x,y,z)に対して2次元(平面)で表現される空間、つまり元の空間(n次元)より1次元低い空間(n-1次元)を超平面と呼びます。
重回帰では独立変数(説明変数)が2つの場合は”回帰平面”、3つ以上では”回帰超平面”と呼びます。
5-2.Pytorch:nn.Linear()
Pytorchで重回帰も実装できますが、sklearnの方が楽のため今回は省略しました。
6.補足:ベクトル・行列式の変換
【ベクトルの内積の入れ替え:wTx=xTw】
wTx=xTw=w0x0+w1x1+⋯+wNxN=[w0 w1 w2 … wn]x0x1x2⋮xn =[x0 x1 x2 … xn]w0w1w2⋮wn
【転置の公式】
(AT)T=A (AB)T=BTAT (ABC)T=CTBTAT
A∈RN×M=a10a20a30⋮aN0a11a21a31⋮aN1a12a22a32⋮aN2⋯⋯⋯⋱⋯a1Ma2Ma3M⋮aNM, B∈RM×O=b10b20b30⋮bM0b11b21b31⋮bM1b12b22b32⋮bM2⋯⋯⋯⋱⋯b1Ob2Ob3O⋮bMO
AT∈RM×N=a10a11a12⋮a1Ma20a21a22⋮a2Ma30a31a32⋮a3M⋯⋯⋯⋱⋯aN0aN1aN2⋮aNM,BT∈RO×M=b10b11b12⋮b1Ob20b21b22⋮b2Ob30b31b32⋮b3O⋯⋯⋯⋱⋯bM0bM1bM2⋮bMO
BTAT=b10b11b12⋮b1Ob20b21b22⋮b2Ob30b31b32⋮b3O⋯⋯⋯⋱⋯bM0bM1bM2⋮bMO a10a11a12⋮a1Ma20a21a22⋮a2Ma30a31a32⋮a3M⋯⋯⋯⋱⋯aN0aN1aN2⋮aNM
【ベクトルの微分1:∂x∂(wTx)=wT】
∂x∂(wTx)=∂x∂(w0x0+w1x1+⋯+wNxN)=∂x∂i=1∑nwixi
=[∂x1∂(∑i=1nwixi)∂x2∂(∑i=1nwixi)…∂xn∂(∑i=1nwixi)]=[w0 w1 w2 … wn]=wT
【ベクトルの微分2:∂x∂(xTAx)=xT(A+AT)】
xTAx=[x1x2⋯xN]a11a21⋮aN1a12a22⋮aN2⋯⋯⋱⋯a1Na2N⋮aNNx1x2⋮xN=[∑i=1Nxiai1∑i=1Nxiai2⋯ ∑i=1NxiaiN]x1x2⋮xN=i=1∑Nj=1∑Naijxixj
∂x∂(xTAx)=∂x∂(i=1∑Nj=1∑Maijxixj) =[∂x1∂∂x2∂⋯∂xN∂][∑i=1N∑j=1Naijxixj]
=[∑j=1Na1jxj∑j=1Na2jxj⋯∑j=1NaNjxj]
=[x1x2⋯xN]a11a21⋮aN1a12a22⋮aN2⋯⋯⋱⋯a1Na2N⋮aNN+[x1x2⋯xN]a11a12⋮a1Na21a22⋮a2N⋯⋯⋱⋯aN1aN2⋮aNN =xT(A+AT)
参考資料
今後の教材用
あとがき
後でプロット追加と超平面の話を追加