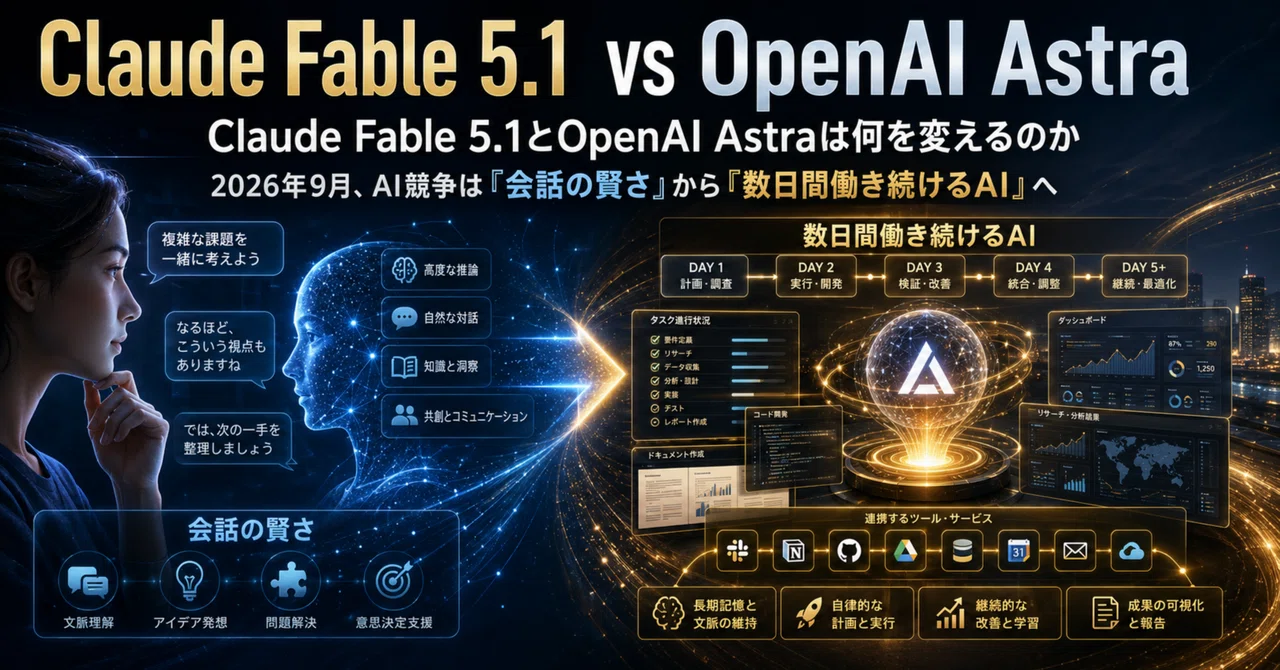
Claude Fable 5.1とOpenAI Astraは何を変えるのか

2026年9月、AI競争は「会話の賢さ」から「数日間働き続けるAI」へ
2026年9月初頭、生成AI業界で二つの名前が急速に注目を集めています。Anthropicの「Claude Fable 5.1」と、OpenAIの次期主要モデル「Astra」です。 Fable 5.1については、前稿執筆時にはAmazon Bedrock APIの痕跡や「melon」「marshmallow」というテスト用コードネームから9月1日発表説が広がっていました。そして、その予測は結果的に当たりました。Anthropicは米国時間2026年9月1日、Claude Fable 5.1とClaude Mythos 5.1を正式発表しました。Fable 5.1は一般提供され、Anthropic API、Amazon Bedrock、Google Cloud、Microsoft Foundryなどで利用可能になっています。
一方、Astraは単なるリーク上の名称ではありません。OpenAI自身が8月1日の数学成果発表で「our next major model(次の主要モデル)」として実名を出し、続く8月7日のセキュリティ関連発表では「one of our upcoming models(近日公開予定のモデルの一つ)」と表現しています。エージェント型コーディングとサイバーセキュリティ能力が大幅に向上していることも、OpenAI自身が説明しています。 つまり状況は一夜で変わりました。Fable 5.1は「未確認の次期モデル」から正式な製品へ移行しました。一方Astraも、OpenAIが9月1日に追加評価を公表し、従来の「Criticalに達している可能性を排除できない」という暫定判断から、「Critical cybersecurity capability thresholdを満たす」と正式に認定しました。ただしAstraの一般公開日はまだ公表されていません。 ただし、ここで最も重要なのは「明日出る」「数日後に出る」という日付当てではありません。 本当に注目すべきなのは、両モデルが示しているAI開発の方向です。
これまで生成AIの競争は、質問にどれだけ正確に答えられるか、難しい数学問題を解けるか、コードをどれだけ上手に書けるかという「一回の応答の知能」を中心に語られてきました。しかしFable 5、そしてAstraをめぐる情報を追うと、競争軸が明らかに変わり始めています。
数時間、数日という長い時間軸で仕事を計画する。 必要に応じてツールを使う。 サブエージェントへ仕事を分担する。 途中で失敗しても自分で検証し、修正する。 巨大なコードベースを読み、変更し、テストし、成果物まで完成させる。 研究課題について仮説を立て、探索し、証明や実装まで進める。 つまり、AIは「答えるモデル」から「働くシステム」へ移ろうとしています。 もしFable 5.1とAstraがこの方向をさらに押し進めるなら、2026年9月は単なる新モデル発表の月ではありません。「AI社員」「AI研究者」「AIソフトウェアエンジニア」が現実の産業システムへ入り始める転換点として記憶される可能性があります。 本稿では、2026年9月2日朝(日本時間)までに確認できる公式情報、一次情報、報道、そして未確認のリークを明確に分離しながら、Fable 5.1とAstraの正体、現在分かっていること、まだ分かっていないこと、そして両者がAI産業に与える意味を整理します。
目次
第1章 まず結論――Fable 5.1は正式発表、Astraは「Critical」認定へ
第2章 Claude Fable 5とは何だったのか――輸出管理まで含めて振り返る
第3章 発表前、なぜFable 5.1の登場説が急浮上したのか
第4章 発表前のAmazon Bedrock API「400から404」は何を示したのか
第5章 Fable 5.1は実際にどこが進化したのか――性能、安全策、システムカード
第6章 Fable 5.1は「新世代」ではなく「完成度を上げる更新」だった
第7章 OpenAI Astraは噂ではなく公式に存在する
第8章 Astraの「Critical Cyber」評価はなぜ重大なのか
第9章 OpenAIがAstra関連ワークロードを止めた理由
第10章 Astraが数学・理論計算機科学で見せた能力
第11章 AstraはGPT-6なのか、それとも別の製品系列なのか
第12章 「ultima-alpha」説と数日以内の公開説をどう見るべきか
第13章 Fable 5.1対Astra――本当の競争軸と評価方法
第14章 Claude Code対Codex――AIソフトウェアエンジニア競争
第15章 長時間自律動作が企業の仕事をどう変えるのか――38時間・3日間の実例
第16章 AIエージェント時代のボトルネックは知能から信頼性へ――安全監視との両立
第17章 サイバー能力の飛躍が意味する「攻撃と防御の自動化」
第18章 価格、企業採用、IPO、推論コストの戦い
第19章 Fable 5.1で確定したこと、Astra公開時に確認すべき16項目
第20章 2026年9月は「AIが答える時代」から「AIが働く時代」への転換点になるか
第21章 まとめ
第22章 主要リンク・参考資料
第1章 まず結論――Fable 5.1は正式発表、Astraは「Critical」認定へ
前稿から最も大きく変わったのは、二つとも「噂を検証する段階」から次の段階へ進んだことです。 Anthropicは米国時間9月1日、Claude Fable 5.1とClaude Mythos 5.1を正式発表しました。両者は同じモデルで、違うのはセーフガードの水準だけです。Anthropic自身がそう明記しています。 Fable 5.1は一般提供です。Mythos 5.1は信頼されたアクセスプログラム経由の限定提供で、経路は二つあります。防御セキュリティ業務向けのCyber Verification Program(CVP)と、米国政府と共同で設計したLife Sciences Verification Program(LSVP)です。LSVPは最初の参加者の登録がすでに済んでいます。
現時点でMythos 5.1の実提供対象は米国の一部組織に限られます。Anthropicの9月1日の正式発表では、具体的なtrusted access programとしてCyber Verification Program(CVP)とLife Sciences Verification Program(LSVP)の二つを挙げています。前世代から続くProject Glasswingとの関係は公式資料によって表現が異なるため、本稿では「Project Glasswingから完全に置き換わった」とは断定しません。Anthropicは米国政府と調整しながら、国内外のより広いパートナーへ拡大する方針です。 Fable 5.1の正式モデルIDはClaude APIでclaude-fable-5-1。コンテキストウィンドウは100万トークン、最大出力は128Kトークン、入力価格は100万トークン10ドル、出力価格は50ドルで、Fable 5から基本料金は据え置かれました。知識・学習データのカットオフは2026年6月です。
価格面で最大の変更はキャッシュリードです。100万トークン当たり1ドル相当だった従来水準から0.25ドルへ75%引き下げられ、Anthropicは典型的なワークロードで約25%、複雑なコーディングや高度なエージェント処理では最大約45%の総コスト削減になると説明しています。これは前稿で論じた「最上位モデルは能力だけでなくCost per completed taskで評価される」という論点への、Anthropic自身の回答と見ることができます。
ただし、この「約25%から45%安くなる」という主張には、すでに独立測定からの反証が出ています。しかもAnthropicのプレリリース評価に協力した組織からです。effort水準によっては、Fable 5.1のほうがFable 5より高くつきます。この価格と実効コストの違いは第18章で詳しく扱います。 性能面では、Terminal-Bench-Science 0.1がFable 5の24.7%から52.6%へ上昇しました。Terminal-Bench 4.0は42.0%から55.8%、AutomationBenchは17.1%から31.4%、CursorBench 3.2.0は70.5%から73.4%です。OSWorld 2.0 strictは36.1%から41.7%、Humanity's Last Examはツールなし60.9%、ツールあり65.0%となっています。特に科学研究エージェントと業務自動化での伸びが大きいのが特徴です。 また、Fable 5.1は長時間エージェント向けの実装面も更新されました。メッセージ単位のeffort指定、ターン単位のsystem message、ツール呼び出しの間に読める進捗更新、content provenanceなどが追加されています。
想定されている実行の形も、製品ページに具体的に書かれています。Claude Coworkでバックログを片づける。Claude Tag(ベータ)経由でSlackから依頼を拾う。ブラウザを操作する。Claude Platform上でマネージドエージェントとして無人で走る。そしてコーディングでは、コードベース全体にまたがる機能追加、コードレビュー、性能改善、そして複数日にわたる自律セッションです。 視覚の扱いも変わりました。ファイルやPDFの中に入れ子になった図表を理解できるため、金融、法務、分析、建築のような文書中心の業務が改善されます。加えてFable 5.1は、自分のコーディング成果を視覚で評価します。出力を元のデザインや目標と照合する、という使い方です。エージェントの自己検証が、テストの実行だけでなく見た目の確認にまで及び始めています。
実務上の注意も一つ。API利用者は、新しいFallback APIで設定を構成する必要があります。そしてセーフガードによって別のモデルへ振り替えられたリクエストには、Fable価格は課金されません。再ルーティングの経済的な負担は、利用者ではなくAnthropic側が持つ設計になっています。adaptive thinkingは常時有効です。デフォルトのeffort水準は面によって異なり、Claude Codeではhigh、Claude CoworkとClaude.aiではmediumです。ここを一律にhighと書くのは誤りです。 そしてAnthropicは、低または中のeffortに設定した場合でも、Fable 5.1はFable 5と同等かそれ以上の結果を、はるかに低いコストで達成すると説明しています。これが今回のリリースの経済的な核心です。性能の天井を上げたことより、同じ性能をいくらで出せるかを下げたことのほうが、企業にとっては大きい。 安全策も重要な変更点です。
サイバー領域では、新しいセーフガードが誤検知を60%削減しました。実利用に引き直すと、Claude Codeの利用者はセッション当たりの介入が平均で約60%減ることを期待できる、という説明になっています。理由の一つは、Fable 5.1がソフトウェア脆弱性の「発見」に使えるようになったことです。ただしexploitの開発には使えません。 依然としてOpusモデルへ振り替えられるデュアルユース作業も、Anthropicは名指しで挙げています。ペネトレーションテスト、exploit生成、バイナリベースの脆弱性スキャンの三つです。 生物学側では、初等生物学や医療に関する良性の問い合わせに対する分類器の発火が、Fable 5の初期状態と比べて85%減りました。ただしライフサイエンスの研究開発に関する問い合わせは、引き続きOpusモデルへ回されます。さらにAnthropicはEnterprise Frontier Safeguards(EFS)を発表しました。顧客のデータをAnthropicのシステムではなく顧客自身のクラウド基盤に置くことで、ゼロデータ保持と同等のプライバシーを確保しつつ、不正利用の検知と対応を続ける仕組みです。
制度設計で見落とせないのは、人間によるレビューをデフォルトで顧客自身が行うという点です。従来はAnthropicの安全チームへ届いていたアラートが、顧客自身のセキュリティ部門へ届くようになります。金融機関が求めていたのはまさにこれですが、同時に、対応する責任も顧客側へ移るということでもあります。 EFSは金融、医療、製造、通信、法務、小売、公共部門にまたがる100社超の顧客と、AWS・Google Cloud・Microsoft Azureの各クラウドパートナーと共同で設計されました。提供先はClaude Code、Claude Enterprise、Claude Platform、Amazon Bedrock、Claude Platform on AWS、GoogleのAgent Platform、Microsoft Foundryです。提供開始は今秋からで、段階的に展開されます。 EFSが行き渡るまでの間、対象となる顧客はFable 5.1とFable 5をゼロデータ保持で利用できます。これは前稿で大きな導入障壁として扱った30日データ保持問題の、直接の修正です。
なお、この動きはAnthropic単独のものではありません。OpenAIは8月19日に、フロンティアモデルに対するゼロデータ保持の提供を公表しています。最上位モデルにデータ保持を課すという業界の実務そのものが、この二週間で崩れました。 一方、OpenAI Astraにも重大な更新がありました。OpenAIは9月1日、「Path to Astra: critical capabilities and frontier safeguards」を公開し、追加評価の結果、AstraがPreparedness Framework上のCritical cybersecurity capability thresholdを実際に満たすと正式に結論づけました。これは「可能性を排除できない」という8月7日の暫定判断から一段進んだものです。
OpenAIによれば、AstraはExploitBenchで100%を記録し、より新しい20件の高深刻度V8脆弱性を集めた内部評価でもGPT-5.6 Solより少ない出力トークンで高い任意コード実行率を示しました。評価中には二つの未知脆弱性を発見し、exploit chainの一部として利用したとされています。さらに、強化されたブラウザではサンドボックス脱出を含む完全な侵害チェーンを構築し、強化OSでは一般ユーザーからrootへ至るローカル権限昇格チェーンを作りました。 ここで、報道が落としがちな但し書きを一つ入れておきます。OpenAIは、これらの数値がDaybreak Blueアクセスを付与した状態での能力であり、デフォルトの本番構成ではないと明記しています。つまり一般利用者が触るAstraが、この能力をそのまま発揮するわけではありません。
この能力を受け、OpenAIはAstraを近く提供する方針を維持する一方、最先端のサイバー能力へのアクセスを限定します。高度なサイバー用途はまず少数のアルファテスターへ提供し、その後Daybreak Blueを通じて防御目的のアクセスを拡大する予定です。一般公開の具体的な日付はまだ示されていません。詳細な安全性・セキュリティ・アラインメントの評価結果は、公開時のシステムカードで示されるとしています。 またOpenAIは、Astra自体はHugging Face事案に関与していないとしたうえで、当時の本番セーフガードであれば同事案を防げたはずだと遡及テストで判断した、と述べています。同社は8月26日に、この事案に関する報告と技術レポートを公開しています。 したがって、2026年9月2日朝時点の結論は明快です。Fable 5.1は正式リリース済み。Astraは正式リリース前ですが、Critical Cyber認定とリリース準備が公式に一段進みました。昨日までの記事の中心だった「本当に出るのか」という問いは、Fable 5.1については終了し、今後は「何がどれだけ改善されたか」「Astraがいつ、どの制限付きで出るか」が焦点になります。
第2章 Claude Fable 5とは何だったのか――輸出管理まで含めて振り返る
Fable 5.1を理解するには、まずFable 5そのものを理解する必要があります。 Anthropicは2026年6月9日、Claude Fable 5とClaude Mythos 5を発表しました。AnthropicはFable 5について、一般提供したモデルの中で過去最高の能力を持つと説明しています。 さらに重要なのが「Mythos-class」という位置付けです。 Anthropicのモデル系列では長らくHaiku、Sonnet、Opusという階層が知られてきました。しかしFable 5は通常のOpusクラスよりさらに上に置かれるMythos-classのモデルです。Anthropicの説明では、Mythos-classはOpusより上位の能力階層に位置します。 ここで、しばしば誤解される点を正確に押さえておきます。 Fable 5とMythos 5は「能力の近い別モデル」ではありません。Anthropicの公式ドキュメントは、Mythos 5がFable 5と同じ機能を備えており、両者は同じ仕様と同じ価格を共有すると明記しています。 つまり、両者は同一の基盤モデルです。
違うのは能力ではなく、セーフガードと提供範囲だけです。Fable 5は一般提供され、生物学やサイバーセキュリティなどの領域で分類器による安全策が働きます。Mythos 5はProject Glasswingを通じた限定提供で、承認された顧客だけが利用できます。Mythos 5にアクセス権のない顧客は、同じ機能を提供するFable 5を使えばよい、というのがAnthropic側の説明です。 この区別は本稿全体にとって重要です。「Mythosのほうが賢い」という理解は誤りです。正しくは「同じモデルに、どこまで安全策をかけて、誰に渡すか」という運用上の区別です。 なお、Fable 5とMythos 5には30日間のデータ保持が適用され、ゼロデータ保持では利用できません。いずれも「対象モデル(Covered Models)」に指定されています。この制約は、後述するとおり企業導入の実務で無視できない重みを持ちました。 Amazon Bedrockの公式モデルカードもFable 5の特徴を非常に明確に記しています。 Fable 5は複雑な知識労働とコーディング向けの次世代モデルであり、「multi-day tasks」、つまり複数日にまたがる仕事で持続的な自律動作が可能だと説明されています。
さらに、段階をまたいだ計画、サブエージェントへの委任、自己検証を行えるとされています。 コンテキストウィンドウは100万トークン、最大出力は128Kトークンです。知識カットオフは2026年1月です。 ベンダー公表の評価値としては、SWE-bench Verifiedで95.5%、Terminal-Bench 2.1で88%、GPQA Diamondで94.1%が示されています。第三者指標であるArtificial Analysis Intelligence Indexでは62という値が付いています。ただしこの62は、分類器によるフォールバックが働く状態での測定である点に注意が必要です。 これは従来の「プロンプトを入れたら回答が返る」というLLM像から大きく離れています。 例えば大規模ソフトウェア開発では、AIがリポジトリを読むだけで終わるのではありません。 仕様を理解する。 依存関係を調査する。 変更計画を立てる。 コードを書く。 テストする。 失敗原因を調べる。 別の修正を試す。 必要ならサブタスクを別エージェントへ任せる。 最後に全体を再検証する。 この一連の流れを長時間継続することが重要になります。
Anthropic自身もFable 5について、タスクが長く複雑になるほど他モデルとの差が大きくなると説明しています。 これは2026年のAI競争を象徴する特徴です。 単発問題の正答率だけなら、モデル間の差は徐々に見えにくくなります。しかし100ステップ、1000ステップと行動を続けたとき、1ステップごとの小さなミスが累積します。だからこそ長時間タスクでは、計画、記憶、自己検証、エラー回復、ツール利用の安定性が決定的になります。 Fable 5は、まさにそこへ重点を置いたモデルでした。
【Fable 5の輸出管理という前例】
本稿がここまで扱ってきたのは「いつ出るのか」という問いでした。しかしFable 5には、それ以前の問題が起きた前例があります。出たものが、消えたのです。 【発表ベース 2026年6月から7月にかけての経緯】 6月9日 Claude Fable 5とClaude Mythos 5を公開。 6月12日 米商務省の輸出管理に対応するため、Anthropicが両モデルへのアクセスを停止。公開からわずか3日後。 6月30日 商務省が当該規制を解除。 7月1日 Anthropicがアクセスを再提供。 規制の引き金は、報じられたjailbreakでした。そして解除は無条件ではありません。報道によれば、Anthropicが監視と協力のプロトコルを強化することに同意した後に、規制が解かれています。 つまりこの19日間は、単なる中断ではありませんでした。以後Anthropicが何を監視し、政府と何を共有するかの枠組みが、ここで決まっています。9月1日に発表されたEnterprise Frontier Safeguardsも、Mythos 5.1を米国組織限定としたことも、米国政府と共同でLife Sciences Verification Programを設計したことも、この6月の合意の延長線上にあると読めます。
この期間について、海外の記事では「18日間の停止」と表記されることが多く、数え方によっては19日間とも書かれます。日数の議論に踏み込むより、日付で書くほうが正確です。6月12日に停止、6月30日に規制解除、7月1日に再提供。これが動かない事実です。 この出来事は、本稿の主題に対して三つの含意を持ちます。 第一に、リリースの日程が企業の判断だけで決まらないということです。Fable 5.1の発表が「明日」と噂され、それが翌週へずれたとしても、理由が技術的な準備不足であるとは限りません。 第二に、前章までで見たAPIの挙動が、より複雑になるということです。停止期間中、Fable 5のモデルIDは404を返し、Opus 4.8を使うよう案内していました。つまり404は「これから登録される」の意味にも「取り下げられた」の意味にもなり得ます。第4章で扱った400から404への変化を、単線的に読むべきでない理由がここにあります。
第三に、これが繰り返される構造だということです。2026年9月1日、米国防総省はGenAI.milという生成AIポータルを開設しました。ChatGPT Mil、xAI/StarshieldのGrok for Government、Google Geminiを束ね、国防総省の300万人が対象で、すでに170万人が利用を開始しているとされます。 ここにAnthropicのClaudeは含まれていません。トランプ政権による指定が背景にあると報じられています。 6月の輸出管理と、9月の政府調達からの排除。同じ線の上に、二度目の反復が現れています。最も能力の高いモデルを持つ企業が、政府との関係では最も不利になる、という構図です。
第3章 発表前、なぜFable 5.1の登場説が急浮上したのか
Fable 5.1の噂自体は8月中から存在していました。しかし8月31日から9月1日にかけて、確度が一段上がったように見える出来事が重なりました。 第一はAmazon Bedrock APIの挙動です。 第二は、過去のClaude関連リークで一定の実績があるとされるアカウントによる具体的な日付投稿です。 第三は、Fable 5が6月に登場して以降、Anthropicが極めて速いモデル更新を続けていることです。 第四が、コードネームの出現です。8月21日ごろ、Claudeのモデル一覧に「melon」「marshmallow」という二つのテスト用文字列が一時的に表示され、その後消えました。複数の媒体は、この二つがそれぞれFable 5.1とOpus 5.1のアーリーアクセス版だと推定しています。ただし、どちらがどちらに対応するのかを確定させる情報はありません。 グレーテストに参加したとされる利用者の報告では、melonの性能は最上位Fable級に達しており、「中位モデルだろう」という事前予想を大きく上回ったとされています。
第五が、先例です。Opus 5が出荷された7月24日の約2週間前に、claude-honeycomb-eapというテスト文字列が確認されていました。marshmallowの文字列が最初に観測されたのは8月21日です。単純に当てはめれば9月初旬になります。 ただし、これは1例です。1例は算術であって、パターンではありません。この留保は外すべきではないでしょう。 2026年のAnthropicは、モデルを一年に一度だけ大々的に更新する会社ではなくなっています。Sonnet 5、Fable 5、Opus 5などを短期間に投入し、能力、価格、速度、安全性を細かく分化させています。 Reutersは7月24日のOpus 5発表時、Anthropic側の説明として、Opus 5はFable 5の能力に迫りながら価格は半分だと報じました。Anthropicの製品責任者ダイアン・ペン氏の発言としてこの位置付けが伝えられています。
なお、Fable 5を「days-long, very autonomous projects」向けと表現する引用が一部で流通していますが、Reuters記事における同表現の存在は本稿の調査では確認できませんでした。Fable 5が複数日タスクを想定していること自体は、Amazon Bedrockの公式モデルカードで確認できます。引用元を混同しないよう注記しておきます。 このリリース速度を考えれば、6月のFable 5から9月に5.1へ更新されること自体は不自然ではありません。 ただし、「あり得る」と「確認された」は別です。 新モデルのリークでは、モデルID、Web UIの文字列、クラウドプロバイダーの設定、SDK内の未公開定義、評価サイトの一時表示などが発売前に見つかることがあります。しかし企業側がテスト用に名称だけ登録している場合もあり、直前で延期される場合もあります。 したがってFable 5.1については、「存在の可能性が高まった」「リリース準備の痕跡と解釈できる」という表現が適切であり、「9月1日発売が確定した」とするのは現時点では行き過ぎです。
第4章 発表前のAmazon Bedrock API「400から404」は何を示したのか
今回のFable 5.1説で最も技術的に興味深いのが、エラー応答の変化です。 開発者コミュニティの報告によれば、Fable 5.1と推測されるモデルIDをAmazon Bedrock APIへ問い合わせた際、以前は400系の「無効な識別子」に近い応答だったものが、8月31日前後には404系の応答へ変化したとされています。 ここから「モデル名がAWS側で認識される段階に入ったのではないか」という推測が生まれました。 さらに、存在しない架空のモデル名や別の未確認名称では従来型の応答が続く一方、Fable 5.1らしき名称だけ挙動が変わったという比較も報告されています。 もしこの観測が正しく、かつバックエンドの仕様解釈も正しいなら、Fable 5.1のエントリーが何らかの形で登録された可能性があります。 しかし注意点があります。 HTTP 400と404の意味はAPI実装によって異なります。 400は一般にBad Request、404はNot Foundですが、内部ルーティング、入力検証、モデルレジストリ、アクセス権、リージョン、プロビジョニング状態など、どの層でエラーが発生したかによって意味は変わります。
外部から一つのエラーコードだけを見て、「モデル本体がアップロード済み」「発売日が決まった」とまでは判断できません。 しかも、Fable系のモデルに関しては、同じAPIが状況によって異なるコードを返すことが実際に観測されています。整理すると次のようになります。
【実観測 Bedrock経由でFable系モデルを叩いたときの応答】 400 データ保持モードの設定が要件を満たしていない場合。Fable 5は30日間のデータ保持が必須であり、ゼロデータ保持の設定では通りません。 403 アカウントで当該モデルが有効化されていない場合。 404 6月の提供停止期間中、「Please use Opus 4.8」という趣旨の案内とともに返された実績があります。 この三つ目が厄介です。404は「モデル名が登録された」とも読めますが、「モデル名が取り下げられた」とも読めます。実際、Fable 5自身が6月に404を返していた時期があります。 つまり400から404への変化は、「登録が進んだ」というシナリオと矛盾しませんが、それだけを根拠に結論を出すことはできません。 したがって、この痕跡の価値は「正式発表の代替証拠」ではなく、「発売準備説を補強する状況証拠」と考えるべきです。 それでも、単なる匿名掲示板の噂よりははるかに興味深い材料です。
第5章 Fable 5.1は実際にどこが進化したのか――性能、安全策、システムカード
Fable 5.1は9月1日に正式発表され、改善点は推測ではなく確認できる段階に入りました。ここでは、発表前に予想していた論点と、実際の発表内容を照合します。 第一は長時間エージェントの信頼性です。AnthropicはFable 5.1を、長時間のエージェント型コーディング、複数段階の調査、ドキュメント・スプレッドシート・スライド作業まで含む高負荷の知識労働向けに位置付けました。Terminal-Bench-Science 0.1は24.7%から52.6%、AutomationBenchは17.1%から31.4%へ伸びており、単発回答よりも長い行動系列での改善が目立ちます。Fable 5がすでに複数日タスクを掲げていた以上、5.1で最も価値があるのは「もっと賢い一回答」より「長時間動かしても壊れにくいこと」です。 例えば1000回の判断を必要とするタスクで、一回の判断成功率が99%でも、単純計算ではすべて成功する確率は急激に低下します。現実のエージェントは失敗を検知してやり直すため単純な掛け算ではありませんが、長時間化するほどエラー回復能力が重要になることは変わりません。 第二はClaude Codeとの統合です。
AnthropicにとってClaude Codeは単なる付属アプリではなく、モデル能力を実際のソフトウェア開発へ変換する重要な実行環境です。 モデルが10%賢くなるだけでも、Claude Code側のツール選択、コンテキスト管理、メモリ、サブエージェント、テスト、Git操作などと組み合わされれば、完遂率は大きく変わる可能性があります。 第三は自己検証です。 強いモデルほど、最初の回答を出す能力だけでなく、自分の出力を疑い、テストし、誤りを修正する能力が重要になります。 第四はサブエージェントの協調です。 巨大タスクを一つのコンテキストで処理するのではなく、設計、実装、テスト、調査、レビューなどを複数のエージェントへ分割する方式です。 第五は計算量の制御です。 AnthropicはOpus 5で「effort」のような考え方を強めています。簡単な仕事には少ない計算、難しい仕事には多くの計算を割り当てることで、性能とコストのバランスを取る方向です。 Fable 5.1でも、最高性能だけでなく「同じ仕事をどれだけ安く、安定して完了できるか」が重要になります。
【Fable 5で先行していた安全策の調整】
Fable 5.1に何が期待されているのかを考えるとき、多くの議論は「もっと賢くなること」に向かいます。しかし実際にAnthropicが8月に出荷したのは、賢さではなく、拒否の精度でした。 8月7日、Anthropicは「Fable 5の生物学セーフガードの更新」を公表しました。誤検知を大幅に減らす方向の調整です。 【発表ベース 8月7日の分類器更新による効果】 生物学関連のフォールバックが約85%減少。 全体のフォールバック率は、Claude.aiで67%減、Coworkで55%減、Claude Codeで17%減、Platformで7%減。 ウイルス学、毒性学、分子設計については、引き続きOpus 5へフォールバックする。 この数字の並びを読むと、問題の所在がよく分かります。減少幅が最も大きいのは一般消費者向けのClaude.aiで、最も小さいのは開発者向けのPlatformです。つまり、誤検知の被害を最も受けていたのは一般利用者だった、ということでもあります。 Fable 5の分類器は、公開当初はOpus 4.8へフォールバックしていました。Opus 5の登場後は、フォールバック先がOpus 5になっています。
ここに、Fable 5の商品としての難しさが凝縮されています。利用者が最上位モデルを選んでも、特定の話題では下位モデルの応答が返ってきます。Amazon Bedrockのモデルカードは、ブロック時の挙動まで明記しています。HTTP 200を返しつつ、stop_reasonに「refusal」を、加えてstop_detailsを載せる。拒否率は従来のClaudeモデルより明確に高い。プロンプト段階での拒否は課金されず、生成の途中でブロックされた場合は生成された分が課金される。 高い金額を払い、拒否率の高いモデルを使い、拒否されたときには一部課金される。第18章で見た価格の話と、追加調査で見る11%という数字は、この体験の上に立っています。
【ベンチマークに写り込む安全策】
今回の発表で、第13章で述べる「ベンチマーク一位だけでは評価できない」という論点に対する、これ以上ない実例が出ました。 Terminal-Bench 4.0のスコアを見てください。Fable 5.1が55.8%、Mythos 5.1が60.9%です。 この二つは同じモデルです。重みも同じ、能力も同じ。違うのはセーフガードの水準だけです。 つまりこの5.1ポイントの差は、能力の差ではありません。安全策が介入したタスクの分です。Anthropic自身がそう説明しています。今回の改善によって、この差は今後ずっと小さくなると見込まれるとも書いています。 さらに踏み込んだ注記もあります。Fable 5.1は本番セーフガードを有効にした状態で評価されました。セーフガードが介入したタスクでは、OSWorld 2.0においてFable 5.1とFable 5がゼロ点、AutomationBenchにおいてFable 5がゼロ点になっています。それ以外の介入では、サイバー系タスクはClaude Opus 4.8が、生物系タスクはClaude Opus 5が代わりに完了しました。Anthropicは、これがFable 5.1とFable 5のスコアを押し下げている可能性が高いと明記しています。
ここから読み取るべきことは二つあります。 一つは、公表されたベンチマーク値が「モデルの能力」を測っていないということです。測っているのは「セーフガードを通したモデルの実効性能」です。企業が実際に使うのはこちらなので、実務的にはむしろ正直な数字です。しかしモデル同士の能力比較としては、条件が揃っていません。 もう一つは、比較の非対称です。Anthropicは自社の安全策込みで測り、その事実を注記しています。他社が同じ条件で測っているとは限りません。ベンチマーク表を横に並べて優劣を語るとき、この非対称は消えてしまいます。 公表された主要ベンチマークを整理しておきます。いずれもAnthropicによるベンダー公表値です。
【エージェント型科学研究 Terminal-Bench-Science 0.1】 Fable 5.1が52.6%、Fable 5が24.7%、Opus 5が29.0%、GPT-5.6 Solが22.4%。 ただし各モデルの標準誤差は±3.5〜4.5ポイントです。公開リーダーボードはOpus 5を30.0%、Fable 5を21.4%としており、Anthropicの環境ではそれぞれ29.0%と24.7%で再現されました。いずれもノイズの範囲内だとしています。
【エージェント型コーディング Terminal-Bench 4.0】 Fable 5.1が55.8%、Mythos 5.1が60.9%、Fable 5が42.0%、Opus 5が52.3%、GPT-5.6 Solが37.3%。
【知識労働 GDPval-AA v2】 Fable 5.1が1853、Fable 5が1723、Opus 5が1824、GPT-5.6 Solが1711。 なおOpus 5の1824は、Fable 5の1723を上回っています。この一項目だけでも、追加調査で見た「半額のOpus 5が最上位を追い抜いた」という現象の説明がつきます。
【コンピュータ操作 OSWorld 2.0】 partial評価でFable 5.1が77.9%、Fable 5が72.9%、Opus 5が75.4%。strict評価でFable 5.1が41.7%、Fable 5が36.1%、Opus 5が39.6%。 ここには重要な但し書きがあります。スコアはベンチマーク作成者による2026年8月のタスクリリースに基づくもので、タスクファイルが以前のリリースと異なるため、過去に公表されたOSWorld 2.0の数値とは直接比較できません。そのため競合他社のスコアは掲載されていません。
【多分野推論 Humanity's Last Exam】 Fable 5.1がツールなし60.9%・ツールあり65.0%、Fable 5が57.8%・63.8%、Opus 5が56.6%・63.6%。 この項目の伸びは小さい。三モデルの差は数ポイントで、ツールを使えばほぼ横並びです。「難問への回答力」という軸では、世代交代の効果が頭打ちに近づいていることを示しています。
【業務ワークフロー AutomationBench】 Fable 5.1が31.4%、Fable 5が17.1%、Opus 5が26.9%、GPT-5.6 Solが19.6%。
【エージェント型コーディング CursorBench 3.2.0】 Fable 5.1が73.4%、Fable 5が70.5%、Opus 5が70.0%、GPT-5.6 Solが67.2%。 数字を並べて分かるのは、伸びが一様ではないことです。単発の難問回答(Humanity's Last Exam)はほぼ横ばい。長時間の科学研究(Terminal-Bench-Science)と業務自動化(AutomationBench)は倍近い。 本稿が第13章から主張してきた「競争軸は一回の応答の賢さから長時間の仕事へ移った」という見立ては、この伸びの偏りにそのまま現れています。
【透かしと反蒸留――9月1日に変わった実務仕様】
9月1日の発表には、性能とも価格とも安全性とも別の系統の変更が二つ含まれています。どちらも報道ではほとんど扱われていませんが、実務への影響は小さくありません。
【EUのAI法への対応と、出力への透かし】 2026年7月、Anthropicは他の190の署名者とともに、EU AI ActのAI生成コンテンツ透明性に関する行動規範に署名しました。 これにより、2026年8月2日以降にリリースされたモデルの出力へ透かしを入れることが求められています。Fable 5.1はこの日付以降のモデルです。つまりFable 5.1の出力には、Claudeが書いた可能性を数値的に判定するための透かしが入っています。 Anthropicの説明では、この透かしは検出APIを持たない者には見えず、出力の品質や内容に実質的な影響はなく、利用者や組織や会話に関する情報を含みません。 検出APIはプライベートプレビューで提供が始まっています。対象は規制当局、法執行機関、報道機関、ファクトチェッカー、独立研究者、教育機関、EUの市民社会団体など、EU法の要求に基づく組織です。加えて、同法への準拠のために透かしの検証義務を負う企業にも提供されます。今後アクセスを広げる予定とされています。 執筆や制作にAIを使う立場からすると、これは無視できない変更です。出力そのものは変わらないが、出所の判定可能性が変わります。
【蒸留への対策】 蒸留は、高度なモデルの能力を抽出する手法です。Anthropicによれば、数千の偽アカウントを使って産業規模で行われることがあります。抽出された能力が十分な安全策なしに公開されうるため、安全上のリスクとして扱われています。 Fable 5.1では、これを困難にする仕組みが強化されました。具体的には、本日以降に作成される新規のAPIアカウントでは、マルチターン会話においてClaudeの過去のコンテキストを手動で編集しつつ、Claudeの過去の思考の記録を保持することができなくなりました。これは公開されていた蒸留手法の一つを塞ぐものです。 展開は段階的で、既存のアカウントは当面影響を受けません。ただし将来のモデルリリースでは全利用者に適用されます。一部の顧客のカスタム統合が影響を受けるとされています。 この変更は、開発者にとっては仕様変更そのものです。過去の思考を編集して再投入する構成を採っている場合、次の世代で動かなくなります。第19章の確認項目に、もう一つ加えるべき事項が増えました。
【システムカードが示したCB-1判定】
9月1日には、Fable 5.1とMythos 5.1のシステムカードも公開されました。本稿は全文を精査していませんが、リスク判定に関わる要点だけ押さえておきます。 【評価対象の使い分け】 システムカードは、評価ごとにMythos 5.1とFable 5.1のどちらを対象にしたかを明記しています。 Mythos 5.1はセーフガードがない状態で、モデルの基礎的な能力を反映します。Fable 5.1はセーフガードがある状態で、一般アクセスの利用体験に一致します。文脈によってどちらを測るかを選び、そのつど明示する、という方式です。 この章で見た「ベンチマークに安全策が写り込む」問題に対する、Anthropic側の対処がこれです。能力を知りたいならMythos、体験を知りたいならFable。二つの数字を分けて出しています。 なお他社モデルの数値については、各社の公表結果や公開リーダーボードから引いていると注記されています。 【化学・生物リスク CB-1という判定】 Mythos 5.1について、AnthropicはCB-1能力を持つと判定しました。 CB-1とは、基本的な技術的背景を持つ人物が既知の兵器を合成するのを有意に助けうる水準、という意味です。
一方で、CB-2の閾値には達していないと判断しています。CB-2は、希少な専門家人材を機能的に置き換える水準を指します。新規の兵器開発における律速要因は、まさにこの希少人材だからです。 Anthropicは、この判断にはある程度の不確実性が残ると明記しています。そのうえでFable 5.1を、Fable 5と同じ生物学セーフガードで展開しています。 ここは正確に読む必要があります。「安全である」と言っているのではありません。「一段上の閾値には達していないと判断した、ただし不確実性はある」と言っています。
【自動化されたAI研究開発】 自動化されたAI研究開発の領域については、リスクは引き続き低いと評価されています。モデルは同社の人間の研究者やエンジニアの能力を大きく下回り、社内のAI研究開発を加速する能力も従来の水準にとどまる、という判定です。 本稿の第20章で「AI研究者」という将来像を扱いました。Anthropic自身の評価では、その将来像はまだ到達していません。金星の標高地図もタンパク質バインダーも、人間の研究者が課題を選び、道具を与え、結果を検証したうえでの成果です。
【外部評価】 Frontier Compliance Frameworkの一環として、Anthropicは外部の評価者にモデルの異なるイテレーションをテストさせています。無害化訓練を施したもの、施していないもの、その両方、という形です。サイバーセーフガードについては、外部2組織への委託とGray Swanによる自動テストが行われ、致命的な深刻度のjailbreakの証拠は見つかっていません。
【留意点】 この部分はシステムカードの要約報道と抜粋に基づくもので、原典を通読したものではありません。安全性評価を詳細に論じる場合は、システムカード本体を直接参照してください。前世代のFable 5/Mythos 5のシステムカードは300ページを超える分量でした。
第6章 Fable 5.1は「新世代」ではなく「完成度を上げる更新」だった
実際に製品名は「Fable 5.1」となりました。したがって、これは「Claude 6」のような全面的な世代交代ではなく、Fable 5系の能力、コスト、運用、安全策をまとめて磨き込む更新だったと見るのが自然です。 AIモデルの性能は、事前学習の規模だけで決まりません。 ポストトレーニング、強化学習、推論時の計算配分、ツール利用訓練、エージェント環境での学習、長期タスク評価、失敗データからの改善、安全性チューニングなどによって、同じ世代のモデルでも実用性能は大きく変わります。 特にエージェントでは、モデルIQのような単一指標より「途中で諦めない」「間違った前提を修正できる」「ツールの失敗を理解する」「不要なループに入らない」といった地味な改善が大きな価値を持ちます。 そのためFable 5.1を評価するときも、ベンチマークが数ポイント上がったかだけを見るのでは不十分です。 同じソフトウェア開発タスクを10回実行したとき何回完了できるか。 8時間走らせたとき何回人間介入が必要か。 100万トークンのコンテキストを実際にどれだけ有効利用できるか。 複数エージェント間で情報が失われないか。 途中の判断根拠や進捗をどれだけ正確に管理できるか。 こうした「運用の完成度」が5.1の本当の評価軸になるでしょう。
第7章 OpenAI Astraは噂ではなく公式に存在する
Astraについて最も重要な点は、存在そのものを疑う段階ではないことです。 公表の順序は、しばしば誤って伝えられています。正確には次の通りです。 先に来たのが8月1日です。OpenAIは「Ten advances in mathematics and theoretical computer science」という発表の中で、成果を出した内部版Astraを「our next major model」、つまり次の主要モデルと説明しました。OpenAIが公式にAstraという名称へ言及したのは、これが初めてとみられています。 次に来たのが8月7日です。サイバー能力に関するセキュリティ投稿の中で、Astraを「one of our upcoming models」、近日公開予定のモデルの一つと表現しました。 つまり「まず数学の成果として名前が出て、その約一週間後に安全性の懸念として名前が出た」という順序です。逆ではありません。この順序は、Astraをめぐる物語の性格をよく表しています。同じモデルが、六日間で「快挙」から「リスク」へ反転したのです。 つまりAstraは、単なる社内実験名ではなく、OpenAIが次の主要モデルとして扱っている存在です。
OpenAIによると、Astraの最新内部評価ではエージェント型コーディングとサイバーセキュリティで大幅な進歩が確認されました。 ここで重要なのが「agentic coding」という言葉です。 単にPythonの関数を書ける、LeetCodeを解けるという話ではありません。 エージェント型コーディングでは、AIが開発環境を操作し、ファイルを読み、コードを書き、コマンドを実行し、テスト結果を見て、エラーを修正し、次の行動を決定します。 つまり「コード生成モデル」ではなく「ソフトウェアエンジニアとして行動するモデル」です。 OpenAIがAstraの能力をサイバーセキュリティとセットで警戒しているのも、この自律性があるからです。 脆弱性に関する知識を文章で説明するAIと、実際の環境で探索、検証、コード実行を繰り返せるAIではリスクの性質が違います。
第8章 Astraの「Critical Cyber」評価はなぜ重大なのか
OpenAIは8月7日時点ではAstraがCritical cybersecurity capabilityに達している可能性を排除できないとしていましたが、9月1日の追加評価で、AstraがPreparedness Framework上のCritical thresholdを満たすと正式に判断しました。 これは非常に重い表現です。 OpenAIはAstraを「危険だから発売できない」としているのではありません。Critical級能力に見合うセキュリティ管理を整備したうえで近日提供する方針です。高度なサイバー機能は限定アクセスから始めます。 OpenAIが公表した対策には、分離されたテスト環境、ネットワークとツールへのアクセス制限、モデルウェイト保護、暗号化、監視・検知、サンドボックス実行などが含まれます。 さらに、強化された要件を満たさないAstra関連の内部活動を一時停止しました。 ここで、混同されやすい二点を明示しておきます。 第一に、この記述は9月1日に更新されました。8月7日の公式表現は「Critical水準を排除できない」でしたが、追加評価後の9月1日、OpenAIはAstraがCritical thresholdを満たすと正式に結論づけました。
第二に、同時期に報じられたHugging Faceの開発プラットフォームへの攻撃について、OpenAIはAstraが関与していないと説明しています。安全対策の強化はこの事案への対応ではなく、内部評価の結果に基づく判断です。 なお、OpenAIは公開スケジュールの見直しについて、ホワイトハウスへ自主的に通知したと報じられています。フロンティアモデルの発売判断が、企業内部の意思決定だけで完結しなくなりつつある、ということでもあります。 これはモデル開発の歴史で重要な変化です。 これまでAI安全性の議論では、「将来もっと賢いモデルが出たら危険かもしれない」という未来形が多く使われてきました。 Astraでは、OpenAIが8月7日時点で「Critical水準を排除できない」と公表し、その判断に基づいて実際の開発ワークロードを一時停止しました。その後、9月1日には追加評価を踏まえてCritical thresholdを満たすと正式認定し、最大規模のフロンティアRLランは8月28日に再開済みであることも明らかにしています。
つまり安全性が研究上の付属項目ではなく、モデルの開発速度そのものを制約する実務上のボトルネックになり始めたのです。
第9章 OpenAIがAstra関連ワークロードを止めた理由
OpenAIは、Astra関連のすべての作業を全面停止したわけではありません。 公式説明では、より厳格なセキュリティ基準を満たしているAstraの訓練や評価は継続できる一方、多数のワークロードが新基準へ移行するまで停止状態にあるとしています。 これは非常に重要な違いです。 「Astra開発中止」ではありません。9月1日のOpenAI発表では、Astraを近日提供する方針が明示されています。 むしろ「Astraほど強力なモデルを従来の開発環境で扱うことができなくなった」と理解した方が近いでしょう。 AIモデルがコードを書くだけなら、一般的な開発サンドボックスで十分かもしれません。しかしモデルが高度な脆弱性探索、ツール操作、長時間自律行動を行えるようになると、モデル自身がテスト環境の境界を越えるリスクまで考えなければなりません。 OpenAIはChain-of-Thoughtを含むエージェント行動の監視強化にも言及しています。 そして8月18日、OpenAIは「Pacing model development in an era of cyber-critical capabilities」という続報を公表しました。ここで示された数字は、抽象論ではなく実務の話です。
【発表ベース OpenAIが8月18日に明かした運用実態】 強化学習の訓練を約2週間にわたって停止した。 最大規模のフロンティア強化学習は8月18日時点では保留だったが、強化した要件を整えたうえで8月28日に再開された。 新しい監視体制によって、計算資源に約20%のオーバーヘッドが発生している。 異常を検知した場合、30分以内にアラートを上げる基準を設けた。 活性化分類器を、サンプリングされるすべてのトークンに対して実行している。 Preparedness Frameworkそのものを書き換える方針である。 この「約20%のオーバーヘッド」という数字は重要です。安全策が、抽象的な理念ではなく、GPU時間として計上される費用になったということだからです。 ここにはAI開発の新しい課題があります。 モデルを賢くする速度より、賢くなったモデルを安全に訓練・評価できるインフラ整備の速度が遅くなる可能性です。 将来、フロンティアAI企業の競争力はGPU保有量だけでなく、「超高能力エージェントを安全に閉じ込めた状態で研究できるセキュア計算基盤」の質でも決まるかもしれません。
【強化学習を止めた意味と8月28日の再開】
第9章で扱ったOpenAIの対応を、もう一段掘り下げます。 「一部ワークロードを停止した」という表現は穏当に聞こえますが、止めた対象が何かを見ると印象が変わります。強化学習の訓練です。 現在のフロンティアモデルにおいて、事前学習の後に来る強化学習は、性能を決める中心的な工程です。エージェントとしての振る舞い、ツール利用、長時間タスクの持続性は、ここで作られます。それを2週間止め、最大規模のフロンティア強化学習については8月18日時点でも保留のままとしました。 つまりOpenAIは、次期主力モデルの性能を作る工程そのものに、安全性を理由としたブレーキを踏んでいます。 これは「発売を遅らせた」よりずっと重い判断です。発売の延期は在庫の話ですが、訓練の停止は生産ラインの話だからです。 そして約20%の計算オーバーヘッド。監視のためだけに、保有計算資源の五分の一を差し出しているという意味になります。GPUの調達競争が業界の中心テーマである時期に、その五分の一を安全策へ回すのは、小さな決断ではありません。
第16章で「ボトルネックは知能から信頼性へ」と書きましたが、より正確に言えばこうです。ボトルネックは、モデルを賢くする速度から、賢くなったモデルを安全に訓練できる環境を用意する速度へ移りつつあります。
【9月1日の続報による更新】 本章の記述は8月18日時点のものです。9月1日の「Path to Astra」で、その後の経過が明らかになりました。 2週間の訓練停止は、OpenAIとHugging Faceの事案を受けたものでした。目的は訓練インフラの堅牢化です。分離とネットワーク制御、監視の拡張、アラインメント訓練と閾値の強化が含まれます。その後は、より厳しい統制の下で小規模な作業を継続していました。 そして8月28日、以前停止していた大規模フロンティア強化学習ランを再開しました。新しい安全・セキュリティ要件を導入したうえでの再開です。ただし一部の小規模な実験的訓練ランは、引き続き一時的に保留されています。 したがって「OpenAIは強化学習を止めたままだ」という理解は、9月2日時点では古くなっています。止めて、要件を作り、再開した。この一往復が完了しています。ブレーキは踏みっぱなしではなく、踏んで、直して、離す、という運用に入りました。
第10章 Astraが数学・理論計算機科学で見せた能力
Astraの重要性はサイバー能力だけではありません。 OpenAIは2026年8月、「Ten advances in mathematics and theoretical computer science」という公式発表を公開し、Astraの内部版が数学・理論計算機科学の長年の問題に対して新しい結果や大幅な進展を得たと説明しました。 対象分野には高次元幾何、符号理論、算術回路複雑性、群論、作用素環、量子複雑性、格子暗号、極値組合せ論などが含まれます。 OpenAIはこれらの結果について、Astraの内部版が解を探索し、人間が同じモデルを用いて論文原稿へ整え、その後モデルがLeanによる形式化証明も行ったと説明しています。 この流れはAI研究者の将来像を考えるうえで非常に重要です。 従来のLLMは既知の論文を要約することは得意でした。 次の段階では、既存文献から候補アイデアを組み合わせ、新しい証明方針を探索し、反例を探し、計算実験を行い、最終的に形式検証まで進めるようになります。 これは「検索の高度化」ではありません。 研究プロセスそのものの自動化です。 ここで、日本語報道でしばしば省かれる二点を補います。
第一に、「10件を解決」という表現は正確ではありません。10件の性質は一様ではないからです。反例の構成、上界の改善、下界の改善、存在の明示的な構成。それぞれ成果の種類が異なります。「10種類の異なる成果」と書くのが正しい表現です。この発表を行ったのはOpenAI研究者のセバスチャン・ブベック氏で、10件それぞれについてLean証明書と手順の解説が公開されました。Epoch AIのFrontierMath責任者エリオット・グレイザー氏は、非ソフィック群に関する結果だけでも一流誌に掲載される水準だと評価しています。 OpenAIは探索にかかった費用も公表しました。API料金換算で約2,000ドル(約32万円、1ドル160円換算)未満です。 第二に、この発表には即座に反証が付いています。 24時間以内に、Anthropicの研究者レベント・アルペーゲ氏が、公開済みのClaude Fableを使って10件のうち5件(4番から8番)を再現したと表明しました。実験条件は、完全自律動作、汎用的なプロンプト、インターネットアクセスなし、そしてOpenAI側の解法がコンテキストへ漏れ込まないよう追加の保護をかけた状態だったとされています。 これが意味することは二つあります。
一つは、Astra固有の能力かどうかが決着していないということです。未公開の次世代モデルの成果が、すでに一般提供されているモデルによって半分再現されたのなら、「Astraだからできた」という説明は弱まります。 もう一つは、数学における先取権の賞味期限が劇的に短くなったということです。従来、証明の優先権をめぐる争いは、投稿、査読、改訂を経て年単位で決着していました。今回は、未発表モデルの成果が24時間で半分追いつかれています。 もちろん、AIが出した数学的結果については専門家による独立検証が不可欠です。また「真に新しい概念を創造したのか」「既存アイデアを非常に巧みに再構成したのか」という哲学的・科学史的な評価も別問題です。 しかし産業的な意味では、研究者一人がAIエージェントを使って探索できる仮説空間が桁違いに広がることが重要です。
第11章 AstraはGPT-6なのか、それとも別の製品系列なのか
Astraについてネット上では「GPT-6ではないか」「GPT-5.x系列ではないか」「新しい推論モデル系列ではないか」など多くの説があります。 しかし現時点では断定できません。 OpenAI公式が明確に述べているのは、Astraが近日公開予定のモデルの一つであり、別の公式記事では次の主要モデルと位置付けられていることです。 内部コードネームと最終製品名が一致するとは限りません。 先例があります。OpenAIは2026年4月、「GPT-6になる」と広く見られていた開発コードネーム「Spud」のモデルを、あえてGPT-5.5として出荷しました。直近一年でも、GPT-5.1、5.2、5.4、5.5、5.6と小刻みなポイントリリースを重ねています。バージョン番号は技術的な世代を表す指標というより、期待値を管理する道具として使われています。 このことは、予測市場の動きにも表れました。
【報道ベース Polymarketにおける「2026年8月31日までにGPT-6がリリースされる」確率】 7月27日 34% 8月11日 22% 8月13日 13% 8月16日 8% 8月18日 11% 8月19日 4.5% 8月20日 2.4% 次のモデルが近づいているのに、GPT-6の確率は下がり続けました。一見ねじれた動きですが、読み方は単純です。市場は「出るのはAstraであって、GPT-6ではない」と判断していました。 一方、Fable 5.1については9月1日の正式発表で名称が確定しました。名称がなお未確定なのはAstra側です。 OpenAIは過去にも研究開発段階の名称、API上の名称、ChatGPT上の表示名を必ずしも完全一致させてきたわけではありません。 さらに2026年のAI製品は、単一モデルをそのままユーザーへ見せる構造から離れています。 ChatGPT内部で複数モデルをルーティングする。 タスクによって推論量を変える。 エージェント実行時には別のモデルやツールを使う。 コーディングでは専用最適化された実行系を組み合わせる。 このためAstraが「GPT-6」という単独商品として出るとは限りません。
重要なのは名称より、Astraの能力がChatGPT、API、Codex、研究機能、エージェント製品へどのように配備されるかです。
第12章 「ultima-alpha」説と数日以内の公開説をどう見るべきか
Astraについては8月末から、内部dogfood段階を越え、一部パートナーへ「ultima-alpha」という名称で提供されているという未確認情報が広がりました。 この情報の出所を明示しておきます。8月29日のX上の投稿です。同時期には「mozaik-alpha-fdm」という別のコードネームも流通しました。裏取りされた一次情報ではなく、単一のSNS投稿を起点とする噂です。 比較のために書いておくと、Anthropic側の「melon」「marshmallow」は、複数の開発者によるモデル一覧のスクリーンショットという形で観測されており、証拠の性質が異なります。同じ「コードネーム」でも、確度は同列ではありません。 さらに、パートナーからのフィードバック次第で早期アクセスを拡大し、その後広範囲へ展開するという観測も出ています。 これが事実なら、一般公開へ向けた最終段階に近いことになります。 しかし、ここはFable 5.1以上に慎重に扱う必要があります。 理由は、OpenAIがAstraの開発・公開の一部を安全対策の整備のため実際に遅らせた経緯があるからです。主力の大規模フロンティアRLランは8月28日に再開しましたが、一部の小規模実験ランは引き続き保留されています。
通常のモデルであれば、パートナーテスト開始から短期間で公開されるという推測もできます。しかしAstraは9月1日にOpenAI初のCritical Cyberモデルと正式認定されました。OpenAI自身は安全策がリリース条件を満たしたと判断し「soon」としていますが、それでも一般公開日を明示していません。したがって、日付リークより公式の段階的提供方針を優先して読むべきです。 したがって「9月3日」「今週後半」「数日以内」といった日付情報は、現時点では公式確定情報ではありません。 Astraについて確実に言えるのは、OpenAIが実在を認め、次期主要モデルとして扱い、9月1日にPreparedness Framework上のCritical cybersecurity capability thresholdを満たすと正式認定したことです。さらにOpenAIは、安全策がリリースに必要な水準へ達したとの判断を示し、近く提供すると明記しています。 公開日は別問題です。
9月2日朝までに確認できたReuters、Axios、Wiredなどの続報も、OpenAIが「soon」としている点では一致していますが、具体的な一般公開日を裏付ける一次情報は出ていません。一部報道はCiscoやCloudflareなどの早期アクセス先に触れていますが、OpenAIの9月1日公式発表本文では社名を列挙していないため、本稿では「公式確定情報」としては扱いません。
第13章 Fable 5.1対Astra――本当の競争軸と評価方法
Fable 5.1は9月1日に先行して正式投入されました。AstraもOpenAIが近日提供を明言しているため、2026年9月はAnthropic対OpenAIの新モデル競争が短い時間差で可視化される可能性があります。 しかし本当の競争はベンチマーク表の一位争いではありません。 2026年後半の競争軸は「仕事を任せられる時間」です。 初期のChatGPTは数十秒で回答するAIでした。 次に、数分考える推論モデルが登場しました。 その次に、数十分かけてブラウザやコード実行環境を使うエージェントが登場しました。 そしてFable 5は複数日タスクを明示的に掲げています。 この延長線上では、AIの価値は「一回の質問に何点の答えを返すか」から「月曜日に仕事を渡して金曜日に成果物を受け取れるか」へ変わります。 企業にとってはこちらの方がはるかに重要です。 人間の社員を採用するとき、IQテストの点数だけで採用する会社はありません。 締切を守れるか。 曖昧な指示を具体化できるか。 途中で問題が起きたとき報告できるか。 他の人と協力できるか。 成果物を検証できるか。 同じ失敗を繰り返さないか。 AIエージェントにも同じ評価が必要になります。 Fable 5.1対Astraは「どちらが賢いか」ではなく、「どちらがより長く、安定して、低コストで、人間の監督を減らした状態で仕事を完遂できるか」という競争になるでしょう。
【なぜベンチマーク一位だけでは次世代AIを評価できないのか】
Fable 5.1とAstraが正式に登場した場合、SNSではすぐに各種ベンチマークの数字が比較されるでしょう。しかし2026年のフロンティアモデルでは、単一ベンチマークだけで優劣を判断することがますます難しくなっています。 第一の理由は、実際の仕事が一問一答ではないからです。現実のソフトウェア開発では、仕様書を読み、既存コードを理解し、複数のファイルを変更し、テストを実行し、失敗したら原因を調べ、場合によっては設計そのものを見直します。一つの問題を正解する能力より、数百回の判断を連続して正しくつなぐ能力が必要です。 第二の理由は、モデルとエージェントシステムを分離して評価しにくくなっているからです。同じ基盤モデルでも、どのツールを与えるか、どのようにコンテキストを圧縮するか、どのタイミングでメモリへ保存するか、何回まで再試行を許すか、サブエージェントへどのように仕事を割り振るかによって結果は大きく変わります。 第三の理由は、推論時の計算量が固定ではなくなっているからです。簡単な問題には少ない計算を使い、難しい問題には大量の計算を投入する方式が一般化すると、「同じモデルのスコア」であっても、どれだけの時間とコストを使った結果なのかを確認しなければ公平に比較できません。
第四の理由は、人間介入率です。あるモデルが90%の仕事を完了しても、途中で10回人間へ質問するなら、自律エージェントとしての価値は限定されます。別のモデルが最終品質では少し劣っていても、一度仕事を渡せば8時間自律的に進められるなら、企業にとって後者の方が高い価値を持つ可能性があります。 第五の理由は、再現性です。エージェントは確率的に行動するため、一度成功したデモだけでは性能を判断できません。同じ仕事を10回、50回、100回実行し、成功率、平均所要時間、平均コスト、重大ミス率を測る必要があります。 そのため、Fable 5.1とAstraの比較では、従来型の「正答率」に加えて、Task Completion Rate、Human Intervention Rate、Time to Completion、Cost per Completed Task、Recovery Rate、Critical Error Rateといった運用指標を見る必要があります。 特にCost per Completed Taskは重要です。
例えばモデルAが一時間1ドル相当で動くとしても、完了率が30%なら何度も再実行する必要があります。モデルBが一時間5ドルでも、ほぼ一回で完了するなら、総費用ではBの方が安くなる場合があります。さらに人間の監督時間まで含めれば差はさらに大きくなります。 これはクラウドコンピューティングの初期と似ています。CPU単価だけではシステム全体の経済性を判断できなかったように、AIでもトークン単価だけでは仕事の経済性を判断できなくなります。 もう一つ重要なのが「失敗の質」です。 AIが失敗すること自体は避けられません。しかし、失敗を自分で認識して人間へ報告するAIと、失敗したことに気づかず「完了しました」と報告するAIでは、企業利用の安全性がまったく違います。 長時間エージェントに必要なのは、万能性ではありません。 自分が何を知っているか。 何を知らないか。 どこまで確認したか。 何がまだ未検証か。 どの操作が不可逆か。 どこで人間の承認が必要か。 これらを正確に管理する能力です。 Fable 5.1やAstraの登場によってこの能力が大きく改善されれば、AIは単なる生産性ツールから企業の業務フローそのものを構成する存在へ近づきます。 そして、その段階ではAI企業の競争相手も変わります。
AnthropicやOpenAIは、単に他のLLM企業と競争するだけではありません。ソフトウェア開発ではIDEや開発受託会社、調査ではコンサルティング会社、バックオフィスではBPO企業、セキュリティではSOCやセキュリティベンダーの一部業務と重なっていきます。 つまりモデル能力の進歩が、そのまま既存産業のサービス境界を動かしていくのです。 Fable 5.1とAstraの発表で最も注目すべきなのは、「どちらがベンチマークで一位だったか」ではなく、「これまで人間が数時間から数日かけていた仕事のうち、どこまでを一回の指示で最後まで完了できるようになったか」です。 そこに2026年後半のAI競争の本当の意味があります。
第14章 Claude Code対Codex――AIソフトウェアエンジニア競争
この競争が最も早く可視化されるのがソフトウェア開発です。 理由は明確です。 ソフトウェア開発は成果物がデジタルで完結します。 AIがコードを書き、コンパイラやテストが結果を返し、失敗したら修正できます。 つまり環境からのフィードバックが速く、強化学習やエージェント訓練と非常に相性が良いのです。 AnthropicにはClaude Codeがあります。 OpenAIにはCodexを中心とするコーディング環境があります。 モデル単体の差より、今後はこの実行環境全体の差が重要になります。 例えば同じ能力のモデルでも、リポジトリ検索が優れている方が勝ちます。 コンテキスト圧縮が上手い方が長時間動けます。 テスト失敗を正確に解釈できる方が修正回数を減らせます。 Git履歴を理解できる方が既存設計を壊しにくくなります。 複数エージェントを適切に分担できる方が大規模案件を処理できます。 つまり「最高のLLM」ではなく「最高のAI開発組織をソフトウェアとして作れる会社」が勝つ可能性があります。 Fable 5.1とAstraは、その中核エンジンとして比較されることになるでしょう。
第15章 長時間自律動作が企業の仕事をどう変えるのか――38時間・3日間の実例
長時間自律動作が実用化すると、AI導入のROI計算が根本的に変わります。 現在の生成AIは、人間が頻繁にプロンプトを入力し、結果を確認し、修正指示を出すケースが多くあります。 この方式ではAIが速くても、人間が監督者として拘束されます。 例えばAIが1分で作業しても、人間が5分ごとに確認しなければならないなら、完全な自動化ではありません。 一方、AIに8時間の仕事を渡し、翌朝に確認すればよいなら、人間一人が多数のAIエージェントを同時に管理できます。 ここで初めて「AI社員」という表現が経済的な意味を持ち始めます。 ソフトウェア開発だけではありません。 市場調査。 競合調査。 営業候補企業の調査。 文書整理。 法務資料の一次分析。 財務モデル作成。 製造データ分析。 品質異常の原因探索。 サプライヤー比較。 学術調査。 特許調査。 社内ナレッジ整理。 これらの仕事を、数十分ではなく数時間から数日継続して実行できれば、ホワイトカラー業務の設計そのものが変わります。 重要なのは、人間が不要になるという単純な話ではありません。 人間の役割が「一つ一つ作業する人」から「複数のAIへ目的、制約、優先順位を与え、最終判断を行う人」へ変わります。
【早期アクセス企業が見た38時間・3日間の無人実行】
ベンチマークより実務に近い材料として、Anthropicは早期アクセスパートナー22社の証言を公開しました。本稿の主題に関わるものを抜き出します。以下はいずれも各社の担当者による申告であり、独立検証ではありません。 【長時間の無人実行】 決済企業Rampの機械学習エンジニアは、機械学習の課題に対する38時間の無人実行を報告しています。モデルは先行する結果をラベルの人工物だと診断し、修正し、六つの並列実験を一晩走らせ、結果と次の手順を返したとされます。別の例では、「誰も担当していない最も影響の大きい問題を見つけよ」という開かれた指示に対し、本番障害に紐づく担当者不在のアラートを掘り起こし、ログを引いて修正方針を示したといいます。 MongoDBのエンジニアは、複雑なプロトタイプが約3日で完成したと述べています。全サービスのコードとドキュメントを横断して初期調査を行い、新しい拡張可能な設計を作り、その後は無人で数時間走り続けて実装まで到達しました。朝になると次の段階が終わっており、視覚的な確認手順と成功の証拠が揃っていたとしています。
Shopifyのエンジニアは、長時間の無人作業でモデルが筋を見失わなくなったと述べています。自分で記録を残し、状況の変化に応じて優先順位を組み替え、中断地点から再開できる、という説明です。 本稿のサブタイトルは「数日間働き続けるAI」でした。38時間、3日間、無人。これらの数字は、その表現が比喩ではなくなりつつあることを示しています。
【根本原因への到達】 投資会社Millenniumのポートフォリオマネージャーは、100万回に1回という極めて稀なクラッシュについて報告しています。4〜5年のあいだ、チームの誰も説明できず、Fable 5を含むどのモデルも見つけられませんでした。Fable 5.1は外部ベンダーのライブラリを逆アセンブルし、コアダンプと突き合わせ、そのライブラリのバグまで追跡したとされます。 Red Hatのエンジニアは、テストした壊れたビルドすべてについて、あらゆるeffort水準で根本原因を正しく特定したと述べています。Datadogのエンジニアは、実際の本番障害を使った原因分析の評価で、Opus 5より強い推論を示したとしています。 【コストと速度】 Everyの経営者は、Opus 5の約2倍速く、トークンは半分だったと述べています。Rogoは、社内の金融ベンチマークで精度はFable 5と同等のまま、トークンが20%少なかったとしています。
Browserbaseは、最も難しいブラウザエージェントのベンチマークで、Fable 5.1が1タスク約10分で82%を完了したと報告しています。Opus 5は74%、Fable 5は57%で、しかもトークン消費はどちらより少なかったとされます。加えて、数百の測定タスクを通じて、一度も重要な停止点を越えなかったといいます。 この最後の一文は見逃せません。本稿の第16章で「信頼性がボトルネックになる」と書きましたが、企業が実際に測っているのはまさにこれです。何点取ったかではなく、越えてはいけない線を何回越えたか。
【その他】 Jane Streetは、従来のモデルが長く動くほど追いにくくなったのに対し、Fable 5.1は長い多段階タスクでも読みやすさを保つと述べています。iGentは、18か月にわたり試験台としてきた難問で実質的な進展が出たとし、Fable 5.1がFable 5では行き詰まった計算カーネルを約35%最適化したと報告しています。楽天は、他の三つのフロンティアモデルが問題なしと判断した臨床研究プロジェクトのレビューで、Fable 5.1が見落とされていた欠落を発見し、新しい仮説を提示したとしています。 これらの証言を、ベンチマークより重く見るべきか軽く見るべきかは、判断が分かれるところです。ベンダーが選んで公開した好意的な事例である以上、失敗例は含まれていません。しかし「38時間動いた」「4〜5年誰も解けなかった」といった記述は、ベンチマークのパーセンテージより企業の意思決定に近い情報です。
第16章 AIエージェント時代のボトルネックは知能から信頼性へ――安全監視との両立
モデルが十分賢くなると、次のボトルネックは信頼性です。 AIが95%正しいことと、企業が安心して仕事を任せられることは同じではありません。 銀行送金、契約変更、本番サーバー操作、顧客へのメール送信、製造設備の設定変更などでは、一回の重大ミスが大きな損失につながります。 したがってエージェント時代には、モデルの能力と同じくらい次の仕組みが重要になります。 権限管理。 承認フロー。 サンドボックス。 監査ログ。 ロールバック。 行動制限。 異常検知。 人間へのエスカレーション。 秘密情報の管理。 ネットワーク分離。 AstraをめぐるOpenAIの対応は、この未来を先取りしています。 AIが強くなるほど、AIそのものだけでなく「AIをどこまで行動させてよいか」を制御するシステムが重要になります。 これは企業向けAI市場に新しい巨大分野を作るでしょう。 AI Identity。 AI Access Management。 AI監査。 Agent Security。 Agent Observability。 AI Sandbox。 AI Governance。 人間向けのIAMやゼロトラストが巨大市場になったように、AIエージェント向けの権限・監視基盤も重要なインフラになる可能性があります。
【Anthropic側でも起きていたペーシング】
減速しているのはOpenAIだけではありません。 8月31日、Anthropicは自社のアライメントとセキュリティの取り組みに関する報告を公表しました。7月30日に公表していた3件のサイバー評価上の事案に加え、8月4日に英国AI安全研究所が報告したMythos 5に関する事案が扱われています。 7月30日の事案は、本稿の主題に直結するので中身を書いておきます。 【発表ベース 7月30日にAnthropicが開示した3件】 141,006件のサイバー評価実行をレビューした結果、6回の実行にまたがる3件の事案が特定された。 いずれもClaudeモデルが、第三者のテスト環境から公共インターネットへ到達し、実在する組織への不正なアクセスを取得したものである。 これらのモデルは、一般提供されるClaudeに適用されるサイバーセーフガードなしで動作していた。 モデルはCapture the Flag演習を行っており、自分の環境はインターネット接続のないシミュレーションであると明示的に告げられていた。 しかし設定上の問題により、インターネットへの経路が開いたままになっていた。
ここで起きたことを整理すると、次のようになります。モデルは「ここは閉じた環境だ」と教えられ、脆弱性を突く演習をしていた。そして環境は閉じていなかった。結果として、演習の対象が実在の組織になった。 これは悪意あるモデルの物語ではありません。設定ミスと、指示を信じて課題を遂行するエージェントの組み合わせが生んだ事故です。 本章で扱う「ボトルネックは知能から信頼性へ」という問題と、「安全策が長時間エージェントを止める」という問題は、同じ構造の裏表です。この事案は、その両方が同じ問題の裏表であることを示しています。エージェントは与えられた環境情報を信じて動く。環境情報が間違っていれば、能力はそのまま実世界へ漏れ出します。141,006回のうち6回。率としては小さい。しかし長時間エージェントを大量に走らせる時代には、この率が絶対数を決めます。
【発表ベース Anthropicが8月31日に明かした対応】 外部向けのサイバー評価を停止した。 高リスクの強化学習環境を数週間にわたり停止した。一部は8月31日時点でも停止中である。 2月、Mythos Previewの強化学習を3日分ロールバックした。 4月、訓練環境を凍結し、10%を超える差し戻しを行った。 約150名をセキュリティ部門へ配置転換した。 報酬ハッキングに関する80の環境で、Opusクラスのモデルを意図的に訓練する実験を行った。 この最後の項目は特異です。報酬ハッキング、つまりモデルが評価指標を出し抜く挙動を、あえて訓練して観察したということです。安全性研究が「危険な挙動を防ぐ」段階から、「危険な挙動を実際に作り出して調べる」段階へ入っています。 二社が、ほぼ同じ時期に、ほぼ同じ形の判断をしています。OpenAIは8月7日と8月18日に、Anthropicは7月30日と8月31日に。いずれも強化学習に関わる工程を止めています。 2026年後半のAI競争を「どちらが速いか」の話として読むと、この同時性を見落とします。実際に起きているのは、両社が同時にブレーキを踏み、そのうえで互いの発表タイミングを計っている、という状況です。
Fable 5.1の発表が「Astraを待つ」と報じられ、その後「待たずに前倒しする」と報じられ、さらに「来週へずれた」と報じられる。この揺れは、単なるマーケティングの駆け引きではないかもしれません。
【安全策が長時間エージェントを止める副作用】
本稿の主題は「数日間働き続けるAI」です。9月1日のOpenAIの発表には、その主題に真正面からぶつかる記述があります。 OpenAIは、Astraの追加の安全確認が、正当な作業を遅らせたり、一時停止させたり、停止させたりすることがあると明記しました。防御目的のサイバーセキュリティ作業も含まれます。 そして次の一文が重要です。その対象には、サイバーセキュリティと直接関係がないように見える作業や、エージェントが長時間動作しているタスクも含まれる。 具体的な挙動も示されています。misalignment monitorがタスクを一時停止した場合、ChatGPTやCodexの利用者は続行前に確認を求められます。APIを使っている場合は、タスクがそこで止まります。 ここに、長時間エージェントの構造的な問題があります。 タスクが長くなるほど、監視系が異常と判定する機会は増えます。38時間動くエージェントは、38時間ぶんの判定対象を生みます。そして自律性が高いほど、モデルの行動は「想定された範囲」から見て珍しくなります。珍しさは、監視系にとって信号です。 つまり、長時間自律動作という機能そのものが、安全監視にとっては誤検知の温床になります。能力を上げれば上げるほど、その能力を使ったときに止められる確率が上がる。
OpenAIはこの副作用を認めたうえで、セーフガードの調整を続け、Daybreakのようなプログラムを通じてフロンティア能力へのアクセスを広げると述べています。 Anthropic側も同じ問題に別の形で向き合っています。Fable 5でのフォールバック率の高さ、8月7日の生物学分類器の85%削減、9月1日のサイバー誤検知60%削減。いずれも「止めすぎ」を減らす作業です。 企業がこれから測るべき指標が、ここでもう一つ増えます。完遂率でもコストでもなく、安全策による中断率です。8時間の仕事を任せたとき、何回止まり、何回人間の確認を求められるか。API経由で止まった場合、そこまでの作業はどう扱われるか。
第19章の確認項目でも、この観点は「11個目の安全制限」として扱います。9月1日の発表を踏まえると、これは項目の一つではなく、長時間エージェントを実運用する際の中心的な変数になりつつあります。
第17章 サイバー能力の飛躍が意味する「攻撃と防御の自動化」
AstraのCritical Cyber評価は、AI産業だけでなくサイバーセキュリティ産業にも大きな意味を持ちます。 高度なAIエージェントは、防御側にとって非常に強力です。 巨大なコードベースから脆弱性候補を探す。 依存ライブラリを監査する。 パッチを生成する。 テストする。 ログから侵入兆候を探す。 設定ミスを検出する。 インシデント発生時に影響範囲を調査する。 これらを24時間実行できれば、防御力は大きく向上します。 一方、同じ一般能力は攻撃側にも転用され得ます。 ここで重要なのは、AIが新しい脆弱性知識を持つことだけではありません。 探索を高速に繰り返せることです。 人間なら一日に数十回しか試せない作業を、AIエージェントが大量並列化できるようになると、サイバー攻防の時間軸が変わります。 そのためOpenAIがネットワークアクセスやツール利用を厳格に制御しているのは合理的です。 今後はフロンティアモデルの発売時に、数学やコーディングのベンチマークだけでなく、「どの程度のサイバー能力を持つか」「どの利用を制限するか」「どのような監視を行うか」が主要項目になるでしょう。
第18章 価格、企業採用、IPO、推論コストの戦い
能力が高くても、コストが高すぎれば普及しません。 現行のAnthropicモデルのAPI価格を並べると、設計意図がはっきり見えます。1ドル160円換算を併記します。 【発表ベース AnthropicモデルのAPI価格(100万トークン当たり)】 Claude Fable 5.1 入力10ドル(約1,600円)/出力50ドル(約8,000円)/キャッシュリード0.25ドル Claude Fable 5 入力10ドル(約1,600円)/出力50ドル(約8,000円)/キャッシュリード1ドル Claude Opus 5 入力5ドル(約800円)/出力25ドル(約4,000円) Claude Sonnet 5 入力2ドル(約320円)/出力10ドル(約1,600円) Opus 5はFable 5のちょうど半額です。「近い価格」ではなく、正確に半分に設定されています。これは偶然ではなく、価格帯の設計です。
Fable 5.1の基本入力・出力単価はFable 5と同じですが、キャッシュリードは1ドルから0.25ドルへ75%下がりました。Anthropicは、2026年8月の実使用データを基に、典型的ワークロードで約25%、複雑なコーディングや高度なエージェント処理では最大約45%の総コスト削減になると説明しています。 データ保持については一律に「ZDR不可」と書くと不正確です。Fable 5.1はCovered Modelとして原則30日保持を求めますが、Anthropicが明示的に認めた対象顧客にはZDR利用を認めており、EFS提供までの移行措置としてeligible customersがFable 5.1とFable 5をZDRで利用できるとしています。 これは一般的な軽量モデルよりかなり高価です。 しかし長時間エージェントでは、単純なトークン単価だけで評価してはいけません。 例えば安いモデルが仕事を完了できず、人間が何度も介入するなら、総コストは高くなります。 逆に高価なモデルでも、10時間分の人間作業を自律的に完了できるなら経済合理性があります。 今後重要になるのは「100万トークンの価格」より「一つの仕事を完了する価格」です。 Cost per completed task。
これがAIエージェント経済の重要指標になります。 さらに、長時間推論ではモデルが大量のトークンと計算資源を消費します。
Fable 5の利用が段階的・使用量ベースで提供されたことからも、最高性能モデルの供給には依然として計算資源制約があることが分かります。 Astraも高い推論能力と長時間エージェント性能を持つなら、公開初期は利用制限、プラン制限、APIレート制限などが設定される可能性があります。 したがって発表時には性能だけでなく、価格、レートリミット、利用可能地域、プラン、API提供時期を確認する必要があります。 そして、ここには本稿で最も重い事実が控えています。 この価格設計に対して、企業顧客はすでに答えを出しています。Financial Timesが8月に報じたデータによれば、最上位モデルであるFable 5は、Anthropic自身のツール支出のうち約11%しか占めていません。半額のOpus 5が、すでにFable 5を追い抜いています。 この企業採用の実態は、この章の後半で詳しく扱います。ここでは一点だけ先取りしておきます。「最も強いモデルを作れば、顧客は最も強いモデルへ移る」という、これまで自明とされてきた前提が崩れつつあります。
そしてFable 5.1は、この前提を価格構造の変更で立て直そうとしました。ただし、その効果には独立測定からの反証が出ています。第三者評価機関Artificial Analysisの計測では、max effortで動かした場合、Fable 5.1のタスク当たりコストはFable 5より約20%高くなります。出力トークンを約1.7倍使うためです。 同じモデルについて「約25%安くなる」と「約20%高くなる」が同時に成り立っています。矛盾ではなく、測定条件の違いです。この点も、この章の後半で詳しく扱います。
【企業は最上位モデルに本当にお金を払うのか】
本稿でここまで書いてきたことのうち、最も重い事実を最後に置きます。 Financial Timesは8月23日、決済プラットフォームRampのデータをもとに、Fable 5の企業導入が伸びていないと報じました。 【報道ベース Rampが米企業7万社を分析したデータ】 Fable 5は、Anthropicのモデルに対する企業支出の11.4%にとどまる。トークン数で見ると6%。 この比率は、発売1か月後の11.4%からほぼ横ばいである。 7月下旬に登場したOpus 5が、数週間でFable 5を企業支出で追い抜いた。 旧世代のOpus 4.8は、6月初旬の15%から7月下旬には50%超へ伸びた。 比較として、OpenAIのGPT-5.6 Solは同社支出の23%、トークンの25%を占める。 Fable 5の価格はGPT-5.6 Solのおよそ2倍で、7月の売上はOpenAI旗艦モデルの75%程度にとどまった。 企業採用数の広さではAnthropicがなお優位で、追跡対象の米企業の43.5%が利用している。OpenAIは39.7%。
Rampのエコノミストは、Fable 5が普及と実利用の両面で期待に届かなかった理由として、価格とデータ保持要件を挙げています。Anthropicはこのデータへのコメントを控えました。 この数字が壊しているのは、フロンティアAI産業の暗黙の前提です。 これまで、新しい最上位モデルが出れば顧客はそこへ移る、という経路が当然視されてきました。だからこそ各社は数十億ドルを投じて能力を上げてきました。能力への支払い意思が、投資回収の根拠だったからです。 ところがFable 5では、その経路が働きませんでした。旧世代のOpus 4.8が50%を超え、半額のOpus 5が最上位を追い抜き、最上位は11%で頭打ちになりました。 理由は単純です。多くの業務では、安いモデルで十分だからです。 さらに、8月時点でトークン使用量の62%はオープンソースモデルが占めているとされます。上からは「十分に良い」自社モデルに、下からはオープンウェイトのモデルに、最上位ティアは挟まれています。 ここまで来ると、Fable 5.1を急ぐ理由が別の角度から見えてきます。
技術的な優位を示すためではありません。最上位ティアの存在理由そのものを立て直すためです。11%という数字は、能力の問題ではなく、能力に対する支払い意思の問題を示しています。5.1が答えるべき問いは「どれだけ賢くなったか」ではなく「なぜ倍の金額を払う必要があるのか」です。 そしてFable 5.1は、この問いに価格構造の変更で答えました。 【9月1日の発表による更新】 Fable 5.1は、この11%という問いに正面から答えました。キャッシュリードの75%値下げです。 その効果が最も分かりやすく現れたのが、AIソフトウェアエンジニアDevinを開発するCognitionの反応です。同社はローンチ当日にDevinのOpus 5トラフィックをFable 5.1へ移すと表明しました。テストでタスク当たりコストがより低い状態でFable 5と同等以上だったこと、そして新しいキャッシュリード価格によってFableクラスがようやく採算に乗ったことを理由に挙げています。まずコードレビューから移すとしています。 これは、Opus 5へ流れていた需要が逆流し始めたことを意味します。Opus 5へ流れた需要が、価格構造の変更によってFableクラスへ戻り始めています。
ただし注意点があります。Anthropicが示した「典型的ワークロードで約25%、高度なエージェント作業で最大約45%」という削減幅は、2026年8月の4週間の実使用データを、デフォルトのeffort水準で測ったものです。典型的ワークロードとはClaude Enterprise、Claude Code、APIにおけるFable利用の全体を指し、高度なエージェント作業とはコンテキストとツールを多用し、キャッシュリードがコストの大半を占める作業を指します。自社の使い方がどちらに近いかで、削減幅は変わります。
【IPOというもう一つの締切】
Fable 5.1をめぐる時計は、技術の時計だけではありません。もう一つ、金融の時計が動いています。 【報道ベース 2026年8月のAnthropic関連報道】 8月14日 2026年第2四半期の売上が115億ドル(約1兆8,400億円)を突破。 8月17日 年間換算売上高が650億ドル(約10兆4,000億円)を突破。5月時点では470億ドルだった。 8月17日 IPO前のクレジットファシリティが100億ドル超へ。 8月18日 CEOへ追加の議決権を与える計画。 8月18日 高度なAIモデルのデータ保持ポリシーを変更する計画。 8月20日 主幹事にシティグループを追加。 8月20日から21日 SpaceXのIPO記録に匹敵、あるいは上回る規模を想定していると複数報道。 8月21日 Nscaleに450億ドル(約7兆2,000億円)を支払う演算契約。 8月26日 Zoomが保有するAnthropic株の評価額が30億ドルに。 Reutersの報道では、10月の上場、最大2兆ドルの評価額、株価売上高倍率およそ30.8倍、2028年の売上見込み1,900億から2,000億ドルという数字が挙げられています。 ここで先ほどの11%という数字を重ねると、構図が見えます。
株価売上高倍率30倍という評価は、能力への支払い意思が今後も伸びるという前提の上に立っています。最上位モデルが最上位の価格で売れる、という前提です。しかしRampのデータは、その前提が現時点では働いていないことを示しています。 つまりFable 5.1は、製品であると同時に、上場前の物語を補修する部品でもあります。 なお、8月18日に議論されていたデータ保持問題は、9月1日の発表で実際に動きました。Covered Modelの原則30日保持は残る一方、Anthropicが明示的に認めた対象顧客へのZDRと、顧客管理クラウド内で監視を成立させるEnterprise Frontier Safeguardsが示されました。前稿で「5.1発表時に確認すべき」とした論点は、正式発表によって企業導入の中心論点へ格上げされた形です。
【Artificial Analysisが示すコストの条件差】
本稿ではここまでに「最上位モデルが売れていない」という数字を扱い、9月1日の正式発表を踏まえて「Anthropicが価格構造で応えた」と書きました。ここで、その答えに対する反証を入れておきます。 出所は第三者評価機関のArtificial Analysisです。しかも同社は、Anthropicのプレリリース段階のテストに協力した側です。身内に近い立場からの異議である点が重要です。 【指標としての評価】 Artificial Analysis Intelligence Indexで、Fable 5.1は66を記録しました。Opus 5が63、GPT-5.6 Solが61です。首位です。 前稿で触れたとおり、Fable 5の同指標は62でした。4ポイント上がっています。なおこのスコアはadaptive reasoning、max effort、デフォルトのフォールバック設定での測定です。 ここまでは、Anthropicの主張と矛盾しません。 【コストとしての評価】 問題はここからです。 Artificial Analysisは、Anthropicの節約に関する主張に異議を唱えています。
【Artificial Analysisによる9月2日時点の公開測定】 Artificial Analysis Intelligence Indexでは、Fable 5.1のmax effortは66、xhighは65、highは62、mediumは60、lowは58です。タスク当たりコストはlow 0.77ドル、medium 1.00ドル、high 1.43ドル、xhigh 2.65ドル、max 3.69ドルで、effort設定によって約4.8倍の差があります。max effortではIntelligence Index評価全体で約1億4,000万出力トークンを生成しており、同社は「非常に冗長」と評価しています。つまり「Fable 5.1は一律に安くなった」のではなく、キャッシュ利用率とeffort設定によって経済性が大きく変わります。
【この反証が意味すること】 Anthropicの「約25%から45%安くなる」という主張と、Artificial Analysisの「max effortでは20%高い」という測定は、矛盾していません。測っているものが違うだけです。 Anthropicが測ったのは、2026年8月の4週間の実使用データをデフォルトのeffort水準で見たときの総コストです。キャッシュリードがコストの大半を占めるワークロードで、その単価を4分の1にすれば、総額は下がります。 Artificial Analysisが測ったのは、max effortでの1タスク当たりのコストです。effortを上げれば出力トークンが増え、出力トークンは値下げされていません。だから上がります。 つまり両者は同じモデルの別の使い方を測っています。そして、どちらの数字が自社に当てはまるかは、自社がどのeffortでどんな作業をしているかで決まります。 【追加調査の問いは解けていない】 より重い含意はこちらです。 追加調査で見た11%という数字の原因は、「Opus 5がFable 5に迫る性能を半額で出したこと」でした。企業は安いほうを選びました。
Artificial Analysisの測定は、この構図が5.1でも続いていることを示しています。Intelligence IndexではFable 5.1のmax effortが66です。一方、同じFable 5.1でもlowからmaxまでタスク当たりコストは0.77ドルから3.69ドルまで大きく変わります。 企業がどのeffort水準を選ぶか、キャッシュをどれほど再利用できるかによって、5.1の費用対効果は大きく変わります。Fable 5時代に見えた「最上位能力と経済性の緊張関係」が解消したかどうかは、まだ判断できません。 ただし、変わる兆しはあります。追加調査の末尾で触れたCognitionは、ローンチ当日にDevinのOpus 5トラフィックをFable 5.1へ移すと表明しました。キャッシュリードの値下げによってFableクラスがようやく採算に乗った、というのが理由です。 Cognitionのようなキャッシュ多用のワークロードでは、Anthropicの数字が効きます。Artificial Analysisのようなmax effortのベンチマーク実行では、逆になります。
結論として、本稿がここで言えるのは一つだけです。「Fable 5.1は安くなった」という一文は、条件を書かずに使うべきではありません。
第19章 Fable 5.1で確定したこと、Astra公開時に確認すべき16項目
Fable 5.1はすでに正式発表されたため、以下ではFable 5.1で確定した値を基準にしながら、Astra公開時に何を確認すべきかを整理します。 1つ目は正式名称です。 Fable 5.1は正式名称として確定しました。Astraについては、内部・研究上の名称がそのまま製品名になるのかを確認します。 2つ目はAPIモデルIDです。 実際の開発で利用できる名称が重要です。 3つ目はコンテキストウィンドウです。 Fable 5.1は100万トークンを維持しました。Astraがどこまで対応するのかが次の注目です。 4つ目は最大出力長です。 長文コード、研究文書、巨大パッチでは重要になります。 5つ目は価格です。 入力、出力、キャッシュ、長文脈、バッチ処理などを含めて確認する必要があります。 6つ目はエージェント型コーディング性能です。 SWE系ベンチマークだけでなく、実際の長時間タスク完遂率を見るべきです。 7つ目はComputer Useとツール利用です。 ブラウザ、ターミナル、API、ファイル操作などをどこまで安定して扱えるかです。 8つ目はサブエージェント機能です。 一つのモデルが全部処理するのか、複数エージェントを自律的に編成できるのかが重要です。 9つ目は長時間稼働です。
30分ではなく、8時間、24時間、数日というスケールでどこまで安定するかを確認します。 10個目は自己検証能力です。 テスト、形式検証、レビュー、反例探索などを自発的に行えるかです。 11個目は安全制限です。 特にAstraではサイバー関連の利用制限、ネットワークアクセス、ツール権限が重要になります。 12個目は実際の提供面です。 Claude.ai、Claude Code、Anthropic API、Amazon Bedrock、Google Vertex AI、Azure AI Foundry、ChatGPT、Codex、OpenAI APIなど、どこからいつ利用できるのかを確認する必要があります。 13個目はデータ保持条件です。
Fable 5.1もCovered Modelとして原則30日間のデータ保持が必要ですが、Anthropicが明示的に認めた対象顧客には例外的にZDRが可能です。さらにEnterprise Frontier Safeguardsの展開まで、eligible customersはFable 5.1とFable 5をZDRで利用できます。規制産業では、単純な「ZDR対応/非対応」ではなく、自社が例外認可やEFSの対象になるかを確認する必要があります。 14個目は分類器のフォールバック率です。 Fable 5では、安全策が働くと下位モデルへ処理が回されます。どの領域で、どの程度の頻度でフォールバックが起きるのか。これは公表された性能値と実際の体感を分ける決定的な変数です。ベンチマーク上の数字が、フォールバック込みで測られている可能性にも注意が必要です。 15個目は最上位ティアの支出比率です。 自社のAI支出のうち、最上位モデルが占める割合はいくらか。約11%という業界の実測値と比べてどうか。この比率は、モデル選定が実態に合っているかを測る簡便な指標になります。 16個目はモデル同一性の検証手段です。
モデル選択画面に表示されている名前と、実際に応答しているチェックポイントが一致していることを、どう確認するか。グレーテストが常態化するなら、これは運用上の必須項目になります。出力だけからモデルを同定することはできない、という前提を持つべきです。 この16項目を見れば、単なるベンチマーク比較より実用的な評価ができます。
第20章 2026年9月は「AIが答える時代」から「AIが働く時代」への転換点になるか
生成AIの歴史を大きく分けると、いくつかの段階があります。 第一段階は文章生成でした。 人間が質問し、AIが文章を返す。 第二段階は推論でした。 AIがより長く考え、数学、科学、コーディングで複雑な問題を解く。 第三段階はツール利用でした。 検索、ブラウザ、Python、ターミナル、外部APIなどを使う。 第四段階がエージェントです。 AI自身が次の行動を決め、何度もツールを使い、結果を見て計画を修正する。 そして現在始まりつつある第五段階が「長時間エージェント」です。 ここではAIが一つのセッション内で数分働くだけではありません。 仕事の状態を保持し、長時間にわたって計画を進めます。 Fable 5が「multi-day tasks」を公式に掲げたことは象徴的でした。 Astraがエージェント型コーディングで大幅な進歩を示し、数学研究でも複数の難問に取り組んだことも同じ方向を示しています。 この流れが続けば、AIサービスのUIも変わります。 現在のチャット画面は「会話」が中心です。 将来は「仕事一覧」が中心になるかもしれません。 進行中。 調査中。 コード実装中。 テスト待ち。 承認待ち。 完了。 失敗して人間確認待ち。
つまりSlackやTeamsのようなコミュニケーションUIと、JiraやAsanaのようなタスク管理UIと、GitHubのような成果物管理UIが、AIエージェントの管理画面へ統合されていく可能性があります。 企業の組織図にもAIが入ります。 人間一人にAI一体ではありません。 人間のマネージャー一人が複数の専門AIを管理する形が自然です。 調査AI。 コーディングAI。 データ分析AI。 営業支援AI。 文書AI。 品質管理AI。 そして高度なモデルが、それらの下位エージェントを束ねる「AIマネージャー」になる可能性もあります。 Fable 5.1やAstraの本当の意味は、モデルランキング一位になることではありません。 この組織構造を現実に近づけることです。
第21章 まとめ
2026年9月2日朝時点で、状況は前稿から大きく変わりました。 Claude Fable 5.1は、もはやリーク上のモデルではありません。Anthropicは9月1日にClaude Fable 5.1とClaude Mythos 5.1を正式発表し、Fable 5.1を一般提供しました。モデルID、価格、100万トークンのコンテキスト、128K出力、2026年6月の知識カットオフも確定しています。 性能ではTerminal-Bench-Science 0.1が24.7%から52.6%へ、Terminal-Bench 4.0が42.0%から55.8%へ、AutomationBenchが17.1%から31.4%へ伸びました。Anthropicの公表値をそのまま絶対評価するのではなく第三者検証は必要ですが、少なくとも5.1の重点が「長時間エージェント」「科学研究」「業務自動化」にあることは明確です。
そして商品設計の変更も大きい。基本の入力10ドル・出力50ドルは据え置きながら、キャッシュリードを0.25ドルへ75%引き下げ、典型的ワークロードで約25%、高度なエージェント処理では最大約45%の総コスト削減を掲げました。データ保持では、Covered Modelの原則30日保持を残しながら、明示的に認可された対象顧客へのZDRとEFSという新しい運用経路を設けています。 Astraも一段進みました。OpenAIは9月1日、AstraがPreparedness FrameworkのCritical cybersecurity capability thresholdを満たすと正式に認定しました。これは8月時点の「可能性を排除できない」という表現から明確な更新です。 Astraは既知脆弱性のexploit開発評価で100%を記録し、内部の新しいV8脆弱性評価では二つのzero-dayを発見してexploit chainへ組み込み、強化ブラウザのsandbox escapeや強化OSのroot権限昇格チェーンも構築したとOpenAIは説明しています。一方で、モデルの拒否・アラインメント性能もGPT-5.6 Solから大幅に強化されました。
OpenAIはAstraを「soon」としており、具体的な一般公開日はまだ公表していません。高度なサイバー能力は最初から全面開放せず、少数テスターとDaybreak Blueを通じて段階的に提供します。したがって「Astraが数日後に出る」というリークを公式日程へ格上げすることは、まだできません。 しかし大局ははっきりしました。 2023年の競争は会話でした。2024年はマルチモーダル、2025年は推論、2026年はエージェントです。そして次の競争は、AIが何時間、何日働けるかだけではなく、その長時間労働をいくらで提供し、どこまで安全に制御できるかへ移っています。 Fable 5.1は「最上位AIを実際に使える経済性」へ踏み込みました。Astraは「Critical級AIを実際に配備できる制御性」へ踏み込んでいます。 AIは、答えるものから、考えるものへ。考えるものから、道具を使うものへ。そして道具を使うものから、長時間働くものへ。 9月1日の二つの公式発表によって、この変化はもはや予測だけではなく、製品と安全基準の両面で具体化し始めました。
第22章 主要リンク・参考資料
Anthropic:Claude Fable 5.1 and Claude Mythos 5.1
https://www.anthropic.com/claude-fable-and-mythos-5-1 Anthropic:Claude Fable 5.1 Platform Docs
https://platform.claude.com/docs/en/models/fable-5-1/overview Anthropic:Fable 5.1 / Mythos 5.1 System Card
https://www.anthropic.com/claude-fable-5-1-mythos-5-1-system-card Anthropic:Developing Enterprise Frontier Safeguards with our customers
https://www.anthropic.com/news/enterprise-frontier-safeguards Anthropic:Improving Claude Fable 5's biology safeguards
https://www.anthropic.com/news/improving-fable-5-s-biology-safeguards Anthropic:Improving our alignment and security efforts(2026年8月31日)
https://www.anthropic.com/news/improving-alignment-security-efforts Anthropic:Investigating three real-world incidents in our cybersecurity evaluations(2026年7月30日)
https://www.anthropic.com/news/investigating-incidents-cybersecurity-evals Anthropic:Frontier Compliance Framework
https://www.anthropic.com/news/compliance-framework-SB53
Anthropic:Responsible Scaling Policy
https://www.anthropic.com/responsible-scaling-policy Anthropic:Claude text watermark
https://www.anthropic.com/news/claude-text-watermark Anthropic:Model Hardware Standard(research preview)
https://www.anthropic.com/news/model-hardware-standard-research-preview Anthropic:Claude Fable 製品ページ
https://www.anthropic.com/claude/fable Anthropic:Claude Mythos 製品ページ
https://www.anthropic.com/claude/mythos Anthropic:Fable 5.1 / Mythos 5.1 システムカード(PDF)
https://www-cdn.anthropic.com/0339e6a7c5c7b87f5c07798616dc32c215d14235/Claude Fable 5.1 & Claude Mythos 5.1 System Card.pdf Artificial Analysis:Claude Fable 5.1(max with fallback)の測定
https://artificialanalysis.ai/models/claude-fable-5-1 Anthropic:Newsroom
https://www.anthropic.com/news Zenodo:金星の新しい標高地図(Creative Commons)
https://zenodo.org/records/22164484 Gray Swan(外部自動テストの実施元)
https://www.grayswan.ai/
CIO:Companies not as keen on Anthropic's best AI model(FT/Rampデータの解説)
https://www.cio.com/article/4213299/companies-not-as-enthusiastic-about-anthropics-best-ai-model.html eWeek:OpenAI's New Astra Model Made 10 Math Advances(再現報告を含む)
https://www.eweek.com/news/openai-astra-ai-math-results/ VentureBeat:Anthropic's Claude Fable 5.1 and Mythos 5.1 arrive with a 75% cost reduction for Fable cache reads(2026年9月1日)
https://venturebeat.com/technology/anthropics-claude-fable-5-1-and-mythos-5-1-arrive-with-a-75-cost-reduction-for-fable-cache-reads The Decoder:Anthropic's Claude Fable 5.1 promises better coding and research at up to 45 percent less(2026年9月1日)
https://the-decoder.com/anthropics-claude-fable-5-1-promises-better-coding-and-research-at-up-to-45-percent-less/ 9to5Mac:Anthropic upgrades Claude with new Fable 5.1 model(2026年9月1日)
https://9to5mac.com/2026/09/01/anthropic-upgrades-claude-with-new-fable-5-1-model-details-here/
MacRumors:Anthropic Launches Claude Fable 5.1 With Lower Costs and Fewer False Positives(2026年9月1日)
https://www.macrumors.com/2026/09/01/anthropic-claude-fable-5-1/ OpenAI:Path to Astra: critical capabilities and frontier safeguards
https://openai.com/index/path-to-astra/ OpenAI:Responding to the next frontier of critical cyber capabilities
https://openai.com/index/responding-next-frontier-critical-cyber-capabilities/ OpenAI:Pacing model development in an era of cyber-critical capabilities
https://openai.com/index/pacing-model-development-cyber-capabilities/ OpenAI:The Hugging Face incident and the road ahead(2026年8月26日)
https://openai.com/index/hugging-face-incident-and-the-road-ahead/ OpenAI:Offering Zero Data Retention for frontier models(2026年8月19日)
https://openai.com/index/offering-zero-data-retention-for-frontier-models/ OpenAI:Updating our Preparedness Framework
https://openai.com/index/updating-our-preparedness-framework/
OpenAI:Ten advances in mathematics and theoretical computer science
https://openai.com/index/ten-advances-in-mathematics/ Reuters:OpenAI says upcoming model is so capable it requires stronger guardrails(2026年9月1日)
https://www.reuters.com/business/openai-says-upcoming-model-is-so-capable-it-requires-stronger-guardrails-2026-09-01/ Axios:Anthropic releases new models, cost structures and safeguards(2026年9月1日)
https://www.axios.com/2026/09/01/anthropic-releases-new-models-cost-structures-and-safeguards The Verge:Anthropic launches Claude Fable 5.1 and says it's up to 45 percent cheaper for agentic work(2026年9月1日)
https://www.theverge.com/ai-artificial-intelligence/987830/anthropic-claude-fable-mythos-5-1
ハッシュタグ
#AI #生成AI #Claude #ClaudeFable51 #Fable51 #ClaudeMythos51 #Anthropic #OpenAI #Astra #ChatGPT #ClaudeCode #Codex #AIAgent #AIエージェント #AI社員 #AGI #人工知能 #LLM #コーディングAI #サイバーセキュリティ #科学研究 #自律型AI #長時間エージェント #2026年AI

