Claude Opus 5.5 vs GPT-6 Sol:同日リリースの2モデルを比べる

2026年9月22日、AnthropicがClaude Opus 5.5を、OpenAIがGPT-6 Sol(と軽量版のLuna)を発表しました。発表がほぼ同時だったため、Xには「どっちをメインにするか」「価格戦争が始まった」という比較投稿があふれています。
この記事では、両社の公式発表、第三者のベンチマーク、X上の初日〜翌日の反応を整理します。結論から書くと、今の空気は「成果物の質とテイストならOpus 5.5、速度とコスパならGPT-6 Sol」です。ただし、リリースからまだ1日ほどしか経っていないので、その分は割り引いて読んでください。
3行でまとめると
Opus 5.5は「Fable 5.1級の性能をOpus 5より約40%安く」。独立系の総合指標で首位に立ち、Xでは「Claudeが戻ってきた」と盛り上がっています。
GPT-6 Solは「GPT-5.6 Solより誤りが約半分、API価格も半額」。価格破壊としては成功ですが、モデルとしては「2番手」と見る人が多いです。
使い分ける人が増えています。深い実装・デザイン・長時間エージェントはOpus、量をこなす実装やレビューはSolという分担です。
両モデルの立ち位置
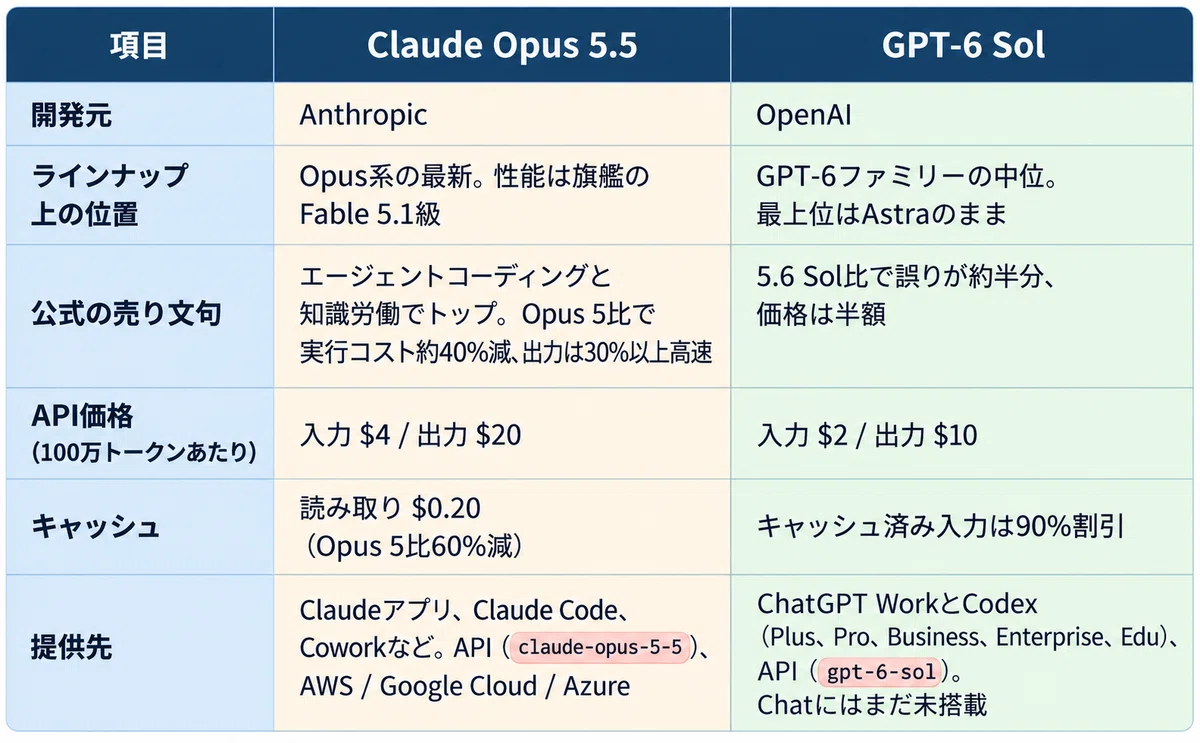
面白いのは、両社とも「安さ」を前面に出しているのに、何と比べて安いのかが違う点です。
Opus 5.5は「旗艦モデル(Fable 5.1)級を旗艦モデルより安く」。FrontierCodeでは、標準の推論設定でGPT-6 Astraを上回り、タスク単価はAstraの約20%だとしています。
GPT-6 Solは「前世代のClaude並みをはるかに安く」。比べている相手はOpus 5.5ではなく前世代のOpus 5とFable 5です。
OSWorld 2.0(オフライン):Opus 5とほぼ同スコア(60.5% vs 60.3%)を約80%低いコストで出した。
DeepSWE:Fable 5に迫るスコア(68.8% vs 69.9%)を約80%低いコストで出した。
また、OpenAIは「GPT-6 Astraは引き続き全方位で当社最高のモデル」と明言しています。SolはAstraの後継ではなく、フロンティア級の性能を日常業務の価格帯で使えるようにするモデルという位置づけです。
公式ベンチマークに「直接対決」はない
ここは注意が必要です。Anthropicの表にGPT-6 Solは載っておらず、OpenAIの表にもOpus 5.5は載っていません。同日発表なので当然ですが、両社の数字を並べるときは、推論設定などの条件が揃っていない前提で読む必要があります。
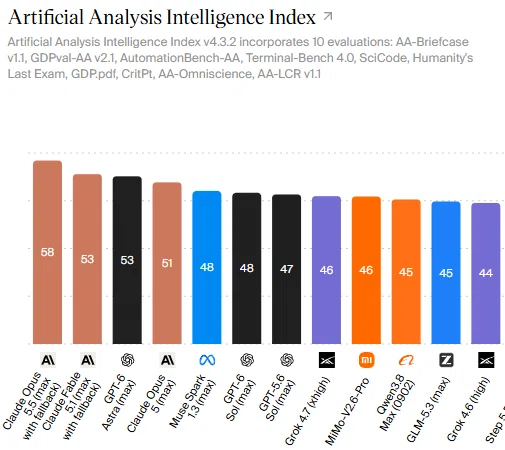
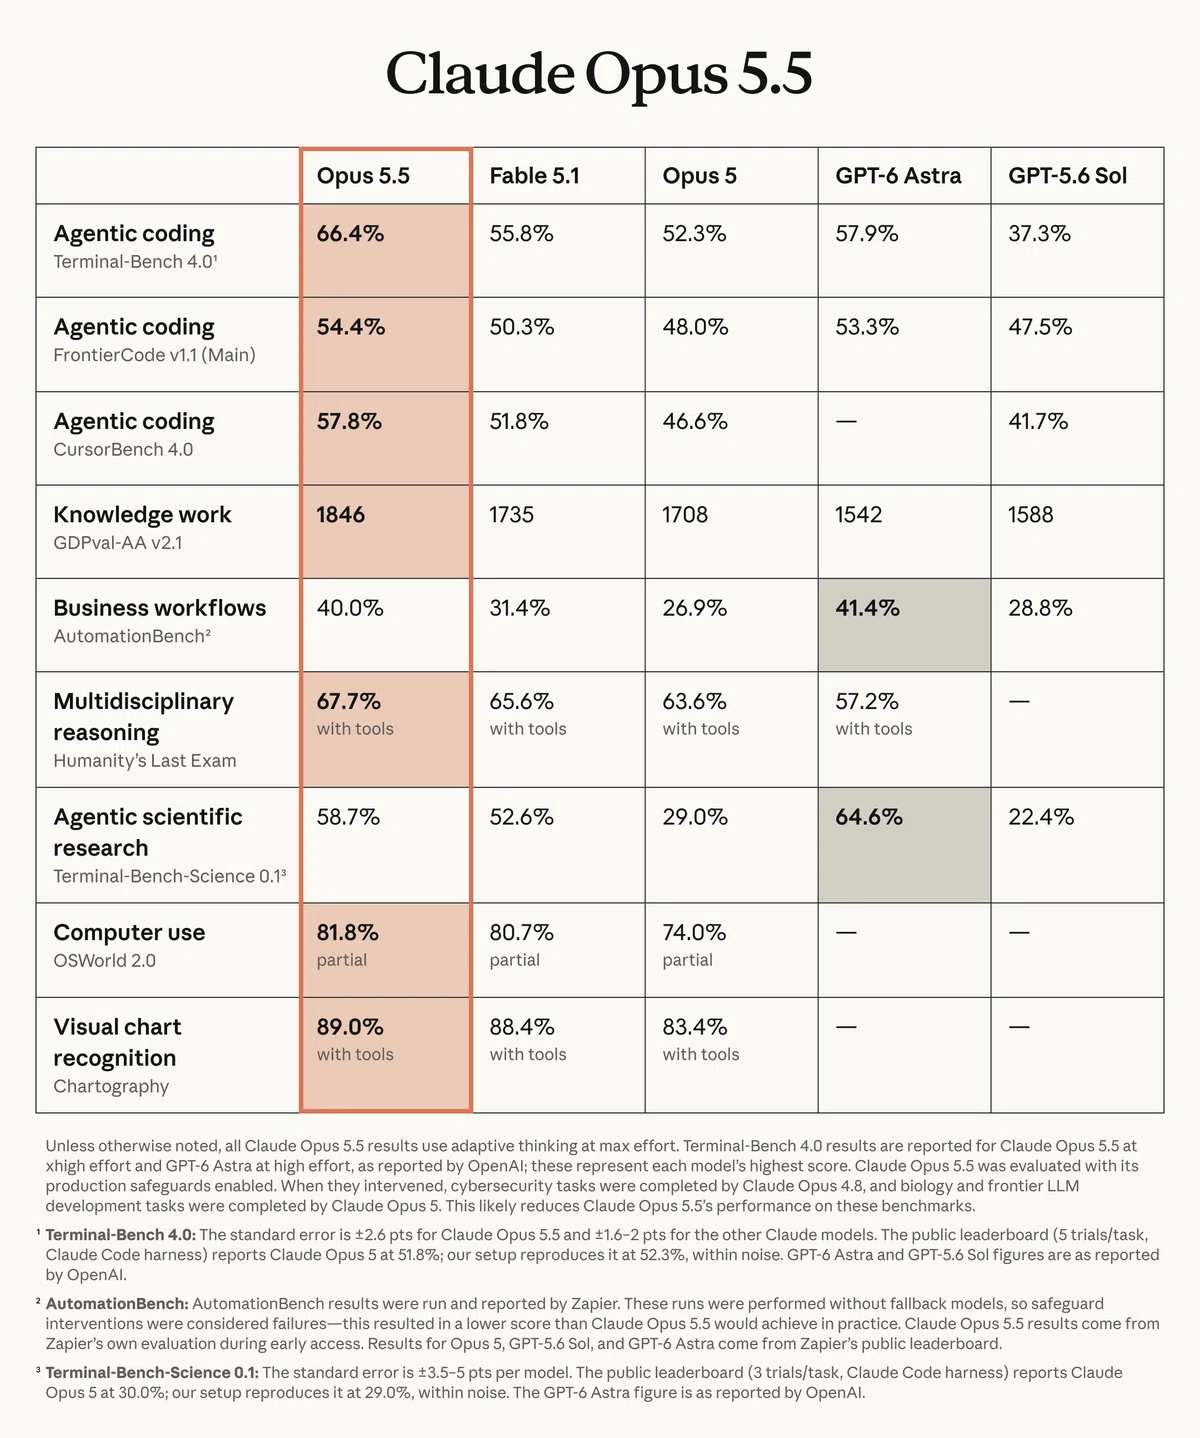
そのうえで、比較の手がかりになる数字を拾うと次のとおりです。
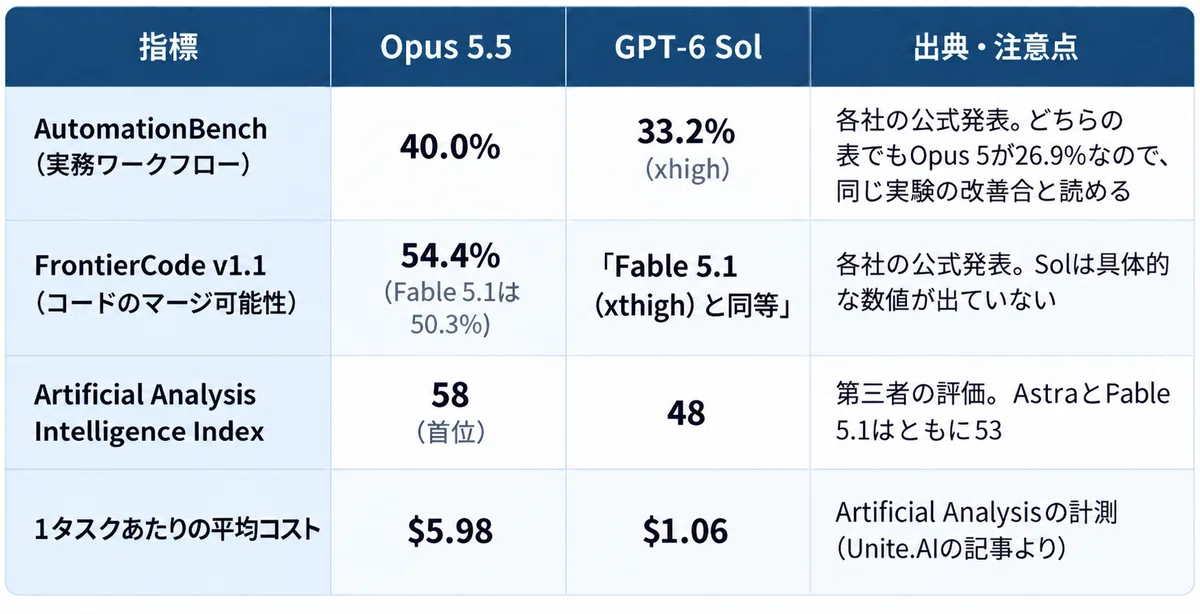
ここから読み取れることは2つです。
知能・エージェント精度はOpus 5.5がはっきり上。 総合指標で10ポイントの差があります。Anthropicの表では、Terminal-Bench 4.0も66.4%で、GPT-6 Astra(57.9%)やGPT-5.6 Sol(37.3%)を上回っています(GPT-6 Solの数値は載っていません)。
ただし1タスクあたりのコストは約5.6倍。 API単価は2倍なのに実際のコストが5倍を超えるのは、Opus 5.5が長く考えるからです。Artificial Analysisによると、Opus 5.5がインデックスの1タスクで出力するトークンは約11.9万で、Opus 5(約7.3万)やGPT-6 Astra(約2.7万)よりかなり多くなっています。Xでよく見る「Claudeは長く考える。GPTは成果物を出す」という言い方は、数字でも裏付けられています。
Claude Opus 5.5:Xの評価はかなり熱い
初日の反応は好意的なものが多く、「Anthropicが戻ってきた」「Fableが本来こうあるべきだった感じ」という声が目立ちます。
文章から「スロップ」が抜けた。早期テスターからは「Opus 4.6以来、一番ストレートで普通の書き方」という評価が出ています。言い方が尖りすぎず、フィードバックを素直に受け入れるようになったという指摘も多いです。公式発表でも「重要な情報を先に書く」「冗長さが40%減った」というテスターの声が紹介されています。
コーディングとテイスト。同じプロンプトでSVG、3D、アニメーション、ゲームUIを作らせると、デザインと完成度でSolを大きく上回るという比較動画や画像が拡散しています。「GPT-6 Solが子供のおもちゃに見える」「同じプロンプトなのに差が一目で分かる」といった言い方が繰り返されています。
実務ワークフローでも勝っている。複雑な実務用のスキルを両方で動かしたユーザーは、「Opus 5.5の方が半分の時間でうまくこなし、次に速くするための改善案まで出してきた」と書いています。公式発表にも、68万行のコード移行を1日かからずに終えた例や、Webアプリ全ページの読み込み短縮を40回中39回成功させた例が載っています。
サブスクに戻る人も。「公開でClaudeに謝る。Opus 5.5を試してサブスクを更新した」という投稿もあります。$200プラン同士の比較では、Opusは1タスクあたりの時間が最短(約1.2分)で、medium設定でも十分強く、5xプランでも枠を使い切れないという声もあります。そこから「今はClaude 20xの方がCodex 20xより無難」と結論づける人もいます。
注意点として挙がっていること:
自分から止まらない。時間の上限と「完了条件」をはっきり指定しないと、プランの枠をどんどん消費します。
「数日後に性能が落ちる」ことへの警戒。特に日本語圏では、「リリース直後だけ強い」という経験則を気にする声があります。
セーフティは厳しめ。公式発表によると、生物分野にはFable 5.1と同じセーフガードが使われ、サイバーセキュリティ関連の多くのタスクはOpus 4.8に回されます(認証を受けた防御側向けのプログラムは別にあります)。用途によっては断られる場面が増えるかもしれません。
GPT-6 Sol:「安い上位モデル」として評価が割れる
公式は「5.6より賢く、誤りは約半分、価格も半額」と主張しています。ユーザーの評価はもう少し冷静です。
評価されている点:
コスパが圧倒的。「xhighはamazing value」「$20のChatGPTサブスクがコーディングに本当に使えるようになった」という実務寄りの声があります。
速度とトークン効率。マンデルブロ集合のWebGLデモでは、Solの方が安く($0.07 vs $0.35)、トークンも少なく、ズームしたときの品質も上だったという検証があります。
5.6 Solからの順当な進化。日本語のts-benchでは、Sol(medium)のツールの使い方がうまくなっていて、前世代からの改善は認められています。
Astraの代わりではなく、量をさばく層。CTO層からは「Astraの無料版ではない。処理の経路ごとにモデルIDを固定し、成功タスクあたりの単価とツール失敗率を見て採用を決めろ」という実務的な意見が出ています。
厳しい声:
Astraより良くはない。「安いが、公開されたどのチャートでもAstraを超えていない。自分の基準では乗り換えない」。
中程度の難しさで取りこぼす。スペイン語圏のユーザーからは「ぼんやりしていて、中程度のケース分析でミスをする。5.6 Solならほぼ一発だった」という報告があります。
デザイン・テイストの対決では負け。自転車に乗るペリカン、PS5コントローラーのSVG、火山島、義手の3Dサイトなど、「同じプロンプト対決」ではOpusが勝つ投稿が目立ちます。
Lunaに足を引っ張られている。同時に発表されたLunaには「5.6 Lunaより劣化した」「安すぎるがエージェント向きではない」という日本語のベンチ投稿があり、Sol本体の印象まで下げています。
少数ですが、「6 Solは5.6より弱い」と切り捨てる声もあります。
観点別:どちらが優勢か
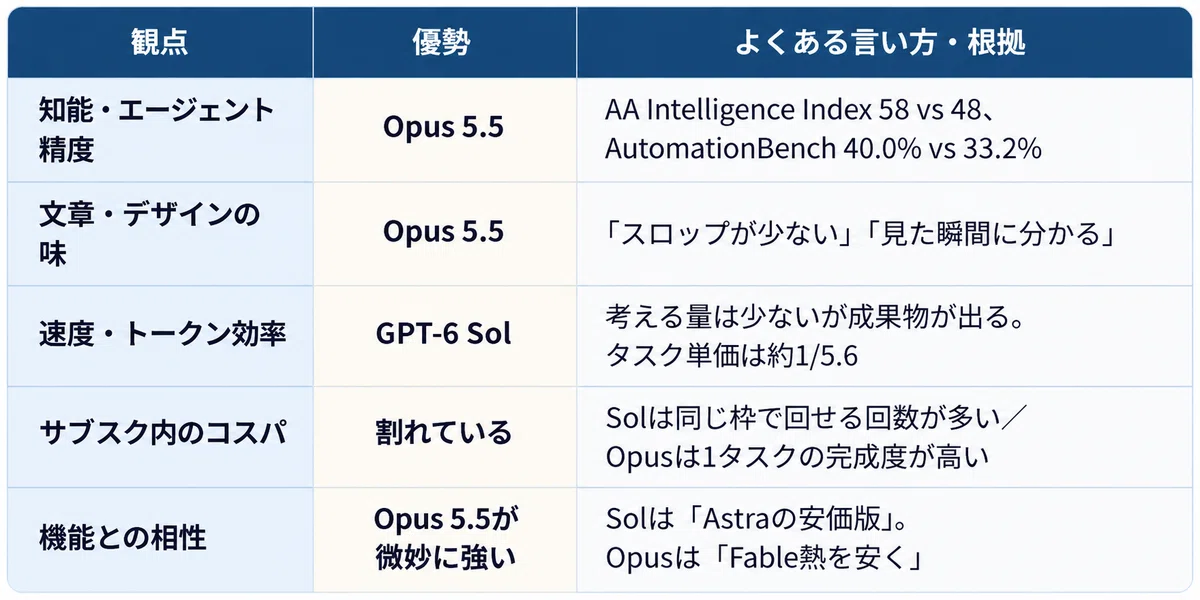
速度の評価は少しややこしく、「Opusは1タスクあたり最速」「半分の時間で終わった」という声と、「Claudeは長く考える」という声が両方あります。トークン消費はOpusの方が明らかに多い一方で、やり直しが少なければ実際にかかる時間は短くなります。タスクの難しさによって結論が変わる部分です。
日本語圏の温度感
日本語のXでも、構図はおおむね同じです。
「今日は同時リリースでお祭り。Opusがかなり万能。今後はClaude Code中心で、最後だけCodexでレビューすれば足りそう」
「Claudeは実用的なアップデート。GPT系はコストが下がって自社プロダクトに組み込みやすくなった」
「6 Solのおかげでこの性能が安く使える。あとはChatにも載せてほしい」
一方で、「Solにネガティブな評価がちらほら。5.6より低いなら話が変わる。OpusがAstraより上なら、コスト面でも不利になり得る」と、Solの立ち位置そのものを疑う声もあります。
現時点での使い分け
初日の評価と公式・第三者の数字を合わせると、次のような分担が妥当そうです。
Opus 5.5が向いている仕事
大規模なコード移行や何時間も動かし続ける長時間エージェント
UI・デザイン・文章など成果物の質やテイストが問われるもの
あいまいで手順が多く、失敗したときのやり直しコストが高いもの
GPT-6 Solが向いている仕事
範囲が決まっているコード変更、レビュー、定型的なデータ変換
大量に回すバッチ処理や自社プロダクトへの組み込み
$20プランやAPI予算などコストの上限がはっきりしている場面
両方を組み合わせる手もあります。Opusを司令塔(計画と判断)、Solを実働部隊(作業の量産)にする構成を試す投稿もすでに出ています。
運用のコツもそれぞれあります。Opus 5.5は、時間の上限と完了条件を指定しておかないと枠を消費しすぎます。Solに切り替えるときは、処理の経路ごとにモデルIDを固定し、「成功したタスクあたりの単価」と「ツール呼び出しの失敗率」で採用を判断するのが安全です。API単価だけで比べると、どちらのモデルも見誤ります。
まとめ:初日の評価は、あくまで初日の評価
初日の盛り上がりはOpus 5.5に集中。文章の改善、テイスト、コーディングの完成度、そして「Claudeが戻ってきた」という感情がセットになっています。
Solは価格破壊としては成功、モデルとしては「2番手」。5.6からの改善と半額は評価されていますが、Astra超えでもOpus超えでもないという見方が多数派です。
用途で使い分ける人が増えている。深い実装・デザイン・長時間エージェントはOpus、量をこなす実装・レビュー・コスト重視の場面はSol(Lunaは慎重に)。
リリースからまだ半日〜1日です。数日後に「最初は良かったが落ちた」「特定の分野では逆転した」という声が出てくる可能性は十分あります。最終的には、自分のタスクで両方を動かし、一発で通った割合とやり直しまで含めたコストで判断するのが確実です。
参考
Introducing GPT-6 Sol and Luna | OpenAI
※この記事は、Claude Opus 5.5で作成しました。
いいなと思ったら応援しよう!
この記事は noteマネー にピックアップされました