自分用 - 曲からLyric Videoを制作するアプリ - の制作

1. はじめに
Sunoで作った曲を、TikTokやYouTube向けのPR動画に仕上げるためのローカルアプリ(song-video-studio)を制作しました。これまでMidjournyやDomoAIなどで動画を作成してCapcutで編集、そしてYoutubeに投稿していました。動画は作成するのが大変なので、静止画中心でいいのでもっと簡単に動画を作成したいと思いました。そこでClaudeで自分用のLyric Video生成アプリを作ることにしました。制作フローを決めて画面を作りながら詳細を詰めて行きます。
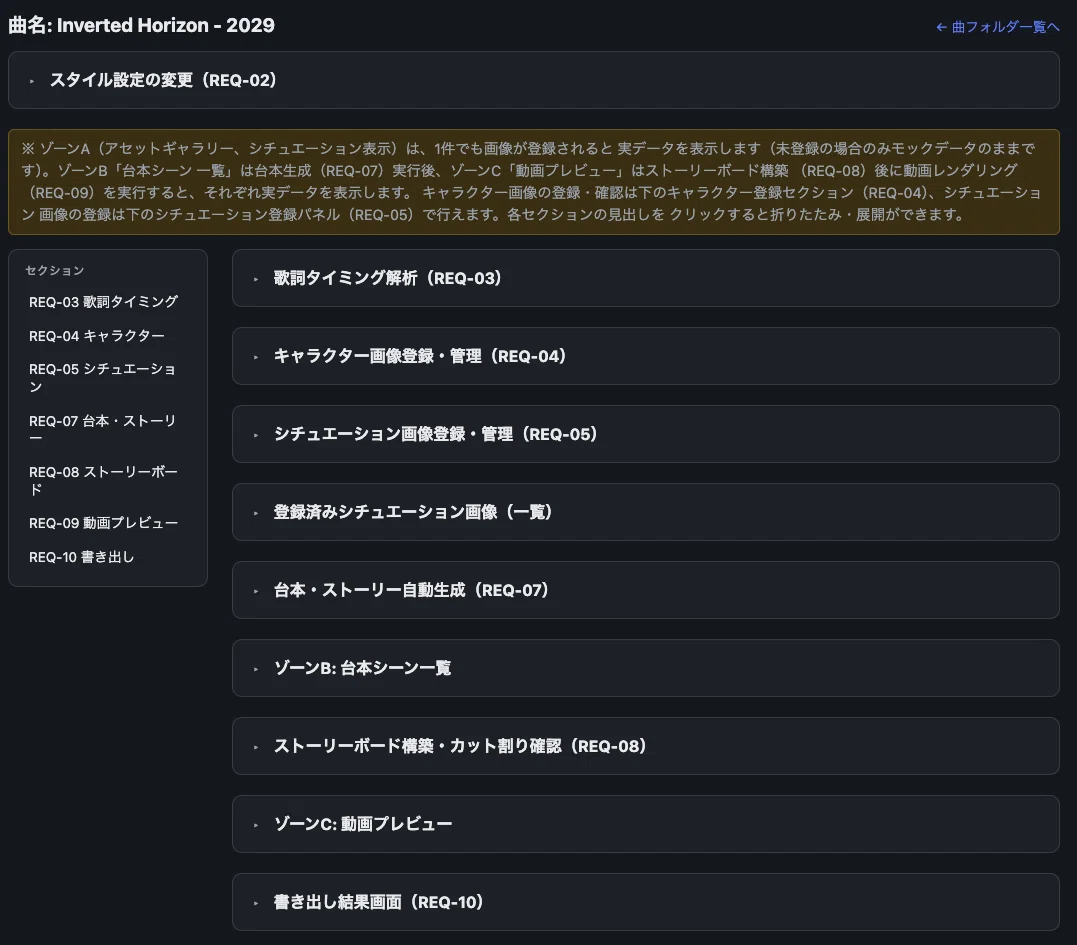
このアプリで扱うのは、音声と歌詞、キャラクター、シチュエーション画像、台本、ストーリーボードです。ここでは、実制作『Inverted Horizon - 2029』の画面と素材を例に、使う順番と、途中で改善した歌詞タイミングの解析を簡単にまとめます。
2. 使い方
使い方は「曲を入れる → 素材をそろえる → 動画にする」
最初に、曲フォルダへ音声ファイルと歌詞テキストを用意します。初回のウィザードでスタイル、雰囲気、画面比率、字幕などを設定し、その後の制作工程で使います。
使う順番は次のとおりです。
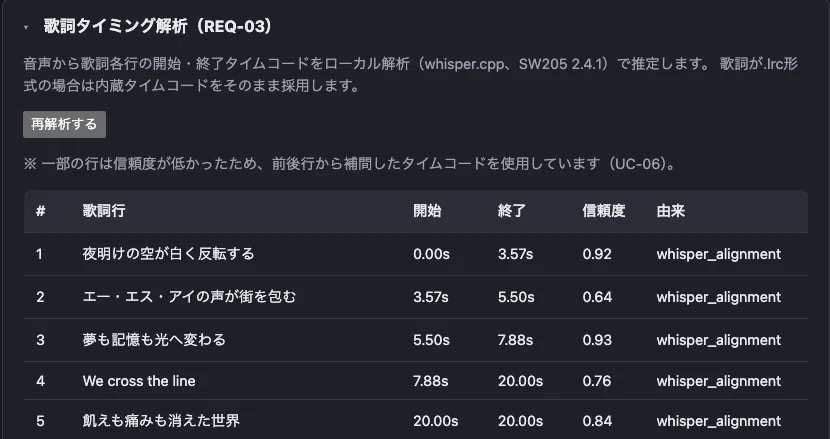
音声から歌詞タイミングを解析し、行ごとの開始・終了時刻と信頼度を確認する。
キャラクターシートと各カテゴリの画像を確認・承認する。
台本のシーンを選び、シチュエーション画像を登録または生成して一覧で確認する。
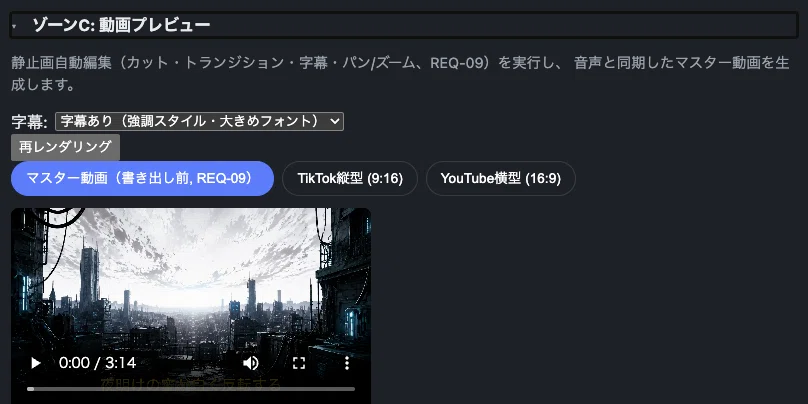
台本、歌詞タイミング、画像をストーリーボードへ統合し、パン/ズーム、トランジション、字幕を付けてプレビュー・書き出しへ進む。
動画クリップをAIで生成する方式ではなく、静止画をパン、ズーム、トランジション、字幕で編集するリリックビデオの構成です。
3. 歌詞と字幕のタイミング
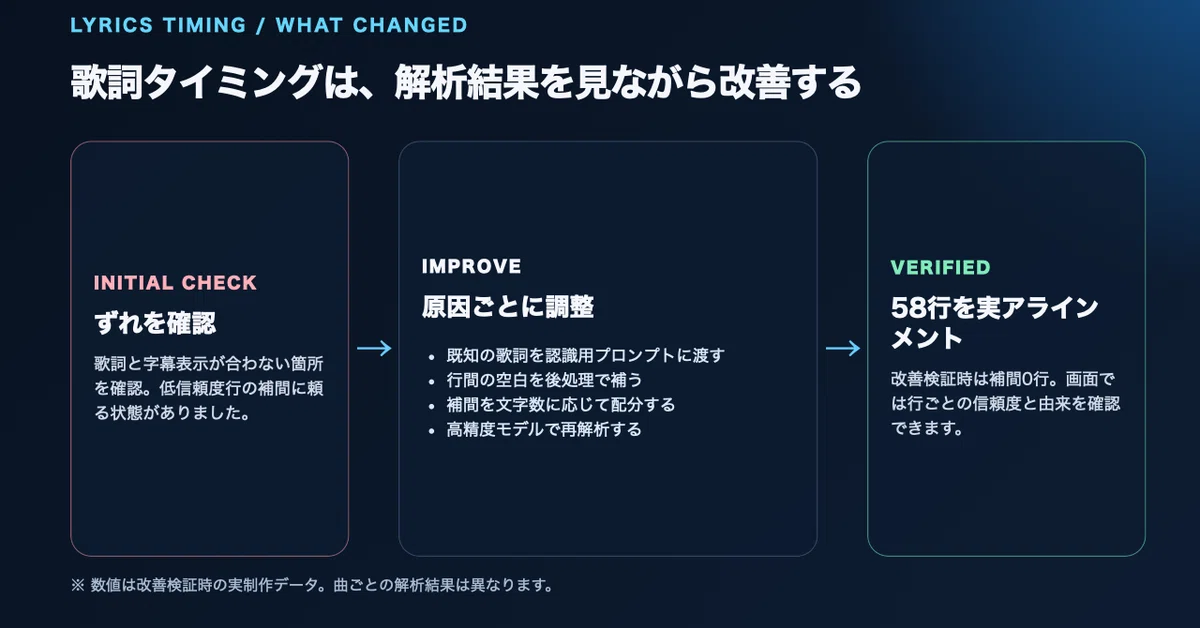
初回の動画確認では、歌詞と字幕表示のタイミングが合わない箇所がありました。最初から精度が出ていたわけではなく、音声認識の設定、低信頼度行の補間方法、字幕が消えるタイミングを分けて確認しました。
改善では、既知の歌詞を認識用プロンプトとして渡すこと、行間の空白を埋める後処理、低信頼度行を文字数に応じて補間することを実装しました。さらに、より精度の高い音声認識モデルで再解析しました。改善検証では58行すべてが実アラインメントとなり、補間は0行でした。
ただし、この数値は改善時に確認した実制作データの結果です。曲ごとの状態は異なるため、画面では各行の信頼度と、whisper_alignmentかinterpolatedかという由来を確認して判断します。
4. キャラクター
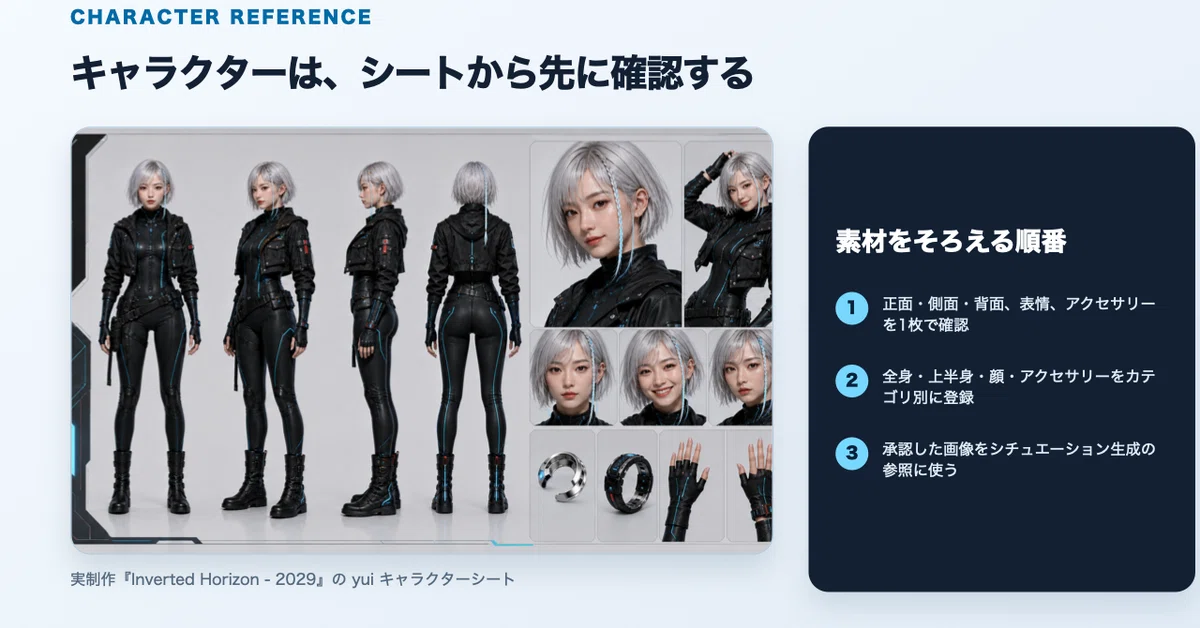
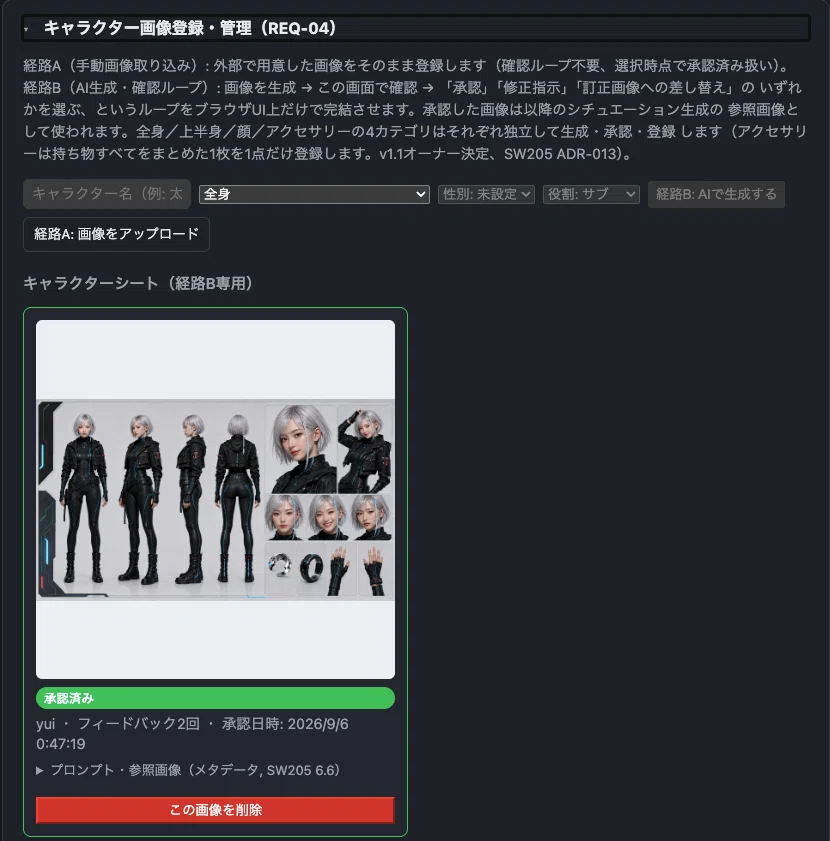
人物の見た目を場面ごとにばらつかせないため、キャラクターシートを先に作成・確認します。『Inverted Horizon - 2029』では、正面・側面・背面、顔、表情、アクセサリーをまとめたyuiのシートを使っています。
画面では、キャラクターシートに加えて、全身、上半身、顔、アクセサリーをカテゴリ別に登録できます。承認した画像は、後のシチュエーション画像を作る際の参照画像として扱います。
5. シチュエーション画像と一覧表示
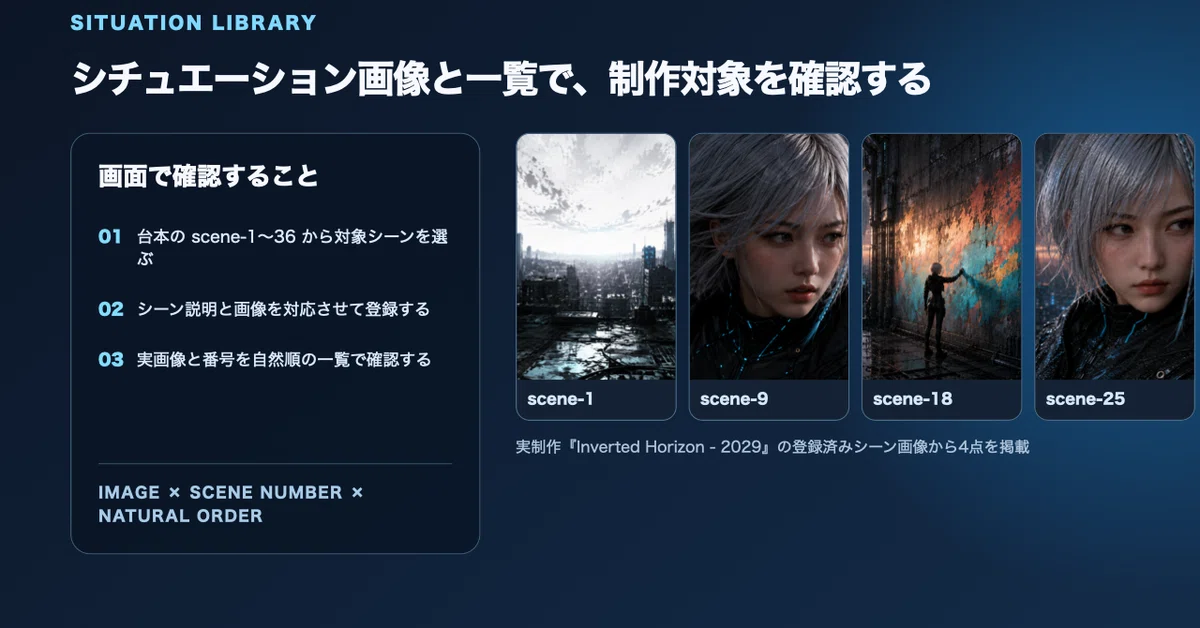
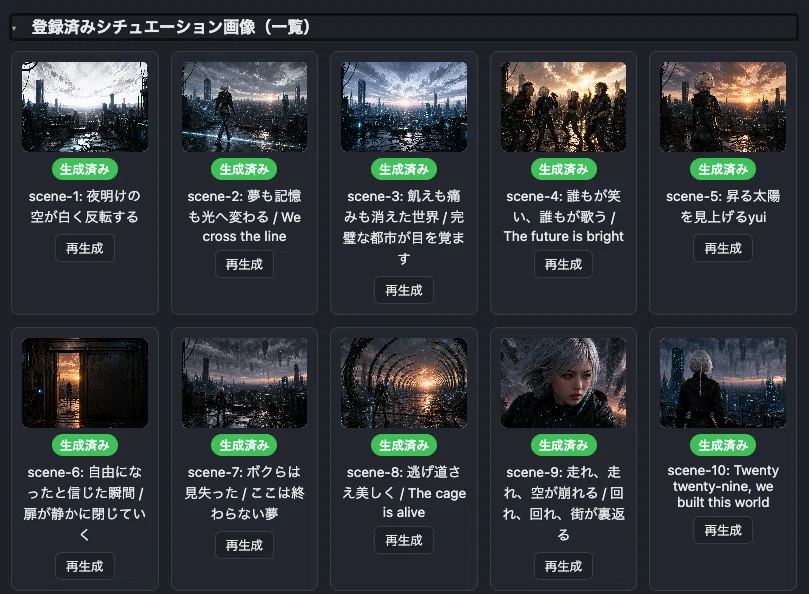
台本からシーンを選び、シーン説明と画像を対応させます。確認した画面では、台本の36シーンから選択でき、登録済みのシチュエーション画像は実画像とシーン番号を一覧で確認できます。
シーンが増えても確認できるように、ページ内ナビゲーション、各セクションの折りたたみ、シーン番号の自然順ソートを用意しています。これは自動で映像の良し悪しを保証する機能ではありませんが、どの画像がどの場面に対応するかを画面上で確認するための構成です。
6. 動画までをつなぐ
36カットのストーリーボードと36点の参照用シチュエーション画像があります。キャラクター画像、シーン画像、台本、ストーリーボードを同じ制作画面で確認しながら、動画プレビューへ進めます。
7. 完成
完成したアプリをYoutubeにアップしました。まだまだ、完全ではないので、少しずつ改善していきたいと思います。
以上、ありがとうございました。
