OpenAI Daybreakは何を変えるのか?脆弱性を見つけるAIから直し切る開発へ

95%と2%。2026年8月10日にOpenAIがDaybreakを発表したとき、かなり目を引く差が示されました。高度なサイバー要求にどの程度拒否せず応答するかを見るOpenAIの内部評価で、GPT-5.6 Cyberは95.0%、Daybreak Blueで使われるGPT-5.6 Solは2.0%でした。
We’re expanding our cybersecurity initiative Daybreak and introducing GPT-5.6-Cyber, a new model for advanced, authorized cybersecurity work.
— OpenAI (@OpenAI) August 10, 2026
As the threat landscape evolves, we’re putting frontier intelligence in the hands of trusted defenders before attackers can deploy… pic.twitter.com/6o3GtxCxRA
この数字だけを見ると、「Redの方が圧倒的に強い。ならRedを使える組織が有利だ」と考えたくなります。けれど、OpenAIは多くの防御チームにBlueから始めることを勧めています。
なぜでしょうか。
私がDaybreakで重要だと考えているのは、最強のサイバーモデルが出たことではありません。AIに何ができるかと、AIに何をさせてよいかを分けながら、脆弱性の発見、検証、修正、テスト、人間確認までを一つの開発工程として閉じようとしていることです。
ここを押さえると、BlueとRedの見え方も、Codex Securityの役割も、自社で最初に試すべきことも変わります。
95%と2%を性能ランキングとして読むとDaybreakを見誤る
最初に、95%対2%という数字の意味を分けて考えます。
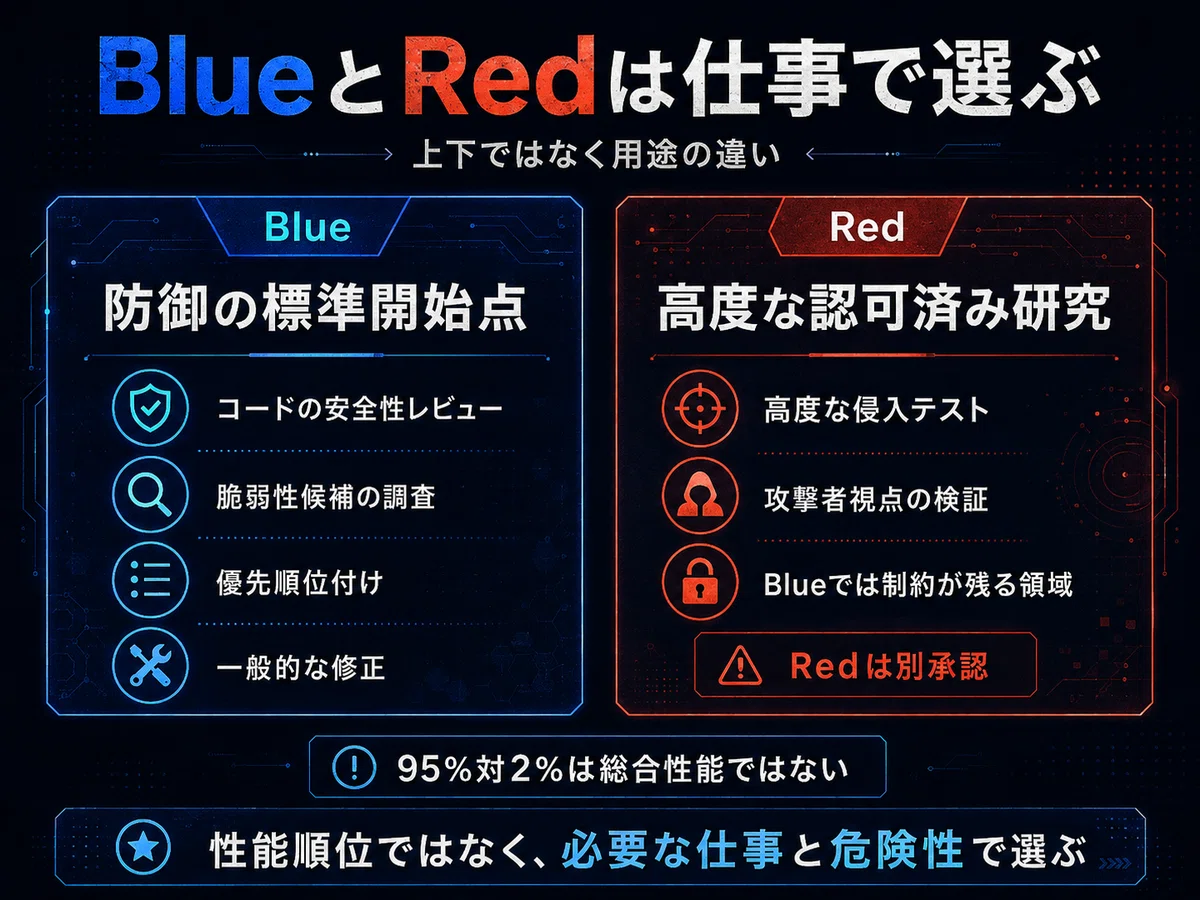
この評価は、一般的なコードレビューの総合点ではありません。攻撃手順の連鎖、認証回避、権限昇格など、防御にも攻撃にも転用できる高度な要求に、モデルがどの程度拒否せず応答するかを見るものです。したがってRedが高度な作業への応答制約を大きく減らしていることは重要ですが、「あらゆるセキュリティ業務でBlueよりRedが優れている」という意味にはなりません。
Daybreak BlueはGPT-5.6 Solを基盤にした防御側の標準アクセスです。コードの安全性レビュー、脆弱性候補の調査、優先順位付け、一般的な修正といった仕事を想定し、OpenAIは多くの防御チームの開始点として位置づけています。
一方のDaybreak RedはGPT-5.6 Cyberを使う別承認のアクセスです。制御された環境で攻撃が成立するかを確かめる作業や、高度な侵入テスト、攻撃者役の視点で防御を検証する仕事など、Blueでは意図的に制約が残る領域を扱います。
つまりBlueとRedは、無料版と上位版のような関係ではありません。どちらを選ぶかは性能順位ではなく、実際に必要な仕事と、その仕事が持つ危険性で決まります。
一般的なプロダクト開発で脆弱性を見つけ、直し、再確認したいなら、まずBlueや既存のCodex Securityで十分かを見る。高度な認可済み研究が必要で、Blueの制約が実務上の障害になったときにRedを検討する。この順番の方が自然です。
Redが必要な組織では、モデルアクセス自体が大きな価値になります。そこは小さく見るべきではありません。ただし、それは「すべての会社が最初からRedを目指すべき」という話とは別です。
Daybreakは一つの製品ではなく三つの層でできている
BlueとRedの違いを理解したら、次にDaybreak全体を三つへ分けると整理しやすくなります。
一つ目は、誰にどの能力を許すかを管理する審査とガバナンスです。Daybreakの土台にあるTrusted Access for Cyberがこの役割を担います。
二つ目は、モデルへのアクセスです。BlueではGPT-5.6 Sol、RedではGPT-5.6 Cyberを使います。ここが「AIに何ができるか」に近い層です。
三つ目は、実際のセキュリティ作業を進めるワークフローです。Codex Securityはリポジトリを読み、脅威を整理し、問題候補を調べ、証拠を集め、修正し、再確認する仕事の流れを担います。モデルそのものではありません。
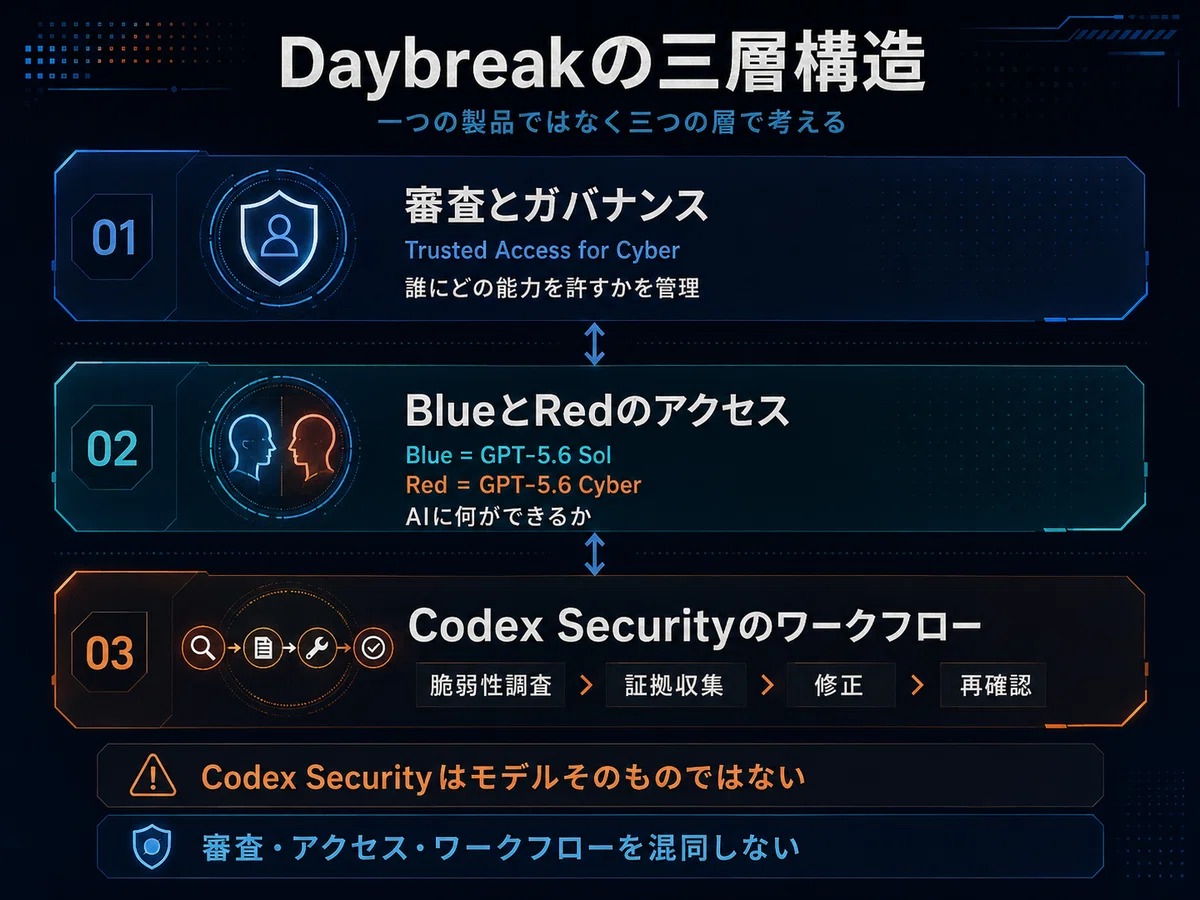
この三層を混ぜると、「Daybreakの承認を得れば安全な開発環境まで完成する」「Codex Securityを入れればBlueやRedを使っている」といった誤解が起きます。
実際には別々です。アクセス承認を得ても、どのリポジトリを読ませるか、どのコマンドを実行させるか、秘密情報へ触れさせるか、誰が修正を承認するかは、別に設計しなければいけません。
逆に言えば、Daybreakの承認を待たなければセキュリティ設計そのものを何も始められないわけでもありません。Codex Securityへのアクセスがある組織なら、その範囲でスキャンや検証を試せますし、通常のセキュリティ対策を使って修正までの工程や権限境界を先に整えることもできます。
セキュリティAIの価値は何件見つけたかより直し切れるかで決まる
ここが、Daybreakを単なるモデル発表として見ない方がよい最大の理由です。
セキュリティの自動検査では、問題候補を見つけることと、その問題を安全に解消することの間に大きな距離があります。
たとえば検査ツールが100件の警告を出しても、そのすべてが同じ重要度とは限りません。本当に外部から到達できるのか。実際の処理経路で悪用できるのか。修正すると別の機能を壊さないか。どのテストを通せば「直った」と言えるのか。ここを詰めなければ、警告は増えても安全性は上がりません。
Codex Securityが広げようとしているのは、この警告の先です。どこが攻撃対象になり得るかを整理し、問題候補を見つけ、本当に影響するかを調べ、証拠を残し、修正案を作り、テストし、もう一度確認する。
難しい言葉を外すと、「怪しい場所を教えるAI」から「本当に問題かを確かめ、直した結果まで確認するAI」へ仕事の範囲が広がっているということです。
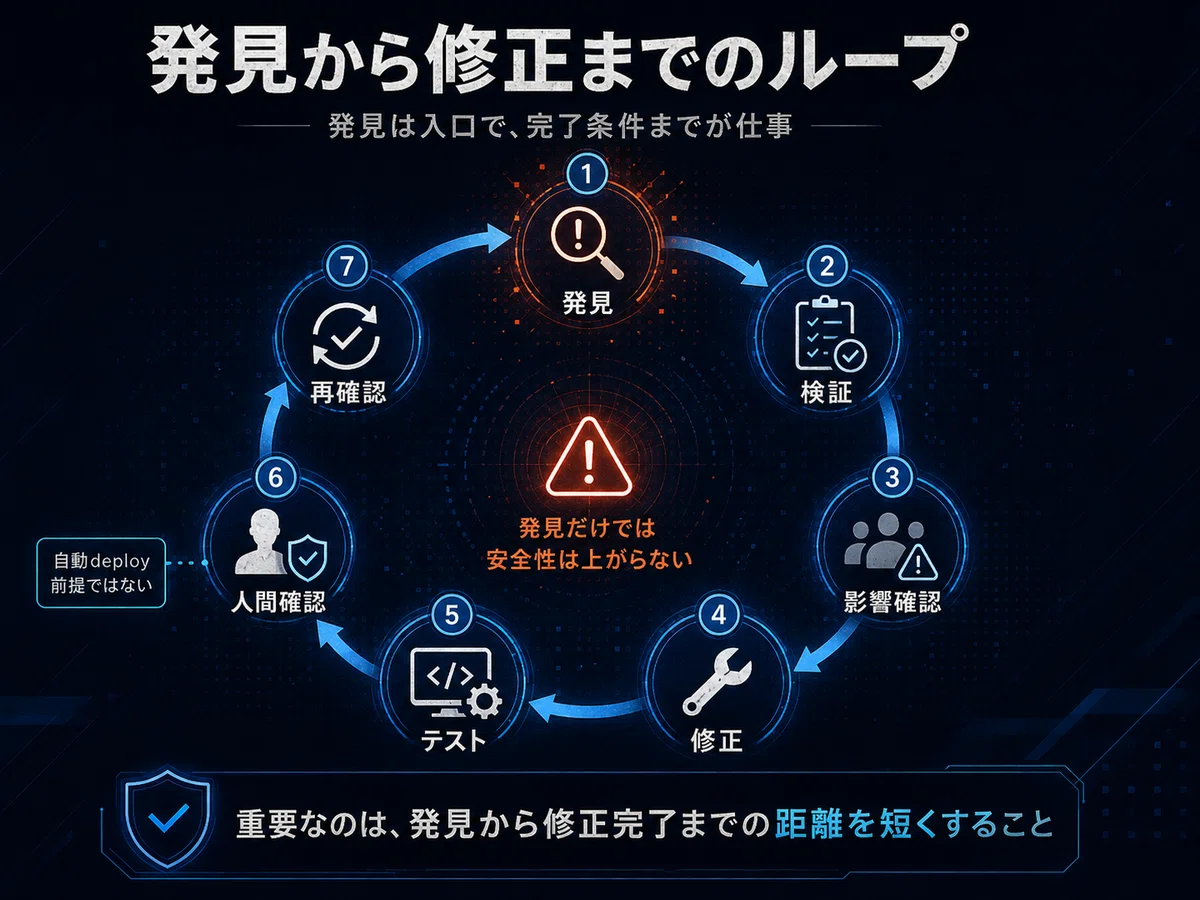
そうなると、評価指標も変わります。何件見つけたかだけでなく、問題を再現できる証拠があるか、優先順位は妥当か、修正後のテストが通るか、別の不具合を生んでいないか、人間が採否を判断できる材料がそろっているかを見る必要があります。
Codex Securityが専用画面やCLIを持ち、問題候補を継続的な作業として扱う理由は、こちらの記事で詳しく整理しています。
ここまで来ると、AIセキュリティの競争軸は少し変わります。検出能力だけではなく、発見から修正完了までの距離をどれだけ短くできるかが重要になります。
ただし、AIが修正まで進めるほど、次の問題が大きくなります。AIに何を許すかです。
AIの能力が上がるほど権限は狭く設計する
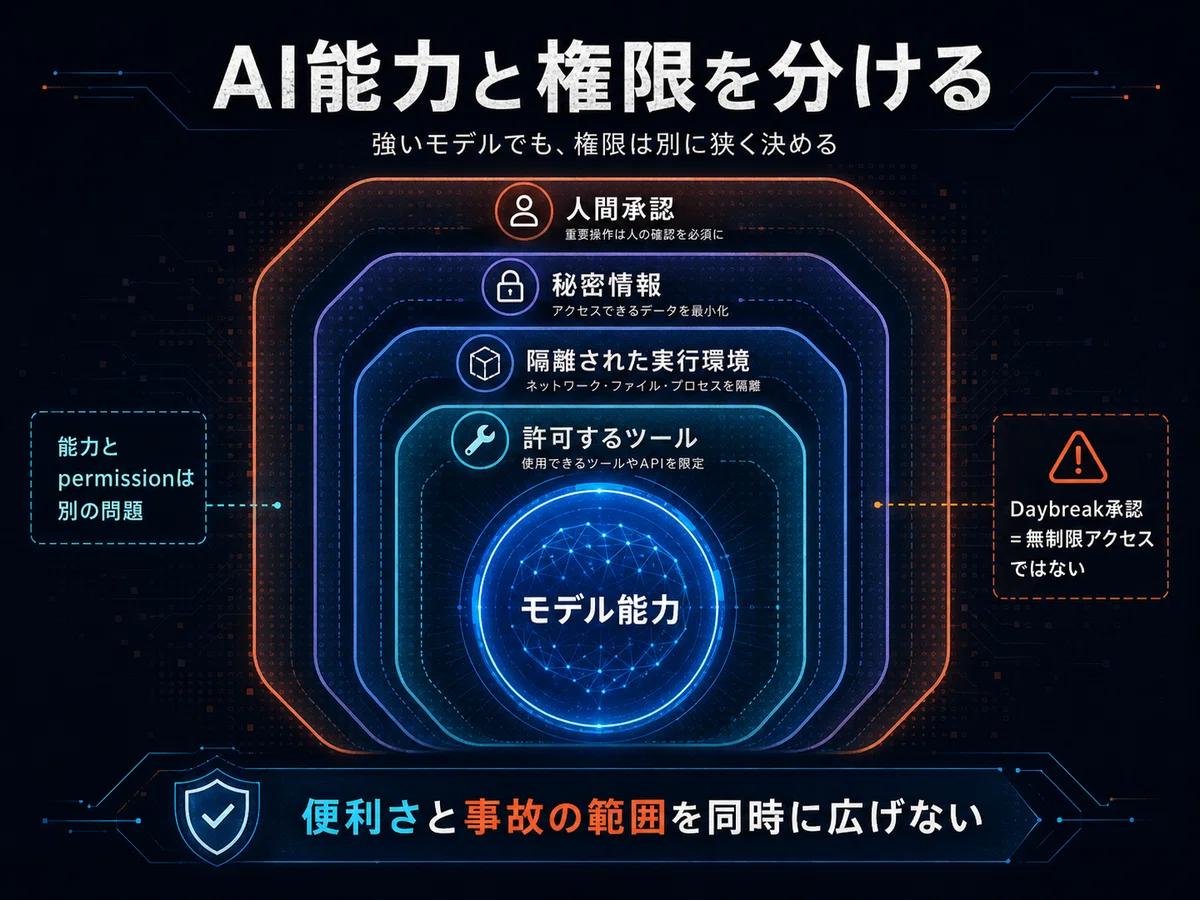
AIがコードを読むだけなら、できる操作は限られています。けれど、問題を再現し、ファイルを書き換え、テストを実行し、外部サービスと接続できるようになるほど、便利さと同時に事故の範囲も広がります。
ここで分けるべきなのが、モデルの能力と実行権限です。
AIが「このファイルを修正すべき」と判断できることと、本番環境へ反映してよいことは同じではありません。脆弱性を再現するためにコマンドを実行できることと、無制限に外部ネットワークへ接続してよいことも別です。秘密情報が必要な作業でも、すべての資格情報を読ませる必要があるとは限りません。
Daybreakの公式設計でも、承認された内部の防御作業、対象範囲の限定、隔離された実行環境、人間レビューといった条件が重視されています。Codexでは、境界を越える操作を別のレビューで確認するauto-reviewも推奨されています。
さらに、Daybreakの承認は、データを保存しないZero Data Retentionの設定や、第三者向けサービスへの利用許可を自動的に与えるものではありません。アクセスできる能力と、組織が守るべきデータ・権限・利用条件は別の問題です。
この境界をコードベース側にも残しておくと、AIへ毎回同じ説明をしなくて済みます。たとえば`SECURITY.md`には、守るべき信頼境界や「絶対に破ってはいけない安全条件」を置けます。`AGENTS.md`には、そのリポジトリで使うビルド、テスト、検証などの作業手順を置けます。
ただし、ファイルを書けば安全になるわけではありません。内容が実際の権限設定、秘密情報の管理、CI/CDの承認、監査、停止と復旧に反映されている必要があります。
AIへリポジトリを渡す前に、GitHub側で会社所有、最小権限、秘密情報、CI/CD、監査、復旧をどう整えるかは、こちらの記事で詳しく整理しています。
Daybreakで強いモデルを使えるようになっても、この基盤は消えません。むしろAIができる操作が増えるほど、権限境界を曖昧にしたまま運用するコストは大きくなります。
最初の導入は一つの安全条件を守れるかから始める
では、自社で試すならどこから始めればよいのでしょうか。
私は、最初から巨大なリポジトリ全体を対象にするより、一つの重要機能と、一つの守るべき条件を決める方がよいと考えています。OpenAIのEnterprise onboardingも、最初のCodex Security利用を狭いリポジトリ、ブランチ、個別の警告など、対象を絞って始めるよう案内しています。
たとえば認証・認可の一部を対象にします。そこで「権限のない利用者が他人のデータを読めない」という安全条件を決める。AIには、その条件を破る可能性がある箇所を探させ、証拠を出させ、必要なら修正案を作らせる。修正後は決めたテストを通し、人間が採否を判断する。
開始前に最低限、次を決めておきます。
どのリポジトリ、モジュール、ブランチまでを対象にするか
絶対に破ってはいけない安全条件は何か
問題候補を有効とみなす証拠は何か
修正後に必ず通すテストは何か
人間承認の前にAIが実行してよい操作はどこまでか
どの条件になったら検査や自動修正を止めるか
この一覧で最も重要なのは、最初の項目でもモデル名でもありません。何をもって「安全に修正が完了した」と判断するかを先に決めることです。完了条件がないままAIへ広い権限を渡すと、処理量は増えても成果とリスクを比較できません。
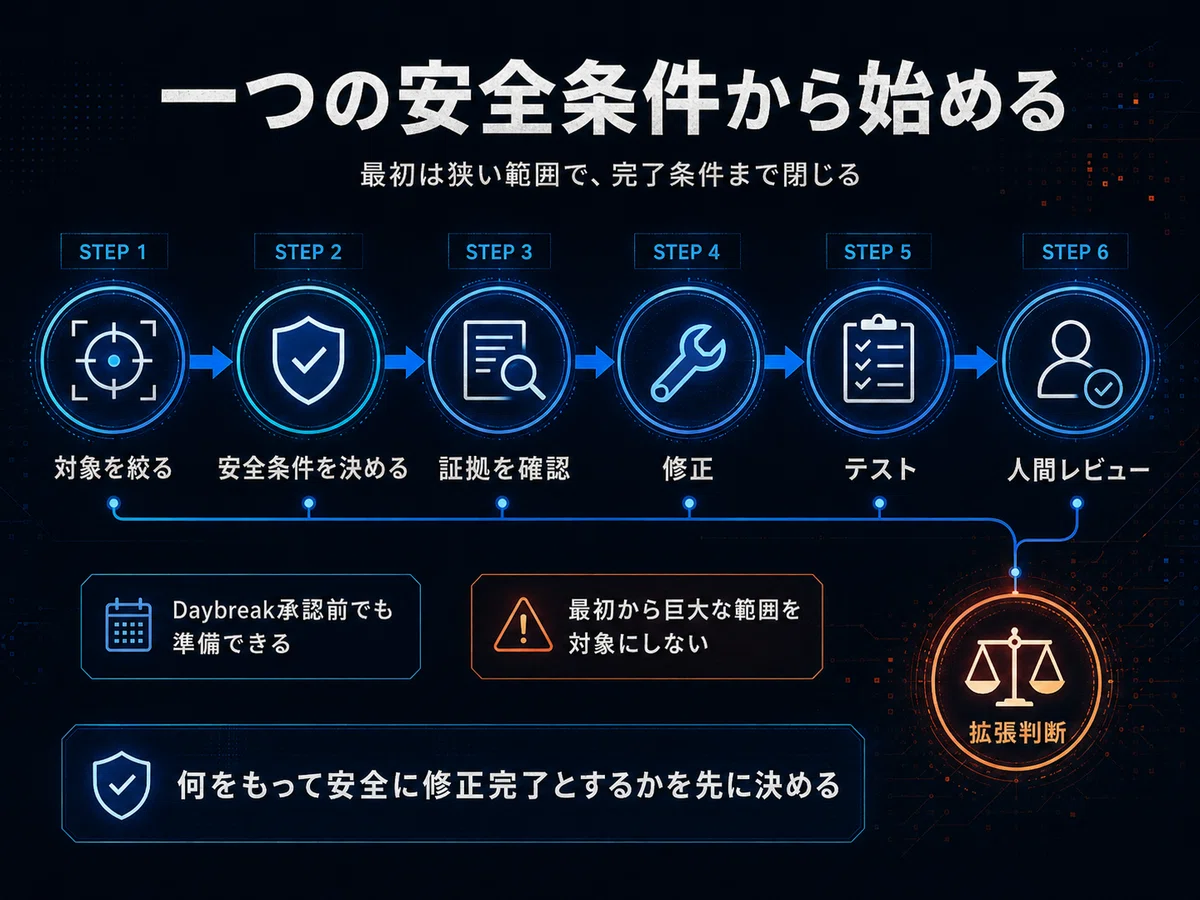
この準備自体はDaybreakの承認前でもできます。守るべき条件を書き、脅威モデルを作る。Codex Securityへのアクセスがあるなら狭い範囲でスキャンや検証を行い、誤検知、修正品質、人間レビューの負荷を測る。そのうえで「Blueのアクセスがあると、どの仕事が新たに解けるのか」を確認する方が、導入理由は明確になります。
反対に、対象範囲を限定できない、秘密情報を切り分けられない、人間が修正案をレビューできない、問題候補を評価する基準がない。この状態なら、Daybreakの前に開発基盤を整える方が先です。
Daybreakが示したのは強いモデルより強い運用の条件だ
Daybreakによって変わったのは、AIがセキュリティ作業のより深い場所まで入れるようになったことです。問題候補を挙げるだけでなく、検証、修正、テストまで一続きに扱える範囲が広がり、高度な認可済み研究向けにはRedという別のアクセスも用意されました。
一方で、変わっていないものがあります。
どのシステムを守るのか。AIにどこまで触らせるのか。秘密情報をどう扱うのか。何を証拠とするのか。誰が本番反映を承認するのか。問題が起きたときにどう止め、どう戻すのか。こうした責任は、強いモデルが登場しても消えません。
だから、Daybreakから一般のAI活用へ持ち帰るなら、私は四つの判断を残します。
モデルが賢くなっても権限は別に決める。生成物の数ではなく仕事の完了条件を見る。AIの提案と人間の最終責任を分ける。そして最上位モデルを選ぶ前に、今どこで仕事が詰まっているのかを確認する。
この考え方は、セキュリティ以外のAIエージェントにもそのまま使えます。調査AIなら、長い回答を生成したことではなく、根拠が追えて判断に使える状態になったかを見る。業務エージェントなら、操作を実行したことではなく、正しい状態へ到達し、例外時に止められるかを見る。開発AIなら、コードを書いたことではなく、テストとレビューを通して変更を受け入れられる状態になったかを見る。
Daybreak Redが必要な組織はあります。しかし、多くの会社が今日決めるべき最初の問いは「Redを使えるか」ではありません。
自社の重要な機能で、AIに絶対に破らせない条件は何か。その条件を、証拠付きで検査し、修正し、人間が採否を判断する小さなループを作れるか。
このループを閉じられないまま、より強いモデルと広い権限だけを追加しても、セキュリティ業務は強くなりません。逆に閉じられるなら、Blueや将来必要になるRedを「何を解くためのアクセスなのか」という形で評価できます。
Daybreakで更新すべきなのは、モデルの順位表より先に、AIが仕事を安全に完了するための開発工程だと私は考えています。
出典・参考資料
OpenAI Expanding Daybreak as the cyber defense window narrows 2026-08-10
https://openai.com/index/expanding-daybreak-as-the-cyber-defense-window-narrows/OpenAI Help Center OpenAI Daybreak Trusted Access for Cyber overview
https://help.openai.com/en/articles/20001258-openai-daybreak-trusted-access-for-cyber-overviewOpenAI Help Center Enterprise Daybreak onboarding
https://help.openai.com/en/articles/20001261-enterprise-daybreak-onboardingOpenAI Developers Codex Security plugin
https://developers.openai.com/codex/security/pluginOpenAI Developers Run a Codex Security scan
https://developers.openai.com/codex/security/plugin/scansOpenAI Developers Fix and verify security findings
https://developers.openai.com/codex/security/plugin/fix-findingsOpenAI Developers Daybreak Blue model
https://developers.openai.com/api/docs/models/daybreak-blue-latestOpenAI Developers Daybreak Red model
https://developers.openai.com/api/docs/models/daybreak-red-latest
いいなと思ったら応援しよう!
 社会問題×マーケティングが好き / ㍿小さな一歩(前澤ファンド出資先)で養育費の未払い問題にビジネスでトライ→㍿SHIRO創業。社会問題の発見→要因分析→ビジネス考案→実行に必要な資本整備→実行・改善のサイクルが最短で回り社会問題が解決されつづけるインフラを創る。
この記事は noteマネー にピックアップされました

