Claude Fable 5.1/Mythos 5.1が登場!変更点と試したい3つの用途

こんにちは、AI-Bridge LabのYOです!
2026年9月1日、AnthropicがClaude Fable 5.1とClaude Mythos 5.1を発表しました。前モデルのFable 5が6月に登場してから、わずか3か月での更新です。
変更点は3つです。トークン課金のコストが一般的な用途で約25%下がったこと。セーフガードの誤検知が減り、ソフトウェアの脆弱性発見に使えるようになったこと。そして公開されたベンチマークのすべてでFable 5を上回ったことです。
なお、Mythos 5.1は米国内の審査済み組織に限定された提供です。日本にいる皆さんが触れるのはFable 5.1のみになります。
この記事の数値はすべてAnthropicの自社公表値で、第三者による検証結果は執筆時点(2026年9月2日)では出ていません。AI-Bridge Labによる実機検証も含んでいません。
この記事でわかること
・Fable 5.1とMythos 5.1を分けている唯一の違い
・価格改定の中身と、定額プラン利用者への影響の有無
・セーフガード変更で新たに可能になった作業と、今も制限される作業
・Fable 5.1で試す価値がある3つの用途
Fable 5.1とMythos 5.1を分ける唯一の違い
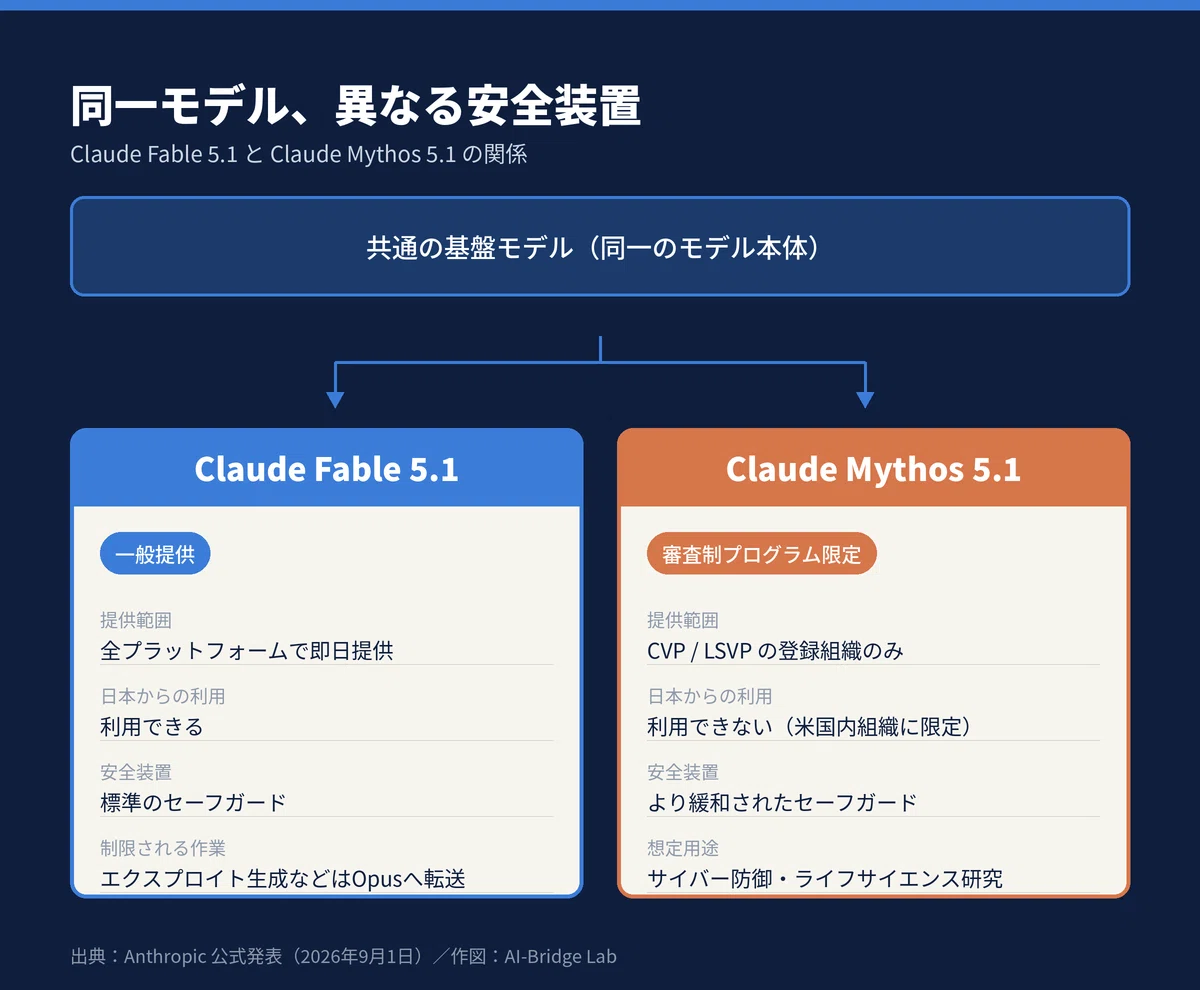
両者は別々のモデルではありません。Anthropicは公式ページで、同一のモデルであり違いはセーフガードの強度だけだと明言しています。
Fable 5.1は一般提供で、9月1日から全プラットフォームで使えます。Mythos 5.1はCyber Verification Program(CVP)とLife Sciences Verification Program(LSVP)という2つの審査制プログラムの登録組織だけが利用でき、対象は現時点で米国内に限られます。サイバー防御やライフサイエンス研究など、標準のセーフガードでは制限がかかる領域の専門家向けという位置づけです。
Anthropicは米政府と調整して対象を広げる方針ですが、時期は明らかにしていません。
価格は実質25%減、ただし下がったのは1項目だけ
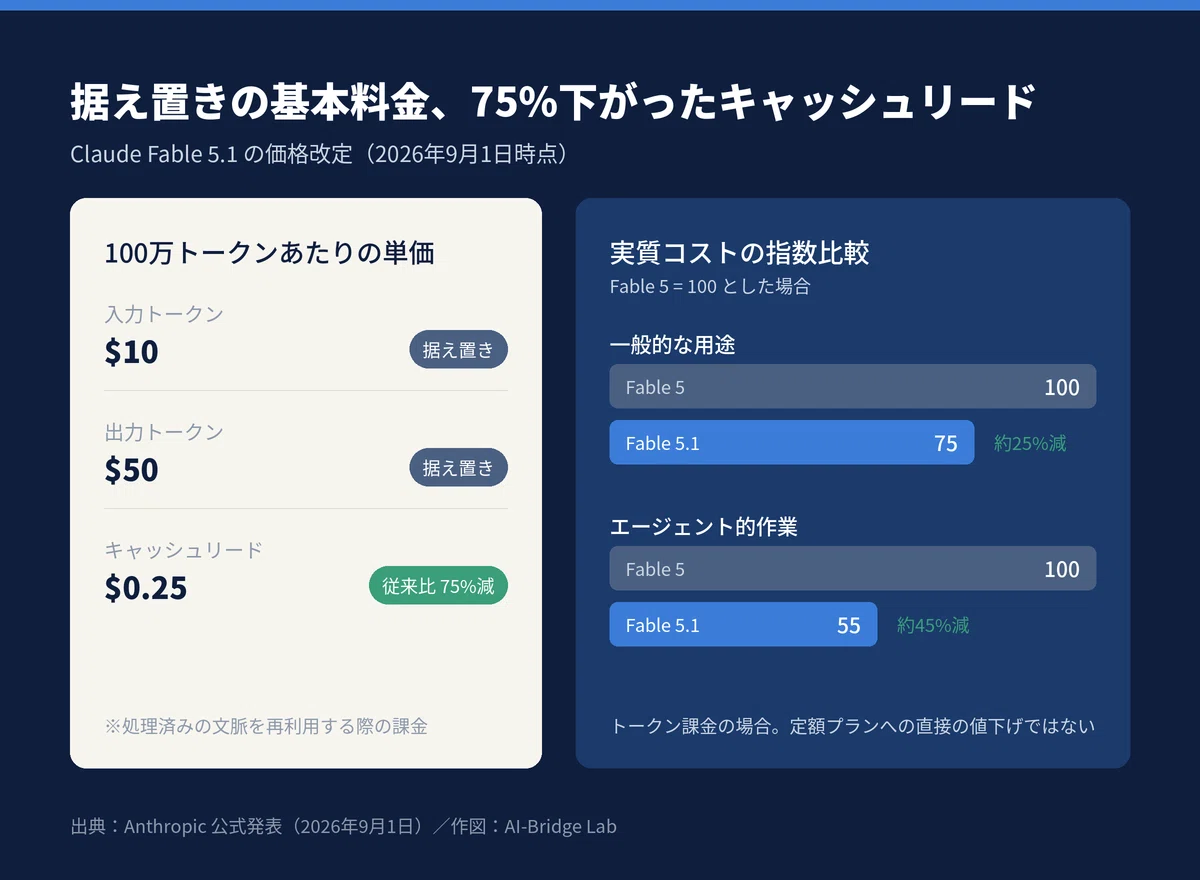
入力トークンは100万トークンあたり$10、出力は$50で、いずれもFable 5から据え置きです。変わったのはキャッシュリードだけで、従来比75%減の$0.25になりました。キャッシュリードとは、一度処理した文脈をモデルが再利用するときにかかる課金です。
この1項目が全体に大きく響きます。Anthropicは2026年8月の実利用データをもとに一般的なワークロードで約25%、文脈とツール利用が多いエージェント的な作業では約45%コストが下がると説明しています。
ただしこれはトークン課金の話です。Claude Proなどの定額プランの月額が下がるわけではありません。恩恵を直接受けるのは、APIやClaude Codeで従量課金を使っている場合です。
セーフガード変更で使えるようになった作業
今回の更新で実務に最も影響するのがセーフガードの精度改善です。これまでは安全側に倒しすぎて、無害な質問まで巻き込む場面がありました。
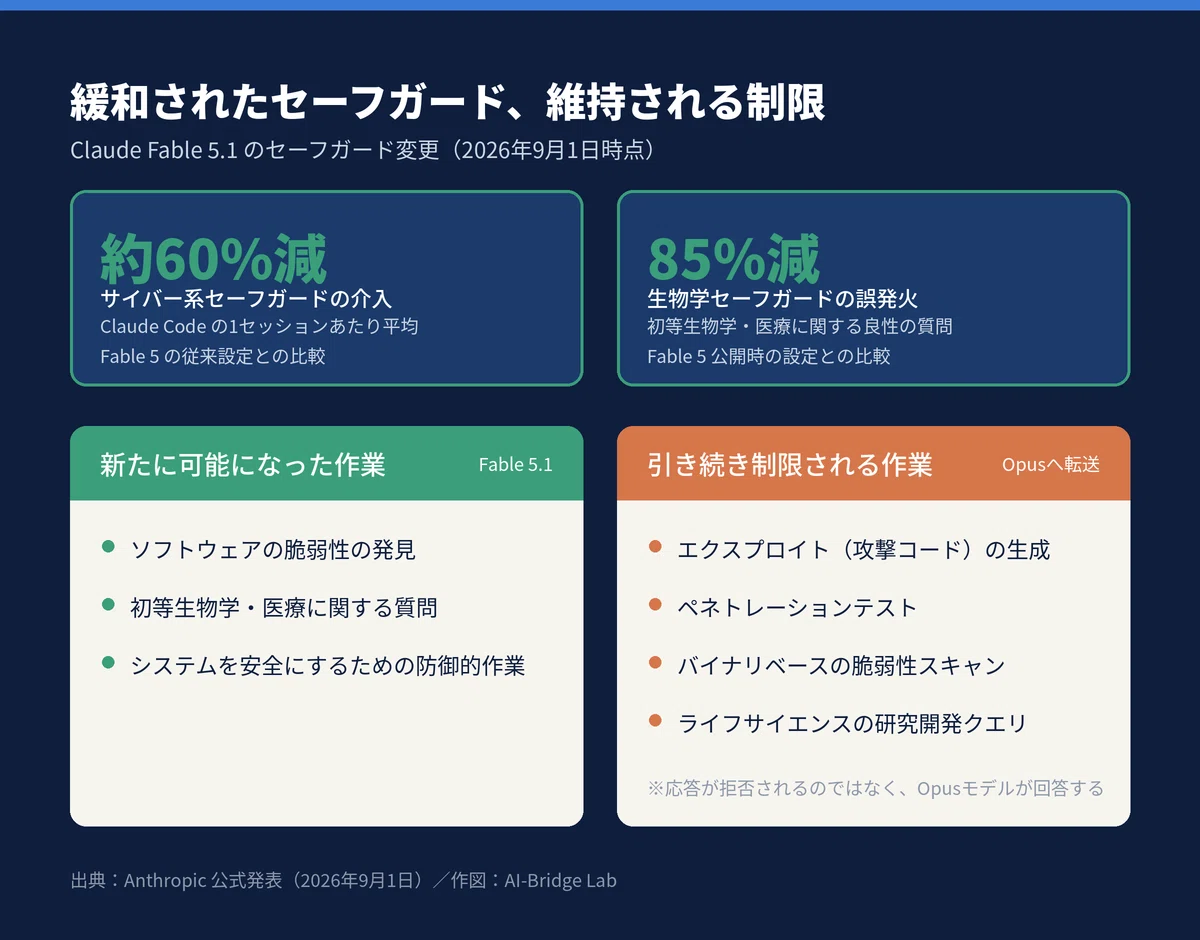
サイバーセキュリティでは、Fable 5.1がソフトウェアの脆弱性の発見に使えるようになりました。攻撃コードの作成は引き続き認められておらず、システムを安全にするための防御的な作業に限られます。この変更などにより、Claude Codeでのセーフガード介入は1セッションあたり平均で約60%減るとAnthropicは説明しています。
生物学でも同じ方向の改善がありました。初等生物学や医療に関する良性の質問への誤発火が、Fable 5の公開当初と比べて85%減っています。体調や薬を調べるような用途で応答が止まる場面は、減ると見てよさそうです。
一方で制限が残る領域もあります。エクスプロイトの生成、ペネトレーションテスト、バイナリベースの脆弱性スキャンといった、防御にも攻撃にも使える作業は今もOpusモデルへ転送されます。ライフサイエンスの研究開発に関わる質問も同じ扱いです。
転送は拒否ではありません。Fable 5.1ではなくOpusが回答を返す仕組みです。Claudeを使っていて回答の質感が急に変わったように感じる場面があれば、これが働いている可能性があります。
ベンチマークの数値と、その読み方
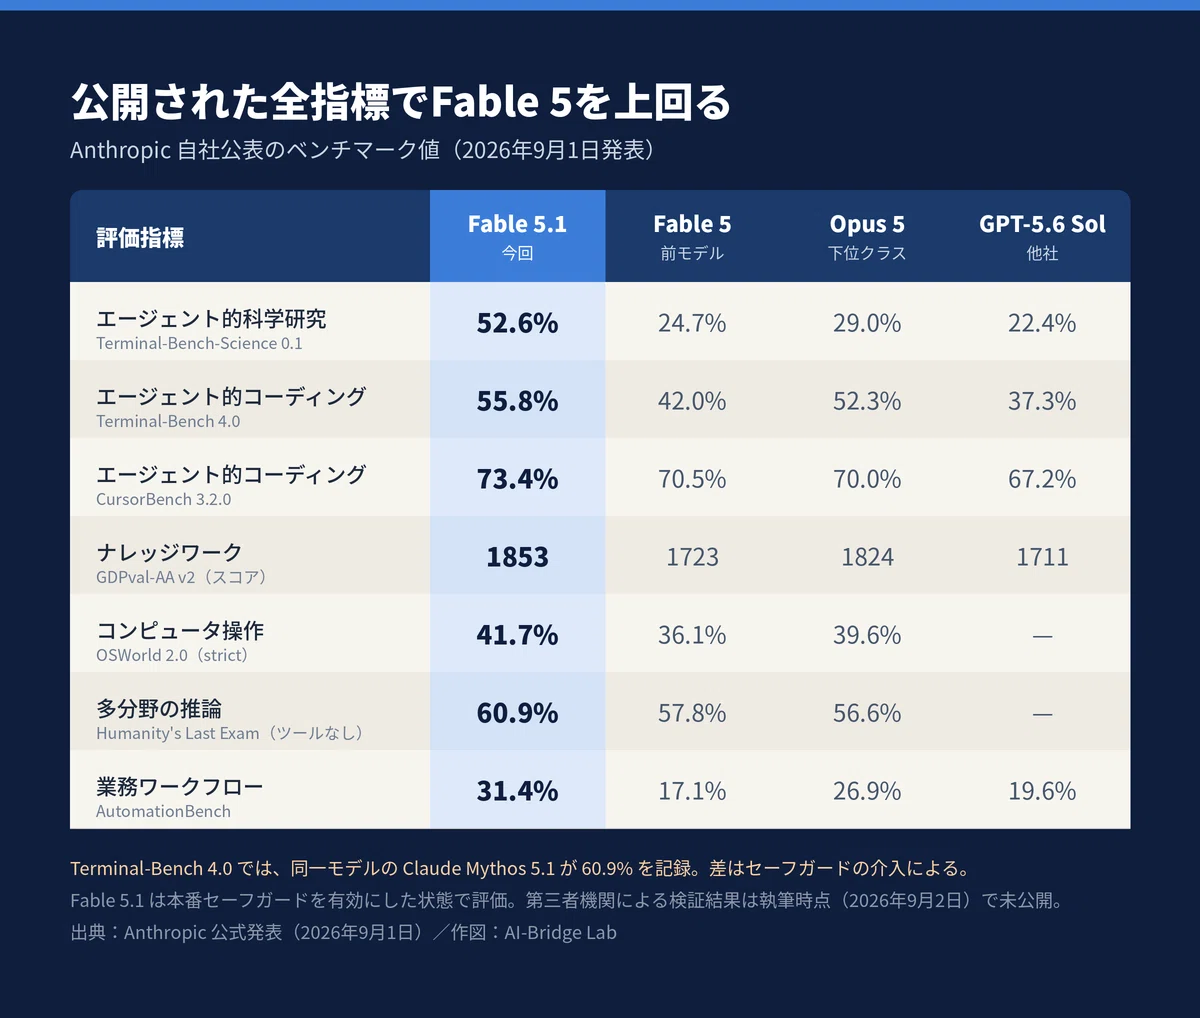
公開された指標のすべてでFable 5.1がFable 5を上回りました。伸び幅が大きいのは科学研究と業務ワークフローで、Terminal-Bench-Science 0.1は24.7%から52.6%へ、AutomationBenchは17.1%から31.4%へ動いています。一方でCursorBench 3.2.0は70.5%から73.4%にとどまり、伸び方には領域による偏りがあります。
ただしAutomationBenchの数字には注意が必要です。Anthropicの注記によると、セーフガードが介入したタスクでFable 5は0点として集計されており、比較対象側のスコアが実力より低く出ている可能性があります。
この表で最も興味深いのは、Fable 5.1とMythos 5.1の関係です。Terminal-Bench 4.0でFable 5.1が55.8%、Mythos 5.1が60.9%を記録しました。両者は同一のモデルですから、この5.1ポイントはセーフガードが介入したタスクの分にあたります。安全装置を動かすことの代償が数値として表に出た形です。Anthropicは今回の改善で差は縮まると見込んでいます。
Fable 5.1で試してほしい3つの用途
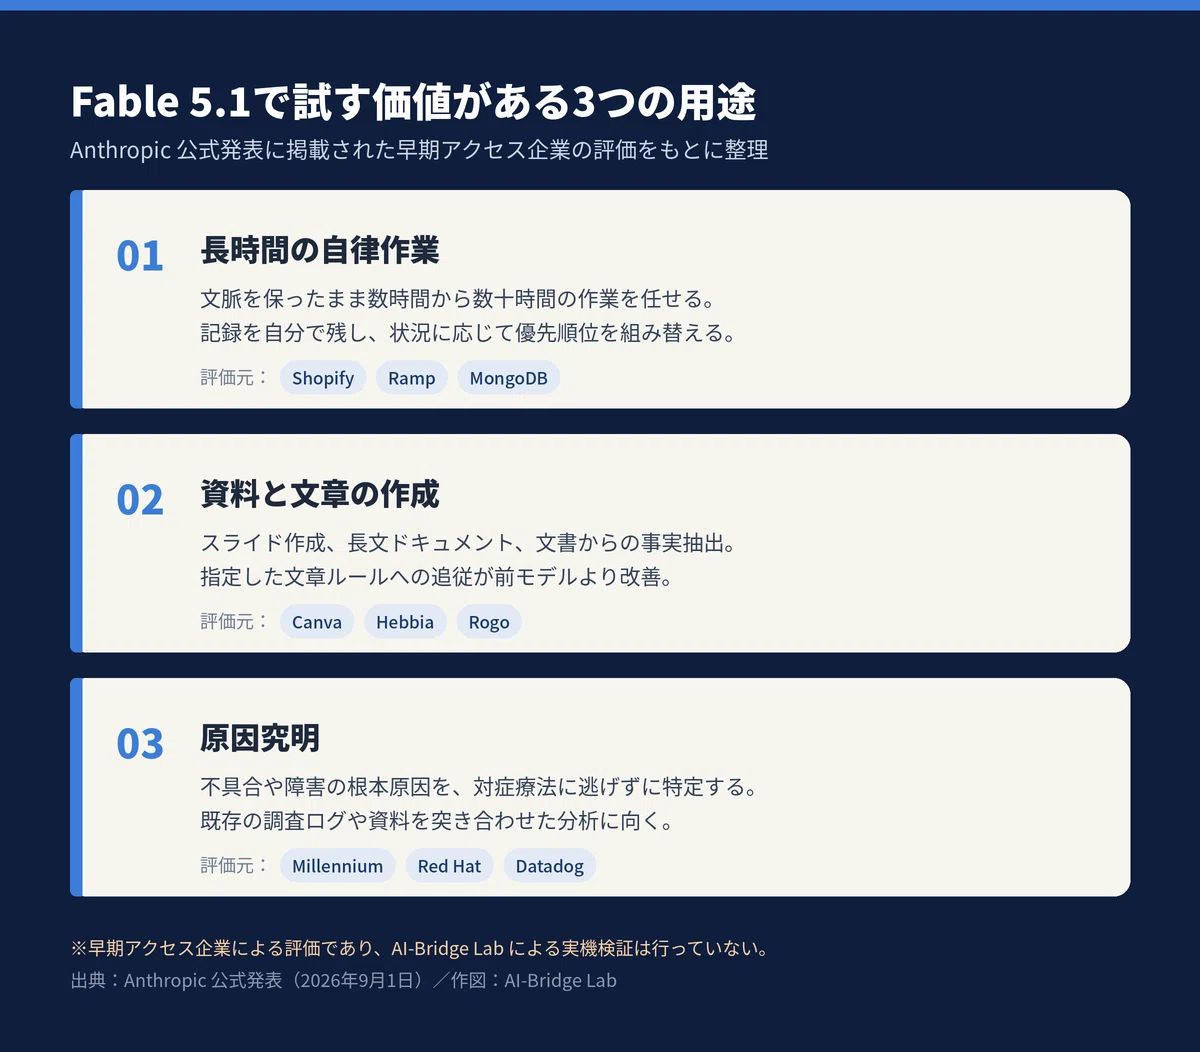
ここからは公式発表に掲載された早期アクセス企業の評価をもとに用途を3つ挙げます。企業側の評価は利害関係のある立場からの発言でもあるため、あくまで候補として見てください。
①長時間の自律作業
Shopifyは、長時間の無人作業に耐えるようになり、自分で記録を残しながら状況に応じて優先順位を組み替え、中断地点から再開できたと述べています。Rampは38時間の無人実行、MongoDBは数時間の連続実行でのプロトタイプ構築を例に挙げています。
②資料と文章の作成
Canvaは、指定した文章ガイドラインへの追従が改善し、ブラインドテストでFable 5より出力を好んだと報告しています。Hebbiaは自社のPowerPoint評価でこれまで試したどのモデルより良いスライドを生成し、財務文書からの事実の拾い出しでも最良だったとしています。
③原因究明
Millenniumは、4年から5年にわたって誰も説明できなかった100万回に1回のクラッシュについて、Fable 5.1が外部ライブラリを解析して原因を突き止めたと述べています。Red HatはClaude Codeで壊れたビルドの根本原因をすべて正しく特定できたと報告しています。
共通するのは、途中で妥協せず最後まで詰める挙動です。
まとめ
Fable 5.1の実質的な意味は、性能の伸びよりも、同じ作業をより安く、より少ない誤検知でこなせるようになった点にあります。
個人的に最も面白かったのは、同一モデルであるFable 5.1とMythos 5.1のスコア差が、安全装置を動かすことの代償として数値に表れていた点です。ここまで開示する例はあまり見かけません。
ただし日本語での出力品質や実際の応答速度は、公式情報だけでは判断できません。AI-Bridge Labでも検証を進め、結果が出た段階で改めて記事にします。
まずは着手できていない調査や資料作成を1つ任せてみてください。今回の変更が効くかどうかは、それが一番早く分かります。
最後まで読んで頂きありがとうございました! 気に入って頂けましたら「スキ」や「フォロー」をしていただけると幸いです! 😄 Xアカウント(mei_aibridgelab)のフォローもぜひお願いします!
いいなと思ったら応援しよう!
 皆さまの温かいサポートのおかげで、活動を続けることができています。もしよろしければ、引き続き支援をお願いできますと幸いです。より質の高い記事投稿に励みます!
