Anthropic「Claude Fable 5.1」と「Claude Mythos 5.1」を発表。提供範囲の違いなど 徹底解説

Anthropicは2026年9月1日、新しいAIモデル「Claude Fable 5.1」と「Claude Mythos 5.1」を発表しました。2つの名前がありますが、基盤モデルは同じです。それなのに、一方は広く提供され、もう一方は限られた人しか利用できません。2つの名前が付いた理由は、安全策と利用条件の違いにあります。
本記事で使用している画像には、編集と翻訳を施しています。
画像内の数値などは変更していません。
Fable 5.1とMythos 5.1、何が同じで何が違うのか
Claude Fable 5.1とClaude Mythos 5.1は、Anthropicによれば同じ基盤モデルです。違うのは安全策の強さと、誰が使えるかという点です。
Fable 5.1は一般提供のモデルです。API、Amazon Web Services、Google Cloud、Microsoft Foundryといった主要クラウドから利用でき、claude.aiでは有料プランのユーザーが使えます。一方のMythos 5.1は、サイバーセキュリティや生命科学の専門家向けの「trusted access」枠に限って提供されています。発表時点では一部の米国組織が対象で、審査を通過した組織や個人だけがアクセスできます。
Anthropicの発表内容
We’re introducing Claude Fable 5.1 and Claude Mythos 5.1.
— Claude (@claudeai) September 1, 2026
They're the world’s most advanced models for coding and knowledge work. pic.twitter.com/8P9PSrWPi3
Claude Fable 5.1とClaude Mythos 5.1を導入します。これらは、コーディングと知識労働のための世界で最も先進的なモデルです。
Anthropicの公式Xアカウントは日本時間9月2日3時3分(協定世界時9月1日18時3分)にこの投稿をしました。「世界で最も高度」という表現はAnthropic自身の評価であり、第三者機関の検証結果ではありません。
同時に公開された公式発表ページでも、両モデルが同じ基盤モデルであること、Fable 5.1が一般提供であり、Mythos 5.1がtrusted access限定であることが明記されています。
性能はどれくらい上がったのか
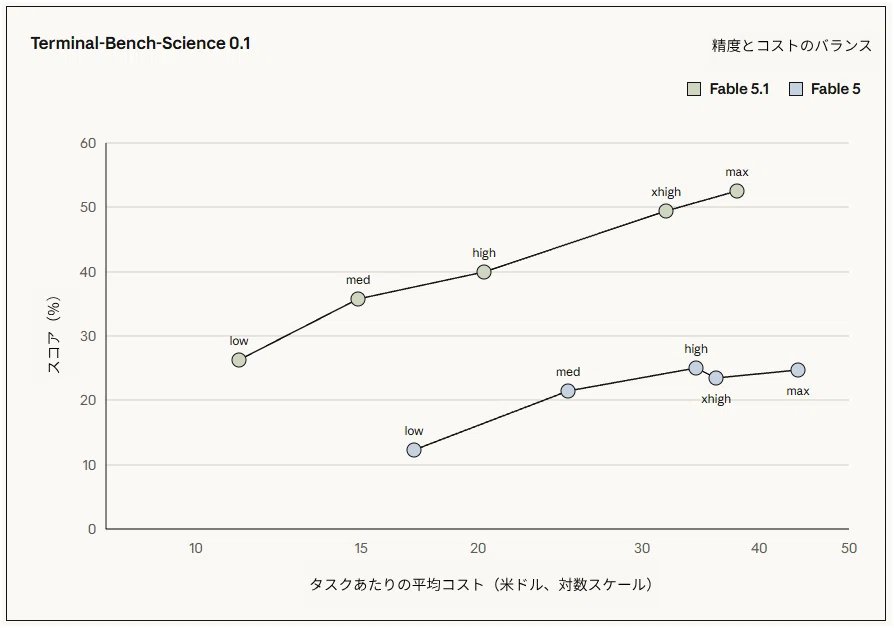
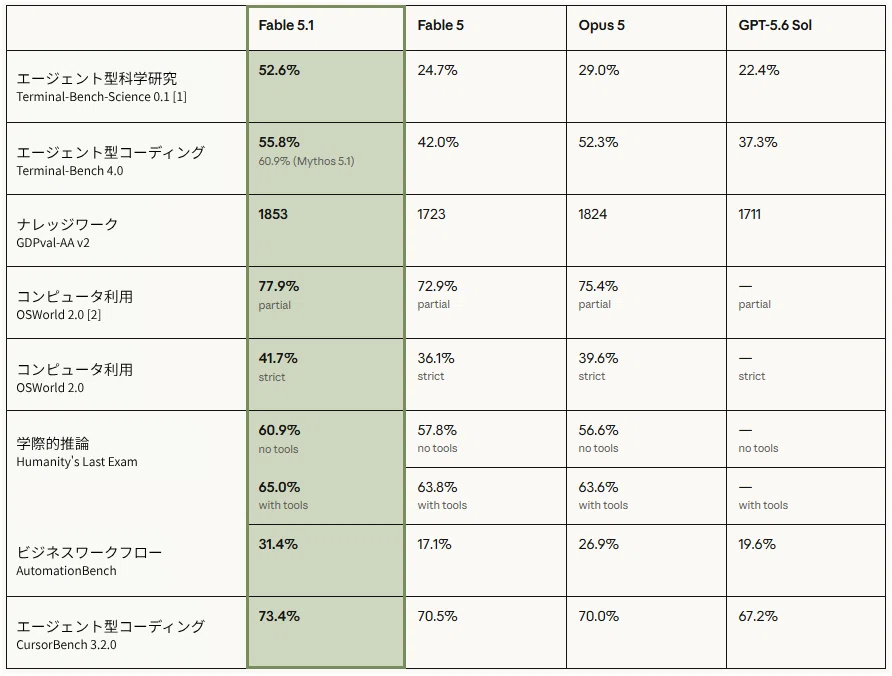
上記2枚の画像には、DeepLによる翻訳が含まれています。
数値などは変更していません。
Anthropicが公表したベンチマーク結果を見ると、伸び幅が大きいのは科学分野のエージェントタスクです。Terminal-Bench-Science 0.1では、Fable 5.1が52.6%を記録し、前身のFable 5の24.7%から2倍以上に伸びています。
コーディング系のTerminal-Bench 4.0では、Fable 5.1が55.8%、安全策を緩めたMythos 5.1が60.9%、旧モデルのFable 5が42.0%という結果でした。FableとMythosの間に差が生じたのは、安全策が一部のタスクに介入したためだとAnthropicは説明しています。
ここで示した数値は、Anthropicによる自社計測の結果です。評価ごとにEffortやツール、安全策などの条件が異なるため、単純な性能順位として比較することはできません。
料金はどう変わったのか
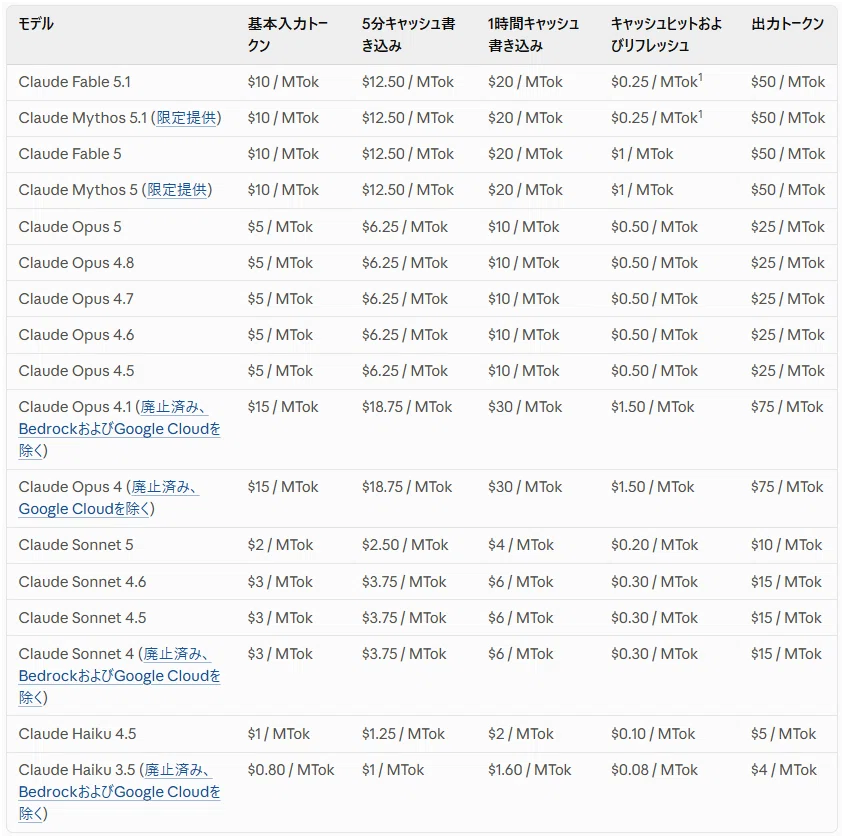
直前の2枚の画像には、Google翻訳による翻訳が含まれています。
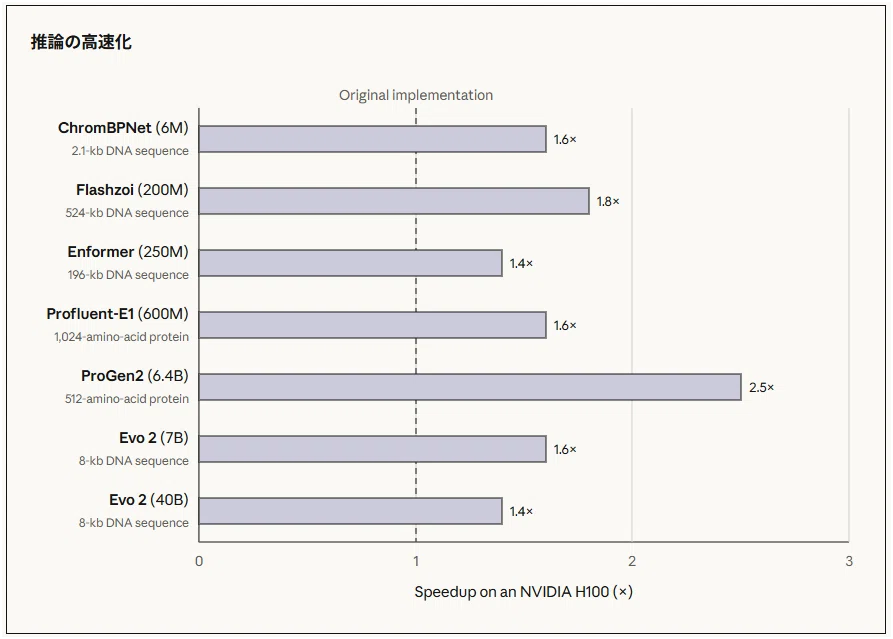
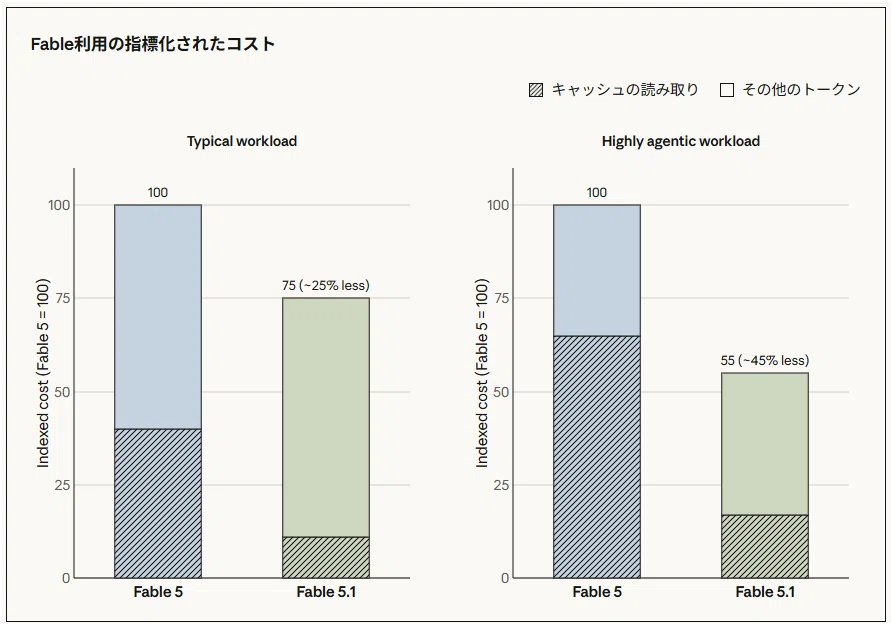
推論の高速化と、Fable利用時のコスト指標
入力トークンは100万トークンあたり10ドル、出力トークンは100万トークンあたり50ドルで、基本料金はFable 5と変わりません。変わったのはキャッシュ読み取りの価格で、100万トークンあたり1ドルから0.25ドルへと75%値下げされました。
Anthropicは、一般的なワークロードで約25%、コーディングのように長時間のやり取りが続く用途では最大約45%のコスト削減になると推定しています。これは基本料金の値下げ幅ではなく、キャッシュ読み取りを含む総費用の推定値です。実際の削減幅は使い方によって変わります。
安全策の「誤検知」が減った
新しい安全策では、無害なサイバーセキュリティ関連の依頼をfalse positive(誤検知)と判定するケースが約60%減ったとAnthropicは説明しています。Claude Codeでは、旧Fable 5の安全策と比べて1セッションあたりの介入回数が平均で約60%減ったとされています。防御的なコーディングや脆弱性の発見に関する依頼が、以前より通りやすくなりました。
生物学の安全策についても、初歩的で無害な生物学・医療関連の質問に対してbiology safeguardsが作動する頻度が、Fable 5発売時点の安全策と比べて約85%減ったとAnthropicは説明しています。どちらもAnthropicの内部評価で、誤検知がゼロになったわけではありません。
どこで使えるのか
Fable 5.1のAPIモデルIDはclaude-fable-5-1です。一度に扱える文脈は100万トークンで、最大出力は128,000トークンです。Adaptive Thinkingと呼ばれる思考モードが常に有効で、Effortによって思考の深さが調整されます。
Claude Code、claude.ai、Claude CoworkといったClaude製品のほか、Amazon Web Services、Google Cloud、Microsoft Foundryを通じて利用できます。Effortの既定値は、Claude CodeではHigh、claude.aiとClaude CoworkではMediumです。
Mythos 5.1は、Anthropicがtrusted access(Project Glasswing)と呼ぶ枠組みを通じて提供され、発表時点では一部の米国組織に限られています。生命科学分野のLife Sciences Verification Programはinvite-only betaとして始まっていますが、Cyber Verification ProgramへのMythos-classモデルの追加は今後の予定です。
まとめ
claude.aiを使う一般ユーザーは、有料プランでFable 5.1を選択できるか確認すれば十分です。APIを使う開発者は、キャッシュ読み取り価格の変更が自分のワークロードでどの程度コスト削減につながるかを試算してみてください。Mythos 5.1は、現時点では審査を通った一部組織向けです。
参考資料
Introducing Claude Fable 5.1 and Claude Mythos 5.1 — Anthropicによる公式発表ページ。
https://www.anthropic.com/claude-fable-and-mythos-5-1Claude Fable 5.1 & Claude Mythos 5.1 System Card — 安全性評価や能力評価の詳細。
https://www.anthropic.com/claude-fable-5-1-mythos-5-1-system-cardAnthropic公式Xアカウントの発表投稿 — 発表を告知したポスト。
https://x.com/claudeai/status/2094848572143407483

