Opus5.5の実践知:コスパと分かりやすい解説への進化

Anthropicが最新モデルとなるOpus 5.5を公開しました。
前世代で課題視されていた出力の冗長さやコード生成の粗さが大幅に見直され、実務における日常的な開発を支える水準へと引き上げられています。
今回はYoutubeのTheoさんのOpus5.5を触った感触を取り上げてみます。
公式も情報を公開しているので、参考まで。
推論レベル:maxを避けmedium設定で回すことが運用の鍵になる
Opus 5.5を実務に投入する際の最適解は、推論レベルをmaxではなくmediumからhighの範囲に固定することです。能力を最大限に引き出そうと推論設定をmaxまで高めると、成果物の品質はほぼ変わらないまま思考ループに陥り、費用と実行時間が跳ね上がります。
トークン単価は20%安価になったものの、タスクあたりの出力トークン消費量は前世代から倍増近くまで増えています。
推論レベルをmaxに設定すると、mediumに比べて10倍以上の思考トークンを消費しながら正解率は約1%しか改善しません。
自然言語での報告は格段に明瞭になった一方で、コンテキストウィンドウの消費を恐れて作業を停滞させる癖が残っています。
推論レベルをmediumからhighに抑え、CLAUDE.mdで不必要な作業停止を防ぐ指示を与えることで安定した成果を得られます。
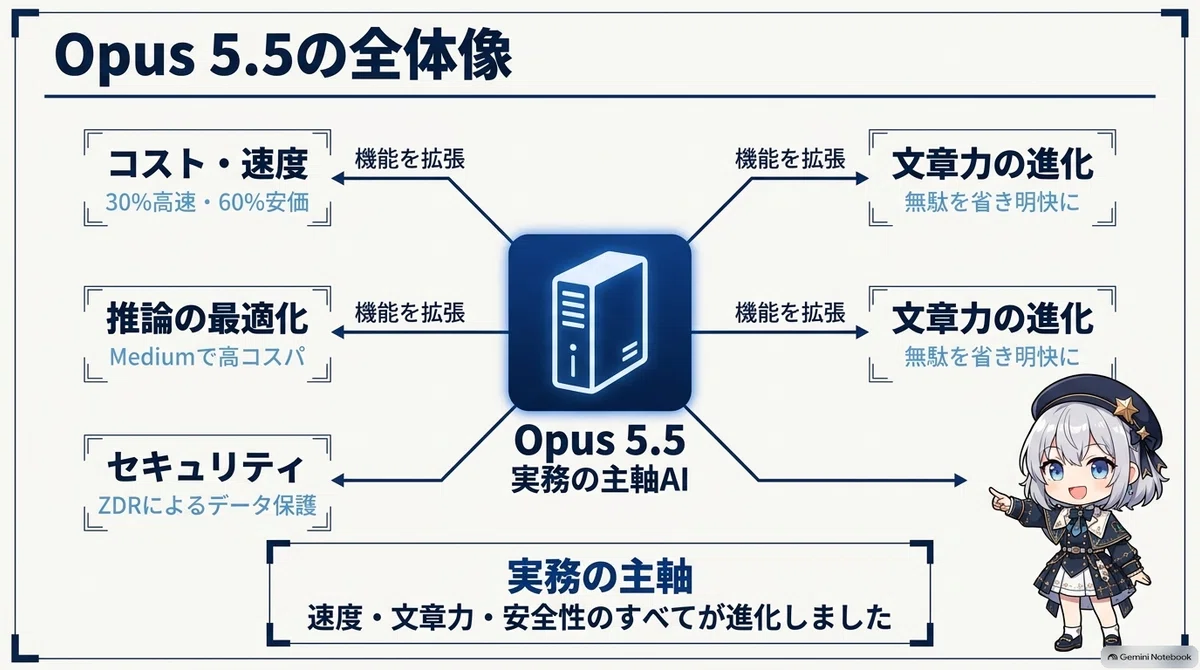
推論レベル(effort)をmediumに抑えるべきだという判断は、公式でも言及されている通りであり、性能を極限まで引き出したいという開発者の直感とは一見矛盾します。この差がどこから生まれるのかを確かめるために、まずはモデルの基本仕様と検証環境の事実から順に見ていきましょう。
公式情報を基にClaudeCode用に調整した内容はこちらから。
最新モデルへの期待と設定値の通説
新しい大規模言語モデルが登場したとき、数か月前のモデルは推論レベルをmaxに設定すれば最も精度の高いコードが得られると考えられていました。
なぜなら、思考時間を長く確保するほど難解な設計やリファクタリングが成功しやすくなると信じられてきたからです。
数か月前の私自身もより賢い結果を期待して、迷わずeffortをmaxまで引き上げて試行を繰り返していました。
今回検証されたOpus 5.5は、前世代のOpus 5で批判を集めたコードの見落としや説明文の質の低さを克服すべく開発されたモデルです。
検証では数十万行規模のコード移行や各種ベンチマークテストの測定が行われ、実際の開発環境における実効性能が測定されました。
検証結果を正しく追うために、推論レベルとコンテキスト圧縮という2つの概念を整理しておきます。推論レベルとは、モデルが最終的な回答を出す前に内部で仮説検証を行う思考の深さを段階的に指定する設定値です。
コンテキスト圧縮は、会話の履歴が上限に近づいた際に過去のやり取りを自動で要約し、記憶領域を確保する仕組みを指します。
実測データが示した性能とコストの内実
単価低下と速度向上の裏で出力トークン量が急増している
Opus 5.5の基本価格は大幅に改定され、カタログスペック上は前世代よりも扱いやすい設定になっています。
APIの料金体系は入力100万トークンあたり4ドル、出力100万トークンあたり20ドルとなり、Opus 5と比べて20%安価になりました。
キャッシュ読み取りも60%値下げされ、100万トークンあたり0.20ドルで処理されます。
生成速度についても約30%の高速化が確認され、セッションの途中で推論レベルを切り替えてもキャッシュが無効化されない設計へと改善されています。
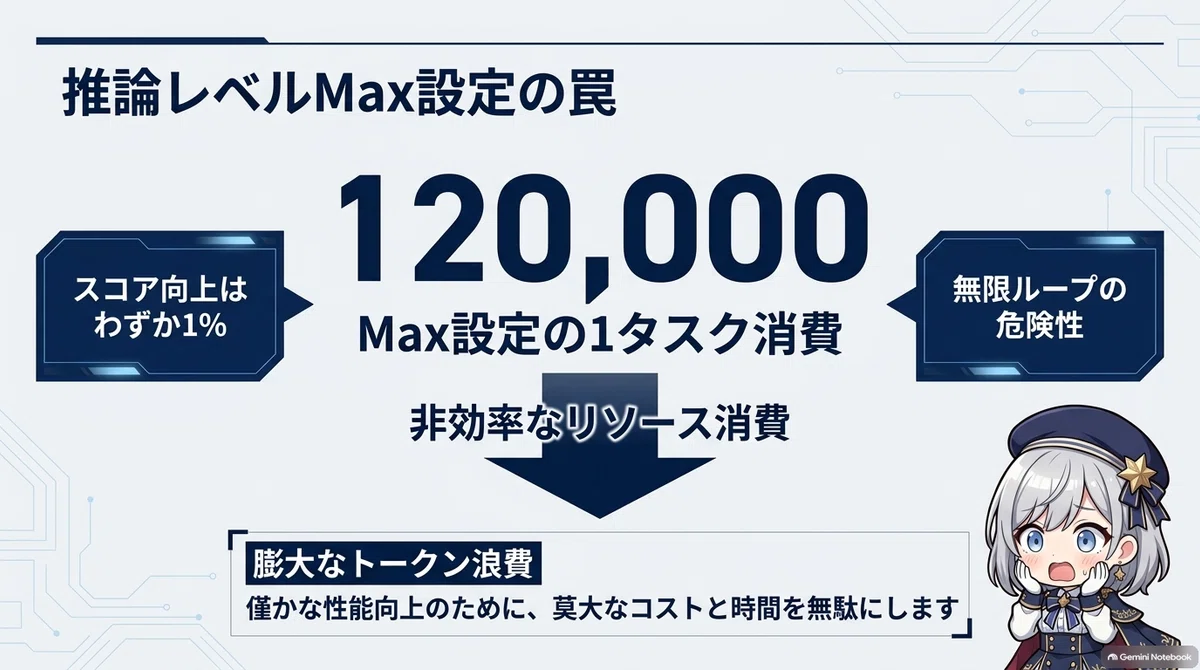
しかし、実証の結果、1タスクあたりの出力トークン数は大きく増加し、推論レベル:maxの測定において、前世代のOpus 5が1タスク平均7万3,000トークン、同社の上位モデルであるFable 5.1が7万8,000トークンだったのに対し、Opus 5.5は12万トークン近くを消費しました。
約2万7,000トークンで完了するGPT6 Astraなどの他社競合モデルと比較すると、4倍以上の開きが存在します。
単価が安くなったとしても、生成されるトークン数そのものが倍増しているため、利用総額は想像ほど下がらないという構造が判明しました。
推論レベルをmediumに抑えた設定が最大の費用対効果を出す
推論レベルの変更が成果とコストにどれほど寄与するのかを測るため、複数の評価指標で強度ごとの数値が取得されました。
実務的なコマンド実行環境を模したTerminal Bench 4などの環境において、推論レベルをmediumに設定したOpus 5.5は極めて高い正解率を示しました。その一方で、max設定では正解率の低下や伸び悩みが記録されています。
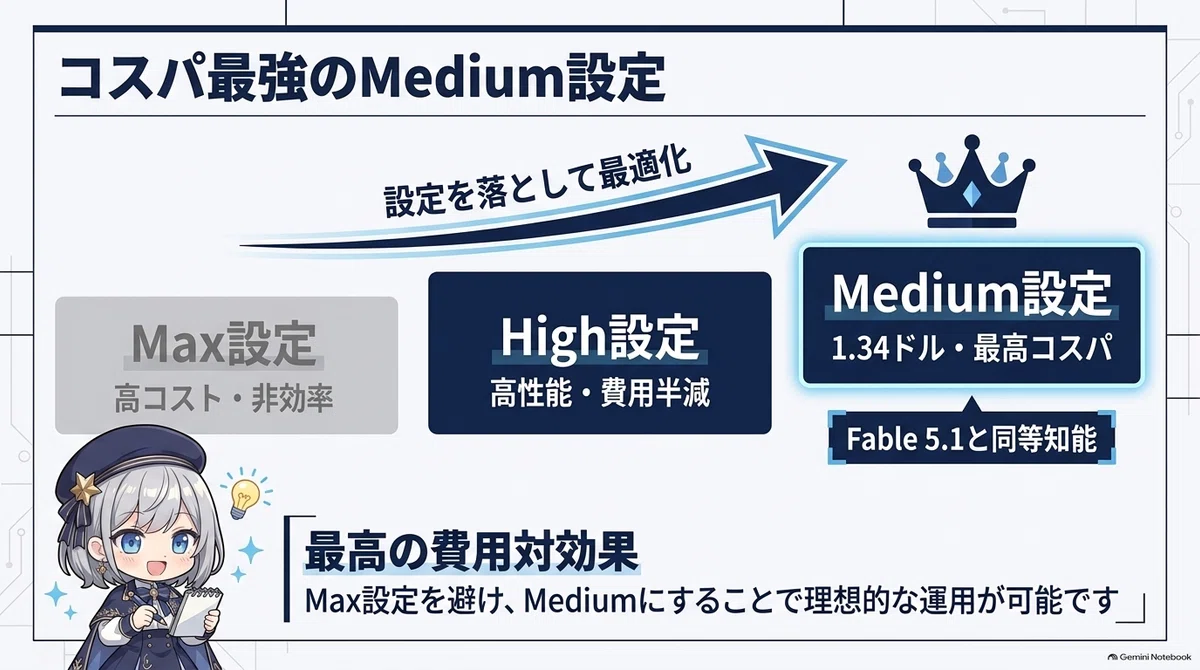
Terminal Bench 4において、medium設定のOpus 5.5は同社のFable 5.1による推論を上回るスコアを記録し、実行コストは約2.94ドルとFableの20ドルに対して大幅に安価でした。
Skatebenchでの測定では、一段階手前のhigh設定において1問あたり約330トークンだった推論消費量が、max設定では約5,000トークンへと急増しました。
この10倍以上の推論トークン増加に対して、ベンチマーク上のスコア向上は約1%にとどまりました。
これらの数値は、推論レベルをmaxに引き上げても精度向上は頭打ちになり、計算資源の浪費だけが突出して進むことを示しています。
思考に割り当てる段階をmaxに設定することは、成果に見合わない莫大なトークンを燃焼させる結果に直結します。
対話の明瞭化が進む一方で自動要約への誤認による停滞が発生する
モデルが開発者へ返す報告の文面と、長時間の自律コーディングにおける動作継続性も実環境で試行されました。
Opus 5で目立っていた記号の乱用や意味不明な説明が排除され、課金バグの原因特定などの実例では差分の影響金額と対象コミットが冒頭で的確に要約されるようになりました。
報告が簡潔で論理的になったことで、開発者がエージェントの意図を把握するためにログを読み直す負荷は劇的に軽減されています。
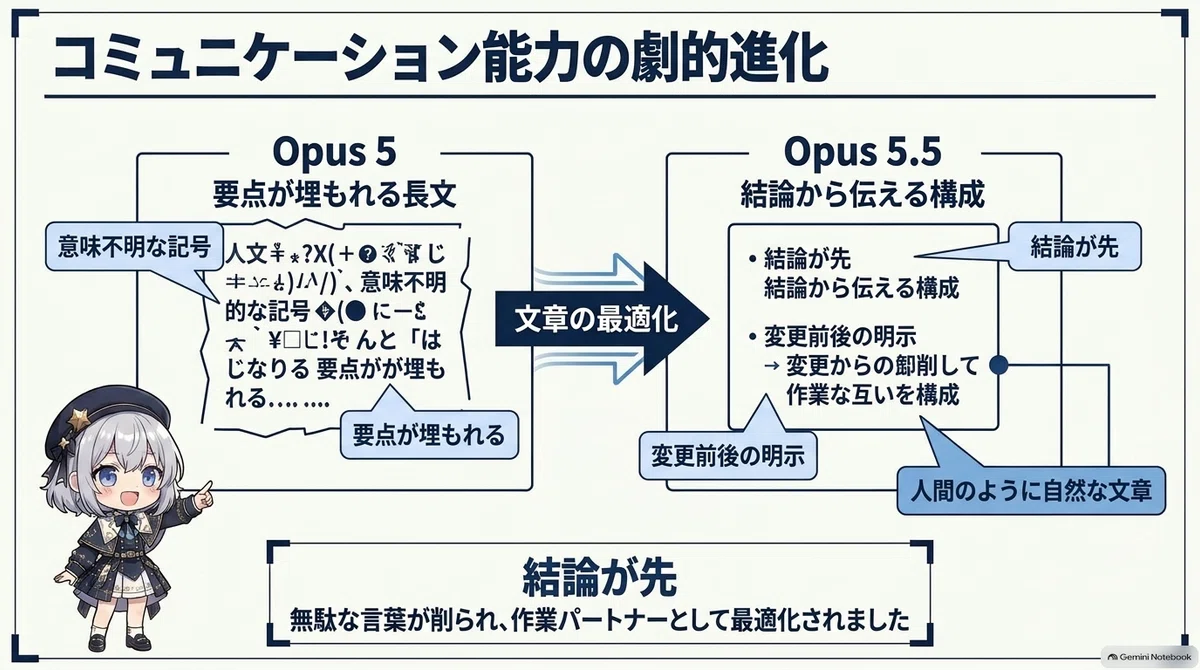
一方で、長時間のセッションでは不可解な停止挙動が確認されました。
3時間以上にわたりローカル環境でコードの最適化を続けていたインスタンスが、conpactionの発生まで残り10%になった段階で、クラッシュによる作業喪失を恐れてコミットを躊躇するという判断を下しました。
会話の履歴が上限に近づくこと自体は正常な動作フローであるにもかかわらず、モデル自身が文脈消失を恐れて処理を止めてしまうという新しい癖が観測された形です。
活かし方
過大な推論を抑えつつ長時間の作業停止を防ぐために、Claude Codeの作業環境へ明日の朝から即座に導入できる実践手順をまとめます。
Claude Codeの対話セッションを開始する場面 — 推論レベルをmaxにはせず、mediumまたはhighに固定して実行する
プロジェクトのルールファイルを定義する場面 — CLAUDE.mdに「思考のループ防止」と「自動要約の発生を恐れずに小さな変更を都度Gitへコミットする原則」を明記する
長時間のリファクタリングやパフォーマンス改善を指示する場面 — 1回の指示で全容を解決させず、対象ディレクトリや改善項目を2つから3つに絞って段階的に実行させる
📖 用語メモ
compaction(コンテキスト自動圧縮): 会話やツールの実行ログが上限に達する前に、要点を要約して長時間のセッションを継続させる機能。
