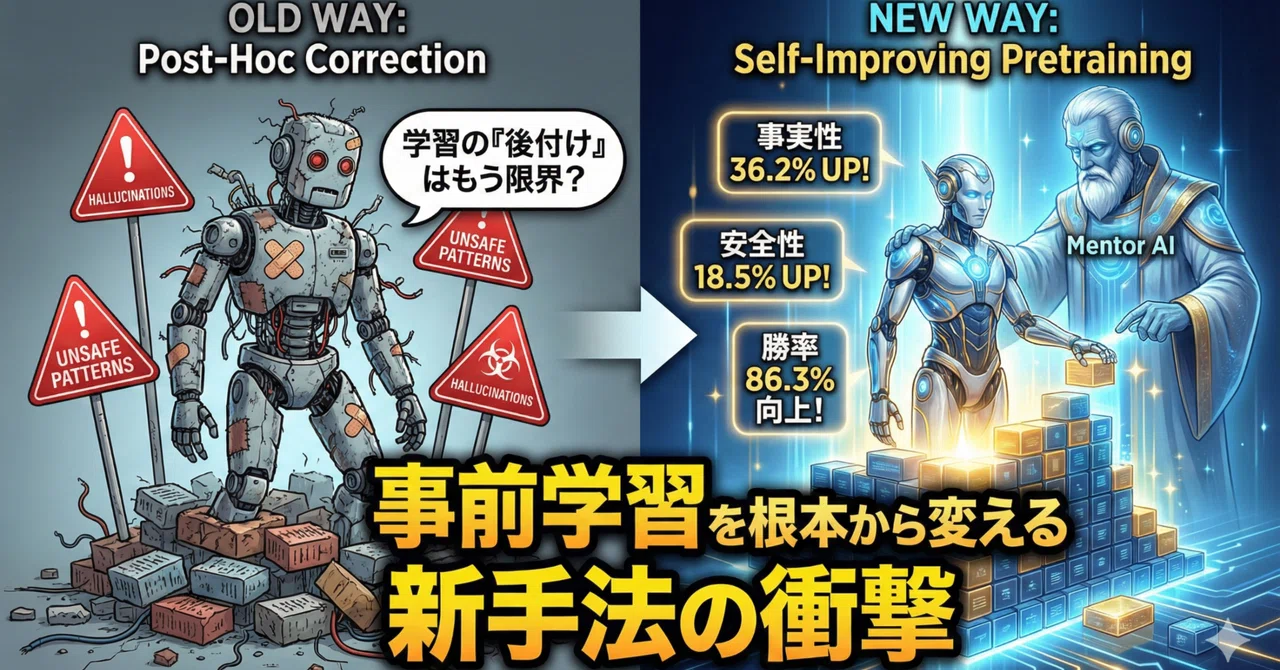
学習の「後付け」はもう限界?事前学習(Pretraining)を根本から変える新手法の衝撃

大規模言語モデル(LLM)と対話していて、流暢な嘘をつく「ハルシネーション」や、安全性のガードレールを巧みにすり抜ける不適切な回答に遭遇したことはないでしょうか。現在、こうした問題への対策は、膨大なデータでモデルを構築する「事前学習」を終えた後に、微調整(ファインチューニング)やアライメント(調整)を施して修正するのが一般的です。
しかし、この「後から直す」というアプローチは、いわば「成長した後の矯正」に過ぎません。最新のAI研究(arXiv:2601.21343)は、この常識を覆す衝撃的な問いを投げかけています。「性格」が決まる最初の瞬間、すなわち事前学習のプロセスそのものに、最初から正しい規律を教え込むことはできないのか。AI開発のパラダイムを根底から変える、新たな挑戦が始まっています。
1. 【パラダイムシフト】「後付けの修正」に潜む根本的な限界
現在のAI開発パイプラインは、まず何兆ものトークンを用いて世界中の知識を吸収させ、その後に安全性や事実性を教え込むという「二段構え」をとっています。しかし、本論文は、事前学習中に深く埋め込まれた(deeply embedded)不適切なパターンや誤った情報は、後段の複雑なパイプラインをもってしても完全に拭い去ることはできない、という冷徹な事実を指摘しています。
もしモデルが、最初の学習段階で「嘘」や「有害なパターン」を知識の基礎として学習してしまったら、その後の微調整は表面的な「絆創膏」を貼るようなものです。モデルの奥深くに刻まれた「基礎的な振る舞い(core behaviors)」を根本から修正しようとすれば、モデルが持つ他の高い能力まで損なわれかねません。だからこそ、事前学習の段階での介入が不可欠なのです。
even this complex pipeline cannot guarantee the correction of patterns learned during pretraining. (このような複雑なパイプラインであっても、事前学習中に学習されたパターンの修正を保証することはできません。)
2. 【革新的手法】「強固な師匠(事後学習モデル)」が、弟子の潜在能力を覚醒させる
この難題を解決するために提案されたのが、「Self-Improving Pretraining」という革新的なフレームワークです。この手法の真髄は、すでに高度な訓練を終えた「強固な事後学習済みモデル」を、事前学習の真っ最中にあるモデルの「師匠(判定役)」として起用する点にあります。
この手法では、静的なデータセットをただ読み込ませるのではなく、以下のようなダイナミックな「ストリーミング(streaming documents)」形式で学習が進められます。
三つ巴の比較: 事前学習中のモデルが、次に続くK個のトークン(model rollouts)をその場で生成します。
師匠による審判: 非常に強力な事後学習済みモデルが、(1) モデル自身が生成した続き(rollouts)、(2) 元の文書の続き(original suffix)、(3) 事後学習済みモデルによって書き換えられた高品質な続き(rewritten suffix)の3つを比較・評価します。
フィードバック・ループ: 強化学習(RL)を用い、モデルが自身の生成(rollouts)の質を高め、師匠が認める「より良い答え」を出せるよう、学習の歩みをその場で修正していきます。
これは、単なる知識の丸暗記ではなく、学習の源流において「何が正しいのか」という高い視座からのフィードバックを受け続ける、極めてインタラクティブなプロセスなのです。
3. 【驚異的な成果】事実性と安全性の圧倒的な向上
この「最初から正しく教える」アプローチは、標準的な事前学習と比較して、AI開発の歴史に刻まれるべき劇的な成果を収めました。
特に注目すべきは、事実性(Factuality)において36.2%、安全性(Safety)において18.5%という相対的な改善を達成した点です。さらに、生成された回答の総合的な品質を比較する勝率(win rate)においては、最大86.3%という驚異的な向上を記録しました。これは、事前学習の段階で適切なガイドを与えることが、モデルの最終的なパフォーマンスにどれほど決定的な影響を及ぼすかを雄弁に物語っています。
In experiments, our method gives 36.2% and 18.5% relative improvements over standard pretraining in terms of factuality and safety, and up to 86.3% win rate improvements in overall generation quality. (実験において、我々の手法は標準的な事前学習と比較して、事実性で36.2%、安全性で18.5%の相対的な改善を示し、全体的な生成品質の勝率では最大86.3%の向上を達成しました。)
4. 【進化する学習】データの枠を超え、モデルが「師匠」を追い越す瞬間
この手法が最も巧妙な点は、学習の進捗に合わせて「報酬の源泉」を動的に変化させる設計にあります。
学習の初期段階、モデルがまだ未熟な時期には、モデルは「元の文書」や「書き換えられた高品質な文書」をお手本として依存します。しかし、学習が進みモデルが成長するにつれて、評価の重みは「モデル自身の生成物(rollouts)」への報酬へとシフトしていきます。
この設計の真価は、モデルが与えられたソースデータの品質を「超越」できる点にあります。自身の生成物を磨き上げることで、元のトレーニングデータに含まれていた不完全さを乗り越え、より安全で、より正確な、独創的な知性を形成していくのです。これは、AIが単なる「過去のデータの鏡」ではなく、自ら進化し続ける存在へと脱皮するための重要な鍵となるでしょう。
5. 結び:AIは「三つ子の魂百まで」を克服できるか?
「Self-Improving Pretraining」は、AI学習における「三つ子の魂百まで」――すなわち、初期段階の教育がいかにその後の生涯を決定づけるか――を技術的に証明しました。事前学習で染み付いた悪癖を後から力技で矯正する時代は、終わりを告げようとしています。
最初から完璧な信頼性を追求するこの新しいアプローチが主流になれば、私たちのAI開発体制は根本から再定義されるはずです。リリース後の修正に追われるのではなく、誕生の瞬間から、AIは私たちの倫理と事実に忠実なパートナーとして形作られることになります。
「AIの安全性と信頼性は、今後どこまで根源的に改善されうるのか?」
この問いに対する答えは、今まさに、事前学習という「知の源流」の中に書き込まれようとしています。
解説動画:
参考資料:
その他記事、コラム、書籍はこちら↓
