「1人で会議、1人で解決」— 複数AIの“集合知”を1つのモデルに封じ込める革新技術『AgentArk』

AIに複雑な問題を解かせたいとき、複数のAIエージェントを戦わせる「マルチエージェント・システム(MAS)」は非常に強力です。ディベートや批判、合意形成のプロセスを経ることで、論理的な誤りをあぶり出し、答えを極限までブラッシュアップできるからです。
しかし、実務において「推論時のオーバーヘッド」は最大の敵です。エージェントを増やせば増やすほど、計算コスト(推論時間やサーバー費用)は跳ね上がり、1つのAIの勘違いがグループ全体に毒を回す「誤りの連鎖(error propagation)」というリスクも孕んでいます。
「MASの知能は欲しいが、群れを管理するコストは払いたくない」。この究極のジレンマを解消するのが、革新的なフレームワーク『AgentArk』です。これは、マルチエージェントによる複雑な推論ダイナミクスを、たった1つのモデルの「重み」の中に封じ込め、推論時の負荷を「学習時」へと大胆に前倒しする技術。いわば、何千回もの議論を内面化した「1人の天才(Single-Model Genius)」を生み出すアプローチなのです。
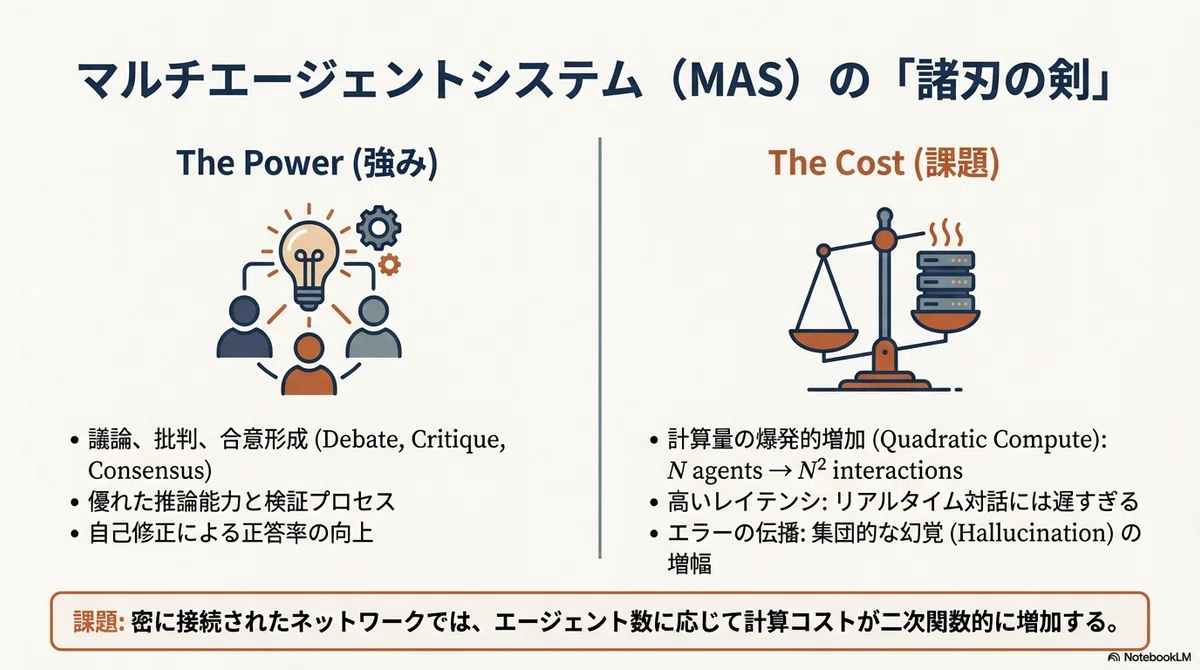
1. 衝撃の事実:重要なのは「構造」ではなく「推論のダイナミクス」だった
これまでMASの世界では、「誰が司会をし、誰が批判に回るか」といった組織図(トポロジー)の設計が肝だと信じられてきました。しかし、研究チームはこれまでの常識を覆す発見をしました。
実は、MASの真の価値は特定の連携プロトコルにあるのではなく、対話によって誘発される「思考の揺らぎや修正のプロセス」そのものにあったのです。研究資料では次のように指摘されています。
Kim et al. (2025b) demonstrate that removing or perturbing explicit agent structures leads to only marginal performance degradation, revealing that the essential contribution of MAS lies in the reasoning dynamics they induce, rather than in the interaction schema itself.(エージェントの明示的な構造を取り除いたり乱したりしても、性能低下はわずかであった。MASの本質的な貢献は、相互作用の形式ではなく、それによって引き起こされる推論のダイナミクスにあることが明らかになった。)
つまり、立派な「会議室(構造)」を外側に作るよりも、議論によって生まれる「思考の型」をモデルに内面化させる方が、賢さの本質に近づけるということです。AgentArkは、この「弁証法的な思考プロセス」を1つのモデルの知能へと変換します。
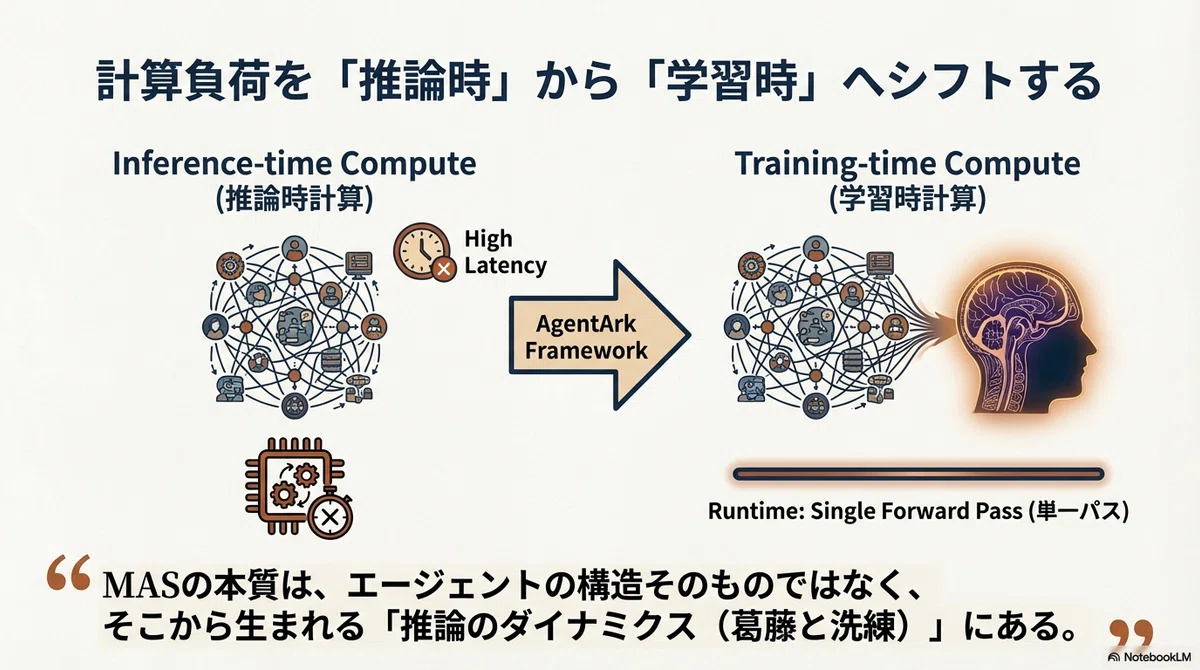
2. 「結果」ではなく「プロセス」を褒める:プロセス意識型蒸留(PAD)の威力
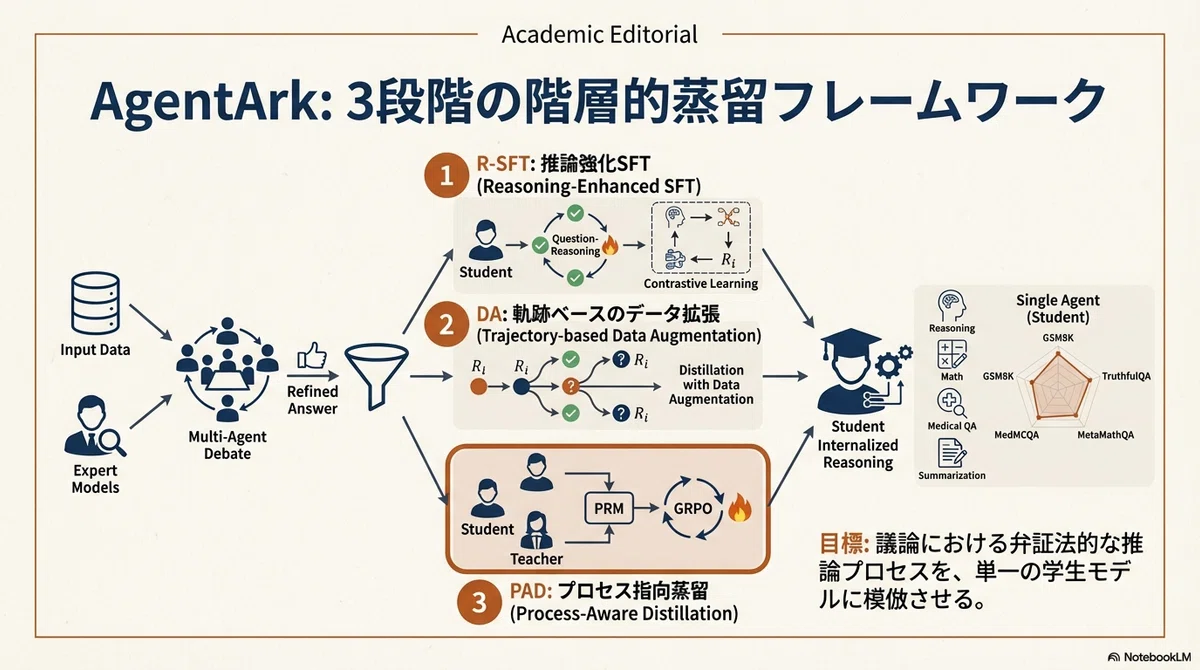
AgentArkの核となるのが、「プロセス意識型蒸留(Process-Aware Distillation: PAD)」です。これは、単に「正解」だけを教える教育とは一線を画す、「高信号なプロセス指導(High-Signal Supervision)」です。
多くのAI学習は「最終的な答え」というスパース(疎)な信号しか与えられませんが、PADでは推論の「一歩一歩(ステップ)」を厳密に評価します。
PRM(Process Reward Model)とGRPOの導入: AgentArkは、ステップごとに正誤を判定するPRMを用い、さらにGRPO(Group Relative Policy Optimization)という強化学習アルゴリズムで生徒モデルを鍛え上げます。これにより、モデルは「どの論理展開がより優れているか」をグループ内での相対評価で学びます。
「考え方のプロセス」を添削する教育: 「なぜその結論に至ったか」という思考の軌跡を添削されることで、モデルは「自己修正」や「エラーの特定」という高度な振る舞いを獲得します。
正解だけを丸暗記させるのではなく、弁証法的な「思考のダイナミクス」を内面化させることで、小さなモデルでも1回の推論(フォワードパス)の中で「脳内会議」を完結させることが可能になるのです。
3. 量は質を凌駕しない:エージェントを増やせばいいという誤解
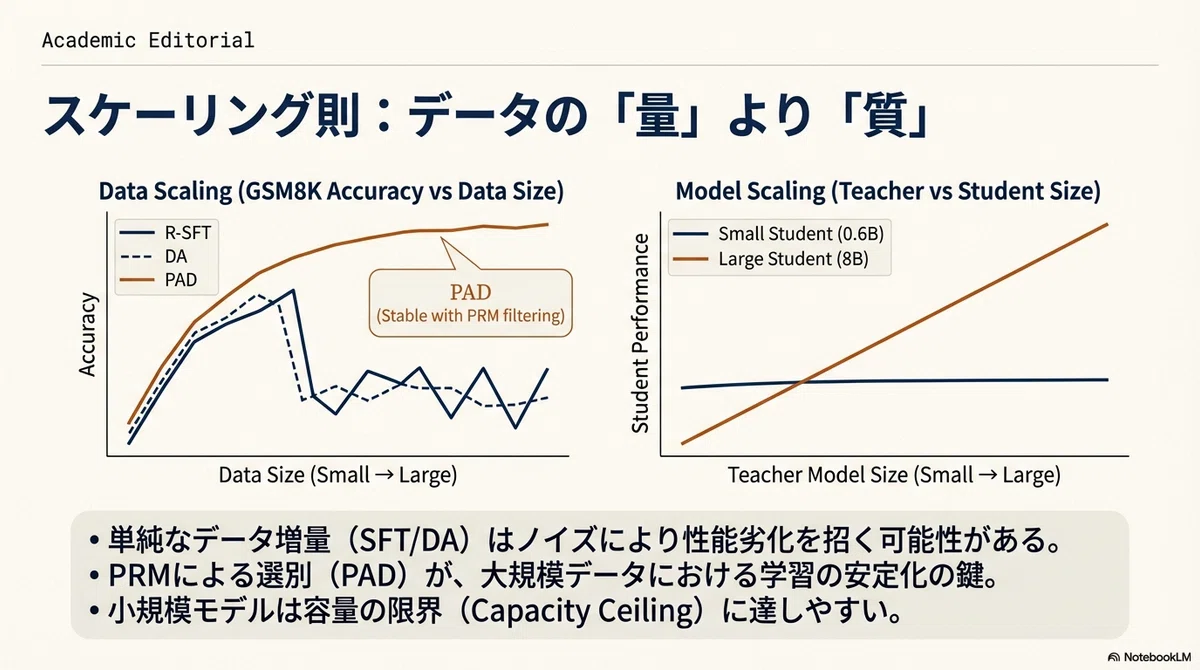
「教師役のエージェント数や学習データを増やせば増やすほどAIは賢くなる」という直感には、落とし穴がありました。研究では、生徒役となるモデルのキャパシティが、学習できる知能の限界(境界)を決定することが示されています。
特に、0.6B(6億パラメーター)のような超小型モデルの場合、教師エージェントを5人から20人へと増やしすぎると、かえって性能が停滞・低下する現象が確認されました。これは、小型モデルにとって複雑すぎる議論が「教師ノイズ」として機能してしまうためです。一方、8Bクラスのモデルであれば、より多様な議論から知能を吸収する余力を持っています。
研究チームが掲げる「Reasoning quality outweighs quantity(推論の質は量に勝る)」という言葉通り、ノイズの多い大量データよりも、PADによる高精度な推論トレースこそが、モデルを真に進化させる鍵なのです。
4. 数学から要約まで:学習した「思考法」は領域を超える
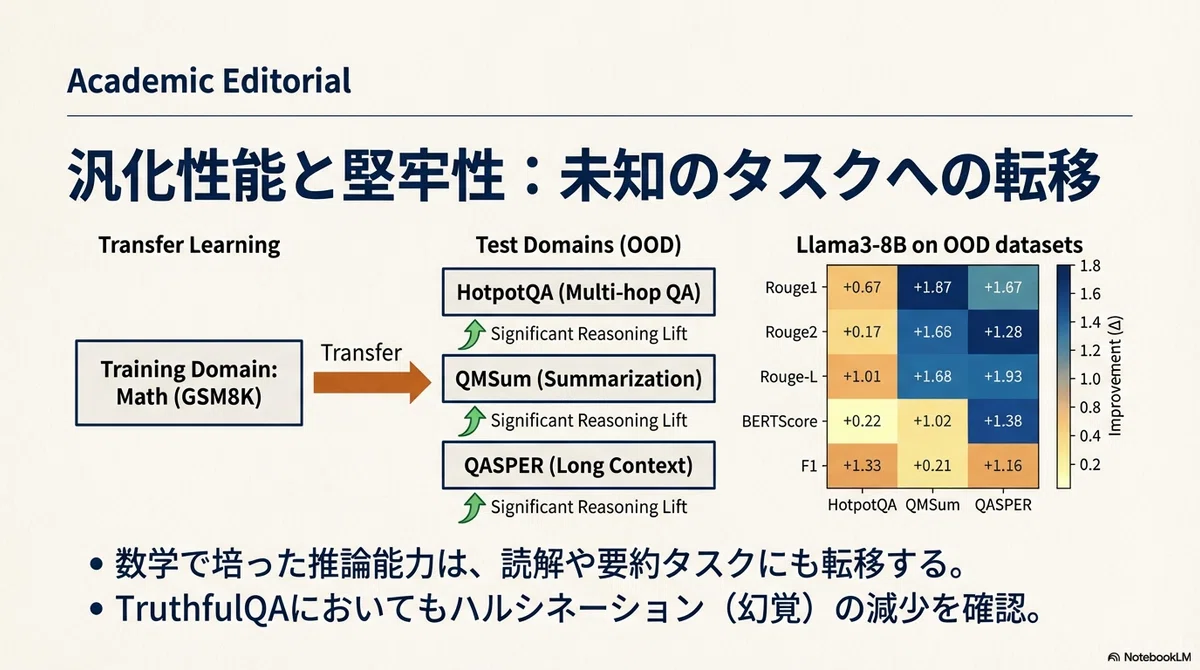
AgentArkで鍛えられたモデルは、特定の知識を覚えたわけではありません。複数の視点を持つ「思考の型」を習得したため、学習していない未知の領域(OOD: Out-of-Domain)でも圧倒的な能力を発揮します。
数学(GSM8K)で「論理的な考え方」を学んだモデルが、多ホップ質問回答(HotpotQA)や会議要約(QMSum)でも性能を向上させただけでなく、その推論パターンはマルチモーダルLLM(MLLM)への転移可能性さえ示唆されています。テキストで学んだ「推論の型」が、視覚情報の処理にも流用できるのです。
表(Quantitative evaluation of reasoning quality)のデータが、その「質の向上」を証明しています:
予測の安定性: 推論トークンの予測のしやすさを示すPerplexity(PPL)が、1.92から1.63へと大幅に改善。
論理の密度: 平均負の対数尤度(Avg NLL)が0.65から0.40へと低下。
思考の解像度: ステップ分解能力、中間検証能力、エラー特定能力のすべての定量的スコアがベースラインを上回る。
これは、モデルがより「予測可能で一貫した」論理展開を手に入れたことを示しています。
結論:AIの「内面化」が切り開く効率的な未来
AgentArkは、これまで推論時に消費していた膨大な計算リソースを、学習時の重みへとシフトさせました。これにより、かつて重厚なマルチエージェント・システムでしか到達できなかった知能を、軽量・高速なシングルモデル(SLM)で再現できる時代が到来したのです。
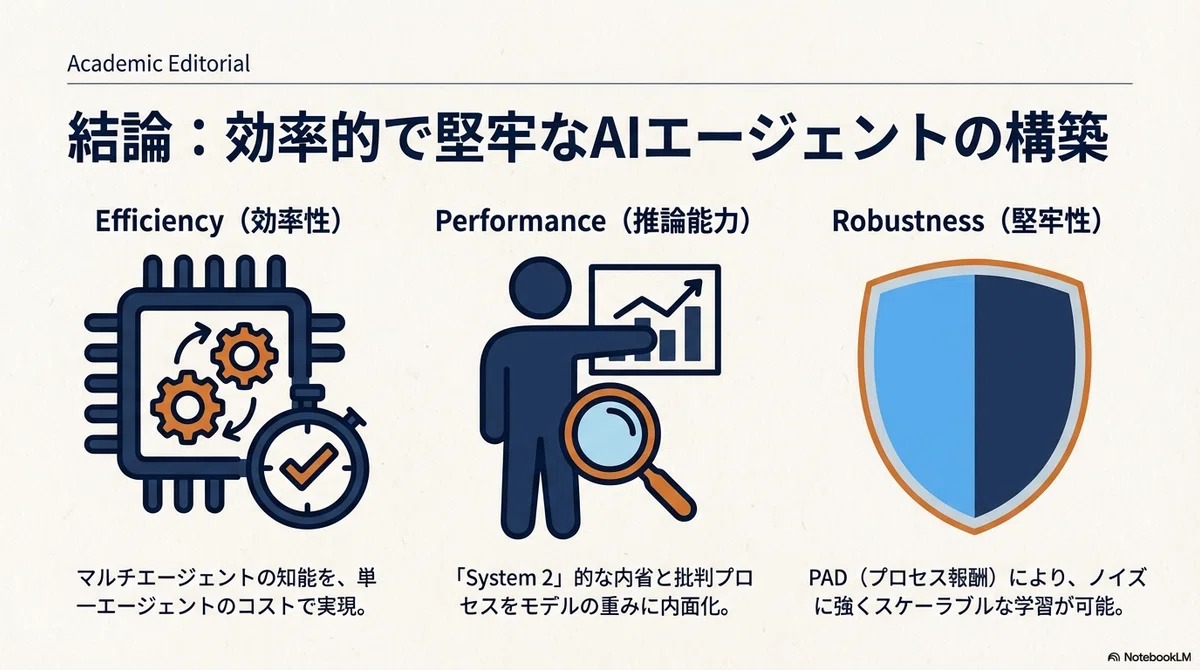
私たちはもはや、エージェントの群れを管理し、何秒も推論を待つ必要はありません。知能は組織という外側の形式から、モデルの内側にある「思考の型」へと移行しました。
もしAIがたった1人で、迷い、疑い、そして自己修正する「脳内会議」を完璧にこなせるようになったら。あなたなら、その余った計算リソースを次に何を解き明かすために使いますか?
解説動画:
参考資料:
その他記事、コラム、書籍はこちら↓
