AI設計の常識を覆す。Googleが提唱する新パラダイム「ネスト学習」がもたらす4つの衝撃

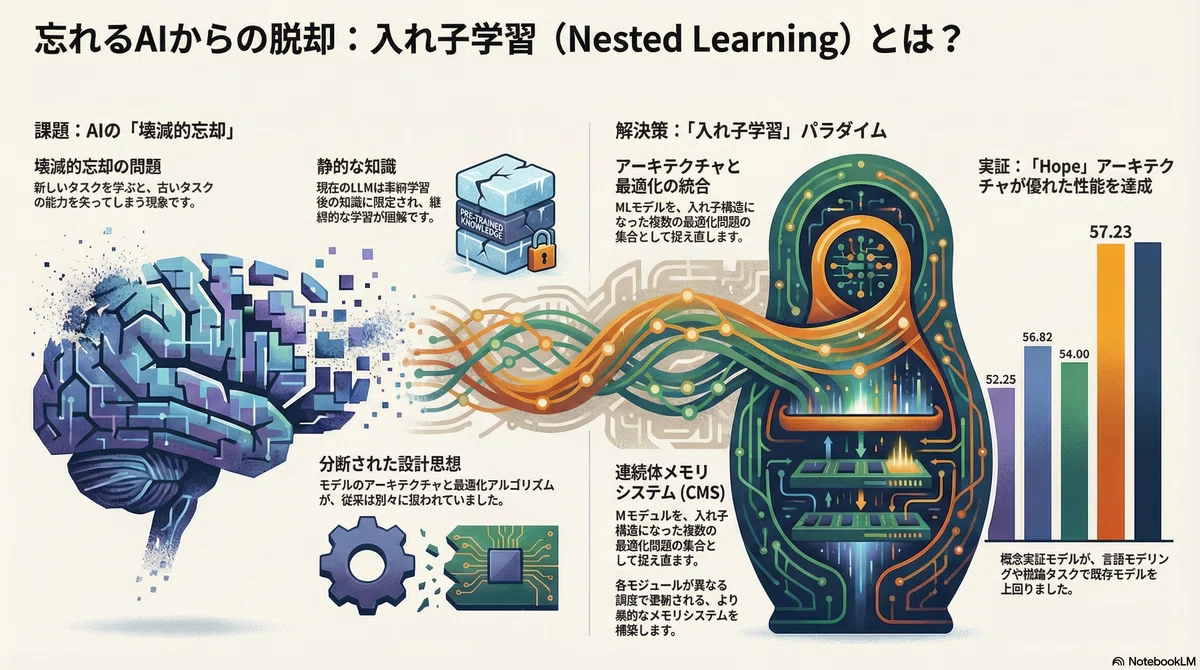
近年の大規模言語モデル(LLM)の目覚ましい発展にもかかわらず、その根底には「壊滅的忘却」という大きな課題が存在します。これは、AIが新しいスキルを学ぶと、古いスキルを忘れてしまうという問題です。
この限界は、人間の記憶障害である「前向性健忘」に例えることができます。脳は新しい長期記憶を形成するために、まず短期記憶を「オンライン」で素早く固定化し(シナプス固定)、その後「オフライン」で時間をかけて大脳皮質に転送・整理します(システム固定)。
現在のLLMは、この最初のオンライン固定プロセスが欠けているため、知識が入力された直近の文脈か、あるいは事前学習で得た静的な情報に限定されてしまうのです。
この根本的な課題を解決するため、Google Researchは人間の脳が継続的に学習する能力から着想を得た、新しいパラダイム「ネスト学習(Nested Learning)」を発表しました。
1. 「アーキテクチャ」と「最適化」は同じものだった
ネスト学習が提示する最も核心的で、直感に反するアイデアは、「モデルのアーキテクチャ(ネットワーク構造)」と「最適化アルゴリズム(学習ルール)」を本質的に同じ概念として扱うことです。
従来のAI開発では、これらは完全に別のものとして設計されてきました。しかしネスト学習は、単一の機械学習モデルを、相互接続された多層的な学習問題のシステムと見なすことで、このギャップを埋めます。このパラダイムを支えるのが「更新頻度」という概念です。各コンポーネントがどれくらいの頻度で更新されるかに基づいて階層(レベル)を定義することで、アーキテクチャと最適化は、異なる速度で動作する学習問題の集合として統一的に捉えることができます。
この視点により、AI設計に「これまで見えなかった新たな次元」がもたらされ、より高性能なAIを構築する道が開かれます。
2. 隠された記憶装置:オプティマイザの真の役割
ネスト学習は、これまで学習を効率化するツールとしか見なされていなかったオプティマイザに、驚くべき新たな視点を提供します。広く使われているAdamやモーメンタム付きSGDといったオプティマイザは、実は「連想記憶モジュール」であるというのです。
この観点から見ると、学習プロセスは、モデルがデータポイントとそのデータがもたらす「驚き」を結びつける記憶の獲得プロセスと再定義できます。具体的には、勾配降下法の更新ルールは、データポイント(xt)を「局所的な驚き信号(Local Surprise Signal: LSS)」に対応付ける最適化問題として数学的に再定式化できます。このLSSとは、「現在のモデル出力と、学習目的が強制する構造との間の不一致を定量化する信号」です。
このパラダイムを理解する上で、記憶と学習の区別が重要になります。研究論文が指摘するように、神経心理学ではこの2つは明確に区別されています。
記憶とは入力によって引き起こされる神経の更新であり、学習とは効果的で有用な記憶を獲得するプロセスである。
3. 「短期・長期記憶」から「連続的メモリシステム」へ
ネスト学習は、AIにおける従来の記憶の捉え方を拡張し、より生物学的に妥当なモデルを提案します。
標準的なTransformerモデルでは、シーケンスモデルが短期記憶(直近の文脈を保持)として機能し、フィードフォワードネットワークが長期記憶(事前学習された知識を保存)の役割を担っています。
これに対し、ネスト学習は「連続的メモリシステム(Continuum Memory System: CMS)」という新しい概念を導入します。これは、先に述べた「更新頻度」という考え方を応用したものです。CMSでは、記憶はそれぞれ異なる頻度で更新されるモジュールのスペクトラム(連続体)として扱われます。これにより、モデルは「異なる抽象度とタイムスケール」でデータを処理できるようになり、継続的な学習に対して、よりリッチで効果的なメモリシステムが構築されるのです。
4. 新アーキテクチャ「Hope」が示す可能性
ネスト学習の原理を用いて設計された概念実証アーキテクチャが「Hope」です。Hopeは、既存の「Titansアーキテクチャ」の派生形であり、CMSブロックで拡張された「自己修正型」のリカレントアーキテクチャです。ここで言う「自己修正型」とは、モデルが「自身の更新アルゴリズムを学習する」能力を持つことを意味します。
その性能は、既存モデルに対して高い競争力を持つ可能性を示しています。
言語モデリングと常識推論タスクにおいて、Hopeは様々なスケールで高い競争力を示し、標準的なTransformerや他の最新リカレントモデルをしばしば上回る性能を達成しました。
長文脈の検索タスク(Needle-In-Haystack)において、Hopeは優れたメモリ管理能力を発揮し、CMSが長い情報系列を扱う上でより効率的かつ効果的であることを証明しました。
まとめ:自己改善するAIへの新たな一歩
ネスト学習パラダイムは、AIの「アーキテクチャ」と「最適化」を、異なる更新頻度を持つ階層的な記憶モジュールとして統一的に扱うことで、AI研究における大きな前進を示しています。
このアプローチは、単にタスクを実行するだけでなく、人間の脳のように経験を能動的に統合・整理するモデルの設計図を提供します。現在のLLMが抱える「忘却」という性質と、人間の脳が持つ驚異的な「継続的学習能力」との間のギャップを埋めるための、堅牢な基盤となるでしょう。ネスト学習は、AIが自ら学び、改善し続ける未来への、新たな一歩なのです。
解説動画:
参考資料:
その他記事、コラム、書籍はこちら↓
