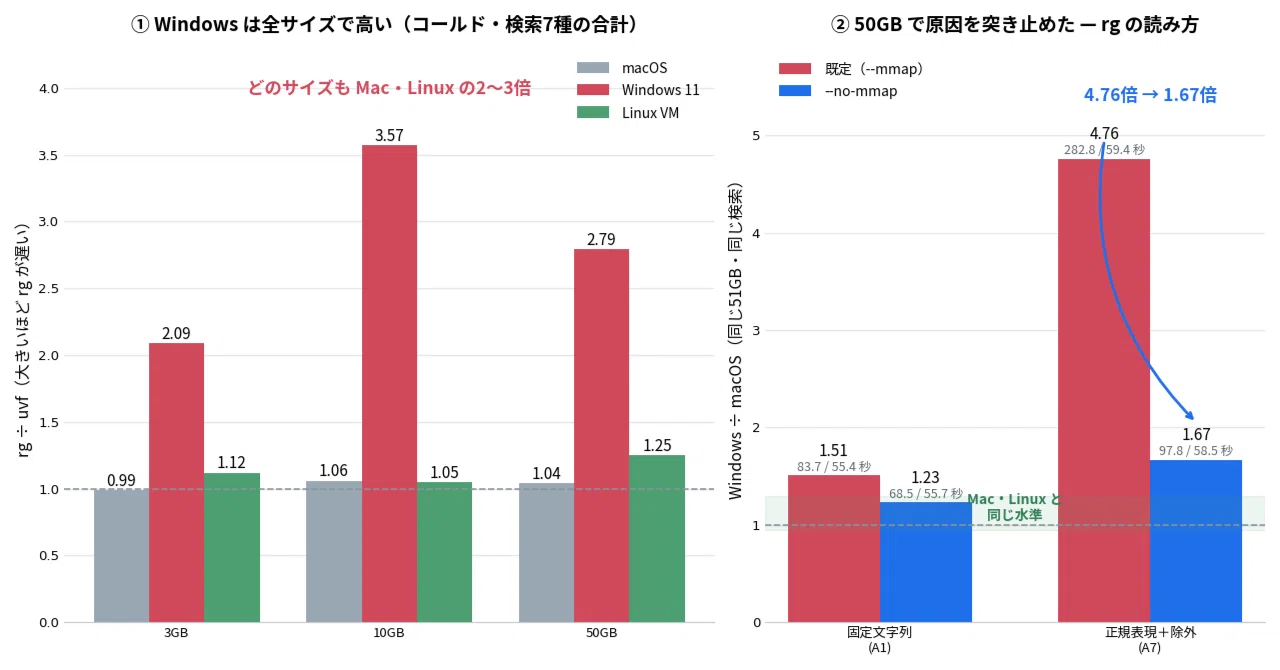
ripgrepはno-mmapで2.9倍速くなる。既定のmmap読みと50GB・3OSで比べた

51GBのファイルをripgrepで検索するとき、--no-mmapというオプションを付けると速くなることがあります。Windowsで最大2.89倍。Macでは何も変わりません。Linuxでは、検索の中身によって速くも遅くもなりました。
これはripgrepの欠陥の話ではありません。既定のメモリマップ読みは、たいていの場合いちばん良い選択です。ただ「たいてい」であって、いつでもではなかった、という話です。
もともとは自分が作っているCLI(uvf)をripgrepと比べていました。3GB・10GB・50GBをMac・Windows・Linuxで測っていて、Windowsの50GBだけが妙だったのです。7種類の検索を掛けた合計で、ripgrep/uvfの性能比を見ると、WindowsとMacの比は3GBが1.09倍、10GBが1.45倍。機械の差として自然な範囲です。ところが50GBだけ2.25倍に跳ね上がる(急にuvfの性能が2倍以上になる)。内訳を見ると、正規表現で「当てはまらない行」を出す項目が283秒で、Macの58秒に対して4.9倍でした。サイズが上がるほど比が悪化する理由はないので、切り分けの計測を書きました。
疑ったのは順に、ファイルの置き場所、断片化、CPUの熱だれです。全部違いました。ツールを通さずに同じ3GiBを読むと、51GBファイルの先頭で1159MB/s、中間で1134、末尾で1168。きれいに揃っています。クロックも開始前と終了後で2803MHzのまま、5回まわしても落ちません。残ったのが読み方でした。--no-mmapを付けた瞬間、282.84秒が97.83秒になりました。
同じ条件で3つのOSを測ると、答えが3通りに割れます。Windowsは固定文字列で1.22倍、正規表現+除外で2.89倍、--no-mmap のほうが速い。Macはどちらも変わりません。Linuxは逆で、固定文字列では1.2倍遅くなり、正規表現+除外では1.64倍速くなりました。6通りのうち3つで速くなり、2つで変わらず、1つで遅くなったことになります。
理由は推測です。メモリマップはファイルをメモリのように見せる仕組みで、ファイルが収まっていればコピーが1回減るぶん効率的です。51GBはWindows機の15.6GBにもMacの32GBにも収まらないので、読んでいるあいだずっとページを入れては捨てを繰り返す。その代償がOSによって違うのだろう、というのが今の見立てです。ただしLinuxが軽い検索と重い検索で逆転する理由は、きれいに説明できていません。
実用の指針としては、Windowsで10GBを超える1本のファイルをripgrepで検索するなら、--no-mmapを一度試す価値があります。付けるのは1語で、損はしません。Macでは何もしなくて構いません。Linuxでは重い検索のときだけ。繰り返しますが、ripgrepを責める話ではなく、今回の条件が「メモリに収まらない1本のファイル」という端のほうの使い方だった、ということです。
自分の道具の話も正直に書いておくと、私のuvfはメモリマップを使わず順番に読むだけなので、3つの環境で同じように動きます。当たり外れがありません。ただ裏を返すと、Linuxでは軽い検索でmmapのほうが速いのに、それを使っていない。速度が残っているということです。いまは3環境で挙動が揃っていることを優先していますが、宿題として残っています。
自分で試すなら2行です。同じファイルにrg --mmapとrg --no-mmapを、あいだにキャッシュを捨てて掛けるだけ。キャッシュを捨てずに測ると2回目が速く出るだけで何も分かりません。そして出力の行数が両方で一致することを確かめてください。違っていたら、測り方が違っています。
くわしい表と条件はブログに置きました。
https://uvp.y42u.net/blog/uvp-rg-no-mmap-50gb/
おまけ:1本の巨大ファイルを探して、当たりをそのまま画面で読むなら、
無料の UwView(uvf)もどうぞ。

Macの場合:
brew install --cask amru195704/uwview/uwview

Windowsの場合:
scoop bucket add uwview https://github.com/amru195704/scoop-uwview
scoop install uwview