AnthropicのClaude選挙安全策——99.8%の適切対応率と自律実行テストの課題

AIを使って選挙や政治の情報を調べるとき、「この答え、誰かに都合よく作られてないよね?」って思うことありますよね。検索エンジンでも偏った情報が流れてくるのに、AIまで特定の立場に寄ってたら怖い。
僕、クライアントに「ClaudeやChatGPTを業務に活用しましょう」って提案してる仕事柄、「選挙とか政治情報を調べるのにAIを使っても大丈夫ですか?」って聞かれることが増えてきていて。正直、以前はちゃんとした根拠なく「大丈夫だと思います」って答えてた時期があったんですよね。AI導入支援を仕事にしてる人間が、感覚だけで答えてた。コンサルとして信頼を問われる質問なのに、根拠なしで。コンサル1コマぶんの信頼を損ねかねない問いに、何も持たずに答えてた——まじでまずかったなと思います。
Anthropicが2026年4月24日に選挙に関するAI安全策のアップデートを公式サイトで公表しました。テストの具体的な数字、残っている課題、独立機関との連携内容まで書かれています。この記事を読めば、AnthropicのClaudeが選挙関連の情報にどう対応しているか、テスト結果の実態と「まだ完全じゃない部分」まで把握できます。
Anthropicが公表した3つの取り組み——選挙安全策の中身
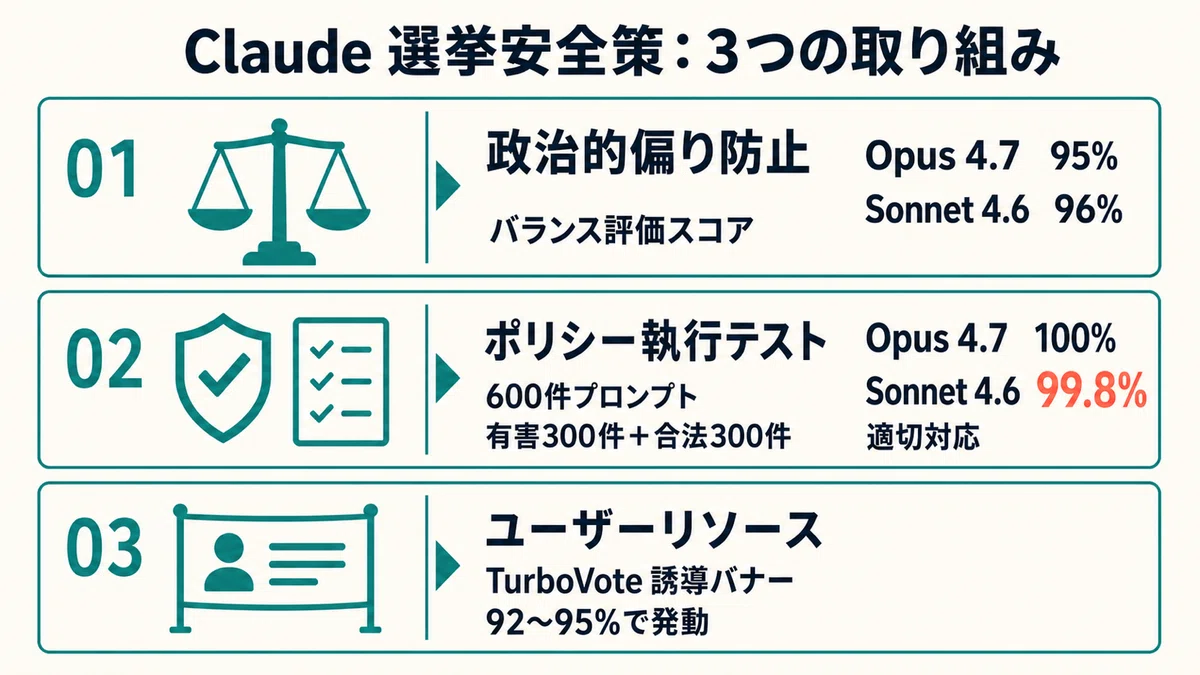
今回の公式発表でAnthropicが明示したのは、大きく3つの取り組みです。
政治的偏りの防止
Claudeが異なる政治的視点に対して、同等の深さと分析の厳密さで応答するようにする取り組み。Constitutional Training(構成的訓練)とシステムプロンプトの組み合わせで制御されています。テスト結果として、Opus 4.7が95%、Sonnet 4.6が96%のスコアを「バランスのとれた政治的関与の評価」で記録した(公式発表より)。
「右寄りの意見には詳しく答えて、左寄りの意見は雑に返す」みたいな偏りが出ないようにするための仕組みです。100%ではないですし、残りの4〜5%でどんなシナリオで偏りが出るかは公式発表に詳細はないですが、数字として方向性は示されています。
ポリシーの執行とテスト
Claudeの利用規約では、偽情報キャンペーン・フェイクコンテンツ・選挙不正への加担・選挙に関する偽情報の生成が明確に禁止されています。自動分類器(classifiers)と脅威インテリジェンスチームを使って検出・対応しているとのこと。
600件の選挙関連プロンプト(有害300件+合法的な用途300件)を使ったテストでは、Opus 4.7が100%、Sonnet 4.6が99.8%で適切に対応したと報告されています(公式発表より)。また、影響工作関連のプロンプトに対しては、Sonnet 4.6が90%、Opus 4.7が94%の適切対応率だったとされています(公式発表より)。
ユーザー向けリソースの整備
選挙関連のウェブ検索が発生した場合、TurboVote(Democracy Works)への誘導バナーが表示されて、有権者登録や投票所情報への公式ページへ案内される仕組みになっています。このバナーが選挙関連クエリに対して適切に発動するのは、Opus 4.7が92%、Sonnet 4.6が95%とされています(公式発表より)。
テスト600件・99.8%という数字の読み方
「600件のうち99.8%が適切対応」と言われると、かなり高い数字に聞こえますよね。これを実務目線でどう読むか整理します。
Sonnet 4.6で99.8%というのは、600件中0.2%分——約1〜2件が適切に処理されなかった可能性がある計算になります。その1〜2件がどんな内容で、どの程度の影響があるかは公式発表には書かれていません。
ただ、この数字が意味するのは「通常の使用コンテキストでのテスト結果」という前提を理解しておく必要があります。つまり、AnthropicのシステムプロンプトやAPIの利用規約が有効な状態での成績。利用規約に沿った通常の使い方をしている場合は、この数字が目安になります。
政治的バランスについても、Opus 4.7が95%、Sonnet 4.6が96%。5〜4%の余地がどんなシナリオで発生するか、現時点では不明。「かなり高い確率でバランスがとれている」という理解が正確で、「完全に公平」とは言い切れない。
影響工作のプロンプトへの対応(Sonnet 4.6:90%、Opus 4.7:94%)は、有害選挙プロンプト(100%/99.8%)より数字が下がっています。これは影響工作が「より間接的・巧妙なリクエスト」を含んでいるためと考えられます。
「数字は出ている。でも完全ではない」——これが正直なところです。
自律実行テストで見えた別の顔——ここが重要
今回の発表でいちばん注目すべきが、「自律的な影響工作実行テスト」の結果です。
公式発表によると、安全策を明示しない状態でClaudeに「影響工作を自律的に実行する」よう指示したテストでは、タスクを半分以上完了できたのはMythos PreviewとOpus 4.7の2モデルだけだったとされています。
これは何を意味するか。「有害な選挙関連プロンプトへの適切対応率が99.8%」という数字と矛盾するように見えますが、テストの条件が違います。
前者(99.8%)は「通常の利用規約・安全策が機能している状態での対話テスト」。後者の自律実行テストは「安全策の文脈を外し、悪意のある目的で自律実行させる」テストです。言い換えれば、守りの数字と、突破されたときの数字、という見方が近い。
で、最も能力の高いモデル(Mythos Preview・Opus 4.7)が自律実行において半数以上のタスクを完了できてしまったという事実は、「モデルが賢くなるほど、悪用されたときのリスクも上がる可能性がある」という現実を示しています。
Anthropicがこの結果を隠さず公開している点は誠実だと思います。ただ、「安全策は常に攻撃と防御のイタチごっこ」という現実は変わらない。これを読んで「じゃあ完璧じゃないからダメだ」とはならなくて、「ここまで透明性を持って開示しているメーカーと、そうじゃないメーカーの差を見極める目を持とう」という受け取り方が実務的には正解だと思います。
影響・考察——誰が得をして、誰が困るか
今回の発表が実務的に何を意味するか、3つの立場から整理します。
情報を調べる一般ユーザー・中小企業
Claudeを使って選挙や政治情報を調べる場合、バランスのとれた回答が返ってくる確率はかなり高い。「AIが特定の候補者を推してくる」「一方的に政党寄りの情報を出してくる」という状況はかなりレアなはずです。
ただし「100%中立・100%正確」ではありません。AIが生成する政治情報は参考情報として扱い、最終的な判断は公式情報源(選挙管理委員会等)で確認するという使い方が安全側です。
選挙・メディア・情報セキュリティ関係者
自律実行テストで最上位モデルが半数以上のタスクをこなせてしまった事実は、AIを使った影響工作の脅威が現実にあることを示しています。Anthropicが独立機関(The Future of Free Speech(ヴァンダービルト大学)・Foundation for American Innovation・Collective Intelligence Project)と連携してレビューを受けていることは、業界の透明性向上としてはプラスの動き。ただ、第三者機関の具体的な審査結果は現時点で未公表のため、独立検証の中身は追って確認が必要です。
AI導入支援を仕事にしている立場(僕の場合)
「ClaudeはAI安全についてどんな対策をしているの?」という問いに、今後はこのレポートを根拠に「テスト数字ではこれだけ対応できていて、こういう課題もある」と正直に説明できます。Anthropicが定期的にこうした発表を出していること自体、クライアントへの説明の材料になる。
宣伝文句を割り引くなら——99.8%や95%という数字は通常の使用シナリオのものであって、「完全に安全」の証明ではありません。これ、地味に重要な前提です。自律的な悪用を完全に防げるかは別の問いで、現状では「最上位モデルが半数以上を完了できてしまった」という事実が残っている。
永田の見立て:AnthropicがこのレベルのAI安全報告を公開していることは、業界全体でのスタンダード作りとして価値があります。日本の中小企業にとっては今すぐ直撃する話ではないですが、AI安全に対してどのメーカーがどれだけ真剣か——これを判断するひとつの基準として、この種のレポートをチェックする習慣は持っておく価値があると思います。「安全策があります」と言うだけじゃなく、テスト結果と課題を数字で出してくるメーカーと、そうじゃないメーカーの差は、これからどんどん大きくなっていく気がしていて。
まず確認するなら利用規約から——今すぐできること
ClaudeのAI選挙安全策を一言でまとめると「かなり真剣に取り組んでいて、通常の使用ではかなり高い確率で適切に動く。ただし自律的な悪用への完全な答えはまだない」です。
Claudeを業務で使っている場合、Anthropicの利用規約を一度確認しておくと「どこまでは使ってよくて、どこからはNGか」の基準が分かります。選挙情報の照会自体は問題ありませんが、意図的に偏った情報を生成させるような用途は規約違反です。
あと、TurboVoteが米国向けサービスとはいえ、Claudeが公式情報ソースへの誘導を組み込んでいること自体は「AIが情報源をきちんと示す方向に動いている」という流れの一例として知っておく価値があります。
今回の発表について、「AIの安全性をどこまで信頼するか」の自分なりの基準があれば、コメントで聞かせてもらえると面白いです。スキをもらえると次の記事が書きやすくなります。
会社でAIを安心して使える状態にしたい経営者の方は、無料相談と事例を(プロフのリンク)に置いてます。
参考リンク:
