AIフロンティアモデルニュース 202609-01

GPT-6 Astraが登場、Claude Fable 5.1とGemini 3.8 Flashも公開
2026年8月30日から9月5日までに公式発表・提供された、汎用フロンティアモデルと基盤モデルの主要な動向をまとめます。
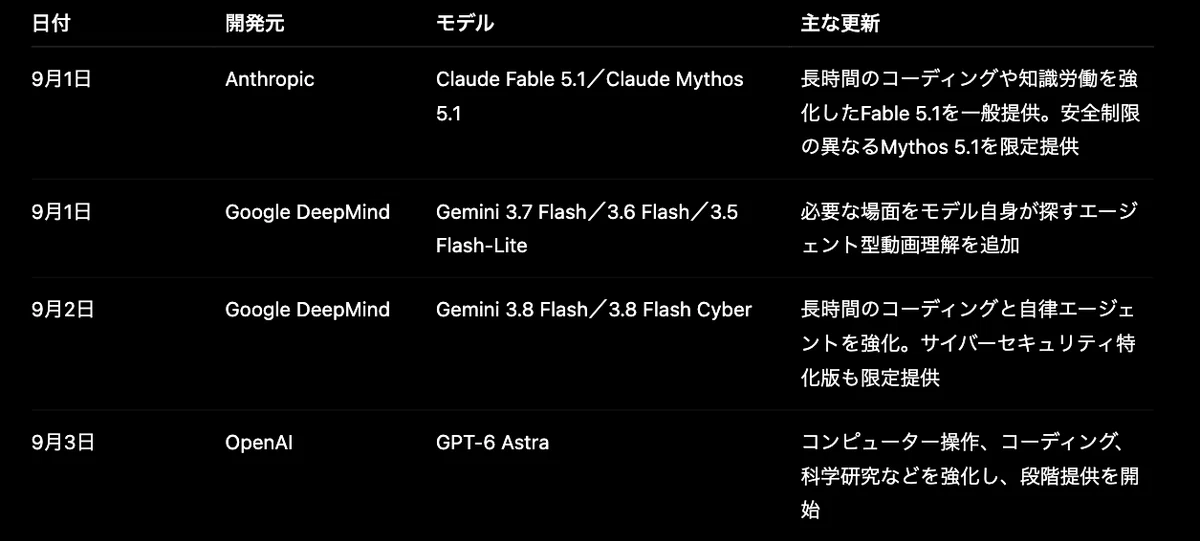
9月1日|Anthropic、Claude Fable 5.1とClaude Mythos 5.1を公開
Anthropicは、長時間のコーディングや調査、複雑な知識労働を重視したClaude Fable 5.1を公開しました。
同時に発表されたClaude Mythos 5.1は同じ基盤モデルを使用していますが、サイバーセキュリティと生命科学の専門業務に合わせて安全制限を調整したモデルです。
Fable 5.1はPro、Max、Team、Enterpriseの各プランとAPIで利用できます。Mythos 5.1の利用対象は審査を通過した一部の組織に限られ、現時点では主に米国で提供されています。一般の日本ユーザーがモデル一覧から自由に選べるものではありません。
開発元の評価では、科学研究を端末上で進める「Terminal-Bench-Science 0.1」でFable 5.1が52.6%を記録しました。
前版のFable 5はAnthropicの実行環境で24.7%でした。エージェント型コーディングを評価する「Terminal-Bench 4.0」ではFable 5.1が55.8%、安全制限の異なるMythos 5.1が60.9%となっています。
ただし、Terminal-Bench-Science 0.1には、モデルごとに±3.5~4.5ポイントの標準誤差があります。Terminal-Bench 4.0の得点差にも、安全機構が一部の課題へ介入した影響が含まれます。これらの数字だけで他社モデルとの総合的な優劣を決めるのは適切ではありません。
APIのモデルIDは「claude-fable-5-1」です。コンテキスト長は100万トークン、最大出力は12万8,000トークン。料金は100万トークン当たり入力10ドル、出力50ドルでFable 5から据え置かれました。
大きく変わったのはキャッシュ読み出しの料金です。従来から75%引き下げられ、100万トークン当たり0.25ドルになりました。
Anthropicは2026年8月の4週間にわたる実利用を基に、一般的な処理では総費用が約25%、コンテキストやツールを多用するエージェント処理では最大約45%下がると試算しています。すべての呼び出しに一律で適用される削減率ではありません。キャッシュ読み出しが費用全体に占める割合によって効果は変わります。
Fable 5.1はClaude APIのほか、Amazon Web Services、Google Cloud、Microsoft Azureで提供されています。Microsoftの環境では、Azure上で提供されるMicrosoft Foundryのモデルカタログから利用できます。
安全対策も見直されました。Fable 5.1では、ソースコードから脆弱性を発見する防御目的の作業が認められています。Anthropicによると、Claude Codeでサイバー関連の安全機構が介入する回数はFable 5より平均約60%減る見込みです。
侵入テストや攻撃コードの生成、バイナリを対象とした脆弱性探索などは、引き続き別モデルへ振り分けられる場合があります。性能を高めるだけでなく、どの能力を誰に開放するかまでモデル仕様の一部になった更新です。(www.anthropic.com)
Anthropic公式発表
Claude Platformモデル仕様
9月1日|Google、Geminiにエージェント型動画理解を追加
Google DeepMindは、Gemini 3.7 Flash、3.6 Flash、3.5 Flash-Liteへ「エージェント型動画理解」を追加しました。
動画を生成する機能ではありません。長い動画の中から回答に必要な場面をモデル自身が探し、詳しく調べるための機能です。
従来の動画解析では、一定のフレームレートで映像全体を読み込む方法が中心でした。
新機能では質問の内容に応じて必要な区間を探し、映像のフレーム、音声、文字起こしのどれを確認するかモデルが判断します。短い動きを高いフレームレートで見直したり、数時間の動画から特定の場面だけを探したりすることも可能です。
Googleの標準ベンチマーク評価では、従来の静的な読み込みと比べてトークン消費を最大88%、解析費用を最大66%削減し、正解率を最大7%改善しました。いずれも課題とモデルの組み合わせによる最大値であり、すべての動画で同じ効果が得られるわけではありません。
動画ファイルとYouTube動画に対応し、Gemini APIのGoogle AI StudioとGemini Enterprise Agent Platformで提供されています。
API設定で処理方式を「agentic」にすると有効になります。機能自体に追加料金はなく、選択したGeminiモデルの通常のトークン料金が適用されます。
長い動画をすべて同じ密度で読み込ませるのではなく、必要な場面をモデル自身に探させる。会議録や講義、監視映像、編集素材などを扱う開発者にとって、動画解析の費用と精度を両立させる新しい選択肢になりそうです。(blog.google)
9月2日|Google、Gemini 3.8 Flashと3.8 Flash Cyberを発表
Google DeepMindはGemini 3.8 Flashを公開しました。
3週間前に登場した3.7 Flashを基に、ソフトウェア開発や複数段階の推論、長時間動く自律エージェントを強化したモデルです。
Googleは「HLE-Verified」で54.9%を記録したと公表しています。長期のソフトウェア開発能力を測る「DeepSWE v1.1」でも、多くの大型フロンティアモデルを上回ったと説明しています。
性能向上の背景には、難しい課題に対して推論を増やし、ツールを繰り返し呼び出す設計があります。
高いeffort設定ではトークン消費が増える場合があるため、速度区分や100万トークン当たりの単価が同じでも、一つの仕事を完了するまでの総額まで同じとは限りません。
費用を優先する処理ではeffortを下げるか、効率重視の用途向けに継続提供される3.7 Flashを選ぶ余地があります。
APIの導入価格は100万トークン当たり入力0.75ドル、思考トークンを含む出力3.75ドルです。この価格は2026年12月31日までで、2027年1月1日から入力1.50ドル、出力7.50ドルへ変更されます。
開発者はGemini API、Google AI Studio、Android Studio、Google Antigravityなどから利用でき、企業向けにはGemini Enterpriseでも提供されます。
一般利用ではGoogle AI ProとUltraの契約者を対象に、Geminiアプリ、Google検索のAI Mode、Google Sheetsで提供されます。
同時発表のGemini 3.8 Flash Cyberは、脆弱性の発見と修正に重点を置いた派生モデルです。
外部評価の「CWE-Bench」では修正成功率47.2%を記録し、比較対象となった先行フロンティアモデルの47.8%に近い結果を出しました。
Google社内で実施した20種類のプログラミング言語を対象とする脆弱性発見評価では、成功率が70%を超えたとしています。
ただし、こちらは詳細が公開されていない社内ベンチマークです。
Cyber版は一般APIで公開されていません。政府機関や重要インフラ運営者、ソフトウェア保守者などの信頼された防御担当者を対象とする「Fairwind Program」を通じて限定提供されます。通常版と同じ感覚で誰でも利用できるモデルではありません。(blog.google)
9月3日|OpenAI、GPT-6 Astraの段階提供を開始
OpenAIはGPT-6 Astraを発表しました。
コンピューター操作やブラウザー利用、コーディング、科学研究、専門業務を横断し、長い作業を最後まで進めることを重視した最上位モデルです。
公式評価では、オフライン環境で実施する「OSWorld 2.0」で72.6%を記録しました。GPT-5.6 Solは65.7%です。
シミュレーション上の1課題当たりの所要時間はAstraが約40分、Solが約75分とされています。
「Terminal-Bench 4.0」ではAstraが57.9%、Claude Fable 5.1が55.8%でした。
ところが「Artificial Analysis Intelligence Index v4.1.1」ではAstraが61.2、Fable 5.1が65.7となり、順位が逆転しています。
評価軸によって結果が変わるため「すべての用途で最も高性能」と単純化することはできません。
OpenAIの比較表には社内評価や、各社で実行条件の異なる数値も含まれています。
APIのモデルIDは「gpt-6-astra」です。コンテキスト長は105万トークン、最大出力は12万8,000トークン。標準料金は100万トークン当たり入力10ドル、キャッシュ済み入力1ドル、出力50ドルです。
入力が27万2,000トークンを超えるリクエストでは、そのリクエスト全体に長文料金が適用されます。
入力とキャッシュ関連料金は通常の2倍、出力料金は1.5倍です。大量の文書やコードベースを一度に渡す場合は、コンテキストの上限だけでなく、この料金境界も確認する必要があります。
提供は一部の組織から始まり、数日かけてChatGPT Plus、Pro、Business、Enterprise、OpenAI API、Microsoft Azure、AWS Bedrockへ拡大されます。Enterpriseでは管理者が有効にするまで初期状態でオフです。Pro、Business、Enterpriseには、より多くの計算量を使うGPT-6 Astra Proも提供されます。
Astraは、OpenAIのPreparedness Frameworkで初めてサイバー能力が「Critical」に達したと判定されたモデルでもあります。
適切なツールと権限があれば、人間が各工程を指示しなくても未知の脆弱性を発見し、堅牢なシステムへの攻撃手段を開発できる水準だと評価されています。
OpenAIは危険な依頼を拒否する訓練を強化し、モデルの推論や操作を監視して不正な行動を停止する仕組みを導入しました。
高度なサイバー機能は少数のテスターから開放し、防御目的の利用についてはDaybreak Blueを通じて段階的に広げる方針です。
安全機構が正当な作業を一時停止させる可能性もあります。ChatGPTやCodexでは確認を求められる場合があり、APIでは処理が停止します。能力が上がった分だけ、利用者が自由に使える範囲も慎重に調整されているわけです。(openai.com)
OpenAI公式発表
OpenAI APIモデル仕様
OpenAI安全性評価
まとめ
今週は大手3社から重要なモデル更新が重なりました。
ただ、単一ベンチマークの首位争いだけを追っていても、実際にどのモデルが使いやすいかは見えてきません。
Fable 5.1ではキャッシュの利用状況が費用を左右します。
Gemini 3.8 Flashは難しい課題ほど推論やツール利用が増えるため、トークン単価だけでは総費用を判断できません。
Astraには27万2,000トークンを境にした長文料金があり、コンピューター操作などではツール固有の料金も加わります。
比較すべきなのは、100万トークン当たりの料金だけではなく、仕事を一つ完了させるまでに必要な時間とトークン量です。
もう一つ、今週の発表に共通していたのが能力とアクセス制御を同時に設計する動きです。
Claude Mythos 5.1とGemini 3.8 Flash Cyberは利用者を限定し、GPT-6 Astraも高度なサイバー機能を段階的に開放します。
企業がモデルを採用する際には公開ベンチマークやAPI単価に加え、データ保持期間、管理者設定、安全機構による中断、利用資格や地域制限まで確認する必要があります。
モデルの性能が高くなるほど「何ができるか」だけでなく「どこまで使わせてもらえるか」が実務上の重要な条件になってきました。
主な参照先
いいなと思ったら応援しよう!
 あなたのチップが、南の島にそよ風を運びます🌴
小さな応援が、大きなエネルギーになります✨
なんくるないさ〜精神で、今日も書いてます!
