union与in结合用法优化

MySQL 集合运算 3 大性能陷阱:千万级数据下 UNION ALL 比 JOIN 慢 5 倍 本文深入解析MySQL集合运算在千万级数据下的性能陷阱,揭示UNION ALL比JOIN慢5倍的原因,并提供优化方案。涵盖并集、交集、差集运算的性能对比及索引优化策略,帮助开发者提升查询效率。 阅读详情

1、问题

最近项目中看到这种写法

select count(1) from ( with ss as
             (select id from t1 where (id='A1' or oid='A2')
             union 
             select oid from t1 where (id='A1' or oid='A2')
             )
       select * 
         from t2 
        where (t2.mid in (select id from ss) or t2.mid in (select ipmid 
                        from t3
                       where mid in (select id from ss) 
                         and status=1) ) 
          and t2.pcode='03' 
          )

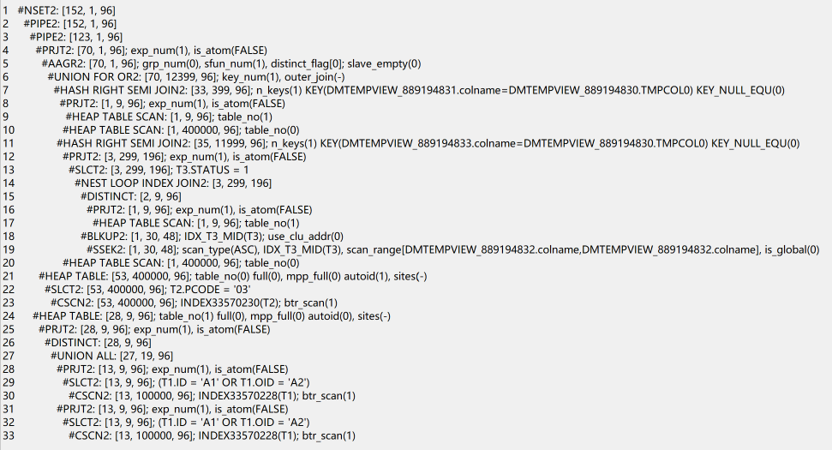
计划:
在这里插入图片描述

从计划上看生成两个HEAP TABLE,其中一个是来自with ss中的,另外一个是t2主查询的。
我们可以理解到or条件会提取公共部分生成heap table,减少扫描次数,但它会让条件没有先过滤,从而出现CSCN(全表扫描)引起性能问题,优化关键在于如何避免全表扫。
从语句条件(id=‘A1’ or oid=‘A2’)知道过滤性较好,可以使用索引,所以要优化可以将or条件改写,之前提过可以改成union all。
第一部分

select id from t1 where (id='A1' or oid='A2')
             union 
             select oid from t1 where (id='A1' or oid='A2')
这个很简单可以改写成
select id from t1 where id='A1'
             union 
             select id from t1 where oid='A2'
             union 
             select oid from t1 where id='A1'
             union 
             select oid from t1 where oid='A2' 

第二部分

select * 
         from t2 
        where (t2.mid in (select id from ss) or t2.mid in (select ipmid 
                        from t3
                       where mid in (select id from ss) 
                         and status=1) ) 
这个我们可以注意到or条件t2.mid in是一样的,这也是为什么会生成HEAP TABLE的原因,那么可以将in里面的先union all再与主查询做in
改写成
select * 
         from t2 
        where t2.mid in (select id from ss
              union all 
              select ipmid from t3 where mid in (select id from ss) and status=1 )

基本上改写完成,这里还要一点说明,in子查询是有隐性去重的效果,我们知道in (1,2,2)等价于in (1,2),无论in集合里是否重复都对主查询结果没影响,那么应该减少去重操作。所以第一部分所有的union可以改成union all。

2、改写

select count(1) 
  from (with ss as
             (select id from t1 where id='A1'
             union all
             select id from t1 where oid='A2'
             union all 
             select oid from t1 where id='A1'
             union all
             select oid from t1 where oid='A2' 
             )
       select * 
         from t2 
        where t2.mid in (select id from ss
              union all 
              select ipmid from t3 where mid in (select id from ss) and status=1 )
          and t2.pcode='03' )

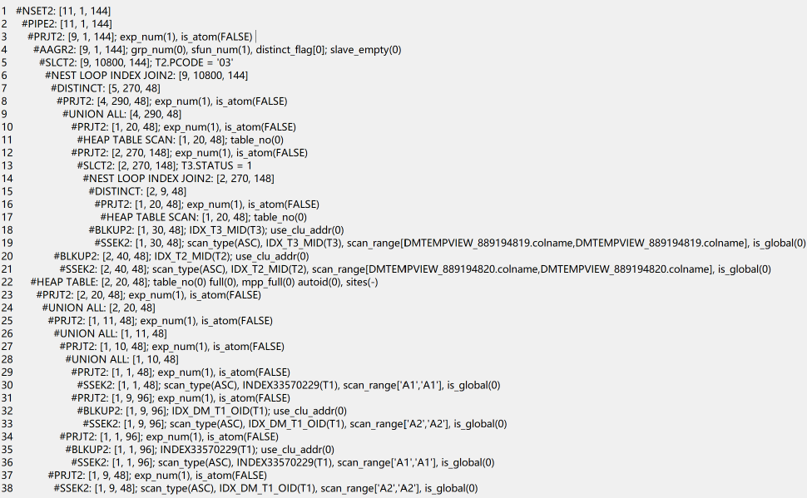
计划:
在这里插入图片描述

从计划上看,避免了全表扫描,执行效率提升几十倍。

3、小结

1、 在得知in子查询能过滤出较少数据时,形如(c1 in or c1 in) 可以改写成c1 in (select union all select)。
2、 In 子查询本身有隐性去重中union应改写成union all,但要注意一点除非in子查询里面的重复值本身太多(即集合数量过多)不利于与主查询关联。

4、附加测试数据

create table t1 (id varchar2(20) primary key,oid varchar2(20),status int);
insert into t1 select 'A'||level,'A'||to_char(round(dbms_random.value(1,10000),0)),round(dbms_random.value(1,5),0)
from dual connect by level<=100000;
commit;
dbms_stats.gather_table_stats(USER,'T1',null,100);
drop table if exists t2;
create table t2 (id varchar2(36) primary key,mid varchar2(20),is_d int,pcode varchar2(2),status int);
insert into t2 select sys_guid(),'A'||to_char(round(dbms_random.value(1,10000),0)),round(dbms_random.value(1,5),0),'03',round(dbms_random.value(1,5),0)
from dual connect by level<=400000;
commit;
dbms_stats.gather_table_stats(USER,'T2',null,100);
drop table if exists t3;
create table t3 (id varchar2(36) primary key,ipmid varchar2(20),mid varchar2(20),status int);
insert into t3 select sys_guid(),'A'||to_char(round(dbms_random.value(1,10000),0)),'A'||to_char(round(dbms_random.value(1,10000),0)),round(dbms_random.value(1,5),0)
from dual connect by level<=300000;
commit;
dbms_stats.gather_table_stats(USER,'T3',null,100);

create index IDX_DM_t1_oid on t1(oid);
create index IDX_T2_MID on T2(MID);
create index IDX_T3_MID on T3(MID);

UNION和UNION ALL性能差异与选型决策指南 UNION和UNION ALL是SQL中基础但极易误用的集合操作符,其核心区别在于是否执行去重(DISTINCT)。从数据库原理看,UNION本质是UNION ALL加排序或哈希去重,涉及内存分配、临时磁盘IO、执行计划变更等底层开销;技术价值体现在保障数据正确性与规避性能雪崩的平衡。典型应用场景包括报表去重计数、多源用户ID合并、ETL中间表拼接及实时事件流聚合。当重复率低、数据量大或业务允许冗余时,UNION ALL可提升数倍性能;而涉及唯一性约束、递归查询去环或口径强一致需求时,UNION不可替代。本 阅读详情

相关推荐

SQL UNION实战指南:多源数据整合原理与性能优化

UNION 是关系型数据库中实现多源同构数据纵向合并的基础操作,其核心在于列对齐、类型兼容与结果集虚拟化。不同于 JOIN 的横向关联或 WHERE 的条件过滤,UNION 通过结构一致性约束(列数、类型优先级)和执行计划调度(如 TempDB 排序开销),支撑跨表、跨渠道、分片场景下的安全聚合。技术价值体现在零建表依赖、权限隔离、语义清晰等企业级能力;典型应用场景包括销售归集、退款分析、BI 视图构建及动态分表查询。本文聚焦 SQL Server 环境,深入解析 UNION vs UNION ALL 的执

cuili5839的博客 342

sql exists和not exists用法

sql exists和not exists用法 exists       (sql       返回结果集,为真)   not       exists       (sql       不返回结果集,为真) 如下: 表A ID   NAME   1       A1 2       A2 3       A3 表B ID   AID   NAME 1

兰染 977

GOM引擎单机传奇架设全攻略——从DBC2000配置到登录器生成

本文详细解析了使用GOM引擎架设单机传奇的完整流程,从DBC2000的安装配置、服务端部署、引擎控制器设置,到登录器生成与客户端补丁放置。文章重点解决了单机架设中的常见问题,如数据库路径配置、IP地址设置及Key.lic文件处理,旨在帮助玩家快速搭建稳定的个人游戏环境,体验GM乐趣。

weixin_28318011的博客 604

MySQL复合查询详解:连接查询、子查询、UNION与性能优化

在数据库日常开发中,复杂业务往往需要多表关联、子查询与结果集合并才能完成,这类复合查询能力直接影响报表统计与数据分析的效率。理解内连接与外连接的差异、NOT IN的NULL陷阱、UNION与UNION ALL的去重代价,是正确书写SQL的前提;而GROUP BY与窗口函数的合理选择,则决定了聚合场景下的性能与可读性。面对“mysql的or能去重吗”这类问题,需要从条件过滤与集合合并的本质去辨析。利用EXPLAIN分析执行计划、优化驱动表索引,可以避免全表扫描和临时表带来的性能瓶颈。围绕MySQL复合查询的语

weixin_31423955的博客 228

【rPPG】基于多光谱摄像头的非接触式睡眠血氧监测系统(传统建模方法解析)

本文深入解析了基于多光谱摄像头的非接触式睡眠血氧监测系统,重点探讨了rPPG技术的原理、硬件设计及传统建模方法。通过多光谱摄像头捕捉皮肤微弱光学变化,实现医疗级精度的心率和血氧监测,特别适合长期睡眠监测场景。文章详细介绍了摄像头选型、照明系统设计以及PBV模型等核心技术,并对比了与传统传感器的性能差异。

weixin_30300225的博客 555

基于FPGA的DDS信号发生器

之前的博客讲到了DDS的基本原理,现在用Verilog代码实现DDS,能够产生四种波形,方波,三角波,正弦波,锯齿波,用按键来控制频率和选择波形。其中按键消抖模块来自小梅哥的FPGA自学笔记设计与验证这本书。 module DDS_Module( Clk, Rst_n, EN, Fword, Key1, Pword, DA_Clk, DA_Data ); input Clk...

qq_43534451的博客 9940

SQL:多列匹配(Multiple-column Matching)

MySQL中的多列匹配是指在查询时同时对多个列进行组合匹配,常见于WHERE子句、IN子句、JOIN条件或索引使用场景。多列匹配的基础形式为SELECT * FROM table WHERE (col1, col2) = ('value1', 'value2');,表示只有当两列同时满足条件时才匹配成功。其应用场景包括多列等值匹配、多列IN匹配、多列JOIN匹配、子查询、EXISTS、UNION组合数据源以及索引优化等。多列匹配在复合主键或唯一约束字段组合中尤为高效,且比AND更具表达力。性能优化方面,建议

2402_88047672的博客 932

使用Python开发TreeATE的测试脚本常见问题

ImportError: No module named py_compile 找不到 DevLangPython3.dll 以上2个问题都是没有安装正确的Python,当前TreeATE依赖32位Python 2.7版本,暂时不支持Python 3以上版本

蓝白云的专栏 1026

SQL子查询与合并查询实战:从执行逻辑到多表数据查询

多表查询是数据库开发中的核心技能,而子查询与合并查询在其中扮演着关键角色。子查询通过嵌套SELECT实现对数据的条件过滤、聚合比较与动态计算,显著提升了SQL的表达能力;合并查询则利用UNION与UNION ALL将多个结果集纵向拼接,尤其适用于分表数据汇总、跨来源数据整合等场景。理解标量、列、行、表四种子查询形态,掌握IN、EXISTS、ANY/ALL的选型逻辑,以及明确UNION去重与UNION ALL高效拼接的取舍,是写出可靠且高性能SQL的关键。在实际业务中,无论是统计用户订单金额、筛选高价商品购买

weixin_28728495的博客 135

九齐NY8B062F单片机:12位ADC与4路PWM在智能家居控制中的实战应用

本文详细介绍了九齐NY8B062F单片机在智能家居控制中的实战应用,重点解析其12位ADC高精度传感器数据采集和4路PWM精准驱动技术。通过实际案例展示如何利用该单片机实现温湿度监测、灯光调节及电机控制,并分享低功耗设计与抗干扰方案,为低成本高可靠性的智能家居设备开发提供完整解决方案。

rnn9storyteller的博客 725

医药领域知识图谱快速及医药问答项目(项目全过程)

该项目是中科院软件所刘焕勇老师在github上的开源项目,基于知识图谱的医药领域问答项目 Github项目地址:mirrors / liuhuanyong / qasystemonmedicalkg · GitCode 一、项目环境搭建 该部分要十分注意,由于版本升级的问题,一些用法及格式已经不兼容了。 python3.8 下载地址:Python Release Python 3.8.10 | Python.orght...

qq_52062182的博客 9911

第8章 数据查询进阶实战:从基础到商业智能分析

本章详细介绍了MySQL数据查询的进阶技巧与应用场景。从SELECT语句基础结构入手,讲解了单表数据检索的各种方法(WHERE、LIKE、ORDER BY等)和聚合函数(COUNT、SUM、AVG等)的商业分析应用。重点演示了多表连接查询(INNER JOIN、LEFT JOIN)的实现方式,并基于电商平台案例展示了订单统计、用户消费分析等实用查询。内容涵盖数据筛选、分组统计、排序分页等核心操作,强调生产环境中的性能优化注意事项,如避免SELECT *、优化LIKE查询等。通过实际SQL示例,帮助读者掌握从

小宝哥Code的专栏 448

建模simulink - 手把手教你搭建xpc平台

概述xpc半实物仿真目标是个基于RTW对低端实时仿真和开发平台,可将计算机或者工控机转变为一个实时系统,不需要第三方操作系统对支持,在计算机上配置输入输入出设备就能和外部交换信息,进行硬件...

不只会拍照的程序猿 7084

MYSQL从语义到执行计划:UNION、EXISTS、IN 的深度辨析

**本文以 UNION、EXISTS、IN 三个高频 SQL 关键字为切入点,辨析集合运算与存在判断两大语义家族的本质差异。文章不讲“哪个更快”的绝对结论,而是从执行路径、NULL 语义、索引依赖和优化器改写出发,给出可验证的选型方法与实战建议。**

需要远程指导仿真实验、代码有问题的,请后台私信。 7183

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

mysql in union all_mysql中or、in、union、union all

先说心得:最近自己也在开发一个项目,用到了mysql的union、unionall、or、in。union:Java代码收藏代码SELECT column,... FROM table1UNION [ALL]SELECT column,... FROM table2使用 UNION 要注意,2个select搜索的column的长度也就是个数要相同且字段要一样。结果是2个查询结果相加,去除相同内容...

weixin_36013970的博客 694

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

记录一次sql优化记录(in变为exists和union)

插入300万条数据 declare i integer; --定义变量 begin i := 2000001; loop /* 插入数据 */ insert into T_TEST_LARGE_DATA (ID, USERNAME, PASSWD, DEPARTMENTID, DEPARTMENTNAME, TITLE, HIREDATE) values (i, 'username', 'pass...

qq_34749144的博客 538

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

mysql中in的用法详解

in操作符在 MySQL 中广泛应用于多值筛选,其简洁性和灵活性使其成为高频查询工具。:列表值与字段类型不一致(如字符串与数字)导致查询失败。是 MySQL 中用于多值筛选的高效操作符,常用于。条件,简化查询逻辑并提升可读性。

技术人集结地 4193

【Cypher】UNION 语句:合并多个查询结果

UNION 语句用于合并多个查询的结果,自动去重后返回。UNION ALL 不去重,直接合并结果,适用于大数据量的查询。RETURN 语句的列名、列数和数据类型必须保持一致,否则会导致错误。ORDER BY、LIMIT 和 SKIP 只能在 UNION 之后使用,对合并后的结果进行排序和分页。UNION 常用于处理不同标签、关系或查询条件的数据整合,提升查询灵活性和可读性。通过合理使用 UNION,可以更高效地合并和处理不同来源的数据,优化 Neo4j 图数据库的查询性能。

彬彬侠的博客 1168

MySQL高级查询技巧:ORDER BY、GROUP BY、IN、UNION完整指南

想要从MySQL初学者进阶为数据库高手吗?掌握ORDER BY、GROUP BY、IN、UNION这四大高级查询技巧,将让你的SQL查询能力实现质的飞跃!这些技巧不仅能帮你更高效地处理数据,还能让复杂的查询变得简单直观。😊 ## 为什么需要学习高级查询技巧? 在日常的数据库操作中,我们经常需要对数据进行排序、分组、筛选和合并。这些操作看似简单,但掌握正确的使用方法和技巧,可以显著提升查询效率

gitblog_01155的博客 744

mysql in union_Case:MySQL使用in带子查询的时候,子查询最好不要使用union或union all...

MySQL使用in带子查询的时候,子查询不要使用union或union all特别是当外部表比较大的时候,千万不要使用in和union搭配,因为子查询中一旦使用union,执行计划会出现dependent subquery这种情况,在生产上我们有使用类似的情况,导致SQL执行效率很差,下面举例说明,为了生产安全隐私,以下举例用测试表演示,原理相通。举例(1) 使用in和union搭配的时候,s表作...

weixin_34883242的博客 810

Flink SQL 集合运算UNION / INTERSECT / EXCEPT 以及 IN / EXISTS 在流式场景下怎么用?

本文介绍了Flink SQL中的集合运算操作(UNION/INTERSECT/EXCEPT)和存在性判断(IN/EXISTS)在流处理场景下的应用。重点分析了这些操作在流式计算中的状态管理问题:UNION ALL适合流合并但UNION可能导致状态膨胀;INTERSECT/EXCEPT需要维护历史状态;IN/EXISTS会被重写为Join操作。文章建议在流处理中优先使用UNION ALL,为交集差集操作添加时间维度,将IN/EXISTS转化为明确的Join,并合理配置状态TTL来控制资源消耗。最后强调流处理中

hello.reader 871

UNION与UNION ALL:从执行计划看懂SQL去重与性能优化

在SQL查询优化中,集合操作是处理多表数据合并的常用手段,而UNION和UNION ALL的选择直接影响数据库性能。二者表面区别是“去重”与“不去重”,但底层却涉及排序、哈希算法、临时表乃至内存溢出等关键机制。理解执行计划中的UNION RESULT、SORT UNIQUE或HashAggregate,有助于开发者在真实业务中避免慢SQL和磁盘爆满问题。针对流水表合并、结果集聚合、唯一集合归并等场景,合理选用操作符能显著提升查询效率。同时,不同数据库对UNION的类型兼容、ORDER BY和LIMIT处理存

weixin_30566111的博客 361

sql优化之union all 和or ,in使用

不要迷信union all 就比 or及in 快,要结合实际情况分析到底使用哪种情况。 对于索引列来最好使用union all,因复杂的查询【包含运算等】将使or、in放弃索引而全表扫描,除非你能确定or、in会使用索引 对于只有非索引字段来说你就老老实实的用or 或者in,因为 非索引字段本来要全表扫描而union all 只成倍增加表扫描的次数 对于既有索引字段【索引字段有效】又包含非索...

weixin_30611509的博客 446

mysql用union替换or_MySQL索引优化和inor替换为unionall

MySQL索引优化和inor替换为unionall作者:小涵 | 来源:互联网 | 2018-07-13 18:59阅读: 2874一个文章库,里面有两个表:category和article。category里面有10条分类数据。article里面有20万条。article里面有一个article_category字段是与category里的category_id字段相对应的。article表里面...

weixin_30173361的博客 256

MySQL多表查询实战:JOIN、UNION与子查询的深度解析与性能优化

在数据库开发中,多表查询是处理复杂业务逻辑的核心技术,它通过连接、合并和嵌套查询,将分散在不同表中的数据重组为业务视角的完整信息。其原理在于利用表间关系(如主外键)进行数据关联,通过JOIN实现横向扩展,UNION实现纵向合并,子查询实现嵌套逻辑。这项技术的价值在于能够高效解决现实世界中的数据关联需求,例如电商系统中的用户-订单-商品关联分析、跨表统计报表生成等。在实际应用中,掌握连接查询(尤其是内连接与外连接的区别)、联合查询的去重与性能权衡,以及子查询的多种形式(如标量、列、EXISTS子查询)至关重要

weixin_30587927的博客 420
上一篇: row_number()函数与group by性能比较
下一篇: Left join+or exists+like关联优化
zcn126
博客等级 码龄8年 27粉丝 91原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值