neo4j实战详解

知识图谱构建:图数据库Neo4j的节点和关系的新增、删除 知识图谱领域内图数据库Neo4j的实战,节点和关系的新增和删除,面对多种情况,有详细实例,帮助解读,欢迎讨论!!! 阅读详情

前言

上一章讲到了Neo4j下载安装过程以及Neo4j浏览器的简单用法,这里通过实战详细说一下Neo4j图数据库具体用法,主要分为增删改查四项。

1、增加

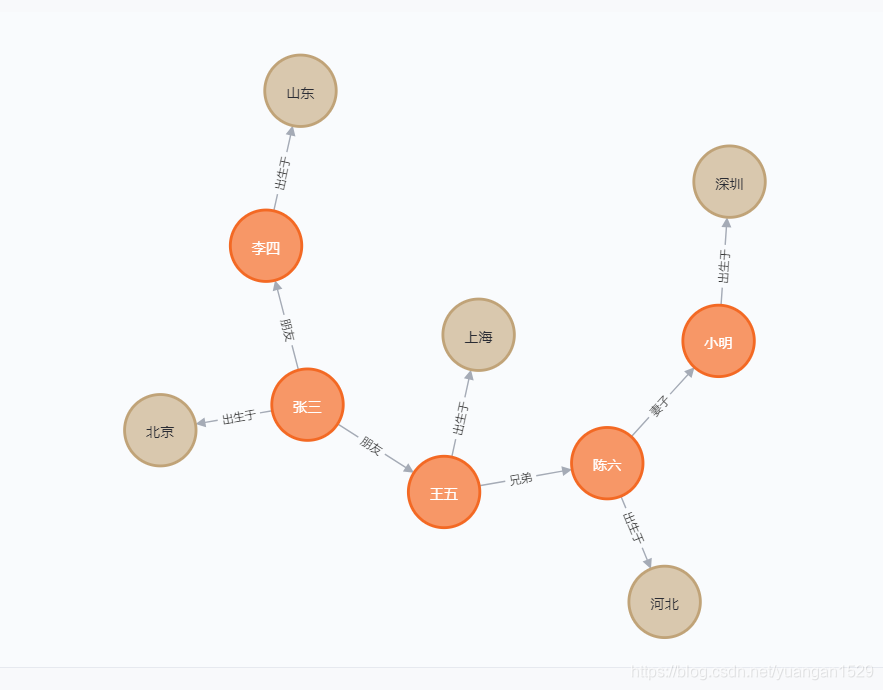
先来个实战,了解一下 Neo4j 的大概用法,实战内容:绘制一个包含简单人物、地理位置及之间所包含关系的图谱。

1.1 第一步:删除当前所有节点

我们删除数据库中以往的图,确保一个空白的环境进行操作:

MATCH (n) DETACH DELETE n

其中,MATCH 是匹配操作,而小括号()代表一个节点 node,括号里面的 n 为标识符或者说变量,这个语句含义:匹配所有节点(因为对节点没有做限制,所有是所有节点),然后删除匹配成功的所有节点。

执行完以后可以点击数据库信息,发现所有节点已经消失。

1.2 第二步:创建人物节点

先来创建一个众所周知的人物:张三

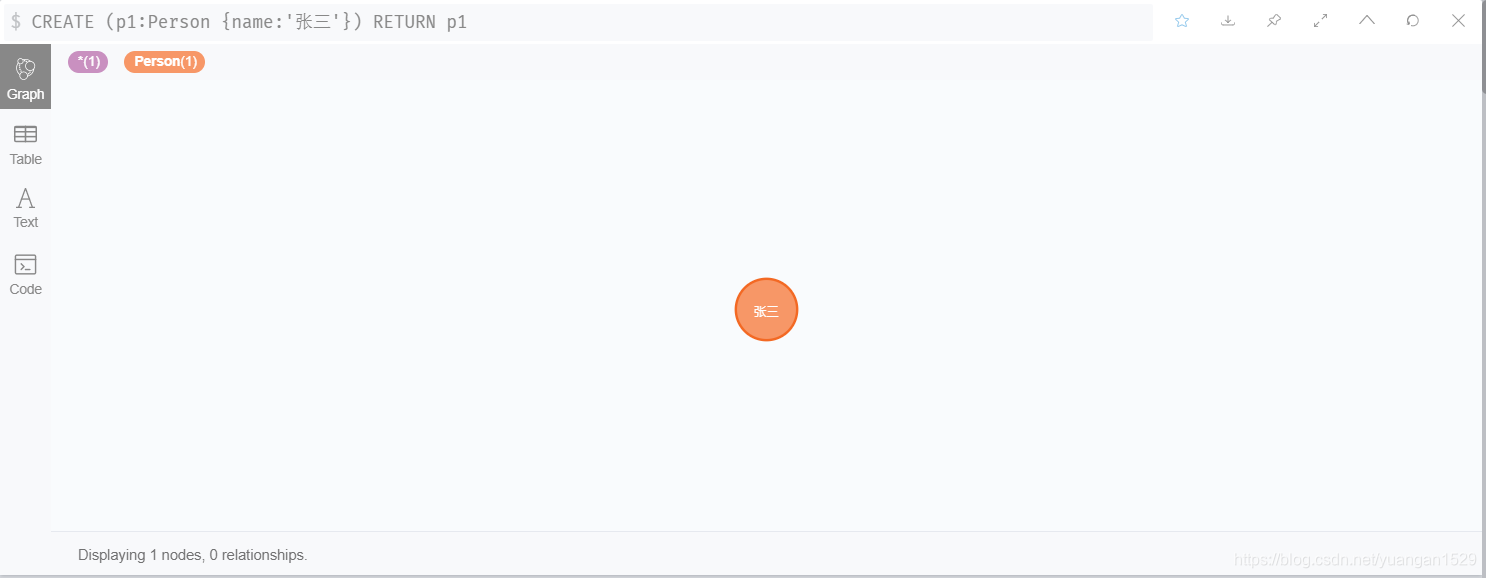
CREATE (p1:Person {name:'张三'}) RETURN p1

执行完成后:
在这里插入图片描述

CREATE 是创建操作,Person 是标签,代表节点的类型。花括号{}代表节点的属性,属性类似 Python 的字典,return 的含义是创建完成,在显示区域展示出变量 p1——也就是将人物张三显示出来(可以理解为自带的查询功能)。这条语句的含义就是创建一个标签为 Person 的节点 p1,该节点具有一个 name 属性,属性值是张三。

注意:代码中 p1 是局部变量,执行完就释放了,不会在数据库中存储,只是用来代表节点——用在后面执行 return,可以随意命名。

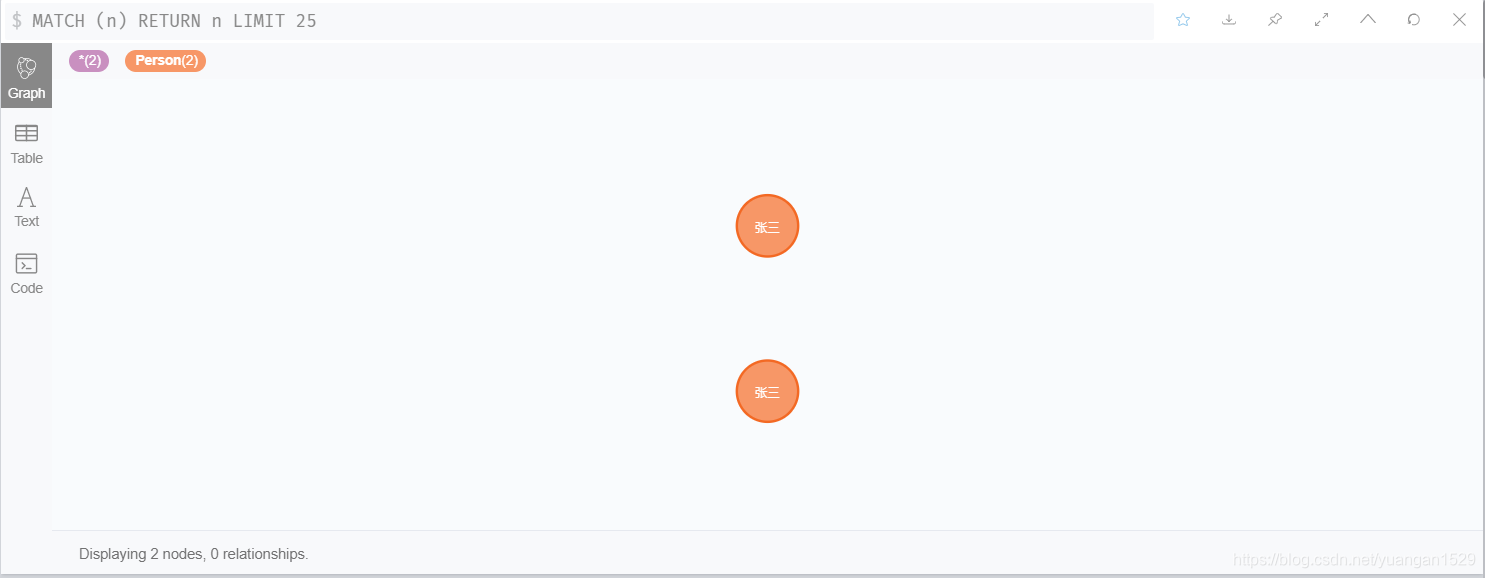
创建过程中,我发现可以创建多个相同人物:
在这里插入图片描述

同时,标签和属性都可以是中文:

CREATE (p1:人物 {名称:'张三'}) RETURN p1

当然,很多编程中直接用中文可能会出现问题,建议还是使用英文比较好。

创建多个人物:

CREATE (p1:Person {name:'张三'})
CREATE (p2:Person {name:'李四'})
CREATE (p3:Person {name:'王五'})
CREATE (p4:Person {name:'陈六'})
CREATE (p5:Person {name:'小明'})

执行结果:
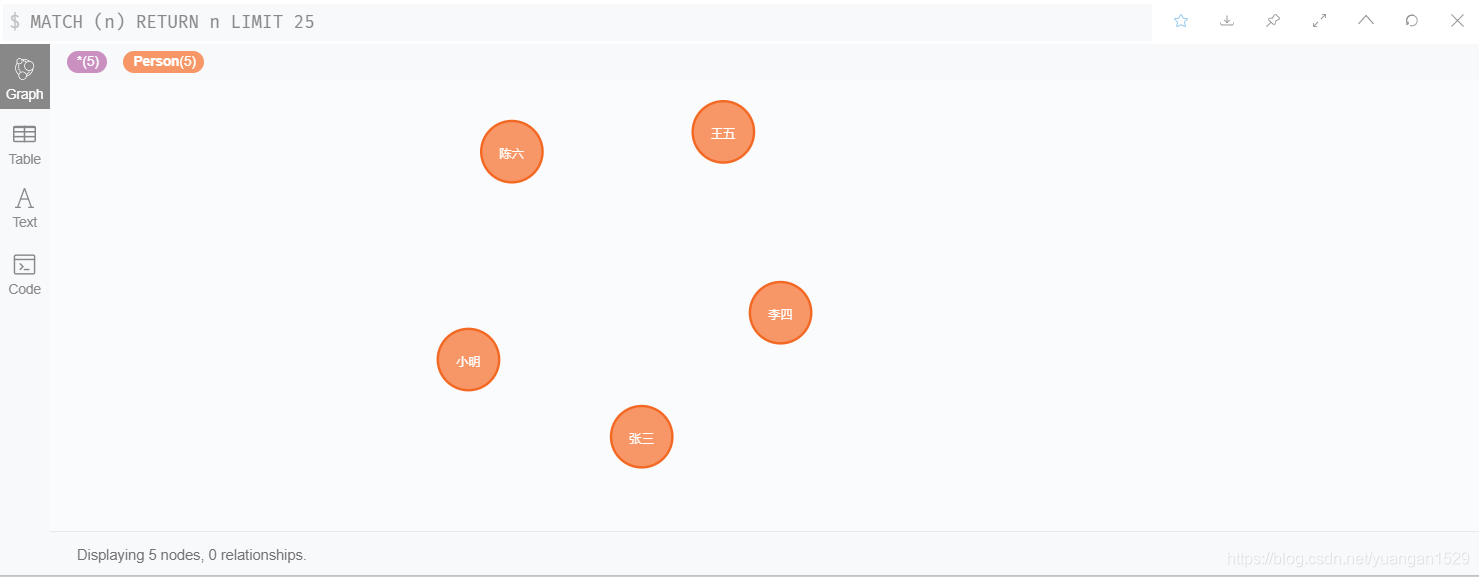
在这里插入图片描述

执行结束,在左侧会显示出来:

在这里插入图片描述

如上图,当前具有节点为 5 个,当前拥有标签为 person,点击 person 会在右边显示出节点信息。

这里有一个问题,就是在执行多行语句,并且都有 return 命令的情况:

CREATE (p1:Person {name:'张三'}) RETURN p1
CREATE (p2:Person {name:'李四'}) RETURN p2
CREATE (p3:Person {name:'王五'}) RETURN p3
CREATE (p4:Person {name:'陈六'}) RETURN p4
CREATE (p5:Person {name:'小明'}) RETURN p5

执行上述命令会报错,因为没有分号,表示一个执行命令(只是会相继执行),但是却存在 5 个返回结果。

正确方案:

#方案1:去掉return
CREATE (p1:Person {name:'张三'})
CREATE (p2:Person {name:'李四'})
CREATE (p3:Person {name:'王五'})
CREATE (p4:Person {name:'陈六'})
CREATE (p5:Person {name:'小明'})

方案2:每句增加分号
CREATE (p1:Person {name:'张三'}) RETURN p1;
CREATE (p2:Person {name:'李四'}) RETURN p2;
CREATE (p3:Person {name:'王五'}) RETURN p3;
CREATE (p4:Person {name:'陈六'}) RETURN p4;
CREATE (p5:Person {name:'小明'}) RETURN p5

不只是 return,之前还提到过相同变量也会存在上述问题,比如:

# 执行下述命令的时候,会一起执行,但是一个变量P相当于对应了多个节点,会冲突,解决方法和上述相同,要么加分号,要么更改变量名
CREATE (p:Person {name:'张三'})
CREATE (p:Person {name:'李四'})
CREATE (p:Person {name:'王五'})
CREATE (p:Person {name:'陈六'})
CREATE (p:Person {name:'小明'})

1.3 第三步:创建地理节点

节点名称为 location,属性包括城市(city)和级别(level):

CREATE (c1:Location {city:'北京', level:'直辖市'})
CREATE (c2:Location {city:'山东', level:'省份'})
CREATE (c3:Location {city:'深圳', level:'直辖市'})
CREATE (c4:Location {city:'上海', level:'直辖市'})
CREATE (c5:Location {city:'河北', level:'省份'})

运行结果如下:
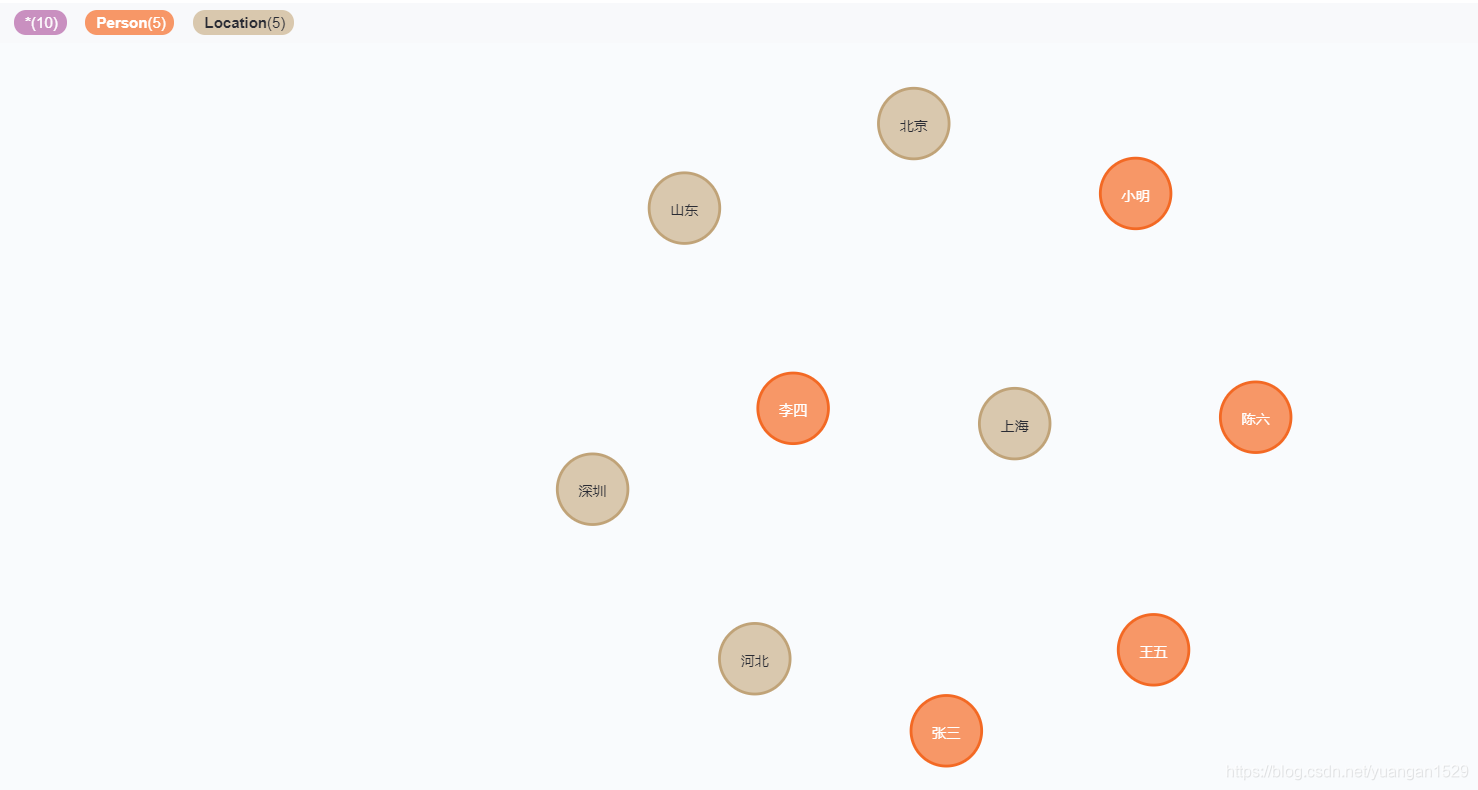
在这里插入图片描述

如上图所示,不同类型的节点采用了不同颜色标识出来。

1.4 创建关系

1.4.1 人与人之间的关系
MATCH (p1:Person {name:'张三'}),
      (p2:Person {name:'李四'})
MERGE (p1)-[f:朋友]->(p2)

结果如下:
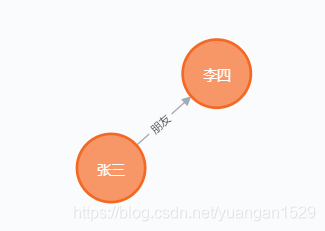
在这里插入图片描述

如上所示,看完结果再看代码就非常容易理解了:

  • Match 会将匹配数据库中节点类型为 person,而 name 属性为张三的,将其指向 p1;p2 指向李四
  • merge 会将匹配后的结果,使用[关系变量名:关系变量值]创建朋友关系,这里的方括号[]即为关系,f 为关系的名称,朋友为关系的类型。注意这里的箭头–>是有方向的,表示是从 p1 到 p2 的关系。

ok,再增加几个关系:

MATCH (p1:Person {name:'张三'}),
      (p2:Person {name:'王五'})
MERGE (p1)-[f:朋友]->(p2);
MATCH (p1:Person {name:'王五'}),
      (p2:Person {name:'陈六'})
MERGE (p1)-[x:兄弟]->(p2);
MATCH (p1:Person {name:'陈六'}),
      (p2:Person {name:'小明'})
MERGE (p1)-[q:妻子]->(p2);

结果如下:
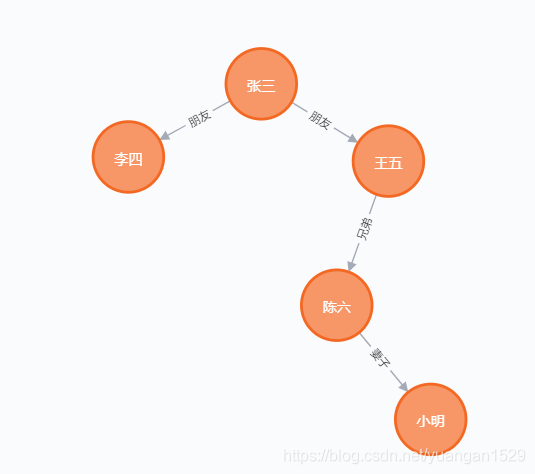
在这里插入图片描述

问题一:如果存在多个相同人物,建立关系会如何?

既然 match 是匹配数据库中的人物,那么如果有多个张三怎么办呢?

我们来实践一下,将之前的关系删除,创建两个张三,两个个李四:

MATCH (n) DETACH DELETE n;
CREATE (p1:Person {name:'张三'})
CREATE (p2:Person {name:'李四'})
CREATE (p3:Person {name:'张三'})
CREATE (p4:Person {name:'李四'})

注意:上面第一行要加分号,表明要单独执行,执行结果如下:
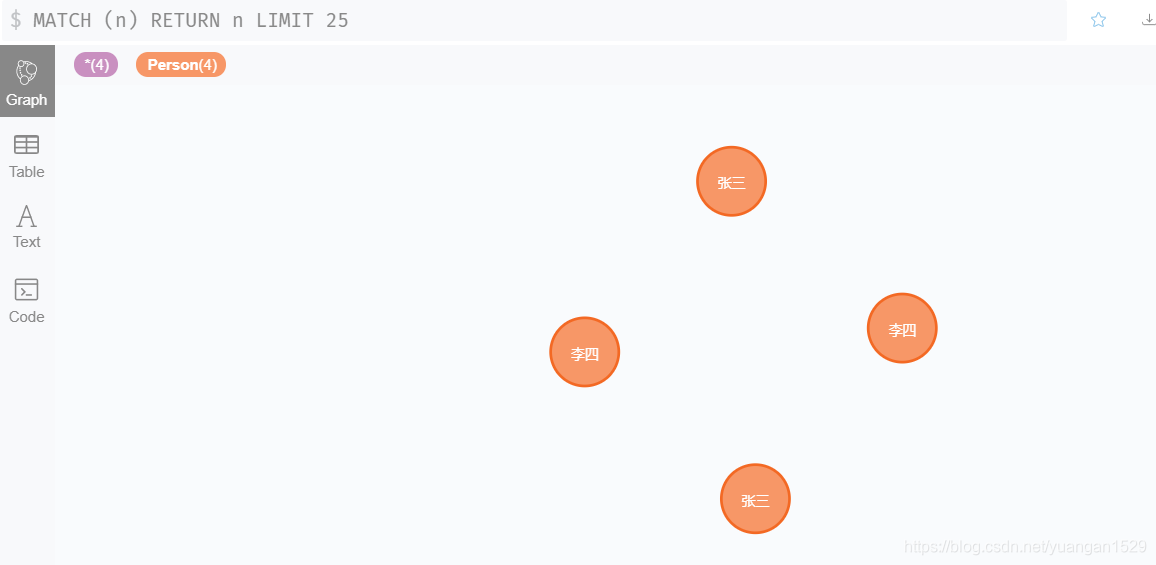
在这里插入图片描述

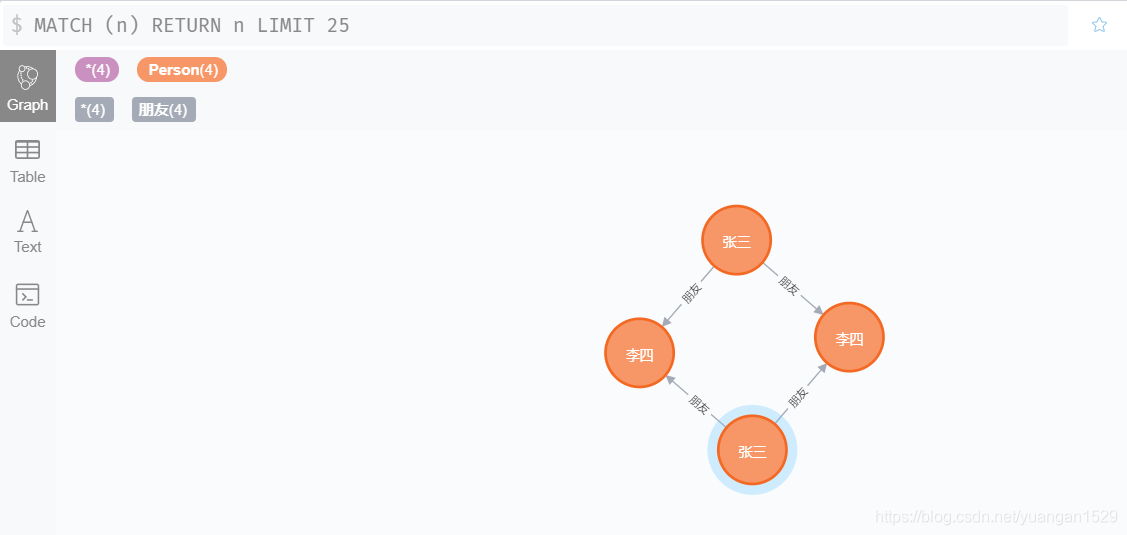
创建张三与李四的关系:

MATCH (p1:Person {name:'张三'}),
      (p2:Person {name:'李四'})
MERGE (p1)-[f:朋友]->(p2)

执行结果如下:
在这里插入图片描述

如上图所示,该结果说明了

  • 匹配的时候,变量 p1 可以指向多个节点
  • 建立关系的时候,可以建立多个关系

问题二:创建关系的变种命令

事实上,当我看到创建关系的那条语句时,我就想到了下面这一条命令:

MERGE (p1:Person {name:'张三'})-[:朋友]->(p2:Person {name:'李四'})

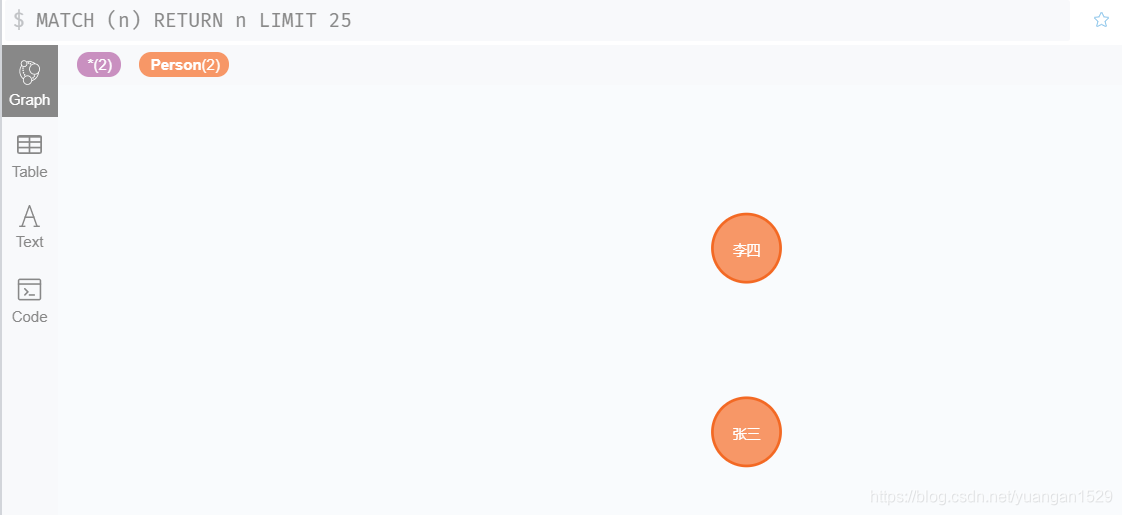
两者是不是等同的呢?我们来执行一下,还是先删除以前的节点,然后创建一个张三,一个李四:

MATCH (n) DETACH DELETE n;
CREATE (p1:Person {name:'张三'})
CREATE (p2:Person {name:'李四'})

执行结果如下:
在这里插入图片描述

OK,我们来执行以下命令:

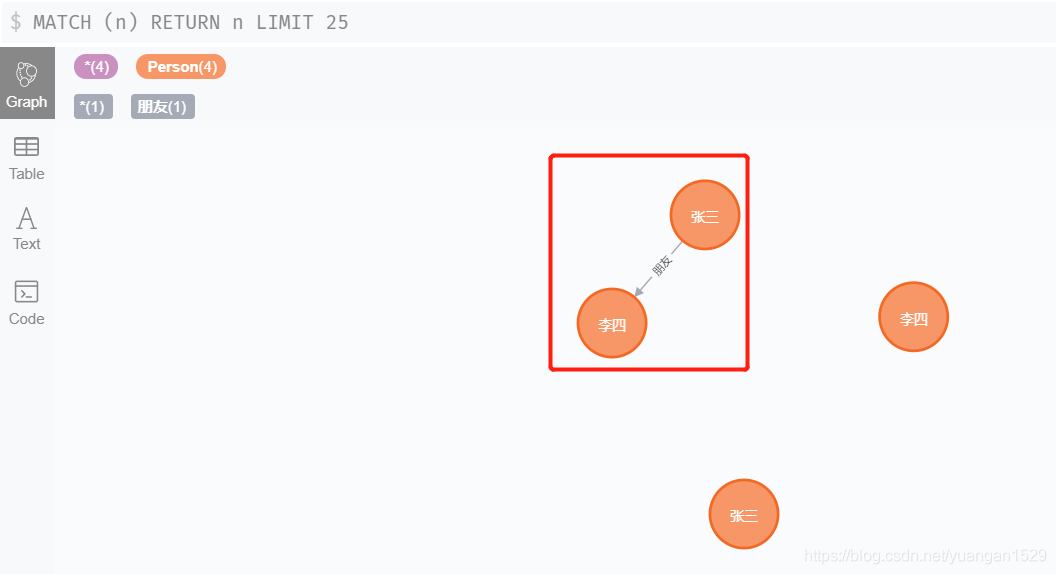
MERGE (p1:Person {name:'张三'})-[f:朋友]->(p2:Person {name:'李四'})

执行结果如下:
在这里插入图片描述

执行结果非常让人惊讶,可以看到多出来一个张三和李四,我们回过头来,再看看上面的变种命令,就会想到一个可能:

没有了 match,就不会再匹配数据库中的节点了,而是直接创建新的节点,同时也完成关系的创建。

再来看另外一个变种:

MATCH (p1:Person {name:'张三'}), (p2:Person {name:'王五'}),(p3:Person {name:'王五'}),
      (p4:Person {name:'陈六'}),
      (p5:Person {name:'小明'})
MERGE (p1)-[:朋友]->(p2),(p3)-[x:兄弟]->(p4),(p1)-[q:妻子]->(p5)

执行后报错如下:
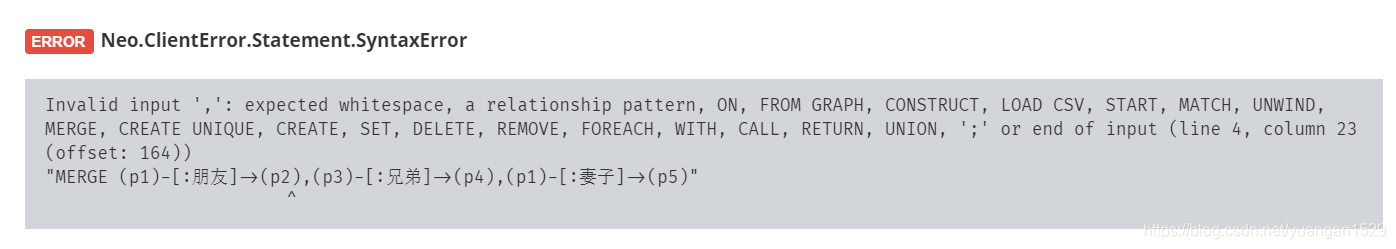
在这里插入图片描述

显然,这个变种命令是不行的。

1.4.2 创建人与地理位置的关系

如果仔细看完上一节,那么创建人与地理位置的关系就好说了:

MATCH (p1:Person {name:'张三'}),
      (c:Location {city:'北京'})
MERGE (p1)-[l:出生于]->(c)

执行结果如下:
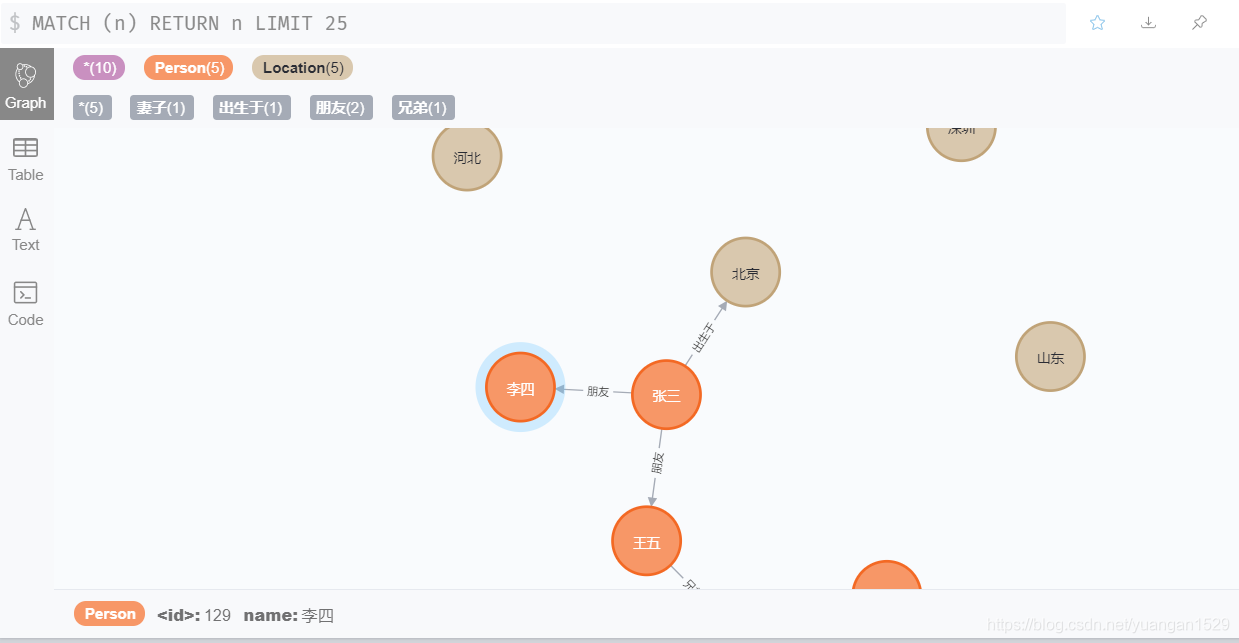
在这里插入图片描述

接下来,所有人都建立出生地关系(命令就不写了,仿照上面写就可以):

在这里插入图片描述

问题一:大小写问题

在创建人与地理位置的关系时,发现一个问题,就是标签是区分大小写的:

MATCH (p1:Person {name:'李四'}),
      (c:location {city:'北京'})
MERGE (p1)-[l:出生于]->(c)

上述代码中,将 Location 写为 location,执行结果如下:
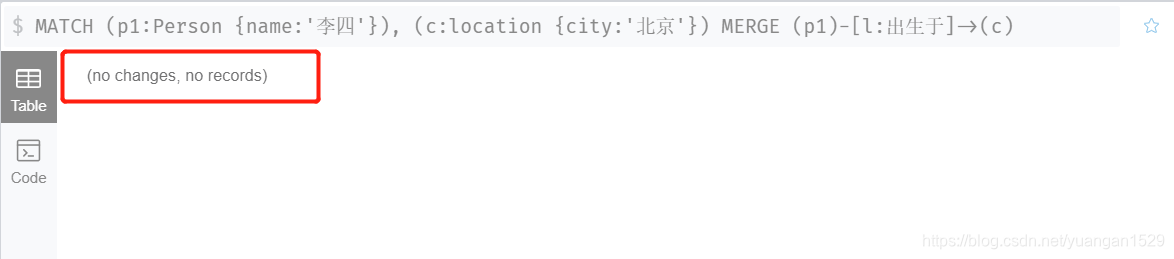
在这里插入图片描述

没有任何执行记录,表明在匹配的是就没有匹配成功,问题就在于没有找到 location 这个类型的节点。

标签类型区分大小写,但是执行关键词是不区分大小写的,比如 match,merge 等。

1.4.3 为关系添加属性

为关系添加属性与为节点添加属性类似:

MATCH (a:Person {name:'张三'}),
      (b:Location {city:'北京'})
MERGE (a)-[:出生于 {since:2001}]->(b)
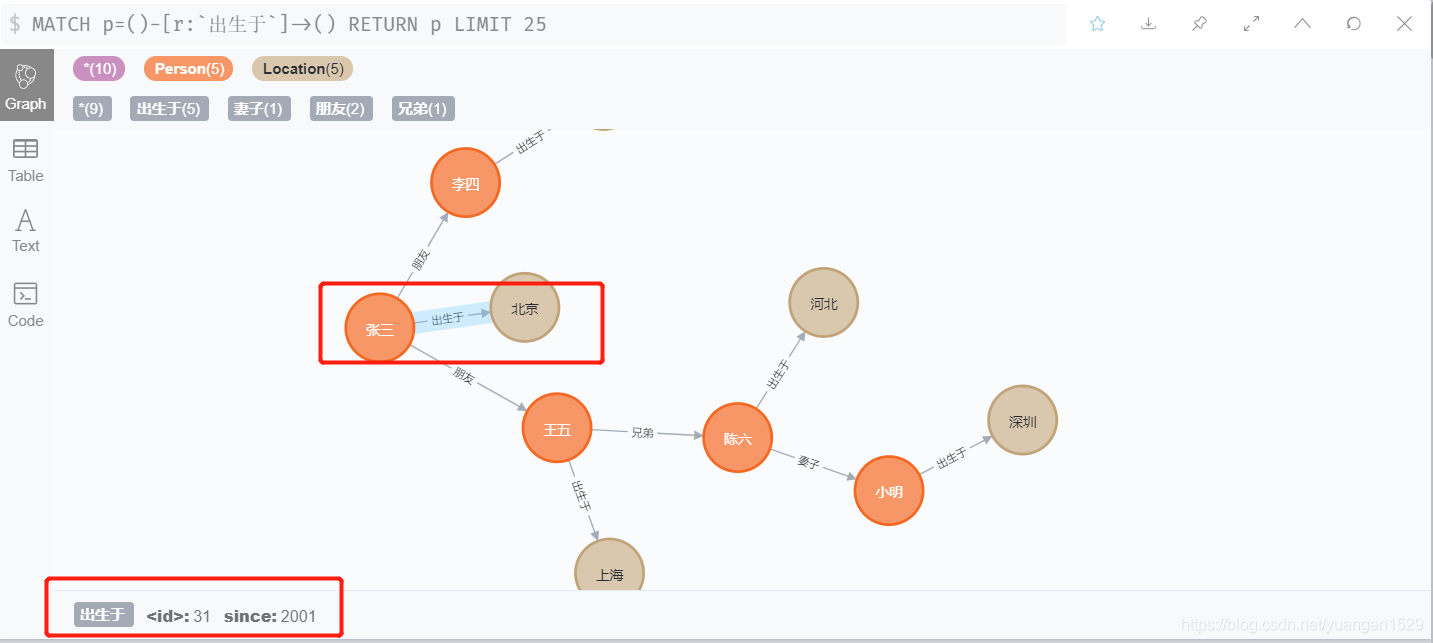
在这里插入图片描述

2、查询

2.1 查询所有对外有关系

MATCH (n)-->() RETURN n

上述查询属于模糊查询,只要有节点对外有关系,则显示出来,查询结果:
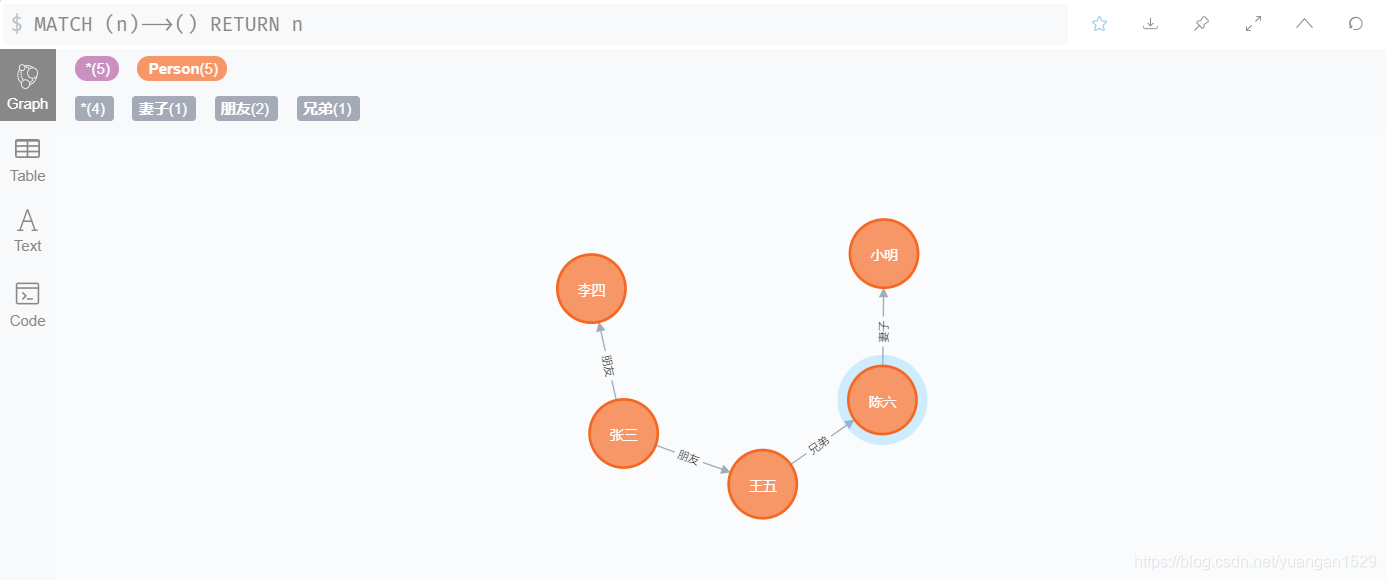
在这里插入图片描述

需要注意的是,返回的是节点,而节点之间的关系则是附属的,也就是只要该节点有对外关系(比如李四就有出生于的指向),那么就显示出来,其中地点一个也没有显示出来,因为地点都是被指向的。

我们很容易相对,与上面相对的查询,将 n 换个位置,就是被指向的查询:

MATCH ()-->(n) RETURN n

是不是很 easy!

2.2 查询所有存在关系的节点

MATCH (n)--() RETURN n

只要该节点存在关系,无论是指向还是被指向,都显示出来:
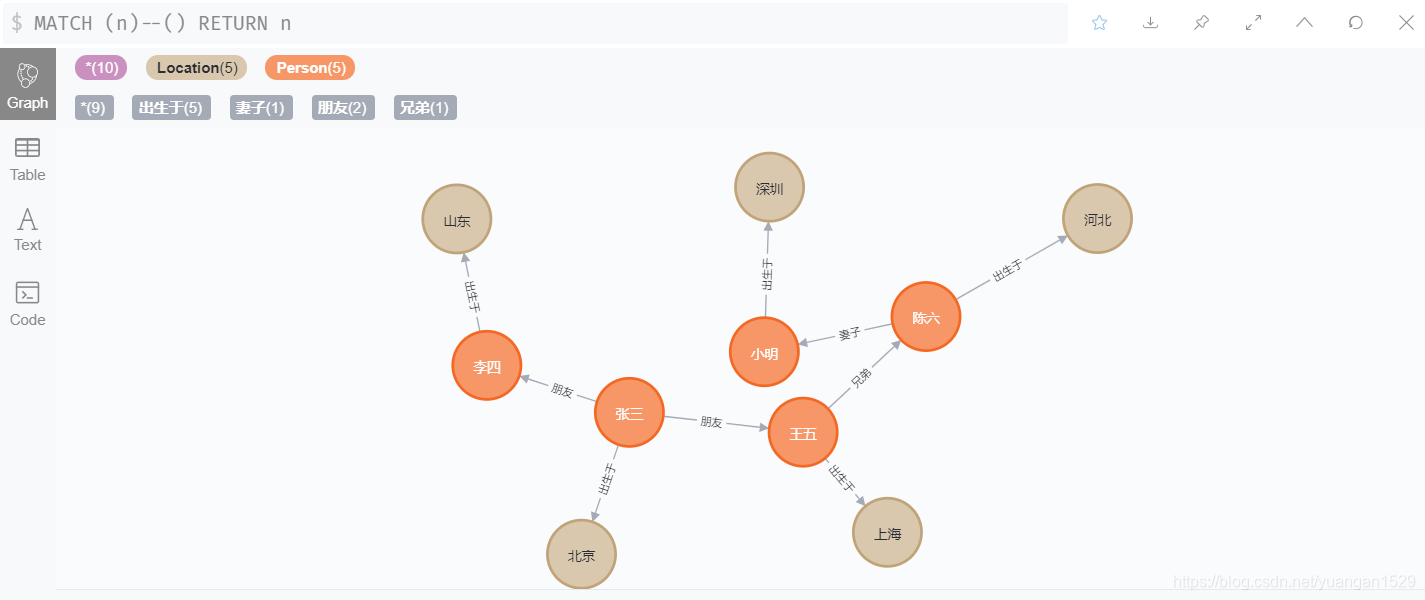
在这里插入图片描述

2.3 查询所有对外有关系的节点,以及关系类型

MATCH (n)-[r]->() RETURN n.name, type(r),r.name

注意:这个查询告诉我们如何查询一个节点的属性:节点.属性,还有关系的类型,查询结果:
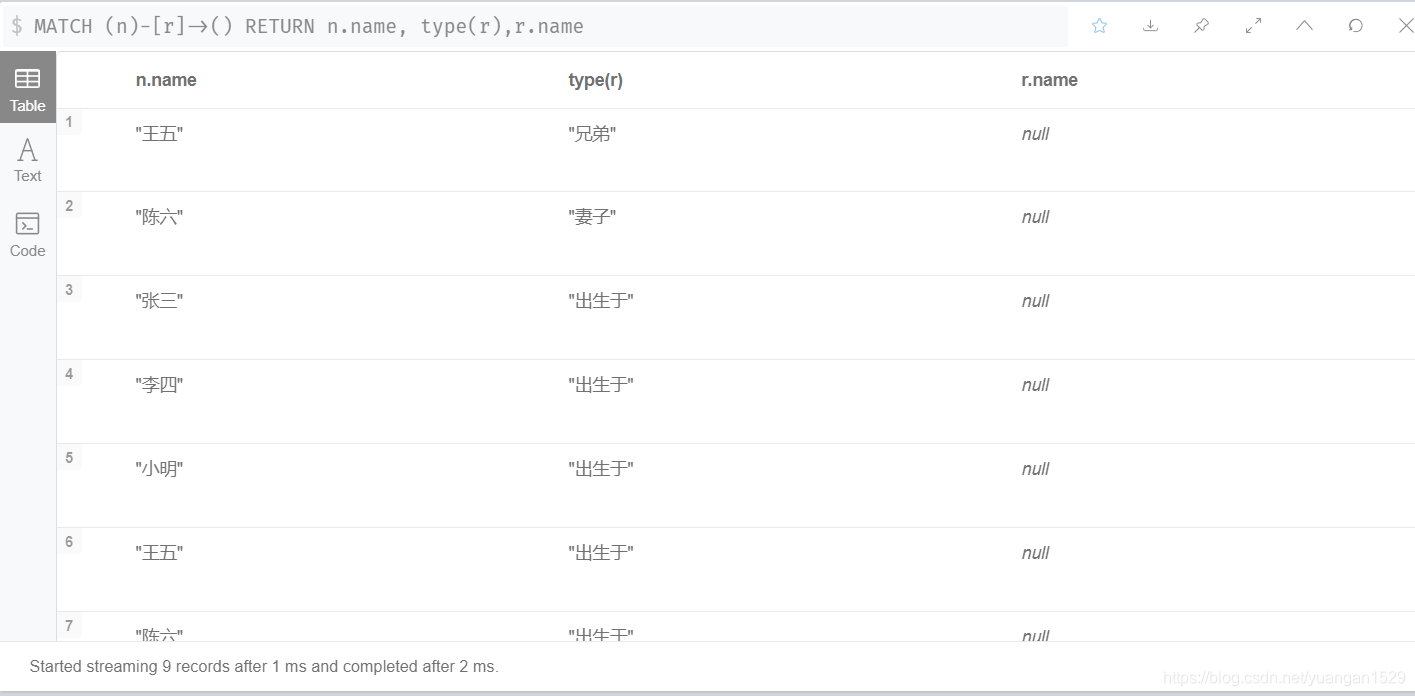
在这里插入图片描述

可以看到关系的名字为 null,这就告诉我们关系只有类型,没有 name,当然了关系还有属性。

我本来还尝试了 type(n),结果报错,显然节点是没有类型的。

2.4 查询所有具有某种关系的节点

MATCH (n)-[:出生于]-() RETURN n

结果如下:
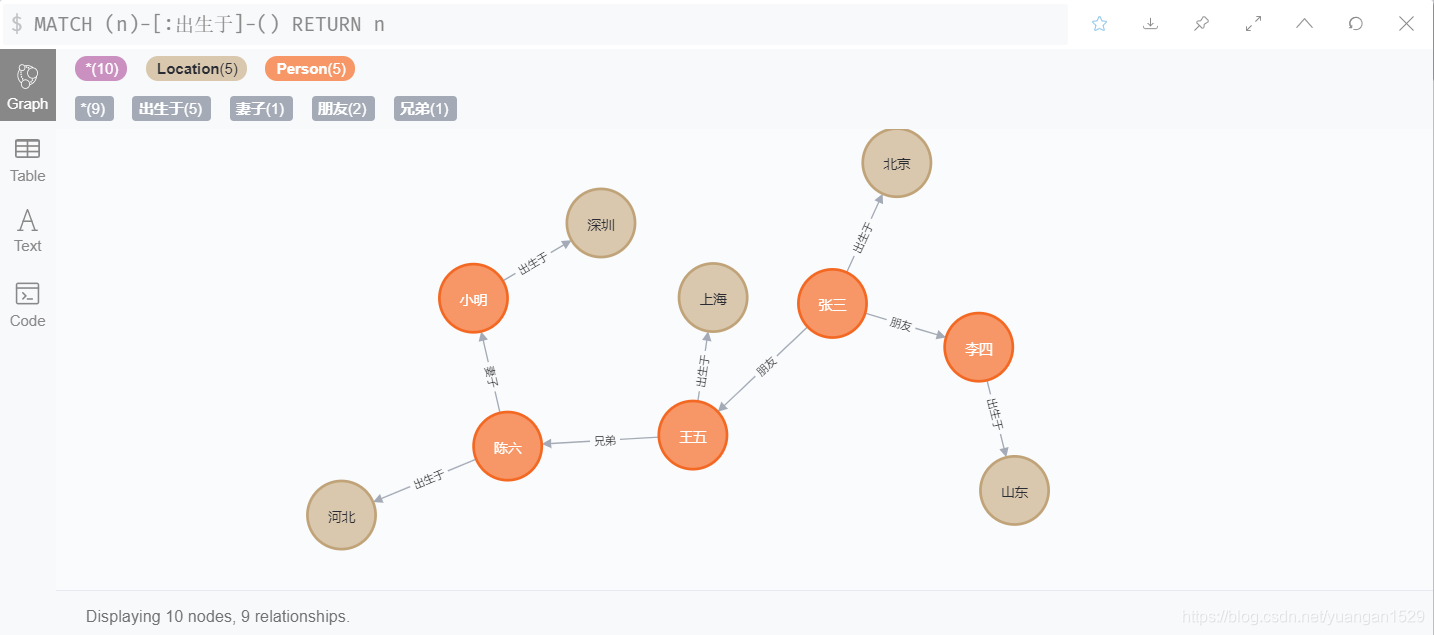
在这里插入图片描述

我们还可以将某个变量指向关系,然后查询关系的类型:

MATCH (n)-[r:出生于]-() RETURN n,type(r)

好吧,上面的运行结果与上面的图一致,并没有显示出 type®,猜测是节点和类型不是一个维度的数据,只显示了第一个返回结果。

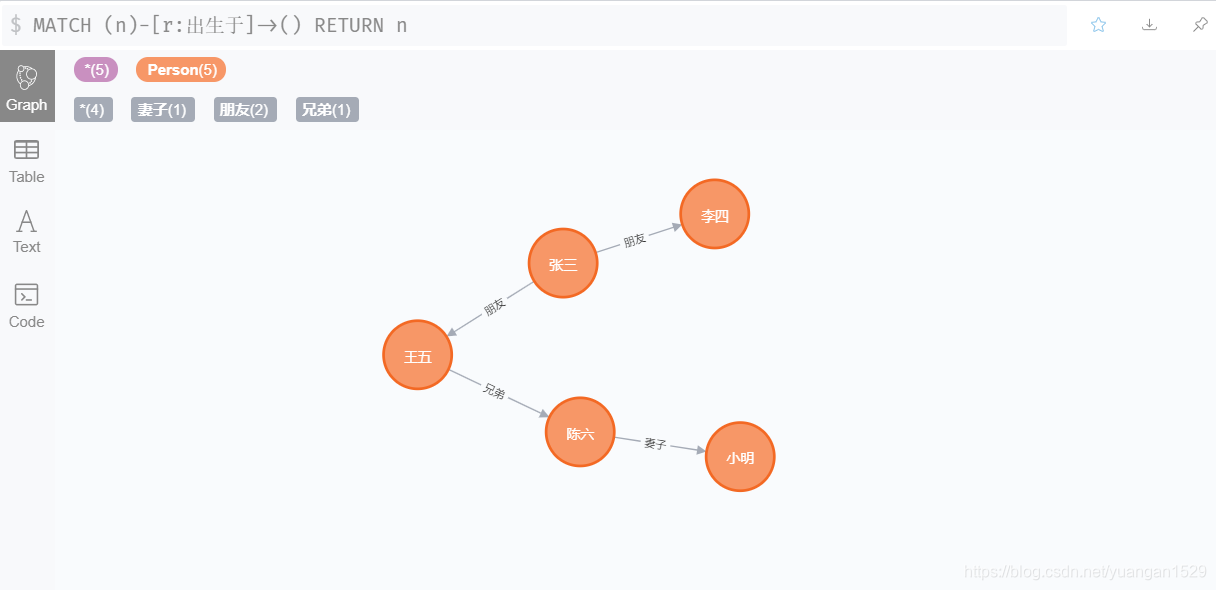
我们可以将某种关系赋予方向:

MATCH (n)-[r:出生于]->() RETURN n
在这里插入图片描述

2.5 查询具有某种属性的节点

MATCH (n:Person{name :'张三'}) RETURN n

也可以使用 where 关键字:

MATCH (n) WHERE n.name = '张三' return n

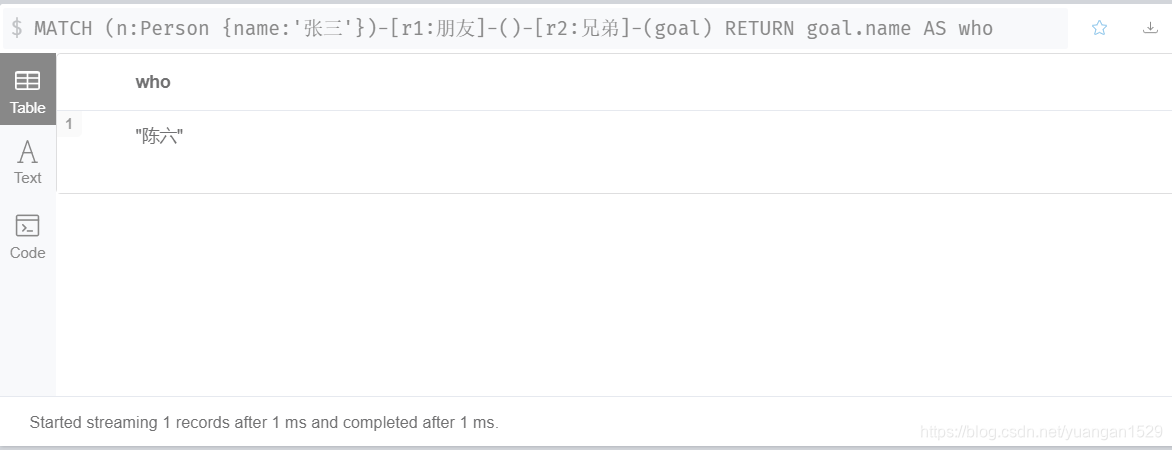
2.6 查找某人朋友的兄弟的名字

MATCH (n:Person {name:'张三'})-[r1:朋友]-()-[r2:兄弟]-(goal) RETURN goal.name AS who
在这里插入图片描述

3、修改/增加

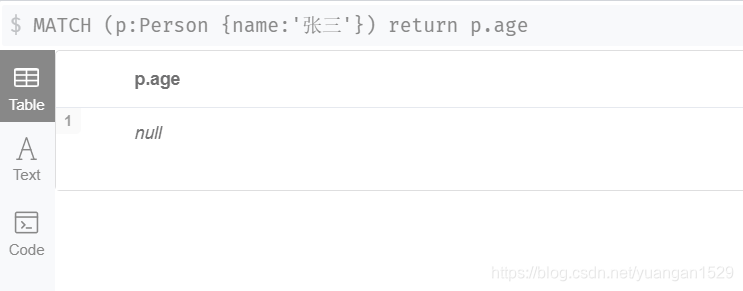
我们记得之前查询过关系的名称,结果返回 null,也就是一个未知的属性是 null,也就是说该属性是存在的,只是为空,我们来验证一下:

MATCH (p:Person {name:'张三'}) return p.age
在这里插入图片描述

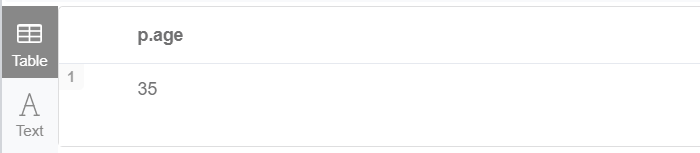
如果,我们将 null 值修改为其他值,是不是就表示增加了新的属性,测试一下:

MATCH (p:Person {name:'张三'}) set p.age=35
MATCH (p:Person {name:'张三'}) return p.age
在这里插入图片描述

结果说明了,在 neo4j 中,修改和增加是一个含义,都是 set 关键字

4、删除

删除和查询一样,都是先匹配关系或者节点,然后利用关键字去删除某个节点或者关系,区别就在于关键字不一样。

Neo4j 的删除关键字有两个:remove 和 delete,在英文中 remove 是移除的含义,这这里表示移除某种属性;而 delete 则是直接删除,删除节点和关系。

4.1 remove

MATCH (p:Person {name:'张三'}) REMOVE p.age

4.2 delete


# 删除节点
match ((p:Person {name:'李四'})-[d:出生于]->(c:Location{city:'北京'})) delete p

# 删除关系
match ((p:Person {name:'李四'})-[d:出生于]->(c:Location{city:'北京'})) delete d

# 删除关系和节点
match ((p:Person {name:'李四'})-[d:出生于]->(c:Location{city:'北京'})) delete p,d,c


#删除某个节点及其关系
MATCH (n) WHERE n.name = '张三' delete n

# 删除所有关系和节点
MATCH (n) DETACH DELETE n

OK,今天就到这里,更多精彩内容关注我的个人网站:蓝亚之舟博客。

Neo4j 实战(一)-- Mac neo4j 安装与配置 neo4j安装版本与JDK版本需要对应,不然neo4j无法启动,这也是一个坑。本机安装python版本是3.6,选择Neo4j版本是3.4。因此,JDK版本是必须1.8.版本以上,不一致会报错。备注:下面是最佳版本适配记录。 阅读详情

相关推荐

qKnow本地部署实战:MySQL+Neo4j+DeepKE+Gradio四层架构详解

知识图谱系统本质上是将非结构化文本转化为可推理的结构化关系网络的技术范式。其核心原理在于通过实体识别与关系抽取(如DeepKE)构建三元组,再依托图数据库(如Neo4j)实现高效路径查询,配合关系型数据库(如MySQL)保障元数据一致性。该技术价值在于支持可解释、可追溯、低幻觉的领域智能问答,广泛应用于金融风控、医疗知识库、企业内搜等对数据主权与逻辑严谨性要求严苛的场景。本文聚焦qKnow这一典型开源实现,深入解析其基于Docker Compose的本地化部署方法论,涵盖MySQL与Neo4j双库协同、De

weixin_30562507的博客 332

Neo4j之DELETE基础

这个查询会找到具有 "Person" 标签且属性 "name" 为 "Alice" 的节点,然后删除该节点以及与之关联的所有关系。这个查询会找到由 "FRIEND" 关系连接的名为 "Alice" 和 "Bob" 的节点组成的模式,然后删除这些关系。这个查询会找到具有 "Person" 标签且属性 "name" 为 "John" 的节点,并删除其 "age" 属性。这个查询会找到年龄大于 60 的所有节点,以及与之关联的所有关系,然后删除这些节点和关系。这个查询会删除图数据库中的所有节点和与之关联的关系。

qq_41081716的博客 4846

SpringBoot+Neo4j+MySQL+Mybatis-Plus多数据源实战:从零搭建到事务统一管理

本文详细介绍了如何在SpringBoot项目中集成Neo4j和MySQL多数据源,实现从零搭建到事务统一管理的完整实战方案。通过环境准备、双数据源配置、业务层实现和事务管理等多个环节的讲解,帮助开发者高效处理复杂数据场景,提升系统集成能力。

weixin_28308325的博客 200

Neo4j 删除节点、关系,和所有节点

neo4j清空所有数据命令如下: MATCH (n) OPTIONAL MATCH (n)-[r]-() DELETE n,r 删除一个节点 DELETE 如下一个节点,删除这个节点可以有两种方法,通过 id 属性,或者 name 属性。 1.1 通过 name 属性 删除这一个节点,如下所示: MATCH (n:TEST1{name:'temp'}) delete n 1.2 通过 id 属性 删除这一个节点,如下所示: MATCH (r) WHERE id(r) = 492 DELETE

for_yayun的博客 4万+

【Neo4j可视化实战】yworks neo4j-explorer:从零上手本地图数据库可视化探索

本文详细介绍了如何使用yworks neo4j-explorer工具进行Neo4j图数据库的可视化探索。从环境准备、连接配置到数据探索实战技巧,涵盖了动态布局算法、交互式查询和Cypher查询进阶玩法,帮助用户高效管理和可视化复杂数据关系。特别适合需要处理大规模图数据的开发者和数据分析师。

weixin_29309475的博客 393

从Neo4j到数据科学:APOC CSV导出的隐藏技巧与实战应用

本文深入探讨了Neo4j中APOC CSV导出的高阶技巧,特别关注复杂数据类型处理、性能优化以及与Python/R生态的深度集成。通过解析`apoc.export.csv`系列函数的核心机制,提供实战案例展示如何将图数据高效转换为CSV格式,并优化与Pandas/Spark等工具的兼容性,助力数据科学家提升分析效率。

weixin_29248653的博客 245

neo4j Docker安装详解+实战

本文介绍 Neo4j的Docker安装,增删改查及索引操作实战操作可查看另一篇文章: https://blog.csdn.net/GodDavide/article/details/102636364 一、简介 Neo4j是一个世界领先的开源图形数据库。 它是由Neo技术使用Java语言完全开发的。 1.Neo4j的特点 SQL就像简单的查询语言Neo4j CQL 它遵循属性图数据模型...

God丶Davide的博客 8万+

GraphRAG实战:用Neo4j构建可追溯、可推理的知识图谱

知识图谱是一种以节点和关系建模现实世界语义结构的技术,其核心价值在于支持精准的关系导航与多跳逻辑推理。相比传统向量检索易出现语义漂移、上下文断裂和关系失焦等问题,图数据库(如Neo4j)通过实体唯一标识、带属性的关系建模及Cypher声明式查询,为大语言模型(LLM)提供结构化、可验证的证据链。这种GraphRAG范式显著提升技术文档问答准确率,降低LLM幻觉风险,并天然适配跨系统知识整合、影响分析、决策溯源等高价值场景。本文聚焦Neo4j与LLM协同落地的关键路径,涵盖图谱构建四步法、Cypher查询优化

weixin_30642869的博客 305

如何用 Neo4j GDS 实现 PageRank 算法:10个实战案例详解

Neo4j Graph Data Science (GDS) 库是一个强大的图算法工具集,其中 PageRank 算法是衡量图中节点重要性的核心工具。本文将通过10个实战案例,详细介绍如何在 Neo4j 中使用 GDS 实现 PageRank 算法,帮助新手和普通用户快速掌握这一强大功能。 ## PageRank 算法基础:理解节点重要性的核心原理 PageRank 算法最初由 Google

gitblog_01052的博客 265

Neo4j样式定制实战:字体大小与节点标签优化指南

本文提供Neo4j Browser样式定制实战指南,重点解决节点标签字体过小和显示混乱的痛点。通过详细解析`:style`命令,手把手教你修改全局及特定节点的字体大小,并介绍如何通过图形界面精准设置节点显示名称(Caption),最后分享样式重置与导出的实用技巧,助你生成专业、清晰的可视化图谱。

weixin_29292431的博客 168

C#连接Neo4j数据库:构建强大的图数据库应用

本文将介绍如何使用C#连接Neo4j,并提供相应的源代码和详细的描述。通过结合C#和Neo4j,你可以轻松地处理和分析复杂的关系数据,为你的应用程序带来更高的灵活性和性能。上述代码中,我们使用Cypher语句创建了一个标记为"Person"的节点,并设置其属性。然后,我们使用另一个Cypher语句更新了该节点的年龄属性。上述代码中,我们创建了一个Neo4j会话,并执行了一个匹配所有节点的查询。通过上述步骤,我们成功地使用C#连接了Neo4j数据库,并实现了一些基本的操作,包括执行查询、创建和更新节点等。

2301_79366332的博客 772

【Mac 实战】简单知识图谱搭建步骤详解(Neo4j + py2neo)

本文介绍了Neo4j图数据库的使用方法及知识图谱构建流程。首先详细讲解了Mac系统下通过Homebrew安装和配置Neo4j的步骤,包括修改默认密码、基础Cypher查询语言操作等。然后以麦当劳为例,演示了节点创建、关系建立、查询修改等基本操作。接着说明数据预处理过程,包括数据清洗、实体识别和关系建模。最后给出使用py2neo构建知识图谱的Python代码模板,涵盖数据读取、节点创建、关系建立等关键步骤。文章提供了从数据库安装到知识图谱构建的完整指导,适合初学者入门图数据库应用开发。

weixin_61639349的博客 1700

【微服务】SpringBoot 整合Neo4j 图数据库项目实战详解

SpringBoot 整合Neo4j 项目实战深度详解

congge 6913

Neo4j GDS-09-neo4j GDS 库中路径搜索算法实现

Neo4j Graph Data Science(GDS)库是Neo4j的扩展插件,提供超过70种图算法,包括路径搜索、社区检测、中心性分析等。其核心功能是通过内存图投影技术高效处理大规模数据。Neo4j Desktop:直接在插件市场添加GDS库。手动安装:下载对应版本的JAR文件至plugins目录,并修改neo4j.conf启用插件。云服务:Neo4j AuraDS(企业版)或Data Science Sandbox(社区版)预装GDS。验证安装:执行查看版本,企业版需通过验证许可。

1365

深入解析经典蓝牙连接:从HCI命令到LMP协议的完整流程

本文深入解析经典蓝牙连接的完整流程,从设备发现、寻呼建立物理链路,到安全配对与加密的每一步。通过对照HCI LOG与AIR LOG,详细拆解了HCI命令与LMP协议报文的对应关系,帮助开发者精准定位连接问题,掌握蓝牙调试的核心方法。

weixin_29260291的博客 422

CTP Python API及Demo(利用Swig 封装)Windows版(6.6.1traderapi)

环境:visual studio2015、python3.9、 参考的是景色大神的教程自己制作,因为直接用它编译好的无法使用,遂自己编译。 从CTP官网上下载CTP API点击下载。这里用的版本是v6.6.1_P1_tradeapi,想使用不同的版本下载即可: 安装Swig软件,本文中所用的Swig是swigwin-4.0.2版本,点击下载。下载后解压,将swig路径添加到环境变量中。 安装python,注意要安装64位版本,将环境变量配置好。本文所用的是3.9版本。 通过Swig得到pyth.

ProgramVAE的博客 2535

Neo4j 图数据库在社交网络等领域的应用

一、前言 Neo4j 是一种基于图论实现的新型 NoSQL 数据库。这种数据库,在处理社交网络,物流运输,推荐系统,欺诈检测等,关系分析等领域有着巨大优势。本场 Chat,我将为你介绍: Neo4j 与关系型、其他非关系型数据库的优势比较 哪些领域适合 Neo4j,哪些领域不适合 Neo4j 的安装 介绍 Cypher 查询语言 案例实战: 银行欺诈环分析 文献索引 寻找垃圾邮箱源...

李天泉 1806

【RDMA】13. RDMA之用户态与内核态交互

原文:https://zhuanlan.zhihu.com/p/346708569 在“RDMA之Verbs”一文中我们说道,Verbs API分为用户态和内核态,分别以ibv_和ib_作为前缀。RDMA技术的最大的优势就在于用户态可以绕过内核,直接控制硬件收发数据,减少了系统调用和内存拷贝次数,所以大部分的RDMA应用都是用户态应用,即使用以ibv_为前缀的用户态Verbs API。 但是并非所有的用户态Verbs API都可以完全绕开内核,本文中我来讲解一下哪些API依赖于内核RDMA子系统(包括驱

我的笔记本 4279

Neo4j图算法实战:如何用GDS插件快速构建推荐系统?

本文详细介绍了如何使用Neo4j的GDS插件快速构建高效的推荐系统。从GDS环境配置、图建模与投影技巧到协同过滤算法实战,全面解析了图算法在推荐系统中的应用。特别针对电商场景,展示了如何通过Node Similarity算法实现用户相似度计算和实时推荐查询,并提供了企业级优化策略,包括并发计算和增量更新方案。

weixin_30379531的博客 393

QFN封装芯片手工焊接实战:从焊盘处理到拖焊技巧

本文详细介绍了QFN封装芯片手工焊接的全过程,从焊盘处理到拖焊技巧,再到常见问题的现场修复方法。通过实战经验分享,帮助工程师和DIY爱好者掌握0.5mm小间距QFN芯片的焊接技术,提升焊接成功率和质量。重点讲解了垂直与平行拖焊手法的对比应用,以及焊后清理与质量检验的关键步骤。

weixin_42652674的博客 522

Ubuntu Rtx3090 Cuda11.7 安装 pytorch3d

pytorch ubuntu pytorch3d 安装

G果的博客 2263

CasRel关系抽取实战教程:结合Neo4j构建动态知识图谱

本文介绍了如何在星图GPU平台上自动化部署CasRel关系抽取模型,实现从非结构化文本中快速提取实体关系三元组。该模型能够高效处理中文文本,自动识别如“人物-创立-公司”等关系对,为构建企业知识图谱、智能问答系统等应用提供核心数据支撑。

weixin_36303305的博客 187

基于FPGA的超声成像算法的硬件设计

顶层设计如下图: 1. Verilog的硬件设计型号是 ALTERA 2.数据的输入量已经给出,附上的四个矩阵输入都要实现。 3.波束形成部分要在FPGA上完成,最后的matlab的代码部分只是获取数据后的图像显示 4.不需要动态聚焦,只是完成固定的四个不同输入数据的显示即可 5.不需要实物,但要实现硬件的仿真,要有相应的模块图和结构图,类似如下 具体实现过程和最终结果如下: 定义aperture(孔径)大小————输入量,数据已给出,一共四个规格的ape...

FPGA/MATLAB学习教程/源码/项目合作开发 1万+

GraphRAG实战:用Neo4j+LLM构建可解释的知识推理系统

知识图谱是一种将实体与关系结构化表达的知识表示方法,其核心原理在于通过节点与边建模语义关联,从而支持路径遍历、因果推断和多跳推理。相比传统向量检索仅依赖语义相似度匹配,图谱技术能显式刻画‘谁—做了什么—影响谁—何时发生’的业务逻辑链,显著提升AI回答的准确性、可解释性与溯源能力。在检索增强生成(RAG)场景中,GraphRAG融合Neo4j等原生图数据库与大语言模型,既保留LLM的自然语言生成优势,又以图结构约束推理边界,避免幻觉。典型应用涵盖客户流失归因、合规规则溯源、故障根因分析等强逻辑、高可信需求领域

weixin_32771907的博客 320

Java高频面试基础问题与知识点整理

Java高频面试知识点总结:覆盖高频基础知识考点+高频集合知识点深入分析+高频多线程与并发编程面试题汇总+其他扩展考察等。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 172万+

企业级AI平台架构设计:AI应用架构师的未来趋势

企业级AI平台是AI从“实验室”走向“生产线”的关键,而AI应用架构师就是这条“生产线”的总设计师。未来,随着生成式AI、边缘计算、自治式AI的发展,架构师的角色将越来越重要——他们不仅要构建技术平台,还要连接技术与业务,让AI真正创造价值。“不要做‘只会调模型的工程师’,要做‘能解决业务问题的架构师’。因为,真正有价值的AI,从来不是“最先进的模型”,而是“能落地、能复用、能创造业务价值的平台”。愿你在企业AI转型的浪潮中,成为那个“搭建桥梁的人”——连接技术与业务,连接现在与未来。

小程序开发 970
上一篇: Neo4j下载安装以及Neo4j浏览器详细说明
下一篇: 学习weka(5):weka之KnowledgeFlow详解
蓝亚之舟
博客等级 码龄11年 4958粉丝 65原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值